Qué es el MPS
Los dispositivos PCIe transfieren datos en paquetes llamados paquetes de la capa de transacción (TLP). Cada TLP tiene una cabecera y un payload. El tamaño máximo de ese payload es el MaxPayloadSize (MPS).
El MPS se negocia entre un dispositivo y su puente aguas arriba durante el entrenamiento del enlace. El valor negociado es el menor entre lo que admite el dispositivo y lo que permite el puente. Cada puente y conmutador en el camino entre el dispositivo y el complejo raíz tiene su propia capacidad de MPS. El MPS final de cualquier dispositivo lo fija el punto más estrecho de la cadena.
Los valores de MPS habituales son 128, 256 y 512 bytes. Algunos dispositivos admiten 1024 o incluso 4096 bytes, pero en la práctica 256 o 512 es lo típico para controladoras NVMe y tarjetas de red. Las GPU suelen admitir 256 bytes.
Por qué importa
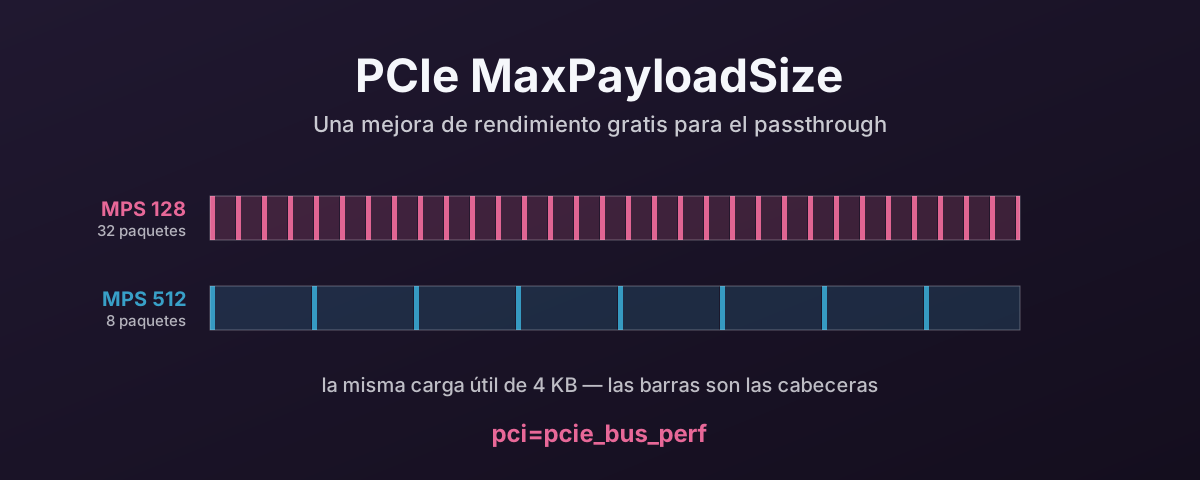
Un MPS mayor significa menos paquetes para la misma cantidad de datos. Una E/S de 4 KB transferida con MPS 128 necesita 32 TLP. La misma transferencia con MPS 512 necesita 8 TLP.
Cada TLP acarrea sobrecarga de protocolo — la cabecera, el CRC, el entramado. Menos TLP significa menos sobrecarga de protocolo por byte transferido. A alto rendimiento, esa diferencia es medible. No dramática. Pero real. Y es la misma sobrecarga, pagada en cada paquete.
El MPS también afecta a lo bien que se aprovecha el enlace PCIe. Payloads más pequeños hacen que el enlace pase más tiempo en cabeceras respecto a datos. Payloads más grandes desplazan la proporción hacia datos útiles.
El impacto en la latencia es menor que en el rendimiento. Una sola lectura de 4 KB con MPS 128 frente a 512 no mostrará una diferencia de latencia que merezca medirse, porque los TLP van en cauce. Pero fuerza muchas IOPS con muchas transferencias en vuelo y la menor sobrecarga de un MPS mayor se acumula.
El problema bajo passthrough
En hardware nativo, la BIOS fija el MPS durante el POST según la topología PCIe. La BIOS de un servidor moderno suele fijar el MPS al máximo que admite la topología, normalmente 256 o 512 bytes.
Bajo QEMU, el complejo raíz del chipset Q35 virtual tiene su propia capacidad de
MPS.
Por defecto, presenta un MPS bajo.
La política de MPS por defecto del kernel de Linux (pcie_bus_default) fija el
MPS de cada dispositivo para que coincida con su puente padre, lo que en una
topología virtual significa el valor por defecto del complejo raíz de QEMU. A
menudo 128 bytes.
Como tal, un dispositivo capaz de payloads de 512 bytes corre a 128 porque el complejo raíz virtual fijó el techo.
Cómo arreglarlo — lado del host
Dile al kernel que fije el MPS al máximo que admite el bus padre de cada dispositivo:
# Add to GRUB_CMDLINE_LINUX_DEFAULT in /etc/default/grub
pci=pcie_bus_perf
Esto fija el MPS de cada dispositivo al mayor valor que permite su bus padre. También fija el MRRS (Max Read Request Size) en consecuencia. El código fuente del kernel dice que se asegura de que el MPS de un dispositivo no sea mayor que el de su padre. Eso mantiene la cadena coherente a la vez que consigue los mejores tamaños de transferencia.
Tras reiniciar, verifica el nuevo MPS:
# Check MPS on a specific device
lspci -vv -s XX:00.0 | grep -i "MaxPayload"
Deberías ver MaxPayload 256 bytes o MaxPayload 512 bytes en vez del 128 por
defecto.
Las otras opciones del kernel
El kernel ofrece cuatro políticas de MPS, cada una fijada con el parámetro de
arranque pci=:
pcie_bus_tune_off — no tocar el MPS en absoluto.
Usa lo que fijó la BIOS.
En hardware nativo con una buena BIOS, esto suele estar bien.
Bajo QEMU, la BIOS es OVMF o SeaBIOS, que puede no optimizar el MPS.
pcie_bus_default — el valor por defecto del kernel.
Fija el MPS de cada dispositivo para que coincida con su puente aguas arriba.
Conservador y seguro, pero no maximiza el rendimiento.
pcie_bus_safe — fija el MPS al mayor valor que admiten todos los
dispositivos del sistema.
Útil para sistemas cerrados donde conoces todos los dispositivos y no se
conectará nada en caliente.
Ligeramente más agresivo que el por defecto.
pcie_bus_perf — fija el MPS por dispositivo al mayor valor que permite el
bus padre.
Cada dispositivo obtiene el mejor MPS que admite su topología local.
Esta es la elección correcta para el passthrough porque optimiza cada camino de
forma independiente.
pcie_bus_peer2peer — fija el MPS a 128 bytes en todo.
Cada dispositivo habla al menor tamaño común.
Se usa cuando los dispositivos necesitan hacer DMA directamente entre sí
(GPU a GPU, GPU a NIC vía RDMA).
No sirve para el passthrough estándar.
pcie_bus_perf es la correcta para el passthrough.
Cómo arreglarlo — lado del invitado
Puedes fijar pci=pcie_bus_perf también en la configuración de arranque del
kernel del invitado.
Si tiene algún efecto práctico depende de cómo presente QEMU la topología PCIe
virtual.
El complejo raíz virtual limita lo que el invitado puede negociar.
En mis pruebas, el arreglo del lado del host es el que se sostiene. El host es dueño del dispositivo físico, y su ajuste de MPS fija el tamaño real de TLP en el cable. El ajuste del invitado solo toca la topología virtual dentro de la VM, y si eso cambia el comportamiento real depende de cómo presente QEMU el camino PCIe para ese dispositivo.
Fíjalo en el host. Fijarlo también en el invitado no hace daño, pero no dependas de eso solo.
Qué es el MRRS
El Max Read Request Size (MRRS) es algo relacionado pero distinto. El MPS limita cuántos datos puede enviar un dispositivo en un TLP. El MRRS limita cuántos datos puede pedir un dispositivo en una petición de lectura.
Un dispositivo con MRRS 4096 puede emitir una sola petición de lectura de 4 KB. La respuesta vuelve en varios TLP, cada uno de hasta el tamaño del MPS. Un MRRS mayor significa que el dispositivo puede pedir más datos por transacción, reduciendo el número de TLP de petición de lectura en el bus.
pci=pcie_bus_perf fija tanto el MPS como el MRRS a sus valores óptimos.
No necesitas ajustarlos por separado.
Impacto frente a otros ajustes
La diferencia de MPS entre 128 y 512 bytes tiene menos impacto en el rendimiento que la alineación NUMA o el ASPM. Suele ser una mejora de un porcentaje de un solo dígito bajo en el rendimiento. No la verás en pruebas de latencia con profundidades de cola pequeñas.
Pero es una optimización gratis. Un parámetro del kernel, sin inconvenientes, sin riesgo de compatibilidad. No hay razón para no fijarla en cualquier sistema que haga passthrough.
No cuesta nada, y ya has pagado el hardware. Bien puedes tener lo que compraste.
Referencias
- Linux kernel PCI Kconfig — MPS and MRRS tuning options — fuente autoritativa de las cuatro políticas de MPS
- Linux Plumbers Conference 2017 — MPS vs MRRS (PDF) — presentación de Sinan Kaya sobre el manejo de MPS/MRRS del kernel