Qué es NUMA
NUMA significa acceso no uniforme a memoria (Non-Uniform Memory Access). En un sistema de un solo zócalo, cada núcleo de CPU accede a toda la RAM del sistema a través del mismo controlador de memoria. El tiempo de acceso es el mismo sin importar qué núcleo hace la petición ni dónde se sientan los datos en la memoria física.
En un sistema multizócalo, cada zócalo de CPU tiene su propio controlador de memoria y su propio banco de RAM. Un núcleo del zócalo 0 puede acceder a la RAM conectada al zócalo 0 rápidamente — eso es memoria local. También puede acceder a la RAM conectada al zócalo 1, pero esa petición tiene que cruzar el enlace entre zócalos (Intel UPI, AMD Infinity Fabric). Eso es memoria remota, y es más lenta.
El kernel llama a cada zócalo-con-su-memoria-local un nodo NUMA. Un sistema AMD EPYC de doble zócalo tiene al menos dos nodos NUMA. Algunos procesadores EPYC exponen cuatro nodos NUMA por zócalo (uno por CCD), dando ocho nodos en una placa de doble zócalo.
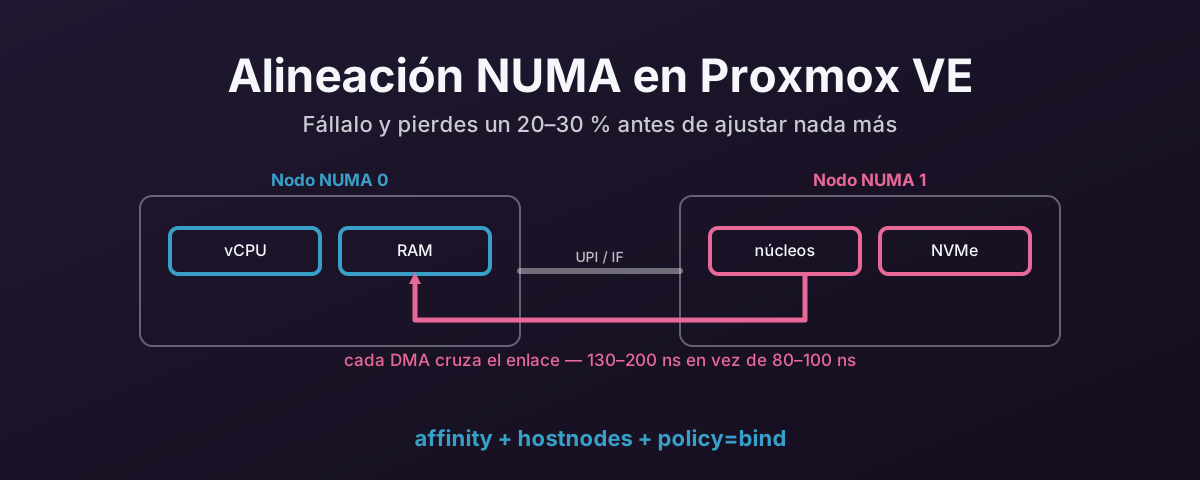
La diferencia de rendimiento entre acceso a memoria local y remota no es sutil. El acceso local ronda los 80–100 ns. El acceso remoto ronda los 130–200 ns. Eso es una penalización del 50–100 % por operación de memoria. Por sí solo es un número muy pequeño. Pagado en cada acceso a memoria durante toda la vida de la VM, deja de ser pequeño.
Por qué importa para la virtualización
Cuando Proxmox crea una VM, asigna vCPU y RAM. Por defecto, esas vCPU pueden planificarse en cualquier núcleo físico de cualquier zócalo. La RAM de la VM puede asignarse desde el pool de memoria de cualquier nodo NUMA.
Si el planificador pone una vCPU en el zócalo 0 y la RAM de la VM está en el zócalo 1, cada acceso a memoria que haga esa vCPU cruza el enlace entre zócalos. Si las vCPU rebotan entre zócalos — cosa que harán si no están fijadas — el patrón de acceso a memoria se vuelve un desastre. Algunos accesos son locales, otros remotos, y el rendimiento de la VM fluctúa en consecuencia.
Para cargas generales — un servidor web, un servidor de archivos, una VM de escritorio — esto suele ser llevadero. La sobrecarga está ahí pero se reparte entre muchas operaciones y no domina.
Para cargas intensivas de E/S — bases de datos, servidores de almacenamiento, cualquier cosa que haga mucha E/S de disco o red — la penalización se compone. Cada finalización de DMA, cada entrega de interrupción, cada copia de búfer implica un acceso a memoria. Si esos accesos cruzan zócalos, la sobrecarga suma rápido.
Por qué importa para el passthrough
Los dispositivos PCIe están cableados físicamente a un zócalo de CPU concreto. Cada zócalo tiene su propio complejo raíz PCIe. La unidad NVMe de la ranura 3 podría estar en las líneas PCIe del zócalo 0. La GPU de la ranura 5 podría estar en las del zócalo 1.
Cuando un dispositivo hace DMA, los datos van a la memoria conectada al nodo NUMA al que el IOMMU los mapee. Si la RAM de la VM se asigna desde el nodo local del dispositivo, la escritura DMA va directa a memoria local. Si la RAM está en el otro nodo, cada operación DMA cruza el enlace entre zócalos.
Para una unidad NVMe haciendo cientos de miles de IOPS, esa penalización de
50–100 ns por operación suma.
Con iodepth=32 y lecturas aleatorias de 4 KB, la diferencia de rendimiento
entre NUMA alineado y desalineado puede ser del 20–30 %.
Eso es antes de haber mirado la sobrecarga del IOMMU, el ASPM, el MPS ni nada más.
Lo mismo aplica a tarjetas de red, GPU y cualquier otro dispositivo pasado por passthrough. El tráfico DMA del dispositivo debería aterrizar en memoria local, y las vCPU que procesan ese tráfico deberían estar en el mismo nodo.
Cómo comprobar tu topología
Averiguar en qué nodo NUMA está un dispositivo
# Replace 0000:XX:00.0 with your device's PCI address from lspci
cat /sys/bus/pci/devices/0000:XX:00.0/numa_node
Esto devuelve el número de nodo NUMA.
Si devuelve -1, el kernel no pudo determinar el nodo. Eso pasa a veces con
dispositivos detrás de ciertos conmutadores PCIe.
En ese caso, traza la topología PCIe a mano con lspci -tv y empareja el puerto
raíz con el zócalo.
Ver tu disposición NUMA completa
numactl --hardware
Esto te muestra cada nodo NUMA, cuántos núcleos de CPU tiene, cuánta memoria hay conectada, y la distancia (coste relativo) entre nodos.
Salida de ejemplo de un sistema EPYC de doble zócalo:
available: 2 nodes (0-1)
node 0 cpus: 0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
node 0 size: 131072 MB
node 1 cpus: 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31
node 1 size: 131072 MB
node distances:
node   0   1
  0:  10  32
  1:  32  10
La tabla de distancias te dice el coste relativo. 10 es local. 32 es remoto. Números más altos significan más saltos. En montajes EPYC de cuatro nodos por zócalo, algunos pares de nodos tienen distancias de 32 mientras otros son 16, según en qué CCD estén.
Mapear dispositivos a nodos
# List all PCI devices and their NUMA nodes
for dev in /sys/bus/pci/devices/*; do
    node=$(cat "$dev/numa_node" 2>/dev/null)
    echo "$(basename $dev) node=$node $(lspci -s $(basename $dev) 2>/dev/null | cut -d' ' -f2-)"
done
Esto te da una imagen completa de qué dispositivos están en qué nodos. Busca tus controladoras NVMe, tarjetas de red y cualquier GPU que pases por passthrough.
Cómo alinear una VM en Proxmox
Fijar las vCPU al nodo correcto
En el archivo de configuración de la VM (/etc/pve/qemu-server/<vmid>.conf):
numa: 1
affinity: 0-15    # Adjust to match cores on the correct NUMA node
El parámetro affinity fija las vCPU de la VM a núcleos físicos concretos.
Ponlo en el rango de núcleos del mismo nodo NUMA que tu dispositivo pasado por
passthrough.
Si tu NVMe está en el nodo 1 y el nodo 1 tiene los núcleos 16–31, pon
affinity: 16-31.
Si la VM solo necesita 8 vCPU, fíjala a un subconjunto: affinity: 16-23.
Asignar memoria del nodo correcto
Habilitar numa: 1 en la configuración de la VM le dice a Proxmox que presente a
la VM con topología NUMA.
QEMU intentará asignar la memoria de la VM desde el nodo NUMA donde están fijadas
las vCPU.
Para un control explícito, puedes fijar la topología NUMA en la configuración de la VM:
numa0: cpus=0-7,hostnodes=0,memory=16384,policy=bind
Esto le dice a QEMU que enlace el primer nodo NUMA de la VM (nodo 0 desde la
perspectiva del invitado) al nodo NUMA 0 del host, usando los núcleos 0–7 y 16 GB
de memoria.
El policy=bind asegura que la memoria se asigne estrictamente desde ese nodo en
vez de recurrir a otros nodos si el pool local está bajo presión.
Verificar la fijación
Tras arrancar la VM, comprueba que las vCPU corren de verdad donde esperas:
# Find the QEMU process
pgrep -a qemu | grep <vmid>

# Check CPU affinity of the process
taskset -cp <pid>

# Or check per-vCPU thread affinity
for tid in $(ls /proc/<pid>/task/); do
    echo "Thread $tid: $(taskset -cp $tid 2>/dev/null)"
done
Errores comunes
No fijar en absoluto
Si no pones affinity, las vCPU de la VM pueden planificarse en cualquier núcleo.
El planificador del kernel las moverá entre nodos según el balanceo de carga.
Cada vez que una vCPU migra de un nodo a otro, cualquier dato con el que estuviera
trabajando en la caché del nodo antiguo pasa a ser remoto.
Para VM generales esto es aceptable. Para VM de passthrough haciendo mucha E/S, no lo es.
Fijar al nodo equivocado
Comprueba el nodo NUMA del dispositivo antes de fijar.
No lo des por hecho.
En algunas placas base, la numeración física de las ranuras no coincide con la
asignación de nodo NUMA de forma obvia.
Verifica siempre con cat /sys/bus/pci/devices/.../numa_node.
Sobresuscribir un nodo
Si fijas demasiadas VM al mismo nodo NUMA, los núcleos de ese nodo quedan sobresuscritos y el pool de memoria local se agota. Cuando la memoria desborda al nodo remoto, obtienes lo peor de ambos mundos: vCPU fijadas con memoria remota.
Equilibra la colocación de tus VM entre nodos. Si tienes dos nodos NUMA y cuatro VM, repártelas por igual.
Olvidar la asignación de memoria
Fijar las vCPU sin controlar también la asignación de memoria te da la mitad del
beneficio.
Las vCPU están en el nodo correcto pero la memoria podría no estarlo.
Usa policy=bind o como mínimo habilita numa: 1 para que la asignación de QEMU
siga a la fijación de CPU.
Sistemas de un solo zócalo
En un sistema de un solo zócalo, todo está en el nodo NUMA 0. Solo hay un controlador de memoria y un juego de líneas PCIe. La alineación NUMA no es una preocupación.
Aún puedes poner numa: 1 en la configuración de la VM — no hará daño — pero
tampoco ayudará.
Un zócalo, un controlador de memoria, nada que alinear.
Ahorra el esfuerzo para una máquina que tenga dos.
Como tal, las ganancias de rendimiento descritas aquí solo aplican a sistemas
multizócalo donde existe el enlace entre zócalos.
Referencias
- Proxmox VE Administration Guide — CPU and NUMA Configuration — documentación oficial sobre fijación de vCPU y opciones NUMA
- Linux kernel NUMA documentation — referencia de la política de memoria del kernel
- AMD EPYC 7003 Series — BIOS & Workload Tuning Guide (doc 58002) — documentación de AMD sobre topología NUMA por zócalo y CCD/CCX