La pregunta con la que empieza toda evaluación de Proxmox
«¿Proxmox es de verdad de nivel empresarial?»
Aparece en casi toda conversación de migración, y la preocupación de fondo casi nunca es la interfaz web. Nadie teme en serio que un panel de navegador corrompa sus datos. Lo que la gente pregunta es si la cosa que se interpone entre una máquina virtual y el hardware — el componente que tiene que mantener a un inquilino fuera de la memoria de otro, para siempre, sin un solo error — es una pieza de ingeniería seria o un proyecto comunitario que se hizo popular.
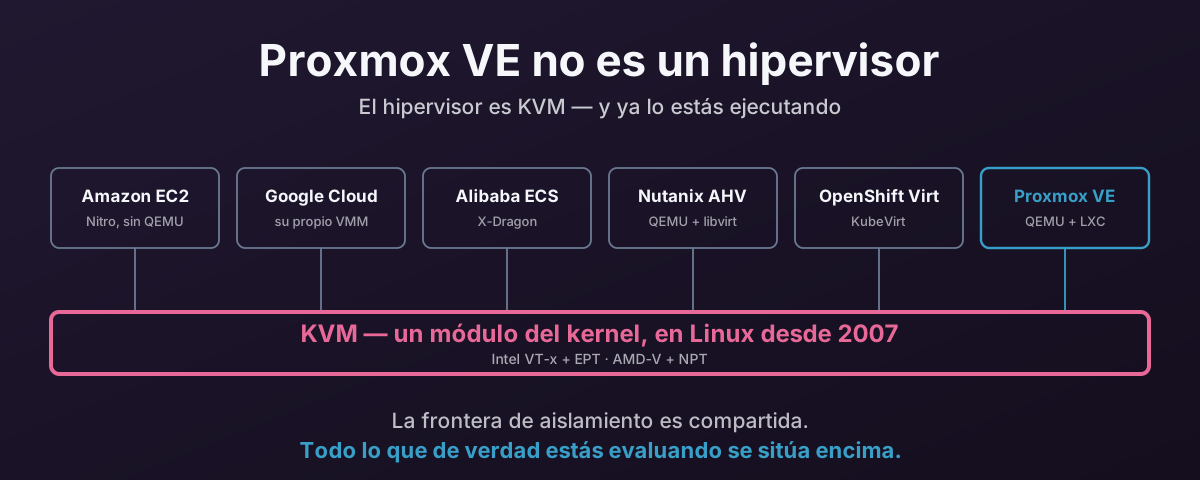
Eso es exactamente lo correcto por lo que ponerse nervioso. Solo que apunta a la capa equivocada, porque Proxmox VE no contiene un hipervisor.
El hipervisor es KVM. Es parte de Linux, está ahí desde 2007, y si tu organización usa EC2, Google Cloud, Oracle Cloud, Alibaba Cloud, DigitalOcean o Nutanix, ya lo estás ejecutando en producción hoy — solo que nunca has tenido que pensar en ello, porque otro era dueño de las capas de arriba.
Este post trata de lo que ese cimiento compartido significa de verdad. Ambas mitades: la parte del argumento que se sostiene de verdad, y la parte que se sobrevende en las diapositivas de los fabricantes.
Proxmox VE es una capa de gestión
La virtualización en Linux son cuatro capas distintas, construidas y mantenidas por cuatro conjuntos de personas diferentes.
1. Extensiones de virtualización hardware. Intel VT-x con EPT, o AMD-V con NPT. Silicio. Esto es lo que hace que un invitado pueda ejecutar su propio kernel a velocidad nativa con sus propias tablas de páginas, sin nada emulando instrucciones.
2. KVM — el hipervisor.
Módulos del kernel: kvm.ko para el núcleo independiente de la arquitectura, más kvm-intel.ko o kvm-amd.ko para las extensiones del fabricante. Este es el componente que posee la frontera de aislamiento. Prepara las estructuras de control de máquina virtual del invitado, maneja los VM exits, gestiona las tablas de páginas de segundo nivel, y entrega interrupciones.
3. El VMM — el monitor de máquina virtual, en espacio de usuario. En Proxmox VE esto es QEMU. Construye la placa base virtual: chipset, topología PCIe, discos, NIC, puertos serie, firmware. KVM ejecuta la CPU; QEMU decide qué hardware cree tener el invitado.
4. La capa de gestión.
Esto es Proxmox VE: pve-manager y pveproxy para la API y la interfaz, qemu-server para convertir un archivo de configuración de VM en una línea de comandos de QEMU, pve-container para LXC, pmxcfs sobre Corosync para la configuración replicada del clúster, pve-ha-manager para el fencing y el reinicio, más la pila de firewall y SDN.
Esas cuatro capas existen también en la plataforma de la que estás migrando, haciendo los mismos cuatro trabajos — vCenter es la capa 4, VMkernel es la capa 2 — y volveré a esa comparación una vez que las piezas estén sobre la mesa.
Qué mantiene Proxmox de verdad
Proxmox VE posee la capa 4 por completo. Sería erróneo decir que solo empaqueta las capas 2 y 3, sin embargo, y esa es la lectura equivocada más común de lo que hace la empresa.
pve-qemu lleva 78 parches contra el QEMU de upstream en su archivo de serie en el momento de escribir esto:
debian/patches/series. La mayor parte de la cola es la propia ingeniería de Proxmox, y toda ella se sitúa en la capa 3 — ninguno de estos parches toca kvm.ko.También construyen su propio kernel, y mantienen empaquetado o parches para la mayor parte de la pila circundante — pve-edk2-firmware para OVMF, más lxc, zfsonlinux, openvswitch, libiscsi, corosync-pve, lvm y ceph.
Así que la frontera real es: toda la capa 4, ingeniería sustancial dentro de la capa 3, y un kernel que compilan. Lo que no han hecho es escribir un hipervisor. El código KVM de la capa 2 es Linux de upstream.
Y nada de esto es una crítica a Proxmox. Como tal, es la razón de que se pueda confiar el trabajo a una empresa del tamaño de Proxmox en absoluto. Una empresa pequeña de Viena no se sentó a escribir un hipervisor desde cero; construyeron sobre uno que Intel, AMD, Red Hat, Google, Amazon e IBM ya pagaban a ingenieros para mantener, y gastaron su propio esfuerzo en la capa de encima y el trabajo de integración que esa capa necesita. Ahí es donde un equipo de ese tamaño puede marcar la diferencia, y la cola de parches los muestra marcándola.
Qué es KVM en realidad
KVM significa Kernel-based Virtual Machine, y el nombre es exacto: es una función del kernel, no un programa.
Carga los módulos y Linux gana un dispositivo de caracteres, /dev/kvm, más un pequeño juego de llamadas ioctl sobre él — KVM_CREATE_VM, KVM_CREATE_VCPU, KVM_SET_USER_MEMORY_REGION, KVM_RUN.
Esa interfaz es toda la API del hipervisor. Cualquier cosa que pueda abrir un descriptor de archivo y llamar a ioctl puede crear máquinas virtuales.
Lo escribió Avi Kivity en Qumranet y se fusionó en Linux 2.6.20, lanzado en febrero de 2007 — hace diecinueve años. Red Hat adquirió Qumranet en 2008, y KVM ha ido en cada lanzamiento del kernel desde entonces, en la cadencia habitual del kernel de nueve a diez semanas. Se ha portado mucho más allá de x86: arm64, POWER, s390 en IBM Z, y RISC-V.
El punto arquitectónico importante es por qué es pequeño.
KVM no tiene planificador, porque Linux tiene uno. Una vCPU es un hilo del host corriente, y el planificador completamente justo la pone en un núcleo como cualquier otro hilo. No tiene gestor de memoria, porque Linux tiene uno. La RAM del invitado es un mapeo de espacio de usuario normal, así que se puede paginar, respaldar con hugepages, o colocar en un nodo NUMA usando la misma maquinaria que cualquier otro proceso. No tiene una pila de controladores, una capa de bloques, una pila de red, ni un sistema de archivos, porque Linux ya los tenía todos y son con los que tu fabricante de hardware está probando.
Ese es el argumento de madurez de verdad, y es mucho más fuerte que un número de versión. Cada mejora de balanceo NUMA, cada cambio de io_uring, cada controlador de red, cada nuevo apaño de errata de CPU que aterriza en Linux aterriza debajo de tus máquinas virtuales, porque no hay un kernel de hipervisor separado al que nadie tenga que portarlo.
El argumento del tipo 1 traza la línea en el sitio equivocado
La objeción que sigue a esto, sin falta, es que KVM es «solo un hipervisor de tipo 2». Corre sobre un SO host, a diferencia de ESXi, que corre sobre metal desnudo.
Esa taxonomía tiene tres décadas más que la virtualización hardware, y la cosa alrededor de la que trazaba una línea ya no está donde nadie cree.
Qué pasa de verdad cuando una vCPU corre
QEMU llama a ioctl(vcpu_fd, KVM_RUN). El control pasa a kvm.ko, que carga el estado de la CPU del invitado y ejecuta VMLAUNCH. Desde esa instrucción hasta el siguiente VM exit, el invitado se está ejecutando directamente en el núcleo físico, en modo invitado, con sus propias tablas de páginas activas a través de EPT, a plena velocidad hardware. No hay nada debajo interpretando nada. El «SO host» no está en el camino. Ni siquiera está corriendo en ese núcleo.
Cuando el invitado hace algo que necesita manejo, la CPU sale al host — y aterriza en kvm.ko, en el kernel, exactamente en el nivel de privilegio que ocupa el VMkernel de ESXi. La mayoría de los exits se resuelven ahí mismo y se reingresa sin que el espacio de usuario se vea involucrado jamás.
ESXi tiene la misma separación
Ahora mira la plataforma que supuestamente prueba la distinción.
La propia documentación de arquitectura de VMware describe el VMkernel como «a POSIX-like operating system» — un sistema operativo de tipo POSIX — que proporciona «process creation and control, signals, file system, and process threads». Eso es un sistema operativo, según la descripción de su propio autor. Y una VM en marcha en ESXi no es una cosa dentro del kernel — es un grupo de procesos userworld: un VMM por CPU virtual, que virtualiza las instrucciones del invitado y gestiona su memoria, y un proceso VMX por VM, que maneja la E/S hacia los dispositivos que no son críticos para el rendimiento y habla con el gestor de instantáneas y la consola remota.
Lee eso con QEMU en mente. Contexto de ejecución por vCPU en el kernel, proceso de espacio de usuario por VM haciendo emulación de dispositivos y gestión. VMware lo separó por la misma razón que todos los demás.
Hyper-V no es diferente. La documentación de Microsoft es explícita en que el Virtual Machine Worker Process, vmwp.exe, es «a user mode component of the virtualization stack» — un componente en modo usuario de la pila de virtualización, engendrado por VM, y que todos los dispositivos emulados se implementan en él — corriendo en la partición raíz, que es Windows. Incluso Xen, la arquitectura a la que la taxonomía mejor le va, necesita un Linux de propósito general en dom0 para funcionar, y obtiene su modelo de dispositivos para los invitados plenamente virtualizados de QEMU.
Entonces, ¿dónde está la línea?
El criterio nunca fue «¿usa el espacio de usuario?». La taxonomía de Goldberg, de principios de los años 1970, pregunta si el hipervisor es una aplicación que corre sobre un sistema operativo preexistente que ya posee el hardware y hace la planificación. Eso es un hipervisor de tipo 2, alojado: VMware Workstation, VirtualBox, Parallels Desktop, QEMU a solas sin aceleración. Instalas un SO de propósito general, luego instalas un programa encima, y ese programa le pide memoria y tiempo de CPU al SO como cualquier otro programa.
Eso no es lo que KVM es. kvm.ko no es un programa encima de Linux. Es parte de Linux, ejecutándose en el mismo nivel de privilegio que el código que posee el hardware, y cuando un invitado sale aterriza ahí directamente. No hay un SO host debajo del hipervisor. El kernel es el hipervisor. Proxmox VE envía ese kernel como el sistema, exactamente igual que ESXi envía el VMkernel como el sistema.
Y la versión «necesita espacio de usuario, así que es de tipo 2» no se puede rescatar, porque aplicada con constancia atrapa a todos. Ninguna VM corre en ESXi sin su proceso VMX, ninguna en Hyper-V sin vmwp.exe, ninguna en Xen como invitado HVM sin QEMU. Un test que mete a todos los hipervisores comerciales en un cubo no distingue nada.
| Kernel que posee la virtualización de CPU y memoria | Modelo de dispositivos en espacio de usuario por VM | ¿Necesita un SO host preexistente? | |
|---|---|---|---|
| VMware ESXi | VMkernel | VMX por VM | No |
| Microsoft Hyper-V | hipervisor más la partición raíz de Windows | vmwp.exe | No |
| Xen | hipervisor Xen más dom0 Linux | QEMU, en dom0 o un dominio stub | No |
| KVM | kvm.ko | QEMU | No |
| VirtualBox, VMware Workstation | el kernel del host, vía un controlador instalado | la propia aplicación | Sí |
Cuatro productos, una forma — y luego una quinta fila que es genuinamente distinta. Esa última fila es lo que se acuñó «tipo 2» para describir, y es la única donde algo más ya estaba al mando del hardware.
Así que la taxonomía sí traza todavía una línea. Solo que no la traza ni cerca de donde el argumento supone: KVM y ESXi están del mismo lado de ella. Llamar a KVM tipo 2 es tomar prestada una palabra de la categoría VirtualBox y aplicarla a algo que está, arquitectónicamente, en la categoría ESXi.
Lo que deja a la etiqueta sin hacer ningún trabajo útil en una evaluación, porque ambos productos entre los que estás eligiendo se sientan en la misma caja. Lo que difiere no es el número de tipo. Es que un fabricante también escribió el kernel y no te deja leerlo — una distinción de licencia y transparencia vestida con la ropa de un diagrama de arquitectura. Nutanix lo demuestra comercialmente: envía el mismo código KVM que Proxmox y describe AHV como un hipervisor de tipo 1 sobre metal desnudo. Mismo código, etiqueta opuesta, departamento de marketing diferente.
Sí hay una preocupación real escondida dentro de la acusación, y merece un nombre mejor: un kernel de propósito general hace mil trabajos que uno hecho a propósito no hace, lo que es más código y más superficie de ataque al lado de la frontera de aislamiento. Eso es legítimo y medible, y vuelvo a ello cerca del final.
Dónde pasa el trabajo de verdad
El único sitio donde el instinto de «está sobre un SO host» tiene un punto real es el manejo de los exits, así que merece la pena tener claro qué exits van a dónde.
| El invitado hace esto | Lo maneja | Coste |
|---|---|---|
| Toca una página aún no mapeada en EPT/NPT | kvm.ko, en el kernel | Un exit, microsegundos |
| Escribe en su APIC local | La propia CPU, vía APICv/AVIC | A menudo ningún exit |
| Envía una interrupción entre procesadores | Interrupciones diferidas en hardware | A menudo ningún exit |
Transmite en una cola virtio-net con vhost-net | Hilo del kernel, sin salto a espacio de usuario | Un timbre |
| Lee un registro en un controlador e1000 o IDE emulado | Todo el camino hasta QEMU | Un exit más un viaje de ida y vuelta al espacio de usuario |
Solo la última fila se parece algo a la caricatura del tipo 2 — y es también la fila que eliminas por diseño, usando dispositivos virtio y no presentando hardware heredado emulado que no necesitas. Ese es el mismo razonamiento tras elegir Q35 en vez de i440fx: menos accesos a registro atrapados, menos dispositivos heredados que recorrer.
El SO host es una ventaja, no lastre
La otra mitad de ese balance nunca entra en el argumento, así que aquí está: un nodo Proxmox es una máquina en la que de verdad puedes trabajar. Es Debian, así que todo el archivo de Debian está a un apt install de distancia.
- La supervisión que ya ejecutas — un node exporter de Prometheus,
smartmontools, tu agente existente — en vez de lo que el appliance decida exponer. - Diagnósticos cuando algo va lento:
fio,iperf3,nvme-cli,perf,bpftrace. - Agentes de copia de seguridad de cualquier fabricante que envíe un binario de Linux.
- Gestión de configuración, para que el hipervisor se siente en el mismo inventario de Ansible que todo lo demás en vez de ser un caso especial.
fwupdpara el firmware, en hardware cuyo fabricante soporte LVFS.
Nada de eso necesita un formato de plugin, un paquete firmado, ni la bendición del fabricante. Compáralo con el modelo de ESXi, donde el shell está restringido a propósito, el código de terceros llega como un VIB, y no hay gestor de paquetes al que recurrir en absoluto.
Alcanza dentro de la pila de almacenamiento
Los agentes de supervisión son la versión aburrida de esto. La propia documentación de almacenamiento de Proxmox lista los plugins nativos — dir, NFS, CIFS, CephFS, ZFS, BTRFS, LVM, LVM-thin, iSCSI, FC/SAS, RBD, ZFS-over-iSCSI, PBS — y luego añade una frase que merece tomarse al pie de la letra:
you may use all storage technologies available for Debian Linux
Eso es una afirmación sobre dónde está la frontera, y el mecanismo detrás es genérico: consigue un dispositivo de bloque en cada nodo, ponle LVM, añádelo como un almacenamiento LVM con shared habilitado. Así es exactamente como funcionan los caminos soportados de Fibre Channel e iSCSI, así que cualquier cosa que pueda producir un dispositivo de bloque compartido puede usar la misma ruta.
NVMe sobre TCP o RDMA es el caso que merece conocer, porque es rápido, actual, y está ausente de esa lista de plugins. nvme-tcp y nvme-rdma son controladores host de Linux integrados en el árbol — NVMe/TCP está en mainline desde 5.0 — así que no hay nada que compilar. nvme-cli es un paquete de Debian (nvme discover, luego nvme connect), y nvmetcli configura el objetivo nvmet dentro del kernel al otro extremo. Un namespace conectado aparece como /dev/nvmeXnY, y de ahí es un dispositivo de bloque corriente.
ATA over Ethernet demuestra lo mismo desde el extremo opuesto del espectro — antiguo, oscuro, igual de no soportado como plugin. El controlador aoe está en mainline; aoetools te da aoe-discover y aoe-stat; vblade convierte cualquier archivo o dispositivo de bloque de otra máquina en un objetivo. Misma ruta, mismo resultado.
Ninguno es una API de plugin, un SDK, ni un programa de certificación. Es lo que pasa cuando la capa de almacenamiento del hipervisor es la capa de bloques de Linux.
Las salvedades honestas, porque esto se lee como un truco de fiesta hasta que son las 3 de la madrugada. Ninguno de los dos transportes es un tipo de almacenamiento de Proxmox probado, así que la integración y sus modos de fallo — comportamiento de reconexión, multipath, timeouts bajo carga — son tuyos para poseer y tuyos para probar antes de que algo importante viva sobre ello. Y AoE es un protocolo pelado de capa 2, no enrutable y sin autenticación, así que pertenece a una VLAN de almacenamiento aislada y a ningún otro sitio. NVMe/TCP al menos tiene un modelo de descubrimiento y se puede enrutar, que es gran parte de por qué es el que hay que elegir ahora.
Quién más ejecuta KVM
Aquí es de donde viene la afirmación de «ya lo estás ejecutando». Toda plataforma de abajo ejecuta el mismo módulo del kernel.
| Plataforma | Dónde te la encuentras | La parte KVM | El VMM de espacio de usuario |
|---|---|---|---|
| Amazon EC2 (Nitro) | Nube pública | Módulo del núcleo KVM | Propio — QEMU eliminado, modelo de dispositivos en las tarjetas Nitro |
| AWS Lambda, Fargate | Serverless | /dev/kvm | Firecracker — un monitor de microVM mínimo en Rust |
| Google Compute Engine | Nube pública | KVM desde el lanzamiento | El propio VMM de Google, a propósito no QEMU |
| Alibaba Cloud ECS | Nube pública | KVM simplificado (X-Dragon) | Propio, con red y almacenamiento descargados a una tarjeta MoC |
| Oracle Cloud (OCI) | Nube pública | Oracle Linux KVM — la misma pila que Oracle envía on-premises | Linaje QEMU |
| DigitalOcean, Linode/Akamai, Vultr, Hetzner, OVHcloud, Scaleway, UpCloud | Nube pública | KVM de serie | QEMU |
| Nutanix AHV | HCI on-premises | KVM de serie | QEMU con libvirt y Open vSwitch |
| OpenStack (Nova) | Nube privada | KVM de serie | QEMU vía libvirt — el controlador por defecto y mejor probado |
| Apache CloudStack, OpenNebula, oVirt | On-premises | KVM de serie | QEMU vía libvirt |
| OpenShift Virtualization, SUSE Harvester | Kubernetes | KVM de serie | QEMU dentro de un pod, vía KubeVirt |
| Proxmox VE | On-premises | KVM de serie | QEMU, con LXC al lado para contenedores |
Todos se quedan la mitad del kernel y reescriben la mitad del espacio de usuario
Los hyperscalers no bifurcaron KVM. Bifurcaron el trabajo de QEMU.
AWS movió EC2 de Xen al hipervisor Nitro, que está construido sobre el módulo del núcleo KVM con QEMU tirado por completo. El modelo de dispositivos vive en tarjetas Nitro dedicadas en su lugar, que es como consiguen un rendimiento indistinguible del metal desnudo. Cada tipo de instancia EC2 de la generación actual ejecuta esto. Aparte, Lambda y Fargate ejecutan Firecracker, un VMM hecho a propósito en Rust que habla con el mismo /dev/kvm.
Google ha ejecutado cada VM de Compute Engine sobre KVM desde que Compute Engine se lanzó, y escribió su propio VMM de espacio de usuario en vez de usar QEMU, explícitamente para evitar la enorme matriz de invitados, dispositivos y modos de QEMU. También fueron por el otro lado y endurecieron el módulo del kernel en upstream, quitando dispositivos emulados que nadie necesitaba y estrechando el conjunto de instrucciones emuladas. Ese trabajo está en el KVM que estás ejecutando.
Alibaba hizo la misma clase de cosa con X-Dragon: un hipervisor KVM recortado con la virtualización de red y almacenamiento descargada sobre una tarjeta MoC basada en FPGA.
Nutanix AHV es KVM más libvirt más QEMU más Open vSwitch más la orquestación de Nutanix — de todo producto comercial de esa lista, el pariente más cercano que tiene Proxmox VE. Una capa 4 diferente, y una factura muy diferente.
Proxmox VE se queda QEMU a propósito
Es tentador leer la tabla como un ranking, con AWS y Google arriba por haber reemplazado QEMU. Esa es la lectura equivocada, porque su restricción no es la tuya.
AWS y Google ejecutan un perfil de hardware, a una escala donde un solo fallo de emulación de dispositivos es un evento a escala de flota, y controlan cada frontera de imagen de invitado que les importa. En ese mundo la amplitud de QEMU es casi toda pasivo, así que borrarlo es obviamente correcto.
Tú no estás en ese mundo.
Tienes una imagen de appliance de 2013 que quiere un e1000. Tienes una VM de Windows cuyo tipo de máquina debe quedar fijado el resto de su vida. Tienes una GPU que pasar por passthrough, un controlador SAS emulado que satisfacer para un instalador, un almacén de variables UEFI que preservar. QEMU es exactamente lo que le deja a una plataforma de propósito general decir que sí a todo eso.
Lo que AWS llama superficie de ataque es lo que tú llamas una matriz de compatibilidad. Ambas descripciones son exactas; la diferencia es si tú puedes elegir tus cargas.
También explica la forma de esa cola de parches. AWS y Google resolvieron la copia de seguridad y las instantáneas fuera del VMM, en sus propios servicios de almacenamiento. Proxmox no tenía un servicio de almacenamiento en el que resolverlo, así que lo pusieron en QEMU — que es por qué savevm-async y el controlador de bloques de PBS existen como parches en vez de como productos.
Y eso merece conocerse por una razón práctica: las partes de Proxmox VE que más echarías de menos son las partes que no están en upstream. Tus configuraciones de VM son texto plano y tus imágenes de disco son formatos estándar, así que una máquina se moverá. Pero una instantánea que incluya el estado de la RAM, y una cadena incremental de Proxmox Backup Server, dependen del fork de QEMU de Proxmox. Esa es una dependencia mucho más ligera que un hipervisor propietario — el fork es público, AGPL, y puedes leer cada parche que hay en él — pero no es cero, y «sin lock-in a nivel de software» debería llevar esa nota al pie.
Entonces — ¿es de nivel empresarial?
La forma perezosa de este argumento no funciona, y merece decirse claro. «AWS usa KVM, por lo tanto Proxmox VE es de nivel empresarial» es un non sequitur: toma una afirmación sobre una capa y la aplica calladamente a un producto entero.
Aquí está la versión que sí se sostiene.
Lo que se comparte es la capa más difícil de acertar y más peligrosa de errar. La virtualización de CPU y memoria, y la frontera de aislamiento entre inquilinos, es la parte donde un fallo es una brecha en vez de una caída. Ese código lo revisan ingenieros pagados por Amazon, Google, Red Hat, Intel, AMD, IBM y Alibaba, y sus fallos los encuentran las organizaciones que ejecutan las flotas más grandes que existen — normalmente antes de que el kernel te llegue. Cuando una vulnerabilidad de escape de invitado sí aterriza, el arreglo llega a través de la actualización normal del kernel que ibas a aplicar de todos modos. No estás esperando el ciclo de lanzamiento de un fabricante para un hipervisor que solo ese fabricante puede ver.
Lo que no se comparte es todo lo que está por encima de la frontera. Lo que significa que la pregunta se colapsa en dos mucho más contestables:
- ¿Es la capa de gestión lo bastante buena para tu forma de operar?
- ¿Puedes comprar soporte para ella con términos con los que puedas vivir?
Ambas se pueden probar en una prueba de concepto y escribir en un contrato. Ninguna requiere fe en un hipervisor.
Esa es una posición mucho mejor que la que la pregunta original supone — que se te pide confiar en un hipervisor novedoso de un fabricante pequeño. No es así. El código específico de Proxmox es una capa de gestión mayormente en Perl y cada vez más en Rust, más esa cola de parches contra QEMU, y fíjate dónde aterrizan los parches: el modelo de dispositivos y el camino de copia de seguridad, no la frontera de aislamiento.
También merece conocerse lo que cuesta que la capa específica de Proxmox falle. Los procesos de QEMU son procesos independientes corrientes en el host, así que que pveproxy se caiga no detiene ni una sola máquina virtual. Ese es un radio de explosión muy diferente de perder el componente que posee la frontera de aislamiento.
Qué no te compra «el mismo hipervisor»
Aquí es donde los documentos de confianza de los fabricantes tienden a parar, lo que te dice algo sobre para quién están escritos. Es la mitad más útil.
No te compra la fiabilidad de AWS. La disponibilidad de Nitro tiene muy poco que ver con KVM. Viene del plano de control, la red, el servicio de almacenamiento, la gestión de capacidad y la práctica operativa alrededor. La fiabilidad de tu clúster vendrá de tu diseño de quórum de Corosync, tu configuración de fencing, tu elección de almacenamiento y tu redundancia de red. KVM no tiene opinión sobre ninguna de esas. Compartir un hipervisor con un hyperscaler no hereda sus operaciones.
No te compra la superficie de ataque de Nitro, y aquí es donde aterriza la mitad legítima de la acusación del tipo 2.
Estás ejecutando QEMU sobre un kernel de propósito general, e históricamente el modelo de dispositivos de QEMU es donde vivieron los escapes de VM memorables — VENOM, en un controlador de disquete emulado que nadie usaba, siendo el ejemplo canónico. Google podía señalar en su momento que Compute Engine estaba sin afectar precisamente porque no ejecuta QEMU. Tú sí lo ejecutas, así que los controles compensatorios son tuyos: prefiere virtio sobre hardware emulado, no presentes dispositivos que no necesitas, deja en paz los perfiles de AppArmor, y parchea QEMU con la misma disciplina que el kernel. Los parches extra/ de Proxmox son ellos haciendo exactamente eso en tu nombre, que es una cosa razonable de comprobar que siguen haciendo.
No hace el comportamiento de las VM portable entre plataformas.
La selección del modelo de CPU, el versionado del tipo de máquina, la compatibilidad de migración en vivo y el comportamiento del reloj se deciden todos en las capas 3 y 4, y difieren por todas partes. Un clúster de generaciones de CPU mezcladas todavía te castigará por poner el tipo de CPU a host, y los relojes de los invitados aún derivan sea cual sea el logo de la plataforma. Mismo hipervisor no es mismo comportamiento.
No responde a la pregunta del soporte — que es la que a compras de verdad le importa, y con razón. Proxmox VE es AGPLv3 y libre de ejecutar en producción. La suscripción compra el repositorio probado para empresa y el soporte del fabricante, desde 120 € por socket y año. El soporte del propio Proxmox se presta en horario laboral austriaco, así que la cobertura ininterrumpida viene de partners en vez de de Viena. croit, donde trabajo, es uno de esos partners, y cubre 24/7, los 365 días del año. Eso es una negociación comercial, no un riesgo técnico — y que sea una negociación comercial es el objetivo de todo lo anterior.
Qué evaluar de verdad en su lugar
Si el hipervisor está zanjado, una prueba de concepto debería gastar su tiempo en la capa que sí es específica de Proxmox VE:
- Fencing y HA. Corta la corriente de un nodo con invitados HA en marcha y cronometra el reinicio. Luego hazlo con dos nodos y confirma que los restantes se comportan como esperas cuando se pierde el quórum.
- Migración en vivo entre generaciones de CPU. Con el modelo de CPU que de verdad pretendes estandarizar, no
host. - Copia de seguridad y, más importante, restauración. Tiempos de restauración bajo carga, no tiempos de copia. Nadie ha sido nunca agradecido por una copia rápida.
- El modelo de permisos. Si puedes dar a un equipo de aplicación consola y control de encendido sobre sus propias VM y nada más, con granularidad suficiente para satisfacer a un auditor.
- La API. Todo lo que hace la interfaz web es una llamada a la API; si tu automatización no puede conducirla, la plataforma no encajará en cómo trabajas.
- El camino de actualización. Una actualización de versión mayor en el clúster de la PoC, antes de que tengas 400 VM en él.
Ninguna de esas es una pregunta sobre KVM. Ese es más bien el punto.
El hipervisor es la parte zanjada. Gasta la prueba de concepto en las partes que no lo están.
Referencias
El propio KVM
- KVM API documentation — la interfaz ioctl de
/dev/kvm, que es todo el contrato del hipervisor - Linux 2.6.20 release notes — el lanzamiento en el que se fusionó KVM, febrero de 2007
- Some KVM developments — LWN, enero de 2007, sobre KVM en los días posteriores a su llegada a mainline
Cómo están construidos los otros hipervisores
- Interpreting virtual machine monitor and executable failures — la propia descripción de Broadcom de una VM ESXi en marcha como «several processes or userworlds», con un VMM por vCPU y un VMX por VM
- The Architecture of VMware ESXi (PDF) — el whitepaper que llama al VMkernel «a POSIX-like operating system» con procesos, señales, un sistema de archivos e hilos. Enlazado vía un espejo porque la URL original de VMware no sobrevivió a la reorganización de Broadcom, lo que es en sí un pequeño comentario sobre la continuidad de los fabricantes
- Hyper-V architecture — Microsoft sobre el Virtual Machine Worker Process como un componente en modo usuario, uno por VM, donde viven todos los dispositivos emulados
- The Nutanix Bible — AHV architecture — AHV descrito como KVM con libvirt, QEMU y Open vSwitch
Quién ejecuta KVM, y cómo lo cambiaron
- 7 ways we harden our KVM hypervisor at Google Cloud — Google sobre ejecutar KVM sin QEMU, y el endurecimiento en upstream que hicieron
- The AWS Nitro System — qué tipos de instancia EC2 ejecutan el hipervisor Nitro
- AWS EC2 Virtualization 2017: Introducing Nitro — el escrito de Brendan Gregg sobre la transición de Xen a KVM, todavía el relato más claro de ella
- Firecracker — el VMM mínimo basado en KVM de AWS tras Lambda y Fargate
- Alibaba Cloud’s sixth-generation ECS instances — el hipervisor X-Dragon y la descarga a MoC
- KubeVirt — el modelo de QEMU/KVM-en-un-pod tras OpenShift Virtualization y Harvester
- OpenStack Nova hypervisor support matrix — KVM como el controlador de referencia
Qué mantiene Proxmox
- The Proxmox GitHub organisation — 89 repositorios, incluidos
pve-qemu,pve-kernel,pve-edk2-firmwarey el empaquetado delxc,zfsonlinux,openvswitch,libiscsi,corosync-pveyceph pve-qemupatch series — los 78 parches contados arriba, y la forma más rápida de ver exactamente qué añade Proxmox a QEMU- Proxmox VE storage documentation — la lista de plugins nativos, qué tipos de almacenamiento son compartidos, y la línea sobre usar todas las tecnologías de almacenamiento disponibles para Debian Linux
nvme-cliynvmetcli— herramientas de host y objetivo de NVMe-oF;aoetoolsyvbladepara el equivalente ATA over Ethernet. Todo en Debian trixie, que es sobre lo que está construido Proxmox VE 9- Proxmox VE pricing and subscription tiers — qué cubre la suscripción
Divulgación: trabajo para croit, un Proxmox Gold Partner. Las afirmaciones técnicas de arriba están referenciadas y son verificables; el párrafo comercial es la parte donde tengo un interés, así que trátalo en consecuencia.