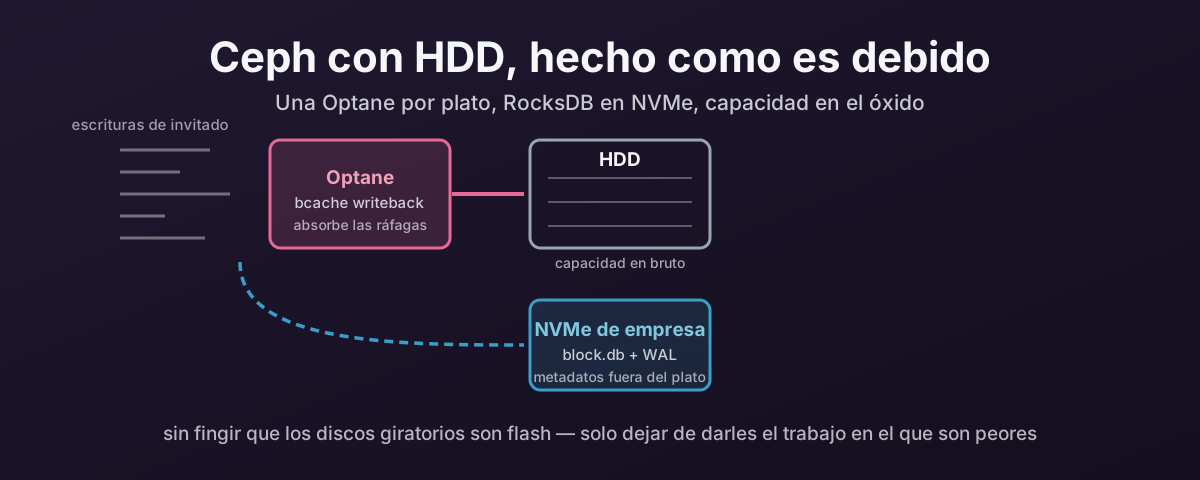
Por qué los HDD vuelven a estar en el menú
Durante años el consejo era bastante simple como para caber en una nota adhesiva: ponlo todo en SSD.
Ese consejo era correcto, y también era barato. Ninguna de las dos cosas es del todo cierta ahora. El suministro de NAND se ha apretado, la demanda de IA ha empujado el precio del flash hacia arriba, y el NVMe de alta capacidad se ha vuelto difícil de justificar para un despliegue de Proxmox consciente del coste — de esos que necesitan ser operativos, fiables, y tan baratos como la honestidad permita.
Los HDD de empresa vuelven a ser interesantes por la misma razón que siempre lo fueron: capacidad por libra, y nada más se le acerca.
La pega es que todo el que ha corrido VM sobre discos giratorios sabe lo mal que puede ir. Esa experiencia es real, y suele ser culpa de la arquitectura y no de los discos.
Echarle la culpa a los discos es más fácil, eso sí. También es equivocado, y es caro, porque convence a la gente de comprar flash que no necesitaba.
Todo lo de abajo asume Proxmox con OSD de Ceph hiperconvergidos, porque ahí es donde las decisiones de disposición de verdad muerden.
El problema es la latencia, no el caudal
Un HDD de empresa moderno mueve datos secuenciales grandes perfectamente bien. Eso nunca fue el cuello de botella.
Un disco de empresa a 7.2k RPM entrega en torno a 80 a 100 IOPS de trabajo aleatorio, porque cada operación aleatoria espera a un desplazamiento del cabezal y una rotación del plato. Ese número apenas se ha movido en veinte años. Es mecánica, no electrónica. Un SSD de empresa de gama de entrada está a tres o cuatro órdenes de magnitud de él.
Dale al mismo disco trabajo secuencial y es un dispositivo útil. La tasa de operaciones más o menos se duplica, a unos 200 IOPS, pero cada una de esas operaciones lleva ahora un bloque grande porque el cabezal ya está en el sitio correcto y puede seguir transmitiendo. Así que obtienes caudal de verdad, 150 a 250 MB/s de él, a un precio por terabyte que nada más toca.
Esa es la asimetría importante, y no es «los HDD son lentos». Un disco giratorio es bueno en trabajo secuencial y inútil en trabajo aleatorio, y los dos números están juntos solo porque la cosa acotada es el recuento de operaciones, no los bytes.
Lo que marca todo el pliego de diseño. No estás intentando hacer el disco más rápido. No puedes. Estás intentando arreglar que pase su tiempo en el modo en el que ya es competente, y mantener el pequeño tráfico aleatorio lejos de él. Como tal, todo lo que sigue es esa única idea aplicada dos veces.
El problema es que las máquinas virtuales no generan la carga de trabajo en la que los HDD son buenos. Generan actualizaciones de metadatos, escrituras de diario, pequeños vaciados síncronos, registro, tareas domésticas de sistema de ficheros, y ráfagas de actividad aleatoria de una docena de invitados a la vez que llegan entrelazadas al disco.
Ceph añade su propia capa a esto. Cada escritura lleva actualizaciones de metadatos de RocksDB junto a los datos. Si todo eso aterriza en platos en bruto, los discos pasan su tiempo desplazándose en vez de sirviendo, y obtienes el síntoma que todo administrador reconoce: alta espera de E/S, invitados lentos, respuesta inconsistente, y un clúster que se siente mucho más lento de lo que su hoja de capacidad sugiere.
La propia guía de hardware de Ceph es franca sobre a dónde lleva esto. Advierte que hay que «consider carefully the ostensible cost-per-gigabyte advantage of larger HDDs, and the concomitant limitations of IOPS per TB» — sopesar con cuidado la ventaja aparente de coste por gigabyte de los HDD grandes contra las limitaciones concomitantes de IOPS por TB — y dice que los discos por encima de 8 TB «may be best suited for storage of large files / objects that are not at all performance-sensitive» — pueden estar mejor destinados a almacenar ficheros u objetos grandes que no son en absoluto sensibles al rendimiento.
Vale la pena hacer esa aritmética, porque los discos que hacen esto económico de entrada son los grandes. 20 TB para arriba. Un disco de 20 TB sigue haciendo sus 80 a 100 IOPS aleatorias, porque la capacidad no te compra operación alguna. Así que ofrece unas 4 a 5 IOPS aleatorias por terabyte, donde un disco de 8 TB alcanza unas once, y uno de 2 TB cuarenta.
Por la propia medida de Ceph, entonces, un plato de 20 TB está bien dentro del territorio en el que te dice que no pongas cargas sensibles al rendimiento.
Eso no es un argumento contra comprarlos. Es la razón por la que existe el resto de este artículo. El diseño de abajo es exactamente lo que hace viable un plato de 20 TB para almacenar VM, arreglando que el pequeño trabajo aleatorio nunca lo alcance.
Saca los metadatos fuera del plato
El cambio de mayor valor para un clúster con HDD es dejar de hacer que el plato guarde la contabilidad de Ceph.
BlueStore guarda tres cosas por OSD: los datos en sí en block, la base de datos de metadatos RocksDB en block.db, y el registro de escritura anticipada en block.wal. Por defecto los tres viven en el mismo dispositivo. Pon block.db en NVMe en su lugar y una gran cantidad de E/S aleatoria pequeña abandona el disco del todo.
La documentación de hardware de Ceph lo dice claramente: «HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD» — los OSD de HDD pueden ver una mejora significativa de latencia de escritura descargando WAL+DB a un SSD.
Usa NVMe de empresa en condiciones aquí, no flash de consumo. La razón no son los números de benchmark de titular. Es la latencia estable bajo carga sostenida, y la protección contra pérdida de corriente. La documentación de Ceph es directa: «Enterprise-class SSDs are best for Ceph: they feature power loss protection (PLP)» — los SSD de clase empresa son los mejores para Ceph, tienen protección contra pérdida de corriente — y «bargain client-class or off-brand SSDs are a false economy» — los SSD de gama de cliente de saldo o de marca desconocida son una economía falsa.
Discos de la clase de los Samsung PM9A3 y Micron 7450 Pro son el tipo de cosa que pertenece aquí. Bajo presión de escritura a Ceph le importa la consistencia mucho más que los números pico, y eso es exactamente lo que separa un disco de empresa de uno de consumo rápido.
Dimensionar block.db, y qué cuesta el desbordamiento
Equivócate en el tamaño y el beneficio se evapora en silencio, porque cuando block.db se llena, RocksDB no falla — se desborda de vuelta al dispositivo lento, exactamente donde habría estado sin el NVMe.
Ese es el peor de los dos mundos: has comprado el flash y sigues desplazándote en el plato.
La guía actual de Ceph:
| Carga de trabajo | block.db como fracción de block |
|---|---|
| RBD / bloque — discos de VM | 1% a 2% |
| RGW / objeto | al menos 4% |
| Recomendación general al descargar WAL+DB | al menos 2.5% |
El almacenamiento de VM de Proxmox es la fila RBD, así que 1–2% es la cifra de planificación honesta, y 2.5% es un sitio cómodo en el que quedarse.
Corre eso contra un disco de 20 TB y los números te llaman la atención:
block.db para un OSD de 20 TB | |
|---|---|
| Al 1% | 200 GB |
| Al 2% | 400 GB |
| Al 2.5% | 500 GB |
Toma eso con los escalones de nivel de RocksDB de abajo y 300 GB por OSD es el punto de aterrizaje sensato. El escalón útil más cercano al centro del rango.
Lo que cambia lo que el dispositivo de metadatos compartido de verdad es. Ocho OSD de 20 TB quieren 2.4 TB de NVMe entre ellos; quince de ellos, el máximo que Ceph indica detrás de un NVMe, quieren 4.5 TB. En discos de este tamaño es la capacidad de DB la que decide cuántos OSD se sientan detrás de un dispositivo, no el ratio. Te quedarás sin gigabytes mucho antes de quedarte sin la bendición de Ceph.
Hay un matiz más que vale la pena conocer, porque hace que el dimensionado intuitivo sea erróneo. La estructura de niveles de RocksDB significa que una partición de DB solo puede usar del todo tamaños que corresponden a las sumas de sus niveles — históricamente produciendo escalones útiles alrededor de 3 GB, 30 GB y 300 GB, con tamaños intermedios que no ofrecen nada por encima del escalón de abajo. Redondear 18 GB arriba a 30 GB suele ser gratis en la práctica; redondearlo abajo a 20 GB no te compra nada por encima de 3 GB en el peor caso.
Comprueba el desbordamiento después de que el clúster haya estado corriendo un tiempo, no en el día uno. Es un problema de aparición lenta.
No necesitas un dispositivo WAL aparte
Este ahorra una partición y un montón de trasteo.
Si especificas un dispositivo de DB y ningún dispositivo WAL explícito, Ceph pone el WAL en el dispositivo rápido con la DB de forma automática. La documentación afirma que «whenever a DB device is specified but an explicit WAL device is not, the WAL will be implicitly colocated with the DB on the faster device» — cada vez que se especifica un dispositivo de DB pero no uno WAL explícito, el WAL se colocará implícitamente junto a la DB en el dispositivo más rápido.
Así que «pon la DB y el WAL en NVMe» es el objetivo correcto, pero es un argumento, no dos. Un block.wal aparte solo tiene sentido si tienes una tercera capa, más rápida, en la que ponerlo.
Apaga el cache de escritura del HDD
Pequeño, sin glamur, y fácil de pasar por alto.
La documentación de Ceph nota que el rendimiento de un OSD «may be dramatically increased … by disabling this write cache» — puede aumentarse drásticamente desactivando este cache de escritura — en los HDD. El cache volátil del disco reordena y retrasa escrituras de maneras que pelean con la semántica de vaciado de Ceph, y apagarlo suele hacer las cosas más rápidas en vez de más lentas.
Se vuelve obligatorio en vez de aconsejable en cuanto bcache está de por medio, que es la siguiente sección.
Ya que estás dentro: no necesitas un HBA capaz de RAID. Ceph lo dice directamente: «You do not need an RoC (RAID-capable) HBA» — no necesitas un HBA capaz de RAID (RoC). Dales los discos a los OSD.
Una Optane por plato
Sacar los metadatos del disco arregla el estado estacionario. No arregla las ráfagas, porque una ráfaga de pequeñas escrituras síncronas todavía tiene que ser reconocida, y el plato sigue reconociendo a velocidad de plato.
Para eso está bcache, y lo que hace que funcione aquí es Optane.
Lo que importa no es la capacidad. Es el comportamiento bajo carga de escritura. Frente a la NAND, Optane ofrece latencia muy baja, resistencia muy alta, y ninguno de los precipicios de recolección de basura que hacen impredecible el rendimiento de cache de escritura de un SSD una vez que ha estado en servicio un tiempo. Absorber tráfico pequeño, a ráfagas, cargado de escritura es la cosa en la que es el mejor del mundo.
La disposición que importa: una Optane por HDD, cada pareja su propio dispositivo bcache. No una Optane compartida entre una estantería de discos.
El emparejamiento es una elección deliberada, y compra dos cosas.
Sin contención. Cada plato tiene una Optane entera de latencia y profundidad de cola para él solo, en vez de hacer cola detrás de las ráfagas de otros siete OSD.
Un dominio de fallo que Ceph ya sabe cómo sobrevivir. Un cache de escritura compartido guarda datos sucios de cada OSD detrás de él, así que perderlo los pierde todos a la vez; emparejado uno a uno, perder una Optane cuesta exactamente un OSD. Esa distinción es la consecuencia más importante de este diseño, y tiene su propio tratamiento en lo que estás cediendo.
Esto tiene que ser Optane. No NAND.
La palabra «Optane» no es una preferencia de marca ni un capricho aquí. Sustituir por un NVMe NAND — por caro que sea — construye algo que se desgasta, y la razón es la resistencia.
Mira dónde se sienta el dispositivo de cache. Porque este diseño apaga el bypass secuencial de bcache — el sequential_cutoff=0 en la regla de abajo — cada una de las escrituras a ese OSD pasa por él: no solo las ráfagas, todo. Eso hace del cache el dispositivo de mayor ciclo de servicio del nodo, al que se le pide absorber el volumen de escritura de un disco giratorio entero durante la vida de la máquina.
La resistencia se cita en escrituras de disco por día, y la brecha no es incremental:
| Dispositivo | Resistencia nominal |
|---|---|
| Optane P5800X | 100 DWPD |
| Optane P4800X | 30 DWPD |
| NAND de empresa intensiva en escritura, tope de gama | alrededor de 10 DWPD |
| NAND de empresa de uso mixto | 3 DWPD o menos |
| NAND de empresa mayoritaria — clase PM9A3, 7450 Pro | alrededor de 1 DWPD |
Optane es entre diez y cien veces la resistencia de la NAND que si no pondrías ahí. Pon un disco de 1 DWPD en la única posición que recibe cada escritura del clúster y no has construido un cache, has construido un consumible.
Es peor de lo que la tabla sugiere, porque la NAND sufre amplificación de escritura internamente y Optane no. El DWPD nominal de un disco NAND es lo que aguanta en la interfaz; lo que sus celdas de verdad absorben es mayor. El número de Optane no necesita tal asterisco.
Las reconstrucciones son donde eso se pone a prueba. El relleno empuja terabytes de escrituras a través de los nodos supervivientes en una ventana comprimida, cada byte de ello a través de sus dispositivos de cache — un evento de resistencia, no meramente de latencia, que llega justo cuando menos quieres que un segundo dispositivo falle.
Así que las dos capas de flash quieren discos distintos, por razones distintas:
| Capa | Volumen de escritura | Qué necesita el dispositivo |
|---|---|---|
| DB/WAL | pequeño — solo RocksDB | Un NVMe de empresa rápido. Baja latencia, altas IOPS aleatorias, PLP. La NAND de empresa es la tecnología correcta; un PM9A3 o 7450 Pro es la compra correcta |
| Cache de escritura | todo | PLP y resistencia en las decenas de DWPD. La NAND es la tecnología equivocada a cualquier precio |
Comprar un solo tipo de disco para ambos trabajos es el error que esta sección existe para prevenir — pero no leas la primera fila como permiso para economizar, porque bajo volumen de escritura no es baja exigencia.
El dispositivo de DB/WAL todavía tiene que ser un NVMe de verdad rápido, por tres razones que nada tienen que ver con cuántos bytes lo cruzan.
Sirve a cada OSD detrás de él a la vez, así que la cola que ve es de cuatro o quince conjuntos de tráfico de metadatos, no el de un disco.
Su latencia aterriza directamente sobre tus clientes. Las búsquedas de RocksDB se sientan en el camino crítico para encontrar objetos, para el emparejamiento y para el scrub, y son lecturas aleatorias pequeñas. La carga de trabajo donde la brecha entre un NVMe rápido y uno mediocre es más ancha. Cada microsegundo se multiplica por cada OSD que depende de él.
Y la compactación es a ráfagas. RocksDB reescribe periódicamente sus niveles, convirtiendo el batir constante en un pico concentrado de lecturas y escrituras. Un dispositivo que aguanta la media y se atasca en el pico atasca cada OSD detrás de él en el mismo momento.
Los propios ratios de Ceph son la pista. Permite tres veces más OSD detrás de un NVMe que detrás de un SSD SATA, y eso es la interfaz y la clase de dispositivo hablando, no la capacidad. Usa NVMe.
Así que: el dispositivo de cache tiene que ser Optane, el dispositivo de DB/WAL puede ser NAND, y ninguna de las dos posiciones es donde ahorras dinero.
Qué Optane: una M10 de 32 GB serviría a menudo
Nada de eso significa que la Optane más grande sea la correcta. El dispositivo que necesitas lo decide tu carga de escritura — aunque, como resulta, el mercado de segunda mano puede decidirlo por ti de todos modos. La aritmética sigue importando, porque te dice qué estás sobrecomprando o infracomprando.
Empieza por para qué sirve el cache. Guarda una ráfaga, no un disco. A writeback_percent=40 un dispositivo de 32 GB da unos 13 GB de buffer sucio, que es un número enorme de pequeñas escrituras síncronas.
Así que no te eche para atrás el ratio. Un módulo de 32 GB delante de un disco de 20 TB es el 0.16% de él, lo que suena absurdo hasta que recuerdas que es un absorbedor de ráfagas y no un cache de conjunto de trabajo intentando guardar datos calientes. Un dispositivo de 375 GB delante del mismo disco es el 1.9%, que es simplemente más margen del que usarás.
Lo que pone el extremo barato del rango en juego. Aquí está el módulo pequeño de consumo contra la pieza de centro de datos, porque la brecha no está donde la gente espera:
| Optane Memory M10 32 GB | Optane DC P4800X 375 GB | |
|---|---|---|
| Lectura aleatoria, 4K | 240 000 IOPS | 550 000 IOPS |
| Escritura aleatoria, 4K | 65 000 IOPS | comparable a la lectura |
| Lectura secuencial | 1200 MB/s | 2400 MB/s |
| Escritura secuencial | 290 MB/s | 2000 MB/s |
| Latencia típica | — | menos de 10 µs |
| Resistencia | 365 TBW | 12.3 PBW — 30 DWPD |
| Interfaz | PCIe 3.0 x2, M.2 2280 | PCIe 3.0 x4, U.2 o AIC |
Mira primero la fila de IOPS de escritura. La pequeña M10 hace 65 000 escrituras aleatorias por segundo; el plato detrás de ella hace 80. Incluso la Optane más barata es unas 650 veces el disco que está cacheando, así que en el eje de rendimiento el argumento se acaba antes de empezar. Las IOPS de más de la pieza DC no tienen a dónde ir cuando hay un disco de 7.2k aguas abajo.
La fila que decide la compra es la resistencia, donde la brecha es de 34×. Convertida en un presupuesto diario a lo largo de una vida de cinco años:
| Dispositivo | Escrituras sostenibles por día, a lo largo de cinco años |
|---|---|
| M10 32 GB — 365 TBW | unos 200 GB/día |
| P4800X 375 GB — 12.3 PBW | unos 6.7 TB/día |
Por debajo de 200 GB de escrituras al día una M10 de 32 GB aguanta hasta el final del montaje. Al doble de eso obtienes dos años y medio. De verdad cargado de escritura y la pieza DC gana su precio — no por las IOPS, que no puedes usar, sino por las treinta y pico veces más escritura que tolera.
Así que mide en vez de adivinar. nvme smart-log en un dispositivo de cache existente te da data_units_written; muestréalo con una semana de diferencia, divide, y compara contra el TBW nominal de lo que estés considerando. bcache guarda sus propios totales bajo /sys/block/bcacheN/bcache/stats_total/ si prefieres leerlo ahí.
Dos salvedades sobre la M10. Sus cifras aleatorias se citan sobre una franja de 8 GB en vez del dispositivo completo, así que en un cache que pretendes correr sustancialmente lleno, trátalas como el extremo optimista. Y es una pieza de consumo que no lleva ninguna reclamación de PLP de empresa — el medio de Optane se escribe en el sitio sin buffer DRAM en el camino de escritura, que es por lo que estos módulos se comportan mucho mejor ante una pérdida de corriente súbita de lo que lo haría la NAND de consumo, pero «se comporta bien en la práctica» no es una especificación. Si quieres la garantía por escrito, compra una pieza de serie DC.
El suelo es el ancho de banda, no la capacidad — sáltate los módulos de 16 GB
Hay una segunda restricción, independiente de todo lo de arriba, y descalifica la pieza más barata del rango.
El cache tiene que ser más rápido que el disco en secuencial, o es un estrangulador. La M10 de 16 GB no lo es, y es el módulo por el que más tentado estarás porque es casi gratis:
| Escritura secuencial | |
|---|---|
| Optane Memory M10 16 GB | 150 MB/s |
| Optane Memory M10 32 GB | 290 MB/s |
| Optane DC P4800X 375 GB | 2000 MB/s |
| Un HDD de empresa a 7.2k | 150–250 MB/s |
Lee la primera y la última fila juntas. Un módulo de 16 GB escribe en secuencial a más o menos la misma velocidad que el disco giratorio que se supone que está acelerando, y más lento que uno bueno. Sigue siendo tremendamente más rápido para trabajo aleatorio — 35 000 IOPS de escritura aleatoria contra las 80 del disco — pero en un flujo secuencial es en el mejor caso un empate y en el peor un techo por debajo de lo que el disco pelado lograba sin ayuda.
Y este diseño te garantiza que llegues a ese techo, porque apagar el bypass secuencial manda todo a través del cache, haciendo del propio ancho de banda de escritura secuencial del cache el techo duro para todo el OSD. La recuperación es donde más muerde: rellenar un OSD de 20 TB es lo más secuencial que esta carga de trabajo llega a ser, y limitarlo a 150 MB/s hace más lenta una reconstrucción ya lenta.
Así que la línea M10 tiene un suelo en 32 GB, y es un suelo de ancho de banda en vez de uno de capacidad. La aritmética de capacidad decía que 32 GB era de sobra; la aritmética de ancho de banda descarta los 16 GB por poco que necesitaras almacenar. Ambas pruebas tienen que pasar, y la pieza barata falla la que la gente no comprueba.
Sea lo que sea lo que estés considerando, pon su cifra de escritura secuencial al lado de 250 MB/s antes de comprarlo.
Comprar un producto que ya nadie fabrica
Optane está descontinuado. Intel liquidó el negocio en 2022, dando de baja 559 millones de dólares de inventario y terminando el desarrollo. No hay nueva producción y no hay reposición; el suministro total solo baja a partir de aquí.
Lo que plantea una pregunta obvia, porque hay una cantidad sorprendente a la venta. Entender de dónde viene te dice qué estás comprando.
Es inventario de repuestos de servicio OEM que se está liquidando. Los tres grandes fabricantes de servidores tenían Optane en stock como repuestos para dar soporte a las plataformas en las que la vendían. Esas plataformas se han quedado sin vida útil y han caído del soporte, así que los repuestos que las respaldaban se convirtieron en stock muerto de la noche a la mañana — almacenes de piezas para máquinas que nadie está contractualmente obligado a reparar ya. Ese inventario es lo que fluye hacia AliExpress y los reacondicionadores.
Dos consecuencias, y las dos son buenas noticias.
Mucho de ello está sin usar en vez de retirado. Los repuestos de servicio estuvieron en una estantería esperando un fallo que nunca llegó, así que la cifra de desgaste a la llegada suele ser efectivamente cero — no «unos años de servicio ligero» sino nunca escrito. Verifica en vez de fiarte: nvme smart-log te da percentage_used y data_units_written, y en stock de repuestos genuino esos deberían ser asombrosamente bajos. Cualquier cosa que muestre desgaste real es un retirado vendido como otra cosa, aunque incluso entonces el margen de resistencia significa que una Optane usada puede tener más vida por delante que un disco NAND nuevecito de la misma capacidad.
Explica qué capacidades vas a encontrar. Los repuestos OEM se tenían en stock para servidores, lo que significa piezas de centro de datos. Aquí está el rango completo, y fíjate en dónde empieza el buque insignia:
| Pieza | Capacidades | Formato |
|---|---|---|
| Optane Memory M10 | 16, 32, 64 GB | M.2 2280, consumo |
| Optane SSD 800P | 58, 118 GB | M.2 2280, consumo |
| Optane SSD P1600X | 58, 118 GB | M.2 2280, pieza de arranque y cache de centro de datos |
| Optane SSD DC P4801X | 100, 200, 375 GB | M.2 110 mm o U.2 |
| Optane SSD DC P4800X | 375 GB en su menor, 750 GB, 1.5 TB | U.2 o tarjeta añadida |
| Optane SSD P5800X | 400 GB, 800 GB, 1.6 TB | U.2 o tarjeta añadida |
En teoría las pequeñas piezas M.2 son la respuesta elegante — la M10, la 800P, la P1600X y la P4801X de 100 GB todas hacen el trabajo, y barato. En la práctica el mercado no las tiene, porque nadie almacenó módulos aceleradores de escritorio como repuestos de servidor. Lo que hay listado es 375 GB para arriba, hardware de clase P4800X.
Así que planea comprar más capacidad de la que el papel necesita, porque eso es lo que está a la venta. No es un mal resultado. Sobrecomprar un dispositivo de cache te deja en 30 DWPD y latencia sub-10 µs cuando tu carga de trabajo exigía una fracción de cualquiera de las dos, y para un plato de 20 TB que pretendes conservar años, esa es la manera correcta de errar. Sí significa que el precio de entrada es más alto de lo que la aritmética sugiere, y que el dimensionado de arriba se vuelve una comprobación contra la infracompra en vez de una lista de la compra.
Tres cosas que planear, ya que esto es una liquidación en vez de una cadena de suministro:
Compra tus repuestos con el montaje. Se está aclarando un pozo finito. Cuando un dispositivo falle dentro de tres años no estarás pidiendo un reemplazo, estarás cazándolo — así que presupuesta los repuestos ahora, mientras el stock está ahí.
Espera firmware OEM y comprueba el namespace. Las piezas de un programa de repuestos de un fabricante a menudo llevan el firmware de ese fabricante y pueden llegar formateadas a un tamaño de LBA o con ajustes de metadatos que convienen a lo que fuera para lo que estaban en stock. Confirma con nvme id-ns antes de construir sobre ella, y ten listo nvme format a un formato llano de 4096 bytes.
No hay garantía, no hay soporte, y no hay más actualizaciones de firmware. La propia nota de soporte de Intel cubre qué significa la liquidación para dispositivos ya en servicio, que es la posición en la que ya está cualquier cosa que compres. Verificar que la pieza que llegó es la pieza del anuncio corre de tu cuenta.
bcache no reemplaza la descarga de DB/WAL
Vale la pena decirlo de forma explícita, porque es el sitio obvio en el que intentar ahorrar dinero y no funciona: todavía necesitas block.db en NVMe. Ambas capas, no una o la otra.
La Optane es un cache de escritura. Eso es todo lo que es. Acorta el camino de reconocimiento de las escrituras que van hacia el disco, y no hace nada más.
RocksDB no solo escribe. Ceph lee sus metadatos constantemente — para encontrar objetos, para servir el emparejamiento, para responder scrubs — y un cache de escritura ofrece a una lectura exactamente nada una vez que los datos han sido vaciados de él. Tampoco quita el cache el tráfico de metadatos; lo aplaza y lo agrupa, así que cada actualización de RocksDB llega al plato eventualmente, compitiendo por los mismos desplazamientos. Y la compactación convierte un batir modesto en mucho más tráfico de dispositivo que las escrituras que lo causaron.
Así que los dos cambios arreglan problemas distintos y ninguno sustituye al otro:
| Qué arregla | Qué no | |
|---|---|---|
block.db en NVMe | los metadatos viven en flash — lecturas y escrituras ambas, permanentemente fuera del plato | nada para una ráfaga de escrituras de invitado |
| Optane vía bcache | latencia de reconocimiento de ráfaga para escrituras de datos | nada para las lecturas de metadatos; solo aplaza las escrituras de metadatos |
Sáltate la descarga de DB y quédate la Optane, y RocksDB está de vuelta en el plato con sus lecturas servidas a 80 IOPS. Sáltate la Optane y quédate la descarga de DB, y el estado estacionario es decente pero las ráfagas todavía se atascan a velocidad de plato.
La regla udev, línea por línea
Los ajustes de bcache viven en sysfs, y sysfs los reinicia cada vez que el dispositivo se registra — que es cada arranque. Así que pertenecen a una regla udev en vez de a un script que alguien tiene que acordarse de correr:
# /etc/udev/rules.d/99-bcache.rules
ACTION=="add|change", SUBSYSTEM=="block", KERNEL=="bcache*", \
  ATTR{bcache/cache_mode}="writeback", \
  ATTR{bcache/sequential_cutoff}="0", \
  ATTR{bcache/congested_read_threshold_us}="0", \
  ATTR{bcache/writeback_rate}="81920", \
  ATTR{bcache/writeback_rate_minimum}="20480", \
  ATTR{bcache/writeback_percent}="40"
KERNEL=="bcache*" casa con cada dispositivo bcache del nodo, así que una regla cubre todas las parejas. ACTION=="add|change" significa que se reaplica cada vez que un dispositivo aparece o se readjunta, no solo al arranque.
Qué hace cada ajuste, y por qué:
cache_mode=writeback — el objeto entero. En el writethrough por defecto, una escritura no se reconoce hasta que alcanza el HDD, así que el cache no hace nada por la latencia de escritura. En writeback, la Optane reconoce y el plato se pone al día después.
sequential_cutoff=0 — por defecto bcache detecta E/S secuencial y la enruta directa más allá del cache una vez que pasa de 4 MB, sobre la teoría de que el disco de respaldo maneja lo secuencial bien. Cero desactiva ese bypass para que todo se cachee. En un nodo hiperconvergido esa es la decisión correcta: lo que parece secuencial a un dispositivo bcache deja de ser secuencial en el plato una vez que varios OSD se entrelazan, y quieres cada escritura reconocida a velocidad de Optane pase lo que pase. Sí conlleva una obligación, eso sí — sin bypass, el propio ancho de banda de escritura secuencial del dispositivo de cache se vuelve el techo para todo el OSD, que es por qué los módulos de 16 GB quedan descalificados.
congested_read_threshold_us=0 — bcache vigila la latencia de su propio dispositivo de cache y empieza a saltarse el cache cuando lo juzga congestionado, por defecto a 2000 µs para lecturas. Optane no se congestiona de la manera en que lo hace la NAND, así que esto es bcache dudando de un dispositivo que ha malmedido. Cero apaga el seguimiento.
writeback_rate=81920 y writeback_rate_minimum=20480 — la tasa de vaciado de fondo, en sectores por segundo, así que un objetivo de unos 40 MB/s con un suelo de 10 MB/s. Un controlador PD mueve la tasa real entre ellos. El objetivo se pone cerca de lo que un plato puede absorber en secuencial, y el suelo impide que el controlador estrangule el vaciado hacia cero y deje que los datos sucios se acumulen indefinidamente. Ambos son puntos de partida en vez de constantes — cómo cambiarlos está abajo.
writeback_percent=40 — cuánto del cache dejará bcache que se quede sucio antes de empujar fuerte hacia atrás, contra un valor por defecto de 10. Cuarenta te da un buffer de ráfaga mucho más profundo. También significa que hasta el 40% de esa Optane guarda la única copia de datos del sistema, que es el compromiso, y es la razón por la que la disposición de una-por-plato importa. Este es el valor que más vale la pena revisar una vez que has observado una carga de trabajo real.
Cambiar los valores de llenado y vaciado más tarde
El 40% y las dos tasas de arriba son los valores que corren aquí, no constantes universales. Son lo primero que querrás mover una vez que has observado una carga de trabajo real, así que vale la pena saber que hay dos sitios donde cambiarlos, haciendo dos cosas distintas.
sysfs lo cambia ahora. La regla udev lo cambia al siguiente arranque. Quieres ambos, y en ese orden.
Cámbialo en vivo, en un dispositivo:
echo 30 > /sys/block/bcache0/bcache/writeback_percent
O en cada pareja del nodo:
for d in /sys/block/bcache*/bcache; do
  echo 30 > "$d/writeback_percent"
done
La tasa de vaciado funciona igual. Ambos valores son en sectores por segundo, así que estos reducen a la mitad el objetivo y el suelo:
for d in /sys/block/bcache*/bcache; do
  echo 40960 > "$d/writeback_rate"
  echo 10240 > "$d/writeback_rate_minimum"
done
Eso surte efecto de inmediato y sobrevive exactamente hasta que el dispositivo se vuelve a registrar. La documentación del kernel es explícita en que estos ajustes «do not persist across reboot» — no persisten a través del reinicio — que es la razón entera por la que la regla udev existe.
Una vez que estés contento con un valor, edita la regla y recárgala sin reiniciar:
udevadm control --reload
udevadm trigger --subsystem-match=block --action=change
Aquí es donde ACTION=="add|change" gana su sustento. El disparo lanza un evento change a los dispositivos que ya están presentes, así que la regla se reaplica a un nodo en marcha en vez de esperar al siguiente arranque. Si la regla hubiera casado con add solo, ese comando no haría nada.
Luego relee los valores, porque una errata en una regla udev falla en silencio:
grep . /sys/block/bcache*/bcache/writeback_percent
Saber en qué sentido moverlos
No ajustes esto desde primeros principios — bcache expone lo que necesitas bajo el mismo directorio de sysfs.
dirty_data es el que vigilar: cuántos datos están sentados ahora mismo en el cache y en ningún otro sitio. La documentación lo describe como «continuously updated unlike the cache set’s version, but may be slightly off» — actualizado continuamente a diferencia de la versión del conjunto de cache, pero puede estar ligeramente desfasado — lo que está bien para este propósito. Muestréalo a lo largo de un día de trabajo normal y una ventana de copia de seguridad.
cache_hits, cache_misses y cache_hit_ratio te dicen si el cache se está usando, con la salvedad de que «a partial hit is counted as a miss» — un acierto parcial se cuenta como fallo. bypassed cuenta la IO que se saltó el cache del todo — con sequential_cutoff=0 eso debería estar cerca de plano, así que un número creciente significa que algo todavía se está enrutando alrededor de él.
Todos esos vienen como totales corrientes más versiones que decaen a lo largo del último día, hora y cinco minutos, lo que hace las de ventana corta mucho más útiles para detectar un problema que la cifra de por vida.
De ahí:
| Síntoma | Mando | Sentido |
|---|---|---|
| Las ráfagas se atascan — las escrituras topan con la latencia del plato a media ráfaga | writeback_percent | arriba, para un buffer más profundo |
| Más datos expuestos en el cache de los que te resultan cómodos | writeback_percent | abajo |
dirty_data clavado en el techo durante trabajo ordinario | writeback_rate | arriba — el buffer no es el problema, el drenaje sí |
| Vaciado de fondo compitiendo con las lecturas de invitado en el plato | writeback_rate | abajo |
dirty_data trepando a lo largo de días en vez de horas | writeback_rate_minimum | arriba, para que el controlador no pueda estrangular hasta el paso de tortuga |
Si dirty_data se queda clavado en el techo hagas lo que hagas, ninguno de los mandos es la respuesta — el clúster está escribiendo más rápido de lo que los platos pueden absorber, y los arreglos honestos son más platos o menos escrituras.
Un fichero que dejar en paz: writeback_running. Ponerlo en apagado detiene el writeback del todo, y la documentación dice que es «only meant for benchmarking» — solo pensado para hacer benchmarks. En un OSD de producción significa que los datos sucios se acumulan hasta que el cache está lleno y nunca se drenan.
Lo que estás cediendo
La mayoría de los artículos sobre este diseño se paran en las buenas noticias. Estas son las partes que de verdad te harán daño, y cada una vale la pena conocerla antes de construir en vez de después.
Perder cualquiera de los dos dispositivos de flash destruye el OSD. No lo para — lo destruye. Ambos dispositivos guardan estado que no existe en ningún otro sitio: block.db guarda el RocksDB que da sentido a block, y un cache de writeback guarda cada escritura aún no vaciada. La documentación del kernel no se anda con rodeos sobre el segundo: «In writeback mode you’ll lose data if something happens to your SSD» — en modo writeback perderás datos si algo le pasa a tu SSD. De cualquier modo el OSD no vuelve, se recrea y se rellena.
Así que estos son la misma clase de riesgo, y vale la pena ser claro sobre eso en vez de tratar el cache como el que da miedo. La Optane no es un dispositivo más peligroso que el NVMe. Dos cosas los separan, y ninguna es la severidad por OSD.
La primera es el radio de explosión, y es la justificación entera del emparejamiento. Una Optane por plato significa que un fallo de cache cuesta un OSD — una pérdida de un solo disco, que es exactamente el evento que un pool replicado existe para absorber, y que Ceph maneja sin que a nadie le llegue un aviso. El dispositivo de DB/WAL se comparte, así que perderlo cuesta cada OSD detrás de él a la vez, que es un fallo correlacionado del que la replicación no te protege. El mismo fallo, un dispositivo contra cinco.
La segunda es cómo se presenta el fallo, y esta es una trampa operativa. Cuando un cache muere en writeback el dispositivo de respaldo se detiene y devuelve errores de E/S, lo que está bien — Ceph marca el OSD como caído y sigue adelante. El caso malo es un reinicio donde el dispositivo de respaldo sube sin su cache adjuntado. Entonces parece un sistema de ficheros montable al que simplemente le falta cada escritura sucia, que es corrupto en vez de meramente rancio. Un block.db ausente falla con estruendo y el OSD se niega a arrancar; un cache ausente puede fallar en silencio y dejarte montar los restos. Trata un dispositivo de respaldo de bcache como no montable sin su cache, y nunca dejes que nada te lo monte servicialmente.
bcache no garantiza el writeback a prueba de corte de corriente por sí solo. Aquí es donde el cache de escritura del HDD deja de ser una optimización y se vuelve un requisito — apágalo, y corre un kernel lo bastante reciente como para tener el manejo de FUA, para que las escrituras síncronas se honren a través de la pila en vez de reconocerse pronto en algún punto del medio. Un dispositivo de cache sin protección contra pérdida de corriente agrava el problema, porque puede perder datos que ya ha reportado a salvo.
Lo que hace del ratio de DB/WAL el número que importa. Ceph permite 4–5 OSD de HDD por SSD SATA y no más de 15 por NVMe, y advierte sobre «balancing the risk of reducing costs by placing too many responsibilities into too few failure domains» — equilibrar el riesgo de reducir costes metiendo demasiadas responsabilidades en demasiado pocos dominios de fallo. A diferencia de la capa de cache no hay emparejamiento disponible para contener este — compartir es el objeto del dispositivo.
En discos de 20 TB esa es toda la conversación, porque la reconstrucción es enorme. Un OSD fallido son 20 TB que rellenar; a los 150–250 MB/s que un plato sostiene, estrangulado para que la recuperación no deje sin comer a los invitados, estás mirando bastante más de un día de operación degradada para un solo disco. Pierde un dispositivo de DB compartido que lleve cinco de ellos y hay 100 TB que mover.
Así que el ratio no es realmente una decisión de coste. Es una decisión sobre cuánto tiempo estás dispuesto a correr degradado, y cuánto tráfico de reconstrucción puede llevar el clúster mientras sigue sirviendo VM.
El diseño depende de un dispositivo que ya nadie fabrica. Este es el que no tiene respuesta técnica. Optane es la pieza correcta para la posición de cache y nada actual la reemplaza — la NAND no puede aguantar el volumen de escritura, y la memoria basada en CXL hacia la que Intel giró no es un reemplazo directo para un cache de bloques. Así que la mitigación es comercial en vez de ingeniosa, está cubierta arriba, y el resumen honesto es que esta arquitectura tiene una fecha de fin en algún punto allá en el futuro.
Nada de esto convierte un clúster de HDD en un clúster todo-flash. El tráfico de escritura aleatoria sostenido que supere la tasa de vaciado llenará el cache, y una vez lleno estás escribiendo a velocidad de plato con capas extra en el camino. Este diseño absorbe ráfagas y quita la sobrecarga de metadatos. No fabrica IOPS.
Lo que suma en total
Tres capas, cada una haciendo la única cosa en la que es mejor — y las tres son necesarias:
- Optane absorbe las ráfagas de escritura aleatoria, un dispositivo por plato. Tiene que ser Optane, porque cada escritura lo cruza y la resistencia de la NAND es la equivocada para esa posición
- Un NVMe de empresa rápido guarda RocksDB y el WAL, compartido entre un puñado de OSD a un ratio que elegiste deliberadamente en vez de aceptar
- Los HDD aportan la capacidad en bruto, liberados tanto de metadatos como de ráfagas
El objetivo no es fingir que los discos giratorios son flash. Es dejar de enviarles el trabajo en el que son peores, para que la capacidad que de verdad pagaste sea usable.
Ese es el truco entero, y no hay nada ingenioso en él. Pon cada trabajo en el dispositivo que es bueno en él, y deja de pagar dos veces por los que no.
Para un clúster hiperconvergido de Proxmox que necesita capacidad de varios terabytes sin el precio del todo-flash, ese es un diseño defendible. Construido como es debido se siente mucho más rápido que los HDD en bruto, falla de maneras que Ceph está construido para manejar, y el dinero va a donde cambia el resultado.
Dos cosas relacionadas que vale la pena leer junto a esto: el trabajo de tamaño de sector en 4Kn, 512e y 512n importa muchísimo para lo que los platos hacen con las escrituras que les llegan, y si estás construyendo esto sobre nodos de conexión directa, el mesh sin switch cubre el lado de red de un clúster Ceph pequeño.
Referencias
- Ceph — Hardware Recommendations — la advertencia de IOPS-por-TB en los HDD grandes, “HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD”, los ratios de 4–5 HDD por SSD SATA y ≤15 por NVMe, la protección contra pérdida de corriente en los SSD de empresa, desactivar el cache de escritura del HDD, y no necesitar un HBA RoC
- Ceph — BlueStore Configuration Reference —
block.dbal 1–2% deblockpara RBD y al menos 4% para RGW, la recomendación general del 2.5%, el desbordamiento de vuelta al dispositivo primario, los tamaños de nivel de RocksDB detrás de los escalones de 3/30/300 GB, y el WAL colocado implícitamente junto a la DB - Linux kernel — bcache admin guide — los modos de cache,
sequential_cutoffy su valor por defecto de 4 MB, el valor por defecto de congestión de lectura de 2000 µs,writeback_rateen sectores por segundo, el controlador PD dewriteback_percent, los contadoresdirty_data/cache_hit_ratio/bypassedy sus versiones decayentes de día, hora y cinco minutos, la advertencia de quewriteback_runninges “only meant for benchmarking”, la afirmación de que estos ajustes “do not persist across reboot”, y “in writeback mode you’ll lose data if something happens to your SSD” - Intel — Optane Memory M10 32 GB specifications — 365 TBW, 240 000 IOPS de lectura aleatoria y 65 000 de escritura aleatoria a 4K sobre una franja de 8 GB, 1200/290 MB/s secuencial, PCIe 3.0 x2
- Intel — Optane Memory M10 16 GB specifications — los 150 MB/s de escritura secuencial y las 35 000 IOPS de escritura aleatoria que ponen esta pieza por debajo de un disco giratorio en caudal secuencial
- PC Perspective — Optane SSD DC P4800X performance — las 550K IOPS de lectura aleatoria 4K de la pieza de 375 GB, 2400/2000 MB/s secuencial, latencia típica sub-10 µs, y 12.3 PBW a 30 DWPD
- ServeTheHome — Optane DC P4801X 100GB M.2 review — las piezas M.2 de centro de datos de poca capacidad, para la escalera de capacidades
- StorageReview — Intel Optane SSD P5800X — la valoración de 100 DWPD, los 30 DWPD de la P4800X, y la comparación contra los discos NAND de empresa que topan alrededor de 10 DWPD para piezas intensivas en escritura y 3 o menos para uso mixto
- Bcache — ArchWiki — los modos de fallo prácticos, incluyendo un dispositivo de respaldo subiendo sin su cache tras un reinicio, y los requisitos de seguridad ante corte de corriente en torno al cache de escritura del HDD y FUA
- Intel — Optane business update — la liquidación, y qué significa para la garantía y el soporte en dispositivos ya en servicio, que es la posición en la que ya está cualquier cosa que compres en el mercado de reciclaje