Un OSD en Rust, el mismo día que salió
croit puso FlashStore OSD en vista previa pública el 9 de noviembre de 20261.
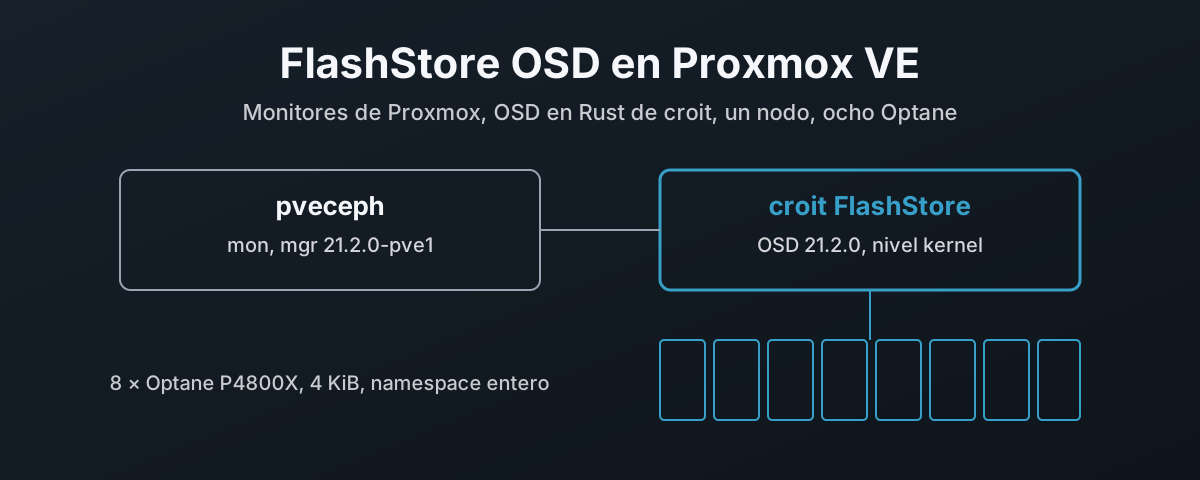
Es un OSD de Ceph escrito desde cero en Rust, con su propio almacén de objetos en lugar de BlueStore, y habla el protocolo de red de Ceph.
Lo que promete es que entra en un clúster que ya tienes: tus monitores, tus managers, tu CLI ceph y tus clientes se quedan como están, y sustituyes un disco cada vez1.
Esa promesa importa más a quien trabaja con Proxmox que a casi nadie.
En un nodo Proxmox VE hiperconvergente, Ceph no es algo que instales aparte.
Sale de la GUI de Proxmox, de los repositorios del propio Proxmox, compilado y parcheado por Proxmox, y todo se maneja con pveceph.
Si un OSD de otro proveedor puede vivir dentro de eso sin romperlo, consigues un motor de almacenamiento nuevo sin renunciar a las herramientas.
Si no puede, lo descubres por las malas, en un nodo que además corre tus VM.
Así que lo probé.
Trabajo para croit, que hace FlashStore. Por eso lo probé a los dos días de salir, y por eso mismo nada de lo que sigue va suavizado. Es una vista previa, el README dice que «not yet recommended for production data»1, y esto es el relato de lo que costó en hardware real, no un folleto.
Respuesta corta: funciona. Mientras escribo esto, ocho OSD FlashStore sirven un pool RBD a una VM en un nodo Proxmox VE 9.2 de serie, en HEALTH_OK. La respuesta larga es que hicieron falta dos arreglos que la documentación no menciona, uno por cómo guarda Proxmox su configuración de Ceph y otro por el kernel de Proxmox, y el resto del artículo trata de esos arreglos y de cómo se encontraron. Si solo lo quieres funcionando, hay un script cerca del final que lo hace todo, y se ha ejecutado en este nodo.
La máquina
El laboratorio es un solo nodo, pve2, en la red de mi casa, y es un mini PC Minisforum B550 cutre de 2021.
Un Ceph de un solo nodo no es como se monta producción, y la regla CRUSH de más abajo es el precio de eso, pero cada paso aquí es igual en un nodo con vecinos.
| Proxmox VE | pve-manager 9.2.26, kernel 7.0.14-28-pve, Debian 13.7 |
| Máquina | mini PC Minisforum B550, 2021; la placa se identifica como BESSTAR TECH B550, BIOS 5.17 |
| CPU | AMD Ryzen 7 5700G, 8 núcleos, 16 hilos, 1 nodo NUMA |
| Memoria | 58 GiB |
| Discos OSD | 8 × Intel Optane P4800X 375 GB (6 con marca Dell, 2 Intel retail) |
| PCIe hasta los Optane | los ocho detrás de un único switch Broadcom PEX880xx, en un solo enlace PCIe 3.0 x16 desde la APU |
| Disco de arranque | WD SN750 512 GB, VG pve, fuera de todo esto |
| Red | un puerto 2.5 GbE, vmbr0 |
| FlashStore | snapshot-2026-11-10, commit upstream c5792750020e2 |
Los Optane están ahí porque FlashStore tiene dos requisitos duros que muchos discos no cumplen.
El disco debe tener protección ante cortes de corriente, y el namespace debe usar bloques de 4096 bytes, como namespace entero, sin particiones ni sistema de ficheros encima1.
FlashStore confirma una escritura cuando es duradera en el disco, así que un disco que miente sobre la durabilidad con una caché volátil se rechaza en mkfs3.
Todos los P4800X informan de que no tienen caché de escritura volátil en sus datos de Identify (vwc 0), que es el propio disco diciendo que la caché no puede perder una escritura confirmada.
Así que el mini PC es el factor limitante de este análisis a fondo, no FlashStore ni los discos. Ocho núcleos es uno por OSD y ninguno de sobra, 58 GiB tienen que alimentar a Ceph y a las VM a la vez, y ocho Optane comparten un enlace PCIe 3.0 porque la APU no da para más. Lee cada cifra de abajo como lo que esta máquina permite.
Umbrella o nada
FlashStore se compila para una sola versión de Ceph cada vez.
La rama lo decide: main habla Ceph 21.2.0 Umbrella, y una rama v20.2.4 habla 20.2.4 Tentacle4.
El daemon comprueba la versión del clúster al arrancar y rechaza cualquiera fuera de su ventana4.
Los paquetes de la página de releases se compilan desde main, y el propio binario lo dice: croit-flashstore-osd 21.2.0 umbrella.
Proxmox VE 9 ofrece tres repositorios de Ceph, y solo uno encaja.
Tentacle es la opción por defecto de Proxmox, así que ¿es la segura?
Es la que no va a funcionar.
El repositorio de Proxmox lleva Tentacle hasta 20.2.5-pve1, y la rama Tentacle de FlashStore apunta exactamente a 20.2.4.
Umbrella en el repositorio de Proxmox es 21.2.0-pve1, la misma versión a la que apunta main.
Proxmox no esconde lo que es Umbrella.
PVE/Ceph/Releases.pm la lista con unsupported => 15, y el asistente de la GUI lo dice claramente en cuanto la eliges.
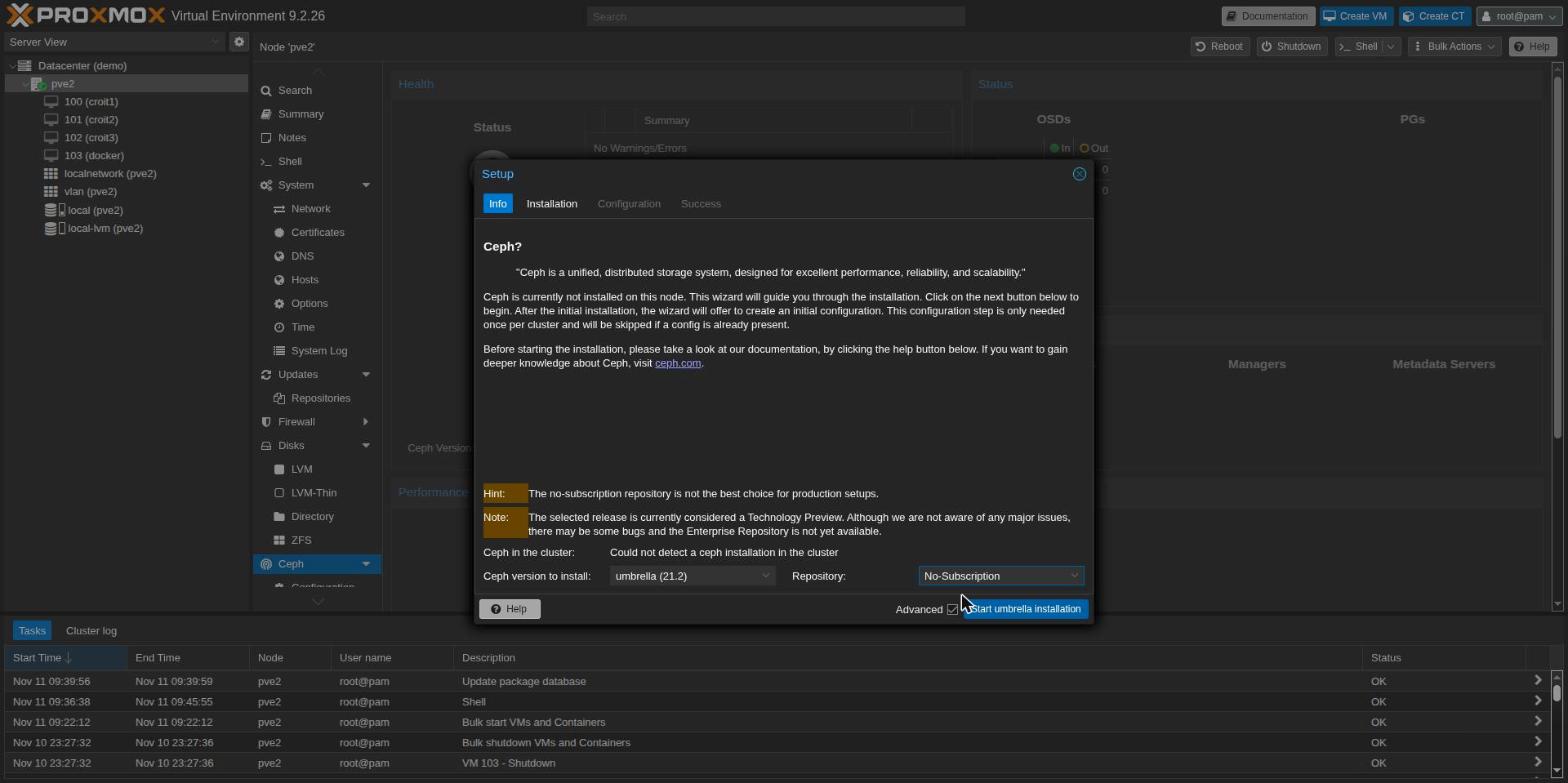
«Technology Preview», sin repositorio enterprise, y el instalador pregunta una segunda vez en el terminal, continue (y/N)?, antes de tocar apt.
Es la cantidad justa de aviso, y vale la pena leerlo como una afirmación sobre toda la pila: un OSD en vista previa sobre una versión de Ceph en vista previa.
La instalación es Proxmox de serie. Datacenter → Ceph → Install, versión Umbrella, repositorio No-Subscription, después la red pública y el primer monitor.
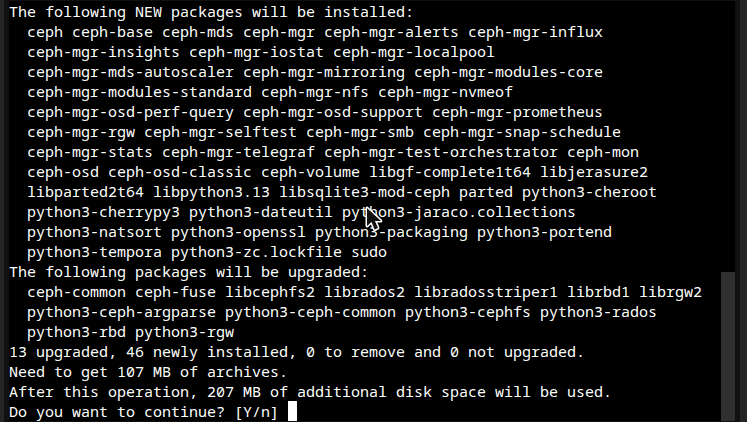
Trece paquetes actualizados, 46 nuevos, 107 MB descargados.
Hay una cosa en esa lista que es nueva en Umbrella: ceph-osd-classic junto a ceph-osd.
No se usa ninguno de los dos, porque aquí nunca se crea un OSD clásico.
Más o menos un minuto después mon.pve2 y mgr.pve2 estaban corriendo, ceph versions informaba de 21.2.0 … umbrella, y la salud era OK sin nada que guardar todavía.
Cuatro discos a 512 bytes
Cuatro de los ocho Optane habían estado pasados a una VM de laboratorio y seguían en formato de 512 bytes, con etiquetas ZFS viejas. Otros dos tenían el formato correcto y las mismas etiquetas. El arreglo para ambos es sencillo: quitarlos de la VM, formatear a 4 KiB, borrar las etiquetas.
El P4800X ofrece 4096 bytes sin metadatos como formato LBA 3, que nvme id-ns muestra como lbaf 3 : ms:0 lbads:12.
nvme format /dev/nvme0n1 --lbaf=3 --force --timeout=900000
wipefs -a /dev/nvme0n1
sgdisk --zap-all /dev/nvme0n1
El primer intento falló, y otro posterior también.
Las dos veces nvme format volvió con Interrupted system call y el disco seguía a 512 bytes.
El log del kernel tiene el motivo:
nvme nvme0: I/O tag 0 (0000) opcode 0x2 (Admin Cmd) QID 0 timeout, reset controller
nvme nvme1: I/O tag 9 (0009) opcode 0x6 (Admin Cmd) QID 0 timeout, reset controller
El opcode 0x2 es Get Log Page y 0x6 es Identify.
Ninguno es el formateo.
Un P4800X formatea el medio entero, y aquí eso tardó entre 345 y 351 segundos por disco.
Mientras dura, el controlador no responde a otros comandos de administración, así que cualquier cosa que le haga una pregunta al disco espera.
Pasado el timeout de administración de 60 segundos del kernel, se rinde y resetea el controlador, y el reset mata el formateo.
| Intento | Qué llegó al disco | Resultado |
|---|---|---|
| nvme0, primero | un Get Log Page a las 09:53:04, en mitad de la instalación de Ceph | abortado, sigue a 512 B |
| nvme0, en una unidad | nada | 4 KiB en 345 s |
| nvme1 | mi propio nvme list, mirando el progreso | abortado, sigue a 512 B |
| nvme2, nvme3 | nada | 4 KiB en 351 s y 350 s |
| nvme1, solo | nada | 4 KiB en 346 s |
El arreglo es lanzar cada formateo en una unidad transitoria con un timeout largo, un disco cada vez, y dejar los discos en paz hasta que termine:
systemd-run --unit=fmt4k /root/fmt4k.sh
journalctl -u fmt4k -f       # read progress from the journal, not from the drive
Así la única forma de ver el progreso es el journal, y nada llega al controlador.
Después, los ocho mostraban 4 KiB en nvme list.
El paquete
La página de releases trae paquetes .deb y .rpm, entre ellos Debian 13 trixie, que es sobre lo que está construido Proxmox VE 92.
Una sola compilación sirve para todas las distribuciones, y necesita glibc 2.34 o más reciente6.
B=https://github.com/croit/ceph-rust/releases/download/snapshot-2026-11-10-0b6783237291
curl -LO "$B/flashstore_21.2.0+git.20261110063351.c5792750020e_debian-trixie_amd64.deb"
curl -LO "$B/sha256sums.txt"
sha256sum flashstore_*_debian-trixie_amd64.deb
grep debian-trixie/flashstore_ sha256sums.txt
Compruébalo a mano.
sha256sum -c no puede comprobar esta descarga, porque el fichero de checksums la llama debian-trixie/flashstore_…_amd64.deb mientras que el asset se llama flashstore_…_debian-trixie_amd64.deb.
Los hashes coinciden, ce1fb352…26c8 en los dos lados, así que el fichero está bien y lo único desacompasado con los assets es la lista.
apt install ./flashstore_*_debian-trixie_amd64.deb
croit-flashstore-osd --version
croit-flashstore-osd 21.2.0 umbrella (build 0.0.0) git c5792750020e
net tiers: kernel (+rdma upgrade)
Se instaló limpio junto a los ceph-osd y ceph-osd-classic del propio Proxmox.
El paquete instala un ceph-osd.target mínimo solo en los hosts que no tienen uno6, y Proxmox ya lo tiene, así que las unidades de FlashStore cuelgan del mismo target que colgarían las clásicas.
Tres cosas del paquete que conviene saber antes de escribir scripts contra él:
| Lo que dice la documentación | Lo que es el paquete | |
|---|---|---|
| Nombre del paquete | apt remove flashstore …6 | croit-flashstore-osd, el fichero del asset es flashstore_… |
| Backends de almacén | el conjunto de features de producción de main es knet,spdk,rdma,mimalloc1 | sin SPDK: --check informa «SPDK NVMe driver: compiled out» |
Valores de flashstore_dev | spdk:<pci>, o file: en compilaciones de desarrollo7 | el nivel kernel, kernel:/dev/…, es la única vía de almacén real en esta compilación |
La fila del medio es la que importa.
El nivel SPDK, el driver NVMe en espacio de usuario que necesita el disco ligado a vfio-pci, no está en el paquete Debian publicado.
Lo que sí está es el nivel kernel: el disco se queda en el driver nvme del propio kernel y FlashStore le habla a través de io_uring.
El código fuente lo muestra compilado, porque la feature knet arrastra kernel-nvme8, aunque la línea de resumen de la comprobación del host diga que está «compiled out of this build».
Esa línea está mal.
Un lector que se la crea se pararía justo ahí.
Lo que dice la comprobación del host
croit-flashstore-osd --check es de solo lectura y se ejecuta antes de escribir nada.
Revisa la compilación, la CPU, la memoria, el IOMMU, cada controlador NVMe, la NIC, el kernel y la configuración, e imprime el arreglo exacto para cada hallazgo9.
En este nodo hizo 115 comprobaciones, y es buena: cada hallazgo viene con el comando que lo arregla, lo que me ahorró un montón de búsqueda.
| Hallazgo | Resultado | Lo que hice |
|---|---|---|
| Hugepages: ninguna reservada | FAIL | reservé los 16 GiB que pedía, persistidos en /etc/sysctl.d |
| Disco de arranque SN750: caché de escritura volátil | FAIL | nada, no es candidato a OSD |
vfio-pci no cargado | WARN | nada, esta compilación no tiene SPDK que lo use |
| límite memlock de 8 MiB | WARN | nada, mide la shell; la unidad pone LimitMEMLOCK=infinity |
sin isolcpus / nohz_full | WARN | anotado, ajuste de latencia |
IOMMU en modo traducido, no iommu=pt | WARN | anotado |
init_on_alloc=1 | WARN | anotado, cuesta entre el 15 y el 20 % de CPU en lecturas grandes, según dice |
| puerto 2.5 GbE, rings de la NIC por defecto, IRQ en cinco CPU | WARN | anotado |
| 8 × P4800X: sin VWC, 4096+0 activo, x4 a 8 GT/s, libres | OK | |
| io_uring con SEND_ZC y buffers fijos, kernel 7.0 | OK |
Cuenta con el segundo FAIL.
La comprobación cuenta todos los controladores de la máquina, y el SSD de arranque tiene caché de escritura, así que suspende la prueba de protección ante cortes, aunque la misma comprobación lo marca correctamente como «in use, not a candidate».
El tutorial dice que salir con 0 significa que no hay FAIL9.
En cualquier host que arranque desde un SSD de consumo, que son muchos hosts Proxmox, --check no puede salir con 0, arregles lo que arregles.
Escribe tus scripts contra las líneas de cada comprobación, no contra el código de salida.
Los WARN de ajuste se quedaron. Todos necesitan un cambio en la línea de comandos del kernel y un reinicio, y esto es un despliegue, no un benchmark. Son la lista correcta para trabajar antes de que nadie cite una cifra de esta máquina.
Núcleos y hugepages para ocho OSD
FlashStore funciona con un hilo por núcleo, y la comprobación explica lo que eso significa: «one core = one shard/PG owner», como mucho 8 núcleos por OSD, y cada núcleo de OSD en su propio núcleo físico en vez de compartirlo con un hermano SMT.
Ocho núcleos físicos y ocho OSD dan un núcleo para cada uno, flashstore_lcores = 0 a 7, con los hermanos SMT para Proxmox y las VM.
Repetida con eso en la configuración, la comprobación marca OK todos los planes de núcleos.
Mira otra vez las hugepages.
La comprobación pide 2048 MiB por OSD, que es el --mem por defecto del daemon, así que ocho OSD necesitan 16 GiB reservados.
En marcha, cada OSD ha usado 512 MiB de sus 2048.
Eso cuadra con la propia nota de diseño de croit para el backend de kernel, que reserva una cuarta parte de --mem para su asignador de payload10.
Así que en esta máquina, con los ocho OSD en marcha, hay 12 GiB de RAM reservados como hugepages que nadie toca, en un host que también tiene VM que alimentar.
A un nodo de almacenamiento le daría igual.
En un nodo Proxmox, esa memoria era una VM, y más abajo se recorta a lo que usan los OSD.
¿Puedo preguntar por qué no puede leer ceph.conf?
Con los discos formateados, el paquete instalado y la comprobación del host limpia, el primer OSD no arrancaba.
croit-flashstore-tool: refused: /etc/ceph/ceph.conf: Permission denied (os error 13)
En Proxmox, /etc/ceph/ceph.conf es un enlace simbólico a /etc/pve/ceph.conf, y /etc/pve es pmxcfs, el sistema de ficheros del clúster que mantiene sincronizada la configuración de todos los nodos.
Los ficheros ahí son root:www-data 0640, y pmxcfs no te deja cambiarlo fichero a fichero11.
Los daemons de Ceph del propio Proxmox se las arreglan porque arrancan como root, leen la configuración y después bajan al usuario ceph, que es lo que hace --setuser ceph --setgroup ceph en cada unidad ceph-osd@.
La unidad de FlashStore no arranca como root.
Es User=ceph desde la primera instrucción, ExecStartPre incluido12, así que nunca llega a leer el fichero.
¿Puedo preguntar por qué un paquete compilado para Debian, para un producto que se vende como sustituto directo, no se probó contra la plataforma Ceph basada en Debian más común que existe? No pregunto quién. pveceph guarda su configuración en pmxcfs, y cada OSD FlashStore en un nodo gestionado por pveceph se topará con esto en su primer arranque.
El daemon ya trae la respuesta.
Su código fuente describe la bajada clásica con --setuser/--setgroup: «started as root by a classic unit (--setuser ceph --setgroup ceph), the daemon becomes that user before it opens the store, a socket or a file»13.
Así que un drop-in que arranque la unidad como Proxmox arranca sus propios OSD debería bastar.
No del todo. Arrancado como root a secas, el siguiente rechazo fue el disco.
activate: device kernel:/dev/ng0n1 not ready: /dev/nvme0n1: Permission denied (os error 13)
El CapabilityBoundingSet de la unidad deja fuera CAP_DAC_OVERRIDE12, así que root queda sujeto a los permisos normales de ficheros, y los nodos del namespace son de ceph:ceph.
Arrancar como root con el grupo puesto a ceph cubre las dos cosas: root es dueño del fichero de configuración, el grupo ceph abre el disco, y el daemon baja a ceph antes de hacer nada más.
# /etc/systemd/system/croit-flashstore-osd@.service.d/pve-ceph-conf.conf
[Service]
User=root
Group=ceph
ExecStart=
ExecStart=/usr/bin/croit-flashstore-osd run --id %i --cluster ${CLUSTER} -f --setuser ceph --setgroup ceph
El daemon confirma la bajada en su propio log: set uid:gid to 64045:64045 (ceph).
Hay un arreglo más corto, SupplementaryGroups=www-data, y no lo usé.
Dejaría al OSD leer cualquier fichero legible por el grupo bajo /etc/pve, no solo la configuración de Ceph.
Un OSD no pinta nada leyendo el resto de la configuración del clúster, y el drop-in de arriba no le da nada más de lo que Proxmox da a los suyos.
Luego, los nodos de dispositivo.
La documentación de FlashStore dice que el nodo del namespace tiene que ser escribible por ceph, «(udev rule)»14, y el paquete no trae ninguna.
Esta casa los discos por modelo, así que no puede pillar el disco de arranque haga lo que haga la numeración:
# /etc/udev/rules.d/70-croit-flashstore-optane.rules
SUBSYSTEM=="nvme-generic", KERNEL=="ng*n*", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
SUBSYSTEM=="block", KERNEL=="nvme*n*", ENV{DEVTYPE}=="disk", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
Después de udevadm trigger, los dieciséis nodos Optane eran ceph:ceph 0660 y el SN750 siguió siendo de root.
El passthrough que este kernel no hace
El nivel kernel tiene dos modos, y el nodo que nombras elige entre ellos.
kernel:/dev/ngXnY manda comandos NVMe directamente al disco a través de io_uring, lo que croit llama kernel-cmd.
kernel:/dev/nvmeXnY hace lecturas y escrituras O_DIRECT sobre el dispositivo de bloques, llamado kernel o directo10.
croit midió kernel-cmd por delante en todas las celdas que probó10, y el inicio rápido del propio README lo usa1, así que eso es lo que configuré.
Con los permisos resueltos, el daemon bajó a ceph, leyó su configuración y se paró en la primera lectura:
croit-flashstore-osd: --dev kernel:/dev/ng0n1: /dev/ng0n1: kernel-cmd fixed-buffer probe read: Errno(13)
La misma prueba había pasado un minuto antes en activate, que todavía tenía las capacidades de root.
Así que la pregunta es si este kernel deja a un proceso sin privilegios mandar comandos de I/O por /dev/ngXnY.
Eso se puede responder sin FlashStore, con la misma lectura usando nvme-cli, como ceph:
| Como | Comando sobre /dev/ng0n1 | Resultado |
|---|---|---|
ceph | Identify Namespace | permitido |
ceph | Read, LBA 0, 4 KiB | Permission denied |
root | Read, LBA 0, 4 KiB | permitido |
Los ocho Optane dieron la misma respuesta, incluidos dos que no había formateado ni reseteado nunca, con firmware de Intel en vez del de Dell. Así que no son los discos ni son los formateos de esa mañana.
Upstream dice que debería funcionar.
En Linux 7.0, nvme_cmd_allowed() deja a un proceso sin privilegios mandar un comando de I/O cuando el log Commands Supported and Effects del disco lo marca como soportado y sin efectos inusuales, y exige una apertura escribible solo para comandos que escriben o cambian datos15.
El log de efectos del P4800X marca Read como soportado, 00000001, y nada más.
La lectura está permitida.
El kernel de Proxmox no es el de upstream.
Su changelog para esta compilación incluye un arreglo portado justo en esta ruta, CVE-2026-90227: nvme/ioctl: check SUBMIT_IO with nvme_cmd_allowed(), que a primera vista cubre un ioctl distinto del que probé.
No he localizado qué cambio del kernel 7.0.14-28-pve marca la diferencia, y no voy a adivinarlo.
Lo que es seguro es el comportamiento: en este kernel, el I/O de passthrough NVMe sin privilegios se rechaza.
FlashStore tiene un plan B para el passthrough rechazado, y no saltó.
La nota de diseño de croit dice que cuando se rechaza Identify, un dispositivo kernel-cmd cae a I/O directo sobre su nodo de bloques y lo avisa al arrancar10.
Aquí Identify está permitido y Read no, así que el plan B nunca se activa y el OSD se para.
Al I/O directo le da igual. Es una línea por OSD:
flashstore_store_backend = kernel
Con eso, osd.0 arrancó.
croit-flashstore-osd: store mounted (1 shards, replayed 4 txns in 16 ms)
croit-flashstore-osd: set uid:gid to 64045:64045 (ceph)
[    1.398] crush location set (create-or-move updating item name 'osd.0' weight 0.3359 at location {host=pve2,root=default} to crush map)
[    2.406] osd.0 is now active (up_from 10, map 10)
Activo en 2,4 segundos.
Preparar y arrancar los OSD
Cada OSD tiene una sección en la configuración de Ceph, lo que en Proxmox significa editar /etc/pve/ceph.conf, y hacerlo a mano no tiene problema.
[osd.0]
	flashstore_dev = spdk:0000:05:00.0
	flashstore_store_backend = kernel
	flashstore_lcores = 0
El dispositivo se nombra por dirección PCI, no por /dev/nvme0n1, y el prefijo spdk: aquí no significa SPDK.
Con un backend de kernel configurado, el daemon busca la dirección en sysfs en cada arranque y encuentra los nodos actuales del controlador10.
Eso aquí importa.
El disco de arranque SN750 era nvme7 en octubre y ahora es nvme8, y los minors de los nodos genéricos tampoco siguen el orden de los discos, con ng1n1 en el minor 0 y ng0n1 en el minor 2.
Una configuración que dice /dev/nvme4n1 puede apuntar a otro disco después de un reinicio.
Una que dice 0000:0b:00.0 no puede.
Después, un comando por disco, que escribe el almacén y registra el OSD en el monitor:
croit-flashstore-tool prepare --dev spdk:0000:05:00.0 --id 0
kernel-cmd /dev/ng0n1: fixed-buffer NVMe passthrough probe ok (IORING_URING_CMD_FIXED on)
mkfs: device lba 4096 B x 91573146 (375083606016 B), awupf 1 lba, vwc false, max_xfer 32 lba
mkfs: 1 store shards, WAL ring 4096 MiB each
osd.0 prepared in /var/lib/ceph/osd/ceph-0
Dos segundos, como root.
prepare lee la clave de bootstrap de /var/lib/ceph/bootstrap-osd/ceph.keyring16, que pveceph solo escribe la primera vez que crea un OSD propio, así que sin OSD clásicos hay que traerla antes:
ceph auth get client.bootstrap-osd -o /var/lib/ceph/bootstrap-osd/ceph.keyring
Seis discos se prepararon a la primera. Dos fueron rechazados:
croit-flashstore-tool: refused: device is not empty (non-zero data in the first 8192 bytes); --wipe destroys it
croit-flashstore-tool: refused: device is not empty (non-zero data at 65536 bytes); --wipe destroys it
lsblk y blkid habían dado esos dos discos por vacíos.
Lo que había en ellos era el área de metadatos en texto de un grupo de volúmenes LVM de un laboratorio anterior, eliminado hacía tiempo, con la etiqueta del principio ya puesta a cero.
La prueba de FlashStore lee los primeros 8 KiB y las regiones en 64 KiB y 256 KiB17, que es más lejos de lo que miran las herramientas habituales, y tenía razón.
Negarse a usar un disco que contiene lo que sea, salvo que le digan --wipe, es exactamente lo que debe hacer una herramienta de OSD.
Borrarlos es decisión de quien sea dueño de los discos, no de la herramienta. Una vez decidido, --wipe preparó los dos en unos dos segundos, y se unieron después de la instalación que viene más abajo. Por eso la captura del panel y las cifras de la instalación muestran seis.
Después se arrancan:
systemctl enable --now croit-flashstore-osd@0
ID  CLASS  WEIGHT   TYPE NAME      STATUS  REWEIGHT  PRI-AFF
-1         2.01535  root default
-3         2.01535      host pve2
 0   nvme  0.33589          osd.0      up   1.00000  1.00000
 1   nvme  0.33589          osd.1      up   1.00000  1.00000
 2   nvme  0.33589          osd.2      up   1.00000  1.00000
 3   nvme  0.33589          osd.3      up   1.00000  1.00000
 4   nvme  0.33589          osd.4      up   1.00000  1.00000
 5   nvme  0.33589          osd.5      up   1.00000  1.00000
Cada OSD se colocó bajo host=pve2 con clase de dispositivo nvme.
Lo que le cuentan al clúster de sí mismos merece leerse una vez:
| Campo | Monitor y manager | OSD FlashStore |
|---|---|---|
ceph versions | 21.2.0 (087cd25db8f1) umbrella (dev - None) | 21.2.0 (b060042deb05) umbrella (dev - croit-flashstore-osd) |
| Compilado por | Proxmox, paquetes -pve1 | croit, desde el commit upstream v21.2.0 que nombra el README1 |
osd_objectstore | bluestore, con todos los campos bluestore_bdev_* rellenos | |
| Lo que es en realidad | FlashStore, sin BlueFS, sin RocksDB |
Lo de BlueStore es deliberado.
flashstore_report_objectstore vale bluestore por defecto porque los monitores clásicos solo activan algunas funciones cuando todos los OSD lo declaran, así que el valor por defecto mantiene funcionando un clúster mixto7.
No es verdad, y conviene saberlo antes de leer los metadatos del clúster y creértelos.
Lo que Proxmox hace con ellos
El panel de OSD de Proxmox lista los seis, up e in, clase nvme, versión 21.2.0, 344 GiB cada uno.
También los llama FileStore.
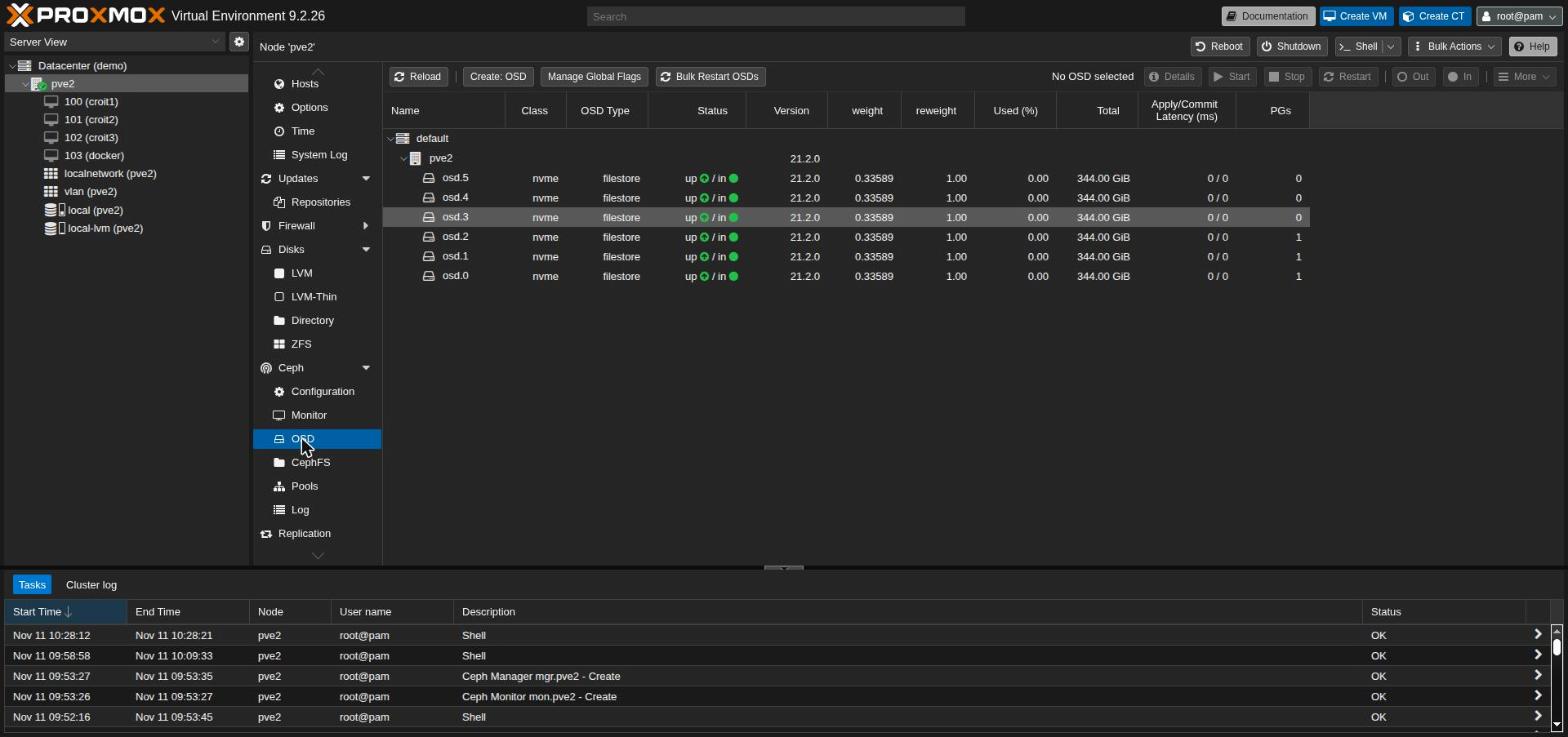
FileStore es el almacén de objetos al que sustituyó BlueStore.
Proxmox deduce la etiqueta en PVE/API2/Ceph/OSD.pm: si los metadatos del OSD tienen una clave bluefs es BlueStore, y cualquier otra cosa es FileStore18.
FlashStore no tiene BlueFS, porque no hay RocksDB debajo, así que declara BlueStore en un campo y recibe la etiqueta FileStore por otro.
Ninguna de las dos es correcta.
Y el panel es donde mira primero la mayoría de los administradores de Proxmox.
Las columnas de latencia marcan 0 / 0 en reposo.
Durante la instalación de más abajo, ceph osd perf dio latencias de commit de 0 a 3 ms en los seis.
Start, Stop y Restart en el panel manejan ceph-osd@N, la unidad clásica, que no es lo que está corriendo19.
Como tal, el panel es una vista de estos OSD, no un control para ellos.
Usa systemctl … croit-flashstore-osd@N y la CLI para cualquier cosa que toque los daemons, y no toques Create: OSD ni Destroy con estos.
Un pool, un almacenamiento y una VM Fisher-Price OS (Windows)
El primer PG del clúster, el del pool .mgr del manager, se quedó en undersized+degraded en cuanto subieron los OSD.
La culpa es del nodo único.
La replicated_rule por defecto pone cada copia en un host distinto, y hay un solo host.
ceph osd crush rule create-replicated replicated_osd default osd nvme
ceph osd pool set .mgr crush_rule replicated_osd
Una regla con dominio de fallo osd y clase de dispositivo nvme20 pone cada copia en un OSD distinto, y el PG pasó a active+clean en segundos.
En un clúster real con tres o más hosts, quédate con la regla por host y sáltate esto.
Todo lo que viene después es la GUI de Proxmox de siempre.
Ceph → Pools → Create: nombre flashstore, size 3, min size 2, regla replicated_osd, Add as Storage marcado.
Más tarde pasó a size 2, min size 1, para la prueba de carga de más abajo.
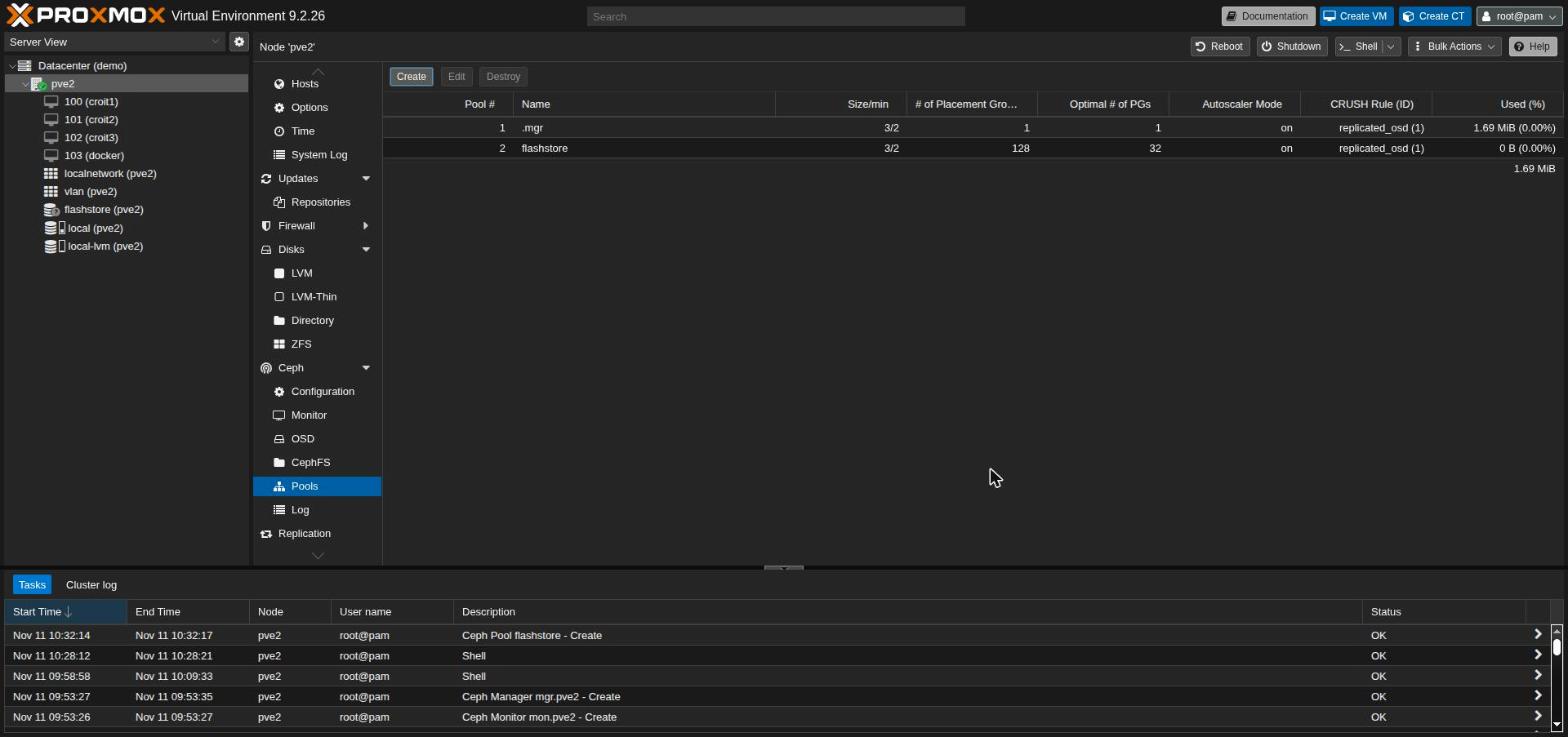
Proxmox creó el pool y la definición de almacenamiento RBD de una vez, y flashstore apareció en el árbol con 654 GiB utilizables, que son los 2 TiB en bruto divididos entre tres copias, menos la sobrecarga.
129 PG pasaron a active+clean, y poco después el autoscaler bajó el pool nuevo de 128 a 32.
La máquina de prueba es una VM Fisher-Price OS (Windows).
No es una preferencia, es lo que una gran parte de los clientes corre de verdad en sus pools de Proxmox, así que es la carga que cuenta: 16 GiB de memoria, 4 núcleos, un disco de 60 GiB en flashstore con discard e iothread activados.
Además es charlatán con el disco y lo usa de forma ineficiente, y de eso se trata: una prueba de almacenamiento quiere el invitado que más se apoya en el disco.
Muestreando el pool cada diez segundos durante los primeros quince minutos de la instalación:
| Escrituras al pool | mediana de 9,3 MB/s mientras hay actividad, pico de 302 MB/s |
| Operaciones de escritura | pico de 2486 por segundo |
| Lecturas del pool | pico de 60 MB/s |
| Espacio bruto usado | 35 GiB entre seis OSD |
| Salud | HEALTH_OK en las 90 muestras |
| Reinicios de OSD | 0 |
| Memoria residente por OSD | de 565 a 871 MiB cada uno al terminar |
Son cifras de un instalador, con la VM y los OSD en el mismo host y los WARN de ajuste sin tocar, y no dicen nada de la velocidad de FlashStore. Lo que sí dicen es que un cliente clásico de Proxmox llevó la instalación de un sistema operativo a OSD en Rust, 35 GiB en bruto, sin un fallo, que es justo lo que este artículo se propuso comprobar.
Lo que hace bajo carga
Una instalación demuestra que funciona. No te dice cómo es usar la VM.
Así que la VM recibió CrystalDiskMark 9.0.321, tres veces: el perfil Real World Performance [+Mix], Read&Write [+Mix], un archivo de 16 GiB en C: y una mezcla de 70 % lecturas y 30 % escrituras, una vez con tres pasadas y dos con nueve. Ese perfil lo hace todo de una petición en una, en un solo hilo, que es lo que de verdad hace un escritorio o una base de datos pequeña, no lo que hace una hoja de especificaciones.
Para entonces la configuración había cambiado desde la instalación. La VM tenía seis núcleos, y el pool se había cambiado en la GUI a size 2, min size 1 y 256 PG. Size 2 con min size 1 es un ajuste de laboratorio en una sola máquina: con una sola copia restante, el pool sigue aceptando escrituras que un único fallo puede hacer perder. En cualquier otro sitio, mantén 3 y 2.
El disco estaba en el valor por defecto de Proxmox, sin caché, que es el predeterminado desde Proxmox 222.
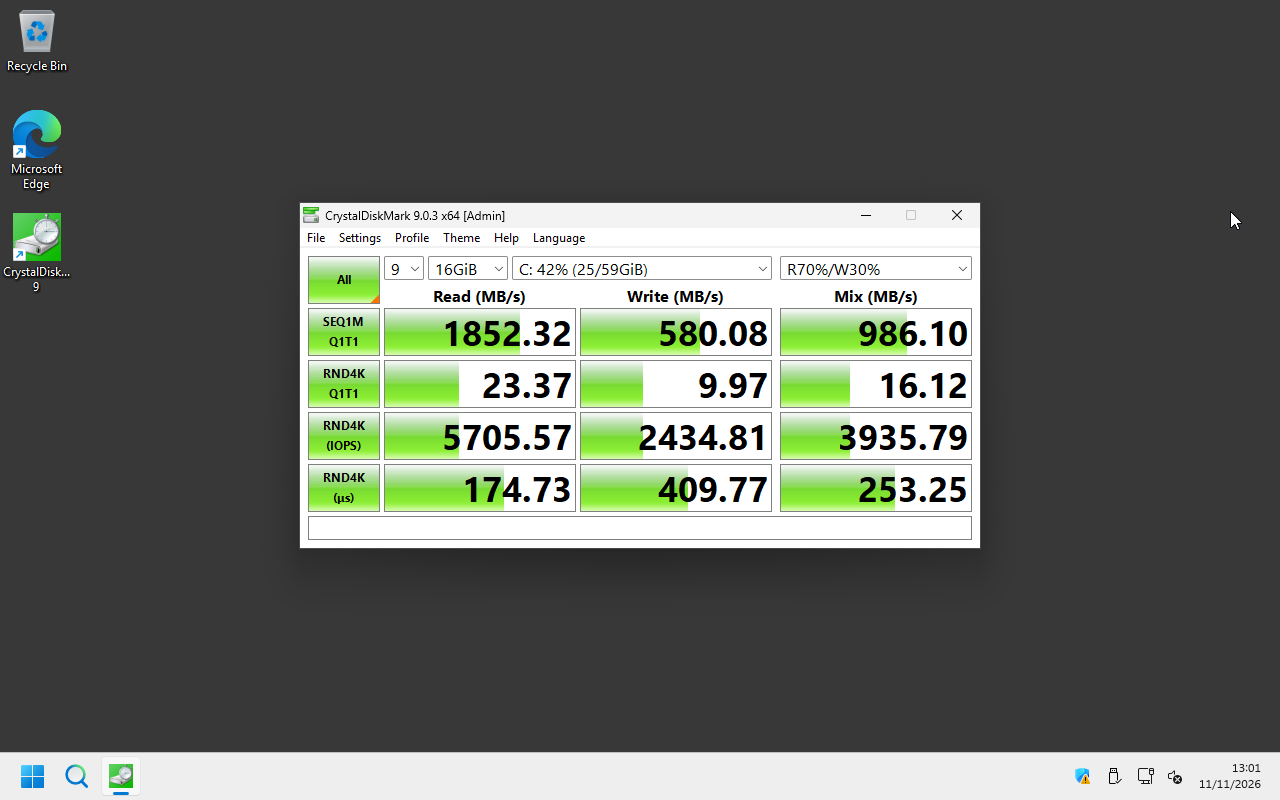
| Real World Performance [+Mix], 16 GiB | 3 pasadas | 9 pasadas | 9 pasadas otra vez |
|---|---|---|---|
| SEQ1M Q1T1 lectura | 1279,71 MB/s | 1675,33 MB/s | 1852,32 MB/s |
| SEQ1M Q1T1 escritura | 563,67 MB/s | 576,65 MB/s | 580,08 MB/s |
| SEQ1M Q1T1 mezcla | 1043,75 MB/s | 1043,28 MB/s | 986,10 MB/s |
| RND4K Q1T1 lectura | 5342 IOPS, 186,57 µs | 5659 IOPS, 176,17 µs | 5706 IOPS, 174,73 µs |
| RND4K Q1T1 escritura | 2419 IOPS, 412,51 µs | 2405 IOPS, 414,79 µs | 2435 IOPS, 409,77 µs |
| RND4K Q1T1 mezcla | 3938 IOPS, 253,13 µs | 3826 IOPS, 260,49 µs | 3936 IOPS, 253,25 µs |
Las escrituras y la latencia de bloque pequeño se mantienen dentro de un 1 % de una prueba a otra. La lectura secuencial sube un 45 % en las tres. Esa es la primera señal de que la columna de lectura no mide lo que parece.
El host se muestreó cada cinco segundos durante las tres, desde /proc/diskstats para los ocho Optane, ceph status para el pool y /proc para cada proceso e hilo, y las dos vistas no cuentan la misma historia.
Escrituras: el disco es la parte pequeña
| Una escritura aleatoria de 4 KiB cada vez, última prueba | |
|---|---|
| Tiempo por escritura, visto por la VM | 409,77 µs |
| Tiempo por escritura, en cada Optane | 17 µs |
| Escrituras que llegan a los Optane por cada escritura de la VM | 4,05: dos copias, unas dos escrituras cada una |
| Escrituras secuenciales grandes | 580 MB/s desde la VM, 1,14 GB/s en los Optane, la segunda copia lo duplica |
El disco es menos del 5 % de una escritura pequeña. Los otros 393 µs son el viaje: QEMU, librbd, el messenger hasta el OSD, el propio OSD y la espera por la segunda copia. Nada de eso se midió por separado aquí, así que no le voy a poner cifra a cada pieza. Lo que sí dice es que en esta máquina los Optane no son el límite para la E/S de una en una, y que un disco más rápido no movería mucho esos 410. El límite ha pasado al cliente, la librbd que trae Proxmox, y habrá más sobre eso cuando la librustyrbd de croit esté desplegada aquí.
Lecturas: la caché, no los Optane
En la última prueba, la pasada de lectura aleatoria de 4 KiB hizo 5700 lecturas por segundo sobre todo el archivo de 16 GiB, y los ocho Optane no leyeron nada.
La pasada secuencial llegó a 2,2 GB/s en el pool mientras las lecturas de los propios discos caían de 755 MB/s a cero.
CrystalDiskMark se salta la caché del invitado y el disco no tiene ninguna en QEMU, así que la memoria que hace el trabajo está en los OSD.
flashstore_obj_cache viene activado por defecto en esta build, la parte del archivo de cada OSD es de unos 2 GiB con size 2, y cada OSD había crecido hasta unos 2,6 GiB.
FlashStore no informa de sus aciertos, así que llámalo casi seguro, no demostrado.
Por eso la lectura secuencial subió en cada prueba: había más archivo ya en caché.
Lee la columna de lectura como una cifra de caché, no del store.
CPU: adónde fueron los núcleos
| Última prueba, en núcleos | Host ocupado | OSD | vCPU del invitado | librbd y cliente Ceph | QEMU |
|---|---|---|---|---|---|
| En reposo entre pasadas | 20 a 24 % | 3,3 | 0,1 | 0,03 | 0,03 |
| Escritura aleatoria 4 KiB | 30 % | 3,9 | 0,38 | 0,20 | 0,08 |
| Lectura aleatoria 4 KiB | 30 % | 3,6 | 0,47 | 0,39 | 0,15 |
| Mezcla secuencial | 41 a 53 % | 3,8 | 1,5 a 2,3 | 0,5 | 0,12 |
Las tres columnas de la VM salen de sus hilos: QEMU da nombre a las vCPU del invitado, y los hilos messenger y worker de librbd corren en el mismo proceso.
La columna de los OSD apenas se mueve. Ocho OSD haciendo polling cuestan 3,3 núcleos sin hacer nada y 3,9 a tope, así que en una máquina de 16 hilos se va una quinta parte de la CPU antes de que una VM pida nada. Nada más se acercó a su límite. El hilo más ocupado fue una vCPU del invitado al 47 %, y el más ocupado de librbd se quedó por debajo del 15 %. Con una petición cada vez, el límite es la espera, no el trabajo, y una cifra de CPU no puede mostrar una espera.
Memoria: planifica para el pico
| En las tres pruebas | |
|---|---|
| Salud | HEALTH_OK en cada muestra, cada PG active+clean, ningún reinicio de OSD |
| Hugepages en uso | 4 GiB de principio a fin |
| Lo que le queda al host por repartir, con una VM de 16 GiB en marcha | de 3,1 a 4,0 GiB |
La fila de hugepages es otra vez la sección del presupuesto, esta vez bajo carga: 512 MiB por OSD, y los otros 12 GiB sin tocar.
La memoria normal es la cifra que hay que vigilar, porque la caché de arriba está hecha de ella. Una vez que una lectura había cargado el archivo, cada OSD se quedaba en unos 2,5 GiB, y esto es lo que ocupaba Ceph en un host de 58,7 GiB:
| Memoria de Ceph en el pico, objetivo por defecto de 4 GiB | |
|---|---|
| Procesos OSD, los ocho juntos | 19,9 GiB, de 2,4 a 2,6 GiB cada uno |
| Hugepages reservadas para los OSD | 16 GiB, 4 GiB de ellas en uso |
| Monitor y manager | 0,3 GiB |
| Total | 36,2 GiB, el 62 % del host |
| Lo que le queda al host por repartir, con una VM de 16 GiB en marcha | 3,6 GiB |
Vuelve, pero sin ningún horario que yo pudiera ver.
Se mantuvo en 19,9 GiB durante 25 minutos, pausas incluidas, luego bajó a 13,9 GiB al final de la última prueba, y el host volvió a tener 10,2 GiB por repartir.
osd_memory_target estuvo en todo eso en su valor por defecto de 4 GiB por OSD, así que ocho OSD tenían derecho a 32 GiB antes de contar una sola hugepage.
En un nodo que además tiene que mover VM, el pico es el presupuesto que hay que calcular antes de los discos, y es donde más duelen los 12 GiB de hugepages sin usar.
Tres VM a la vez, con un presupuesto más ajustado
Una VM deja sitio de sobra. Con tres, el presupuesto tiene que cuadrar. Así que antes cambiaron dos ajustes.
ceph config set osd osd_memory_target 1073741824   # 1 GiB per OSD, was 4
sysctl -w vm.nr_hugepages=2048                     # what eight OSDs use, was 8192
El objetivo no necesita nada más: cada OSD informó del nuevo valor en segundos, y aun así se reiniciaron uno a uno, con los 257 PG de vuelta en active+clean antes del siguiente.
Las hugepages tienen trampa.
Antes de cada arranque de OSD, croit-flashstore-prep quiere un --mem entero libre, 2048 MiB, y amplía el pool si falta, pero nunca lo vuelve a reducir.
Reiniciar osd.7 después del recorte volvió a subir el pool en el acto:
croit-flashstore-prep[7]: hugepages 2048kB: free 256 < need 1024, nr_hugepages 2048 -> 2816
Así que el mínimo que sobrevive a un reinicio o a un arranque es lo que usan los OSD más el margen de un arranque: 2816 páginas, 5,5 GiB, frente a los 16 GiB que pide la comprobación. El script de instalación de arriba reserva ahora justo eso. Volver a recortar a 2048 cuando los ocho están arriba da otros 1,5 GiB hasta el siguiente reinicio.
Después, tres clones de la VM, de 10 GiB cada uno, lanzaron CrystalDiskMark a la vez: Real World Performance [+Mix], tres pasadas, pero sobre un archivo de 1 GiB cada uno en vez de 16 GiB. Eso hace de la columna de lectura una cifra de caché más que nunca, así que mira las escrituras.
| CrystalDiskMark, tres VM a la vez | VM 104 | VM 105 | VM 106 | Las tres | Una VM sola |
|---|---|---|---|---|---|
| SEQ1M Q1T1 escritura | 346,99 MB/s | 318,99 MB/s | 446,98 MB/s | 1113 MB/s | 580,08 MB/s |
| SEQ1M Q1T1 lectura | 796,05 MB/s | 905,03 MB/s | 1160,93 MB/s | 2862 MB/s | 1852,32 MB/s |
| RND4K Q1T1 escritura | 1901 IOPS | 1928 IOPS | 1862 IOPS | 5691 IOPS | 2435 IOPS |
| RND4K Q1T1 latencia de escritura | 524,56 µs | 517,00 µs | 535,42 µs | 409,77 µs | |
| RND4K Q1T1 lectura | 3773 IOPS | 3916 IOPS | 3909 IOPS | 11 598 IOPS | 5706 IOPS |
| RND4K Q1T1 mezcla | 2978 IOPS | 3027 IOPS | 3411 IOPS | 9416 IOPS | 3936 IOPS |
Tres VM sacaron 2,3 veces las escrituras pequeñas de una sola, y cada una lo pagó con un 27 % más de latencia. Los Optane seguían sin ser el motivo. Llegaron a 20 900 escrituras por segundo a 17 µs cada una, los mismos 17 µs que con una VM, y el más ocupado de los ocho estuvo al 14 %.
| Host, cada cinco segundos durante la prueba | Objetivo por defecto 4 GiB, una VM | Objetivo 1 GiB, tres VM |
|---|---|---|
| Mayor proceso OSD | 2,7 GiB | 1,15 GiB en el pico, 0,8 después |
| Los ocho procesos OSD juntos | 19,9 GiB | 8,0 GiB en el pico, 5,8 después |
| Hugepages reservadas | 16 GiB, 4 en uso | 4 GiB, todas en uso |
| Memoria dada a las VM | 16 GiB | 30 GiB |
| Lo que le queda al host por repartir, en el punto más bajo | 3,1 GiB | 14,8 GiB |
| Crecimiento del swap | ninguno | ninguno |
Así que FlashStore sí se ajusta a osd_memory_target.
Lo superó un 15 % en el pico de una pasada de lectura y volvió por debajo, con la caché haciendo su trabajo dentro del presupuesto y no fuera.
Entre el objetivo y el recorte, las VM recuperaron 26 GiB en la misma máquina.
| CPU en núcleos, tres VM | Host ocupado | OSD | Invitados | librbd y cliente Ceph | QEMU |
|---|---|---|---|---|---|
| Tres arranques de Fisher-Price OS (Windows) | 81 a 89 % | 3,4 a 3,6 | 6,3 a 7,9 | 0,4 a 0,7 | 0,3 |
| Benchmark | 42 a 73 % | 3,7 a 4,5 | 1,2 a 4,0 | 0,4 a 1,6 | 0,2 a 0,4 |
| En reposo después | 20 a 24 % | 3,3 | 0,3 | 0 | 0 |
Arrancar tres invitados exigió más a la CPU que someterlos al benchmark. El almacenamiento de debajo nunca se acercó, y eso es el mini PC poniendo el límite, como estaba claro desde el principio.
Todo ello, en un solo script
Todo lo anterior está en un solo script. Dale las direcciones PCI de los discos que quieres como OSD y hace el resto, en el orden de este artículo, con los dos arreglos de Proxmox incluidos.
flashstore-pve-setup.sh: OSD FlashStore en un nodo Proxmox VElspci -D -d ::0108 # find the drives
bash flashstore-pve-setup.sh --dry-run 0000:05:00.0 # show the plan, change nothing
bash flashstore-pve-setup.sh 0000:05:00.0 0000:06:00.0
| Comprueba | Escribe | Ejecuta |
|---|---|---|
| Proxmox VE 9 y Ceph 21.2.0 Umbrella | el keyring bootstrap-osd | una lectura passthrough como ceph, para elegir kernel-cmd o kernel |
| cada disco: NVMe, sin caché de escritura, sin montar, sin particiones, sin uso | el drop-in que arranca como root y luego usa --setuser | prepare y systemctl enable --now por disco |
| ningún dato en las zonas que lee la propia sonda de FlashStore | una regla udev por disco, por número de serie | la comprobación del host, que solo se detiene en lo que necesitan los OSD |
| bloques de 4 KiB | una sección [osd.N] por disco, un núcleo físico cada una | la descarga del paquete, verificada contra el SHA-256 de la versión |
No se destruye nada salvo que lo pidas.
--format-4k reformatea un disco que no esté a 4 KiB, uno cada vez en su propia unidad para que nada lo interrumpa, y --wipe le deja sobrescribir un disco que tenga datos.
--single-node añade la regla replicated_osd, y volver a ejecutarlo se salta los discos que ya son OSD.
Se probó aquí, no solo se escribió.
Rechazó el SN750 por su caché de escritura, rechazó el disco de osd.7 mientras aún tenía un store, y luego, con osd.7 purgado y sus nodos de dispositivo devueltos a root, lo reconstruyó desde cero en 10,5 segundos, eligiendo por su cuenta el backend kernel.
Lo que no hará es instalar Ceph.
Ese paso te pide aceptar una Technology Preview, y esa decisión es tuya, no de un script.
Lo que hay que arreglar
Nada de esto frena a un administrador decidido, y todo frenaría a uno con prisa. Cada punto es algo que croit afirma ante cualquiera que descargue el paquete, y con cada uno me topé al primer intento.
| Dónde | Qué pasa | Qué lo arreglaría |
|---|---|---|
| unidad systemd | User=ceph no puede leer pmxcfs, así que el OSD nunca arranca en un nodo pveceph | distribuir el arranque como root y luego --setuser, o un drop-in para Proxmox |
| plan B de kernel-cmd | solo cae a directo si se rechaza Identify; en el kernel de PVE se rechaza Read y el OSD se para | caer a I/O directo ante cualquier I/O de passthrough rechazado |
| udev | la documentación exige una regla que dé a ceph los nodos del namespace; no se distribuye ninguna | distribuir una ligada a los dispositivos configurados |
resumen de --check | dice que el NVMe de kernel está «compiled out» cuando es la única vía de almacén compilada | corregir la etiqueta |
código de salida de --check | el SSD de arranque suspende la prueba de PLP, así que salir con 0 es imposible | puntuar solo dispositivos configurados o candidatos |
| hugepages | dimensiona 2048 MiB por OSD, y prep los quiere libres en cada arranque; el backend de kernel usa 512 | dimensionar el backend de kernel según lo que usa, y que prep pida lo mismo |
sha256sums.txt | los nombres de fichero no coinciden con los assets del release | nombrarlos como se publican |
| nombre del paquete | la documentación dice apt remove flashstore; el paquete es croit-flashstore-osd | un solo nombre, o el correcto en la documentación |
referencia de flashstore_dev | solo lista spdk: y file: | documentar kernel: y spdk: con un backend de kernel |
Nada de esto es trabajo nuevo. El daemon ya tiene la bajada de privilegios, el backend directo y la lógica del plan B. Solo falta unirlo todo para la plataforma en la que la mayoría lo va a probar primero.
Una vista previa es donde se descubre esto
Una vista previa es el sitio adecuado para cada uno de esos hallazgos, y el sitio equivocado para dejarlos. Para eso es una vista previa: alguien se la lleva a casa, la pone en el hardware que de verdad tiene, y apunta dónde se cae. Lo que importa aguantó. El almacén subió en milisegundos, los OSD entraron en un clúster montado con las herramientas de otro, y la instalación de un sistema operativo fue a parar a ellos sin un fallo.
Lo que lo hizo tropezar fue todo lo que rodea al daemon. Un fichero de configuración en un sistema de ficheros que la unidad no podía leer, un kernel que dice que no a una llamada que upstream permite, un disco de arranque que la comprobación no dejaba de contar. Nada de eso es difícil. Todo eso es la diferencia entre software que funciona y software que funciona en tu máquina, y la única forma de cerrarla es probar en las máquinas que tiene la gente y no en las que montaste para ello.
Con todo, es un comienzo prometedor. En un mini PC cutre, con la librbd clásica todavía en el lado del cliente y los ocho discos en un solo enlace PCIe 3.0, los Optane trabajan aquí más duro que con BlueStore. A medida que esto avance volveré sobre ello y profundizaré más, conforme se sustituya más parte de la pila, y también con una mirada a CephFS2.
«Drop-in» es una promesa hecha a un administrador que no tiene tiempo de leer el código fuente. Los monitores de Proxmox, la GUI de Proxmox, el kernel de Proxmox y un paquete de otro es exactamente la situación para la que existe esa promesa. Ahora casi la cumple. Nueve arreglos pequeños y la cumplirá, y prefiero ser yo quien los encontró un miércoles por la mañana que un cliente que se los encuentre un viernes por la noche.
croit/ceph-rust README — vista previa pública desde el 9 de noviembre de 2026, «not yet recommended for production data», requisitos, inicio rápido, conjunto de features de producción, commit de Ceph probado. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
croit/ceph-rust release snapshot-2026-11-10 — los paquetes usados aquí, incluidos
flashstore_…_debian-trixie_amd64.debysha256sums.txt. ↩︎ ↩︎croit/ceph-rust — hardware requirements — la comprobación de caché de escritura volátil, hugepages, notas sobre versiones del kernel. ↩︎
croit/ceph-rust — branches and versions —
mainapunta a v21.2.0,v20.2.4apunta a v20.2.4; «The daemon refuses a cluster release outside its supported window.» ↩︎ ↩︎Proxmox pve-manager, PVE/Ceph/Releases.pm —
umbrellalistado conrelease => '21.2'yunsupported => 1. ↩︎croit/ceph-rust — build and install packages — distribuciones, glibc 2.34, el tratamiento de
ceph-osd.target, la líneaapt remove. ↩︎ ↩︎ ↩︎croit/ceph-rust — configuration reference —
flashstore_dev,flashstore_lcores,flashstore_report_objectstorey por qué valebluestorepor defecto. ↩︎ ↩︎croit-flashstore-osd Cargo.toml — línea 29,
knet = [… "kernel-nvme"]. ↩︎croit/ceph-rust — first OSD tutorial — la comprobación del host de solo lectura; «Exit 0 means no FAIL.» ↩︎ ↩︎
croit/ceph-rust — ADR 0169, kernel NVMe backend — los dos modos de kernel, la comparación medida, la reserva del asignador de payload, la resolución de direcciones
spdk:y el plan B que solo mira Identify (enmienda 6). Añadido al repositorio la misma tarde del release. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎Proxmox VE — Proxmox Cluster File System (pmxcfs) — el sistema de ficheros del clúster bajo
/etc/pvey su propiedad y permisos fijos. ↩︎croit-flashstore-osd@.service —
User=ceph,ExecStartPre=… activate, y unCapabilityBoundingSetsinCAP_DAC_OVERRIDE. ↩︎ ↩︎croit-flashstore-osd privdrop.rs — la bajada de privilegios clásica con
--setuser/--setgroup. ↩︎croit/ceph-rust — prepare the host — «the namespace node must be readable and writable by user
ceph(udev rule)». ↩︎Linux v7.0, drivers/nvme/host/ioctl.c —
nvme_cmd_allowed(), la regla para el passthrough NVMe sin privilegios. ↩︎croit/ceph-rust — security — «
preparedefaults--keyringto/var/lib/ceph/bootstrap-osd/<cluster>.keyring». ↩︎croit/ceph-rust — prepare, activate and list — la prueba de dispositivo no vacío y
--wipe. ↩︎Proxmox pve-manager, PVE/API2/Ceph/OSD.pm —
osdtypeesbluestoresolo cuando los metadatos llevanbluefs, y si no,filestore. ↩︎Proxmox pve-manager, PVE/Ceph/Services.pm —
ceph_service_cmd()asignaosd.Na la unidad systemdceph-osd@N. ↩︎Ceph documentation — CRUSH maps — reglas replicadas, dominios de fallo y clases de dispositivo. ↩︎
CrystalDiskMark — Crystal Dew World’s disk benchmark; “Various measure mode (Peak/Real World/Demo)”. ↩︎
Proxmox VE wiki — Performance Tweaks — the disk cache modes: “cache=none seems to be the best performance and is the default since Proxmox 2.X”. ↩︎