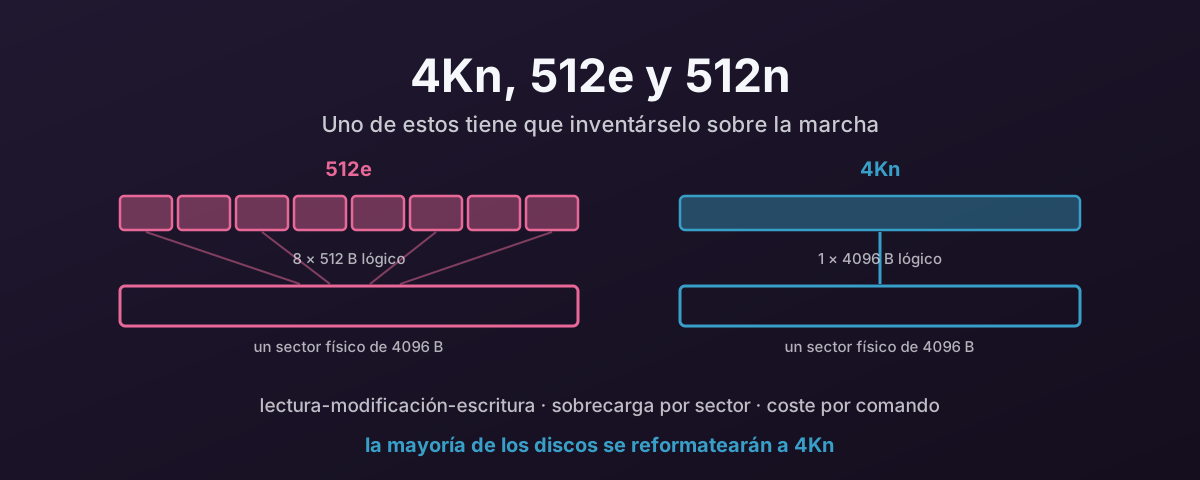
Tres formas en que un disco puede presentarse
Un disco tiene dos tamaños de bloque, y la diferencia entre ellos es toda la historia.
El sector físico es en lo que el medio trabaja de verdad — la unidad más pequeña que el disco puede leer o escribir sin hacer trabajo extra. El bloque lógico es en lo que el disco le dice al host que trabaja — la unidad que el host direcciona.
Hay tres combinaciones por ahí.
512n — 512 nativo. Los dos tamaños son de 512 bytes. Este es el mundo viejo: discos duros anteriores a 2010, y nada que comprarías nuevo hoy en ningún tamaño que valga la pena.
512e — emulación de 512 bytes. El sector físico es de 4096 bytes, pero el disco informa de bloques lógicos de 512 bytes y traduce en el firmware. Esto existe por una razón: compatibilidad con sistemas operativos, gestores de arranque y aplicaciones que dieron por sentado los 512 para siempre. Bastante sensato como ingeniería, y la raíz de casi todos los problemas que siguen.
4Kn — 4K nativo. Los dos tamaños son de 4096 bytes. El disco dice la verdad, el host lo direcciona en la unidad que usa el medio, y no hay ninguna capa de traducción en medio.
Qué hace 512e en cada escritura desalineada
Una lectura es barata en los tres casos. El disco lee el sector de 4K y devuelve la porción de 512 bytes que pediste.
Las escrituras son donde la ficción se pone cara.
Si el host escribe un único bloque lógico de 512 bytes, el disco no puede escribir 512 bytes. El medio no tiene tal unidad. Así que hace esto en su lugar:
- Lee el sector físico entero de 4096 bytes.
- Fusiona en él los 512 bytes de datos nuevos.
- Vuelve a escribir el sector entero de 4096 bytes.
Eso es una lectura-modificación-escritura, y convierte una escritura pequeña en una lectura más una escritura. En un disco giratorio eso significa esperar a que el plato vuelva a dar la vuelta. Una rotación completa a 7 200 rpm es algo así como 8ms que no habías presupuestado. En flash el coste es distinto en clase, y no desaparece cuando la escritura termina. Ese tiene su propia sección más abajo.
La desalineación es la versión de esto que muerde más fuerte. Si una partición empieza en un desplazamiento impar de 512 bytes — el clásico es la vieja convención de 63 sectores — entonces cada escritura de 4K del sistema de ficheros cruza dos sectores físicos. Eso no es una lectura-modificación-escritura, son dos, en cada escritura, para siempre, hasta que alguien reparticione el disco.
Amplificación de escritura en flash
En un disco duro la lectura-modificación-escritura te cuesta una rotación y luego se acaba. En flash te cuesta vida del disco, y esa es una factura que pagas una vez y sigues pagando.
La amplificación de escritura es la proporción de lo que de verdad se escribió en la NAND frente a lo que el host pidió escribir. Una proporción de 1.0 significaría que el disco escribió exactamente lo que se le dio. Nunca es 1.0, porque la flash no puede sobrescribir en el sitio: el disco programa una página nueva, marca la vieja como obsoleta, y la recolección de basura reubica después las páginas supervivientes para poder borrar un bloque entero. Esas reubicaciones también son escrituras.
512e añade una capa evitable encima de eso, y la razón es un detalle que vale la pena enunciar con claridad: la capa de traducción del disco mapea en unidades de en torno a 4 KB sin importar el tamaño de bloque lógico que anuncie. Un disco que informa de bloques de 512 bytes sigue rastreando unidades de 4 KB internamente.
Así que una escritura de 512 bytes del host se convierte, dentro del disco, en: lee la unidad de mapeo de 4 KB, fusiona los 512 bytes, programa una nueva unidad de 4 KB. 4096 bytes llegan a la NAND para que 512 bytes pudieran cambiar. Ocho veces la escritura, para esa escritura.
La desalineación es menos dramática por escritura y peor en total. Una escritura de 4 KB que cruza dos unidades de mapeo ensucia las dos, así que se programan 8 KB para 4 KB de datos. Eso es una amplificación de 2× en cada escritura, permanentemente, hasta que se arregle la tabla de particiones.
Los efectos en cadena son lo que hace que esto importe en vez de ser solo desaseado:
- Más escrituras en la NAND significa que la recolección de basura corre más a menudo, y sus reubicaciones son amplificación en sí mismas.
- Una caché de escritura SLC se llena antes, así que el disco cae a su estado estacionario más lento antes y el rendimiento de escritura sostenido baja.
- Los ciclos de programa/borrado se consumen en proporción a lo que llegó a la NAND, no a lo que el host envió. Duplica la amplificación y has reducido a la mitad la vida del disco para la misma carga.
- Las valoraciones de resistencia — TBW, DWPD — se citan contra las escrituras del host. La amplificación se come ese margen en silencio, y el disco se desgasta por delante de la aritmética de garantía que hiciste al comprarlo.
Las escrituras directas y síncronas son el peor caso
La mayor parte del tiempo la caché de páginas esconde todo esto. El núcleo acumula escrituras pequeñas, las fusiona, y emite IO de 4 KB o mayor al disco, así que la lectura-modificación-escritura nunca ocurre.
Dos flags quitan esa protección, y las aplicaciones a las que les importa la durabilidad ponen las dos.
O_DIRECT se salta la caché de páginas.
Ahora no hay nada entre la aplicación y el disco que fusione una escritura de 512 bytes en algo del tamaño de un sector.
O_SYNC u O_DSYNC exige que la escritura esté en un medio estable antes de que la llamada retorne.
Eso impide que el disco absorba la escritura en un búfer volátil y la combine con sus vecinas más tarde.
Ponlos juntos y cada escritura de 512 bytes es un ciclo completo de lectura-modificación-escritura que tiene que terminar ahora, por sí solo, sin nada contra lo que amortizarse. Ahí es donde la amplificación en un disco 512e se acerca a su 8× teórico, y es exactamente el patrón que produce un log de commits de base de datos, un ZIL de ZFS o un WAL de BlueStore de Ceph.
La protección ante pérdida de energía es lo que rescata esto en el hardware empresarial. Un disco con PLP puede confirmar una escritura síncrona una vez que está en un búfer DRAM respaldado por condensadores, que es durable, y aun así fusionar internamente antes de programar la NAND. Un disco de consumo sin PLP tiene que llegar a la flash antes de poder responder, así que paga el coste completo por escritura. Una razón más de que el PLP no es opcional para esta clase de carga.
En Proxmox el modo de caché decide cuál de estos te toca:
cache=noneesO_DIRECT— el valor por defecto de PVE, y la elección correcta para HA all-flash. La caché de páginas del host queda fuera del camino, así que los patrones de escritura del invitado llegan al disco tal como el invitado los emitió.cache=directsyncesO_DIRECTmásO_DSYNC— cada escritura síncrona. Es un ajuste de nicho para discos dedicados a logs de base de datos e inusable para cargas generales.
En un dispositivo de respaldo 512e, cache=directsync con un invitado confirmando en registros de 512 bytes es más o menos el arreglo menos eficiente disponible: sin fusión en el host, sin fusión en el disco, y una lectura-modificación-escritura por commit.
Y aquí está la parte que hace 4Kn estructural en vez de meramente preferible.
O_DIRECT exige que el desplazamiento, la longitud y el búfer estén alineados al tamaño de bloque lógico del disco.
En un disco 512e eso es 512 bytes, así que una escritura directa de 512 bytes es legal y el disco la paga en silencio.
En 4Kn el bloque lógico es 4096, así que la escritura directa más pequeña que el núcleo aceptará es de 4 KB.
El patrón patológico deja de ser algo que tienes que evitar y pasa a ser algo que la pila no puede expresar.
Sobrecarga en el medio
El segundo coste es estructural, y es la razón de que Advanced Format exista siquiera.
Un sector no es solo sus datos. En un disco duro cada uno lleva una marca de sincronización para que la cabeza sepa dónde empieza el sector, un hueco para que los sectores consecutivos no se solapen, un marcador de dirección, y un campo ECC para corregir errores de lectura.
Con sectores de 512 bytes pagas todo eso ocho veces por cada 4K de datos. Con un sector de 4K lo pagas una vez.
Eso tiene dos consecuencias, y la segunda importa más que la primera:
- Parte del plato que era sobrecarga pasa a ser capacidad usable. Esta fue la motivación declarada de la industria durante la transición a Advanced Format, en porcentajes bajos de un solo dígito.
- El campo ECC puede ser mucho mayor para la misma sobrecarga total. Un código fuerte que protege 4096 bytes corrige mucho más que ocho códigos débiles que protegen 512 bytes cada uno. Según subía la densidad de área, eso dejó de ser un lujo y pasó a ser la única forma de mantener aceptables las tasas de error.
La flash no tiene marcas de sincronización ni huecos de rotación, pero la misma lógica se aplica un nivel más arriba: la NAND se programa en páginas, las páginas son mucho mayores que 512 bytes, y las tablas de mapeo del disco tienen una entrada por unidad direccionable. Bloques lógicos más pequeños significan más metadatos para rastrear la misma capacidad.
Sobrecarga en el host: comandos e interrupciones
El tercer coste es el que la gente se salta, porque no está en el disco en absoluto.
El tamaño de bloque lógico fija el suelo de cuán pequeña puede ser una IO. En un disco de bloque lógico de 512 bytes, un sistema de ficheros o una aplicación es libre de emitir una escritura de 512 bytes, y cada una es una IO completa: un comando construido y enviado, una escritura de doorbell, una entrada en la cola de finalización, y una interrupción para decir que terminó.
Cada una de esas tiene un coste fijo al que le da igual cuántos datos estaban implicados. Mueve 4KB como ocho comandos de 512 bytes y pagas ese coste ocho veces. Muévelo como un comando de 4K y lo pagas una vez.
Dos matices honestos, porque aquí es donde el argumento se exagera habitualmente.
Para IO grande, el tamaño de bloque lógico no cambia nada del número de comandos. Un solo comando puede describir muchos bloques, así que una escritura secuencial de 1MB es un comando tanto si los bloques son de 512 bytes como de 4K. El ahorro es real solo donde se está emitiendo IO pequeña.
Donde sí se emite IO pequeña, sin embargo, el efecto no es sutil: cada una de esas ocho peticiones es una que el núcleo tiene que construir, planificar y completar, cada una con su propia interrupción MSI-X y su transición de usuario a núcleo, y a profundidades de cola altas así es como consigues una tormenta de interrupciones. Dentro de una VM es peor aún, porque cada una de esas interrupciones es también un cambio de contexto de invitado.
Y las controladoras NVMe modernas fusionan interrupciones, así que el número de interrupciones no es simplemente el número de comandos. El trabajo de envío y finalización por comando permanece, sin embargo, y a unos pocos cientos de miles de IOPS el coste de CPU por comando es una fracción medible de un núcleo. Esta es la misma aritmética que las interrupciones publicadas en la serie de passthrough — pequeños costes fijos multiplicados por un número muy grande.
4Kn, metadatos de sector y RAID por hardware
Ir a un formato 4096 + 0 tiene una consecuencia que pilla a la gente, y cae de lleno sobre el RAID por hardware.
Algunas controladoras RAID y arrays de almacenamiento no usan sectores planos de 512 o 4096 bytes en absoluto. Formatean los discos a un tamaño extendido — 520 o 528 bytes, o los equivalentes de 4K como 4104, 4160 y 4224 — porque esos bytes extra por sector son donde la controladora guarda sus propios metadatos. Eso es información de protección T10-PI/DIF, o datos de integridad de fabricante, almacenados en línea con los mismísimos datos que describe.
Un formato 4096 + 0 no tiene dónde ponerlos. El sector es datos, de punta a punta, y ese es todo el objeto de elegirlo.
Así que una controladora que quiere metadatos en línea tiene tres opciones, y ninguna es gratis:
- Rechazar el disco.
- Reformatearlo de vuelta a un formato extendido, deshaciendo el trabajo de 4Kn que acabas de hacer.
- Guardar sus metadatos en otro sitio del disco.
La tercera es donde la flash te castiga. Los metadatos escritos aparte de los datos que describen son una segunda escritura, en un desplazamiento distinto, cayendo en una unidad de mapeo distinta. Otra página NAND programada por cada una que de verdad querías escribir. Esa es la amplificación de la sección de arriba, reintroducida deliberadamente, para llevar metadatos de integridad que el disco podría haber guardado en línea gratis si lo hubieras dejado en un formato extendido.
No puedes tener las dos cosas. O el sector lleva los metadatos de la controladora, o lleva solo tus datos.
Por lo que la flash ha socavado bastante el argumento del RAID por hardware
El resto de esto es juicio y no mecanismo, así que tómalo como tal.
Una controladora RAID por hardware es RAID por firmware corriendo en un procesador dedicado. El «hardware» es una CPU, algo de DRAM y una batería. No una forma fundamentalmente distinta de computar la paridad. Lo que históricamente te compraba era una caché de escritura respaldada por batería y descarga de la paridad, y en flash ambos argumentos se han debilitado mucho. La NVMe empresarial ya tiene una caché propia protegida ante pérdida de energía, y la controladora se convierte en un techo de ancho de banda por delante de dispositivos que cada uno puede saturar varios gigabytes por segundo.
También te cuesta cosas que ahora quieres activamente:
- El estado del dispositivo desaparece. El detalle SMART, los indicadores de desgaste y los registros de fabricante que te dejan calcular la amplificación de escritura están todos detrás de una abstracción opaca.
- Sin sumas de comprobación de punta a punta. Una controladora verifica la paridad, lo que detecta un disco ausente, no una respuesta equivocada de uno presente. ZFS y Ceph hacen sumas de comprobación de los datos en sí y pueden decirte qué copia está mal — corrupción silenciosa que una controladora deja pasar tal cual. Por eso, la controladora está resolviendo el problema equivocado.
- Los metadatos de fabricante en los discos atan el array a una familia de controladora, lo que es su propia clase de poco fiable cuando la controladora es lo que falla.
- El RAID de paridad hace su propia lectura-modificación-escritura en las escrituras de banda parcial, apilándose encima de todo lo de las secciones de arriba.
Para Ceph esto ni siquiera es una preferencia. La propia guía hiperconvergente de Proxmox es que los discos deben presentarse en modo HBA o passthrough, no detrás de una controladora RAID, y ZFS quiere exactamente lo mismo por las mismas razones.
Así que el arreglo que se deduce de todo esto es: un HBA en vez de una controladora RAID, discos formateados 4Kn con cero metadatos, y redundancia más sumas de comprobación hechas por ZFS o Ceph, que sí pueden decirte cuándo un disco mintió. Si algo en tu parque de verdad necesita un formato de sector extendido, eso es un o-lo-uno-o-lo-otro deliberado que resolver mientras los discos todavía están vacíos. No algo que descubrir después de construir los OSD.
Dónde muerde de verdad 512e
Sería deshonesto afirmar que 512e arruina un sistema moderno, porque normalmente no lo hace.
Una pila Linux actual lee el tamaño de sector físico, alinea las particiones a él — parted y sfdisk lo hacen ambos por defecto ahora — y usa bloques de sistema de ficheros de 4K.
En esa configuración el host emite IO de 4K alineada a 4K, el disco nunca necesita una lectura-modificación-escritura, y 512e te cuesta casi nada.
Los problemas son concretos:
- Particiones desalineadas, normalmente heredadas de una instalación vieja o una imagen clonada. Dos lecturas-modificación-escritura en cada escritura.
- ZFS con
ashift=9en un disco 512e, porque ZFS se creyó los 512 informados. Cada escritura de registro se convierte en una lectura-modificación-escritura, y no puedes cambiarashifta posteriori — el pool hay que reconstruirlo. - Aplicaciones que escriben registros de 512 bytes con O_DIRECT, saltándose la fusión de la caché de páginas. Algunas bases de datos y mucho software a medida hacen esto.
- Cualquier cosa que se fía de que el tamaño lógico sea el real. Ese es el daño de verdad en la emulación: reparte un número que es incorrecto, y las cosas aguas abajo toman decisiones con él.
4Kn quita toda la categoría. El disco no puede mentir sobre un tamaño de sector que no tiene.
Vale la pena ser claro sobre el tamaño del premio, sin embargo. La propia guía de Seagate es que 4Kn vale claramente la pena perseguirlo cuando la pila está plenamente optimizada para 4K y estás contando cada IOPS — un nivel all-flash afinado, digamos. Por debajo de eso, en un Linux moderno correctamente alineado, la diferencia de rendimiento para IO alineada suele ser pequeña. El otro argumento es la consistencia del parque: un parque uniformemente 4Kn no tiene sorpresas de formato mixto, y nadie tiene que acordarse de qué discos mienten.
La mayoría de los discos se pueden convertir — si el fabricante lo permite
Esta es la parte que se pasa por alto: 512e es a menudo un ajuste de formato, no una propiedad del hardware. Muchísimos discos SAS y SATA empresariales, y la mayoría de la NVMe empresarial, se entregan informando de 512 bytes y se reformatearán a 4Kn de buena gana.
Todo lo siguiente destruye cada byte del dispositivo. No hay conversión en el sitio.
NVMe — nvme-cli
Mira primero qué soporta el namespace:
# Lists each LBA format and marks which one is in use
nvme id-ns -H /dev/nvme0n1 | grep -i "lbaf\|data size"
Quieres un formato con Data Size 4096 y Metadata Size 0, marcado como mejor y no en uso actualmente. Luego aplícalo:
# -l/--lbaf selects the LBA format index from the list above
nvme format /dev/nvme0n1 --lbaf=1 --force
El tamaño de metadatos importa tanto como el tamaño de datos. Algunos formatos de fábrica reservan bytes extra por sector — 520, o 4160 — para llevar metadatos de protección T10-PI/DIF de punta a punta. Si nada en tu pila consume eso, es relleno en cada sector, así que elige el formato de cero metadatos y quítatelo de encima. Elegir un formato con metadatos por accidente también te deja un disco que se comporta distinto del que querías crear, y combinar un cambio de tamaño de sector con un cambio de PI puede forzar un formato completo lento en vez de uno rápido.
Para todos los discos de un host, hazlo en bucle. Esto necesita shopt -s extglob para los globs extendidos, y selecciona solo formatos que sean 4096/0 y no estén en uso:
shopt -s extglob

for dev in /dev/nvme+([0-9])n+([0-9]); do
    # Skip anything that is not actually there
    [ -e "$dev" ] || continue

    # An LBA format with 4096-byte data, 0-byte metadata, marked Best, not in use
    lbaf=$(nvme id-ns -H "$dev" \
        | grep -P '(?=.*Metadata Size: 0)(?=.*Data Size: 4096)(?=.*Best)(?!.*in use)' \
        | awk '{found=$3} END {print (found != "" ? found : -1)}')

    if [ "$lbaf" != "-1" ]; then
        echo "Formatting $dev using LBA Format: $lbaf"
        nvme format --force --lbaf="$lbaf" "$dev"
    else
        echo "Skipping $dev: no matching LBA format found."
    fi
done
Dos cosas ahí dentro hacen más trabajo del que parece.
El glob coincide con namespaces — nvme0n1, nvme12n3 — y deliberadamente no coincide con particiones como nvme0n1p1, porque el patrón termina después de los dígitos que siguen a la n. Esa es la diferencia entre reformatear un namespace y hacerle algo irrecuperable a un sistema en marcha.
Y la selección solo convierte alguna vez un disco que de verdad ofrece lo que pediste. Cualquier otra cosa cae hasta -1 y se salta, lo que cubre tres casos separados:
- El disco solo ofrece 512. No existe ningún formato de 4096 bytes, así que no hay nada a lo que convertir y el bucle lo deja en paz. No lo intenta, y no falla a medias.
- El disco ya es 4Kn. El formato 4096/0 es el que está en uso, y
(?!.*in use)lo excluye — así que una segunda pasada por el mismo host es una operación nula. Sin reformateo innecesario de cada disco. - Los únicos formatos de 4096 llevan metadatos. Un formato 4096 + 8 no satisface
Metadata Size: 0, así que el bucle no te dará en silencio un disco T10-PI que no pediste.
En otras palabras falla cerrado. Cuando no está seguro, se salta.
Una nota de portabilidad: esos lookaheads necesitan el modo -P (PCRE) del grep de GNU. En un sistema donde grep es otra cosa, el patrón no coincide con nada y cada disco se salta. Molesto, pero al menos yerra en la dirección segura.
Lee el bucle antes de correrlo, de todas formas.
Donde sí coincide, reformatea sin más avisos. nvme format --force no pregunta dos veces.
Su sitio está en el aprovisionamiento, en una máquina cuyos discos no guardan nada, nunca en un host con un OSD, pool o disco de VM en marcha.
En FreeBSD el equivalente es nvmecontrol, donde -f es el índice de formato:
nvmecontrol format -f 1 nvme0ns1
SAS y SATA — openSeaChest
El openSeaChest de Seagate es multiplataforma, de código abierto, y funciona también en discos de otros fabricantes.
# Find the handle
openSeaChest_Format --scan

# Ask the drive which sector sizes it will accept
openSeaChest_Format -d /dev/sg1 --showSupportedFormats

# Convert. The confirmation string is deliberately hard to type by accident.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
Esa frase de confirmación no es que yo esté siendo dramático. Es la cadena literal que la herramienta exige, y la parte de «may render the drive inoperable» — puede dejar el disco inoperable — es real. Un formato de bajo nivel interrumpido por un corte de luz puede dejar un disco que necesite otro formato antes de que funcione siquiera.
Por debajo, la operación difiere según el transporte: SAS y SCSI usan Format Unit, SATA usa Set Sector Configuration Ext — el camino de formato rápido — y NVMe usa NVM Format. Para un disco SAS puedes conducir Format Unit directamente, y ten en cuenta que esta opción toma la cadena de confirmación más corta:
openSeaChest_Format -d /dev/sg1 --formatUnit 4096 --poll \
    --confirm this-will-erase-data
Dos opciones distintas, dos cadenas de confirmación distintas — cámbialas de sitio y la herramienta se niega.
Donde el disco soporta un formato rápido, el tamaño de sector cambia en segundos en vez de horas; el disco hace luego su trabajo de integridad y de fondo después, y escribir tus datos reales encima reduce ese tiempo de fondo. Un formato completo escribe ceros de punta a punta y puede tardar muchas horas o días en un disco giratorio grande.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 --fastFormat \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
SCSI — sg_format
Para cualquier cosa que hable SCSI, sg3_utils hará el mismo trabajo:
# --size requires --format; expect hours on a large spinning disk
sg_format --format --size=4096 /dev/sdb

# Fast format where the drive supports it — seconds instead of hours
sg_format --format --size=4096 --ffmt=1 /dev/sdb
sg_format te da una cuenta atrás de 15 segundos antes de comprometerse, que --quick se salta.
Su documentación también advierte de un fallo concreto que conviene conocer: si el cambio de tamaño de bloque tiene éxito pero el formato luego falla, el disco puede acabar en un estado «format corrupt» — formato corrupto — y necesita otro formato para recuperarse.
Antes de convertir nada
- Comprueba el camino de arranque. Un disco 4Kn como dispositivo de arranque necesita UEFI y un SO que lo soporte. El Linux moderno va bien. El Windows más antiguo no, y algunas controladoras RAID por hardware todavía rechazan 4Kn por completo.
- Hazlo antes de que el disco guarde nada. Reajustarlo significa evacuar, convertir, restaurar.
- Haz uno, luego comprueba. Convierte un solo disco, confirma los tamaños informados, y luego haz el resto.
- Cuenta con horas en un disco giratorio sin formato rápido. No empieces un formato de bajo nivel en una máquina que necesitas de vuelta pronto.
Comprobar lo que tienes
# LOG-SEC is what the host addresses, PHY-SEC is what the medium uses
lsblk -o NAME,MODEL,SIZE,LOG-SEC,PHY-SEC

# The same, from sysfs
cat /sys/block/sda/queue/logical_block_size
cat /sys/block/sda/queue/physical_block_size

# SMART states both, and this is the clearest 512e signature there is
smartctl -a /dev/sda | grep -i "sector size"
512 bytes logical, 4096 bytes physical es un disco 512e.
Números que coinciden significan nativo — 512n si los dos son 512, 4Kn si los dos son 4096.
Y comprueba que las particiones de verdad cuadran:
parted /dev/sda align-check optimal 1
ZFS, Ceph y discos virtuales
ZFS — pon ashift=12 explícitamente al crear un pool, y no te fíes del tamaño informado por el disco, porque en 512e te dirá 9 y estará mal. No se puede cambiar después.
Ceph — el tamaño mínimo de asignación de BlueStore debería ser 4 KB en flash. El Ceph moderno usa por defecto 4096, pero las builds más antiguas usaban por defecto más — en torno a 16 KB en SSD y 64 KB en HDD — y eso le sienta mal a los discos de VM RBD, porque emiten muchas escrituras aleatorias pequeñas de 4 KB y una escritura de 4 KB que cae en una unidad de asignación de 16 o 64 KB a la vez amplifica la escritura y desperdicia el resto en relleno. Se fija al crear el OSD, así que hay que ponerlo antes de crear o reconstruir:
ceph config set global bluestore_min_alloc_size_ssd 4096 # new or rebuilt OSDs only
Hay un bluestore_min_alloc_size_hdd correspondiente. Los OSD existentes conservan aquello con lo que se construyeron, así que cambiarlo significa reconstruirlos.
Discos virtuales — un invitado ve lo que el hipervisor presenta, no el disco subyacente, así que un disco 4Kn bajo una VM todavía le da al invitado bloques de 512 bytes a menos que digas otra cosa. Mantener la pila 4K de punta a punta significa decirle a QEMU que presente 4K, que en Proxmox es una línea de argumento en bruto en /etc/pve/qemu-server/<vmid>.conf:
args: -global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096
Esa línea es lo que de verdad fuerza a QEMU a 4Kn para esos discos — -global lo aplica a cada dispositivo scsi-hd de la VM, así que al invitado se le dice 4096 tanto para el tamaño de bloque lógico como físico y particiona y alinea en consecuencia.
No entrecomilles toda la cadena. Proxmox parsea args: con Text::ParseWords::shellwords, así que esto:
args: "-global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096"
colapsa en un único argumento — las comillas se respetan y se quitan, y a QEMU se le entrega una opción larga imparseable en vez de cuatro. Sin comillas, la misma línea se parte en -global, scsi-hd.physical_block_size=4k, -global, scsi-hd.logical_block_size=4096, que es lo que quieres. Es un error fácil de cometer porque entrecomillar es el instinto correcto en una línea de comandos, y el fallo — una VM que no arranca, quejándose de la opción — no apunta de vuelta a las comillas.
Haz esto antes de instalar el SO invitado. Cambiar el tamaño de bloque de un disco bajo un sistema ya instalado puede dejarlo sin poder arrancar, porque la disposición de particiones y el gestor de arranque se escribieron para sectores de 512 bytes. Ten en cuenta también que args: es una escotilla de escape de experto fuera de la gestión de la GUI, y la interacción con la migración en vivo y las instantáneas vale la pena volver a comprobarla contra la documentación actual de Proxmox.
Cuando el invitado dice 512 y el host dice 4K
Este es el caso que vale la pena entender bien, porque es lo que consigues por defecto después de hacer todo el trabajo de arriba.
QEMU presenta bloques lógicos de 512 bytes al invitado a menos que se le diga otra cosa, sea cual sea el dispositivo de respaldo. Así que puedes convertir cada disco del host a 4Kn, y a las VM de encima todavía se les dirá 512 — y se lo creerán.
El invitado particiona entonces en fronteras de 512 bytes porque puede, y emite IO de 512 bytes porque puede. Pero el dispositivo del host ahora tiene de verdad un bloque lógico de 4096 bytes, y no aceptará una escritura de 512 bytes. Algo tiene que reconciliar los dos, y ese algo es el host: QEMU lee los 4 KB circundantes, fusiona en ellos los 512 bytes del invitado, y vuelve a escribir el conjunto.
No has quitado la emulación. La has movido del firmware del disco a tu hipervisor, donde cuesta CPU del host y un búfer de rebote en vez de ciclos del disco.
Con cache=none esto tampoco es una penalización blanda. O_DIRECT contra un dispositivo 4Kn exige desplazamientos y longitudes alineados a 4 KB, así que una escritura de invitado de menos de 4K no se puede simplemente dejar pasar — la alineación hay que arreglarla en QEMU antes de emitir siquiera la IO.
Y el caso de la desalineación vuelve una capa más arriba. Un invitado particionado con granularidad de 512 bytes pone sus escrituras de 4 KB del sistema de ficheros en desplazamientos que cruzan dos bloques de 4 KB del host, así que cada una se convierte en dos lecturas-modificación-escritura en el host. El mismo fallo que una partición desalineada en un disco 512e desnudo, salvo que ahora está pasando dentro de una VM donde nadie lo está buscando.
Así que la regla es: si el host es 4Kn, presenta 4K al invitado también, y hazlo antes de que el SO entre.
La excepción es el soporte del invitado, que es toda la razón de que 512e exista:
- Los invitados Linux manejan 4Kn sin problema.
- Windows soporta 4Kn para volúmenes de datos desde Windows 8 y Server 2012 en adelante, y arrancar desde 4Kn quiere UEFI.
- Cualquier cosa más antigua — Windows 7 y anteriores — no puede hacer 4Kn en absoluto. Para esos, un disco virtual que presenta 512 es el precio de correrlos, y el host hará la reconciliación. Si eso importa, mantén esos invitados en almacenamiento donde te cueste menos en vez de en tu nivel más rápido.
Comprueba con qué acabó de verdad el invitado, desde dentro del invitado:
lsblk -o NAME,LOG-SEC,PHY-SEC
512 ahí en un host 4Kn significa que la reconciliación de arriba está pasando en cada escritura desalineada.
Referencias
- OpenZFS — Workload Tuning —
ashift, por qué2^ashiftes la IO más pequeña posible en un vdev, y la observación de que «many devices misreport their sector sizes» — muchos dispositivos informan mal de sus tamaños de sector - Página de manual de
nvme-format—--lbaf,--namespace-id,--sesy--force - Página de manual de
sg_format—--sizecon--format, la opción de formato rápido, y la advertencia de formato corrupto - openSeaChest — las utilidades de disco de código abierto de Seagate, incluidas
--setSectorSizey--showSupportedFormats - Wiki de openSeaChest — Format, Fast Format, And Sector Sizes — qué transporte usa qué comando, y cuándo aplica el formato rápido
nvmecontrol(8)— el equivalente de FreeBSD- Documentación de la capa de bloques de Linux — cómo el núcleo modela los tamaños de bloque lógico y físico