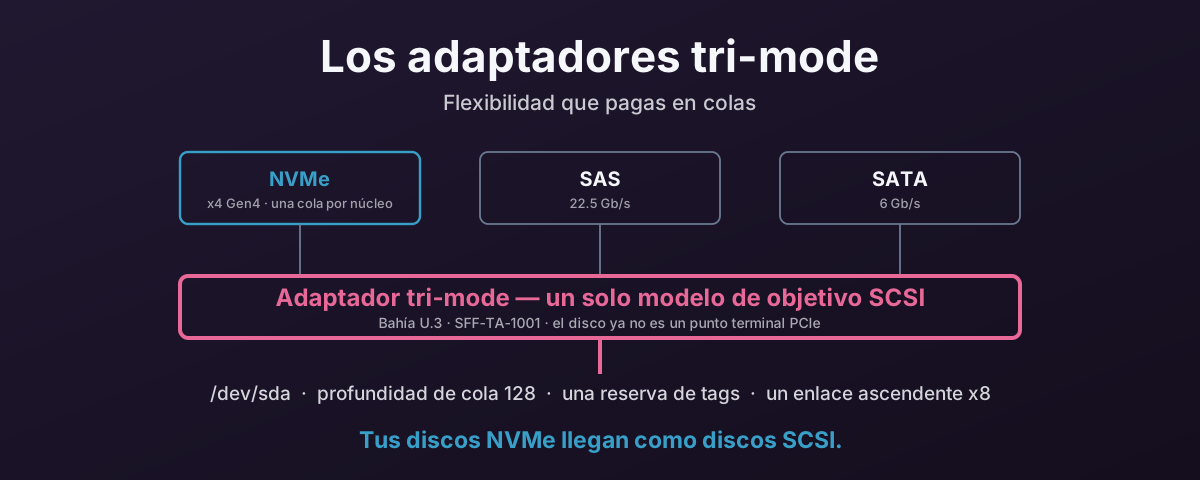
La bahía que acepta cualquier cosa
El argumento de venta de un adaptador tri-mode es de verdad bueno, y merece exponerse bien antes de desmontarlo.
Compra un chasis con un backplane U.3 y una controladora tri-mode, y cada bahía de disco se vuelve universal. La ranura 0 puede llevar un disco SAS de 24G, la ranura 1 un dispositivo de arranque SATA barato, la ranura 2 un SSD NVMe Gen4, y el adaptador negocia con lo que aparezca. Broadcom llama al silicio Tri-Mode SerDes; el estándar de bahía es SFF-TA-1001, conocido como U.3, que define un conector común para SAS x1/x2, SATA, y NVMe a x1, x2 o x4. El lado de gestión es SFF-TA-1005, Universal Backplane Management, que es como el chasis averigua con qué está hablando realmente y activa los LED de actividad correctos.
Para cualquiera que especifique servidores, eso resuelve un problema real y molesto. Ya no tienes que decidir el protocolo de almacenamiento en el momento del pedido, ni mantener dos SKU de chasis, ni descubrir que las bahías con capacidad NVMe son las cuatro de la izquierda y tus discos fueron a las otras veinte. Un solo número de pieza cubre el parque, y un parque SAS puede pasar a NVMe de disco en disco en vez de de chasis en chasis.
Nada de eso es marketing. Es la razón de que estos adaptadores se vendan, y sería tonto pretender lo contrario.
Pero la flexibilidad no es gratis, y la factura no se paga en euros. Se paga en colas.
Qué le pasa de verdad al disco
Un SSD NVMe es un punto terminal PCIe. En un servidor de conexión directa, sus cuatro líneas van al complejo raíz de la CPU — a través de un retimer o un conmutador PCIe, pero eléctrica y lógicamente es un dispositivo en el bus PCIe. El kernel lo enumera, enlaza el controlador nvme, y desde ese punto el controlador habla con los registros del disco directamente.
Pon el mismo disco detrás de un adaptador tri-mode y eso deja de ser cierto.
Las líneas del disco ahora terminan en la controladora. La documentación de Broadcom llama al bloque relevante el PCIe device bridge, y la palabra puente hace mucho trabajo: esto no es un conmutador transparente que reenvía las transacciones de tu CPU a un disco que aún puede ver. El adaptador es el punto terminal PCIe que tu host enumera. El disco es un objetivo colgado del lado lejano de él, y el firmware de la controladora vuelve a originar cada E/S.
Así que el adaptador no está pasando tus comandos NVMe a través. Los está terminando, y hablando con el disco en tu nombre.
Lo que plantea la pregunta de qué protocolo te habla a ti.
El SO nunca ve un disco NVMe
Habla SCSI.
Enchufa un SSD NVMe en un HBA tri-mode de Broadcom y no aparece como /dev/nvme0n1. Aparece como /dev/sdb, enlazado a mpt3sas — el mismo controlador que lleva más de una década corriendo controladoras LSI SAS. nvme list no devuelve nada. lsblk -o NAME,TRAN informa del transporte como sas. Para cada capa de la pila de almacenamiento por encima del controlador, compraste un disco SAS.
Esto no es un fallo ni una limitación de firmware esperando arreglo. Es el diseño. Presentar todo como un objetivo SCSI es exactamente cómo un adaptador sirve tres protocolos: la controladora normaliza SAS, SATA y NVMe en un único modelo de dispositivo, y el host obtiene un controlador, un camino de enumeración, un juego de herramientas. La flexibilidad del marketing y la presentación SCSI en dmesg son la misma decisión arquitectónica mirada desde uno u otro extremo.
Las generaciones 9500 y 9600 sí añaden un mecanismo de passthrough para que las herramientas del fabricante alcancen los comandos de administración NVMe de un disco, y las piezas más nuevas de Broadcom son mucho mejores mostrando la salud del disco de lo que era la 9400. Pero eso es un canal lateral de gestión. El camino de datos — cada lectura y escritura que emite tu carga — sigue bajando por la pila SCSI.
Y la pila SCSI tiene un modelo de colas que precede al flash en veinte años.
El modelo de colas que acabas de ceder
Esta es la parte que de verdad te cuesta rendimiento, y merece precisión, porque «el NVMe es más rápido que el SAS» no es la razón.
La decisión central de diseño de NVMe no fue un cable más rápido. Fue dejar de fingir que un dispositivo de almacenamiento es una única cosa serializada.
La especificación permite hasta 65 535 pares de colas de E/S, y esa cifra se cita en toda divulgación NVMe que existe. Es el número equivocado al que aferrarse. Ningún disco implementa nada que se le acerque, así que cualquiera que haya mirado de verdad un sistema en marcha puede descartar la comparación — y tendría razón. El número real es más pequeño, sin gloria, y transmite mejor la idea.
Así que aquí hay un disco real. No una pieza de empresa: un SSD OEM SK Hynix de 256 GB, del tipo soldado en un portátil de gama media, en una máquina de 16 núcleos.
$ nproc
16
$ cat /sys/class/nvme/nvme0/queue_count
17
$ ls /sys/block/nvme0n1/mq | wc -l
16
$ cat /sys/block/nvme0n1/queue/nr_requests
1023
Diecisiete colas: una cola de administración, y dieciséis colas de E/S para dieciséis núcleos. Cada una de 1023 comandos de profundidad. El mapeo es uno a uno — cada cola hardware está enlazada a exactamente una CPU:
$ cd /sys/block/nvme0n1/mq && grep -H . */cpu_list
0/cpu_list:1
1/cpu_list:9
2/cpu_list:3
3/cpu_list:11
...
Una CPU por cola, hasta el fondo — la cola hardware 0 sirve al núcleo 1 y a nada más.
Eso es lo que «el NVMe tiene muchas colas» significa de verdad en la práctica. No 65 535 — una por núcleo, tengas los núcleos que tengas. Linux crea un par de colas por CPU hasta lo que conceda la controladora, y las controladoras conceden mucho más de lo que un servidor típico tiene núcleos, así que en la práctica el número de núcleos es el número. Pon este disco en una caja de 64 núcleos y obtienes 64.
Ese reparto por núcleo es de donde viene el rendimiento:
- Un núcleo envía a su propia cola. Sin cerrojo, porque ningún otro núcleo la toca.
- Cada cola tiene su propio vector MSI-X, afinado a ese núcleo.
- La interrupción de finalización aterriza de vuelta en el núcleo que emitió la E/S, donde las líneas de caché relevantes ya están.
- Los dieciséis núcleos pueden estar en vuelo a la vez sin contender jamás por una estructura compartida.
El paralelismo escala con tu número de núcleos, y el trabajo de ningún núcleo se encola nunca detrás del de otro. Un disco de consumo barato hace esto. Es lo mínimo.
Ahora mira lo que el disco obtiene detrás del adaptador. Los números de abajo no son estimaciones — son constantes en el controlador mpt3sas de la rama principal.
La profundidad de cola por dispositivo se fija desde ioc->max_nvme_qd, que el controlador toma de lo que informa el firmware de la controladora y por lo demás recurre a un valor por defecto de compilación en drivers/scsi/mpt3sas/mpt3sas_base.h:
#define MPT3SAS_SATA_QUEUE_DEPTH	32
#define MPT3SAS_SAS_QUEUE_DEPTH		254
#define MPT3SAS_RAID_QUEUE_DEPTH	128
#define MPT3SAS_NVME_QUEUE_DEPTH	128
128. A un dispositivo capaz de decenas de miles de comandos en curso se le da una profundidad de cola de 128 — y fíjate en que es más superficial que el valor SAS por defecto de 254 puesto dos líneas por encima. Las capacidades propias del disco nunca entran en la decisión. El número viene de la controladora.
El número de colas hardware es peor, y el controlador es franco al respecto. De mpt3sas_scsih.c:
shost->nr_hw_queues = 1;

if (shost->host_tagset) {
	shost->nr_hw_queues =
	    ioc->reply_queue_count - ioc->high_iops_queues;
	...
	dev_info(&ioc->pdev->dev,
	    "Max SCSIIO MPT commands: %d shared with nr_hw_queues = %d\n",
	    shost->can_queue, shost->nr_hw_queues);
}
Lee eso con cuidado, porque están pasando tres cosas separadas.
El valor por defecto es una cola hardware. nr_hw_queues = 1. El multicola solo ocurre en controladoras gen35 con la función host_tagset habilitada, e incluso entonces es lo que el propio historial de commits del controlador describe como colas hardware múltiples simuladas — el hardware de la controladora de E/S es una única cola de envío con múltiples colas de respuesta, y blk-mq se está encajando encima de eso.
El número de colas viene de la controladora, no del número de núcleos. Es reply_queue_count menos las colas de alta IOPS — la asignación de vectores MSI-X del adaptador. No tiene nada que ver con cuántas CPU tienes, y no crece cuando añades discos. Esta es la inversión exacta del disco de arriba, donde el número de colas era el número de núcleos.
Y la reserva de tags es compartida. host_tagset significa exactamente lo que dice: una reserva de tags para todo el adaptador del host, y esa línea de registro dice «shared» en voz alta. Cada disco de la tarjeta saca del mismo conjunto de ranuras de comando. Un chasis de veinticuatro bahías tiene veinticuatro discos compitiendo por los tags de una controladora.
Pon los dos lado a lado. Aquel SSD de portátil tenía dieciséis colas privadas de 1023, una por núcleo, respondiendo solo a sí mismo. El mismo disco detrás del adaptador obtiene una parte de las colas de respuesta de la tarjeta, 128 comandos en curso, y veintitrés vecinos sacando de la misma reserva.
Así que la pérdida no es que SCSI sea lento. El SCSI moderno sobre blk-mq va bien. La pérdida es estructural:
- Las colas pertenecen al adaptador, no al disco. Añadir discos divide un recurso fijo en vez de sumar a él.
- La reserva de tags es compartida a escala de host. Un disco bajo carga pesada puede matar de hambre a los otros de un modo que sencillamente no puede pasar cuando cada disco tiene sus propias colas.
- La profundidad por dispositivo está topada en 128, sin importar lo que el disco pueda sostener.
- La localidad de interrupción se debilita. Las finalizaciones llegan por la cola de respuesta que usara la controladora, no necesariamente por el núcleo que envió.
Para una profundidad de cola de 1 o 2 — un proceso de un solo hilo haciendo lecturas ocasionales — nada de esto se registra. Medirás la misma latencia de cualquier forma, dentro del ruido. La penalización aparece exactamente donde compraste NVMe para ayudar: muchos núcleos emitiendo muchas E/S concurrentes. Cuanto más profunda la carga, más del disco has pagado y no puedes alcanzar.
El enlace ascendente es una sola ranura x8
El modelo de colas es el problema sutil. El techo de ancho de banda es el obvio, y puedes leerlo de las propias fichas de producto de Broadcom sin necesitar un benchmark.
El HBA de la serie 9500 es una tarjeta x8 PCIe Gen 4.0. Las cifras publicadas por Broadcom para ella son 13 700 MB/s en lectura secuencial 256K y 3 M IOPS en lectura aleatoria 4K. La misma ficha dice que admite hasta 32 dispositivos NVMe.
Pon esos dos números uno al lado del otro y la pregunta se responde sola: ¿cuántos discos hacen falta para quedarte sin adaptador?
No muchos, y menos cada año. Un SSD Gen4 x4 hace unos 7 GB/s. Un SSD Gen5 x4 hace unos 14. Ambos son piezas corrientes en 2026 — el Gen4 es de lo que está lleno el mercado U.2 de segunda mano, y el Gen5 es lo que obtienes comprando nuevo.
| Techo | Discos Gen4 para alcanzarlo | Discos Gen5 para alcanzarlo |
|---|---|---|
| HBA 9500 — 13 700 MB/s secuencial | 2 | 1 |
| HBA 9500 — 3 M IOPS (4K RR) | 3 | 1–2 |
| eHBA 9600 — 6,4 M IOPS (4K RR) | ~6 | ~3 |
| MegaRAID 9600 — 1,1 M IOPS RAID 5 (4K RW) | ~1 | ~1 |
Relee la fila de arriba. Un solo SSD Gen5 alcanza todo el techo secuencial de un HBA 9500. Un disco, en una tarjeta valorada para treinta y dos. Todo lo que viene después es capacidad. No rendimiento.
Y la fila de abajo es la que debería parar un pedido: en el MegaRAID de la generación actual, un estante lleno de NVMe en RAID 5 entrega más o menos lo que un disco corriente hace por su cuenta.
Los discos ni siquiera enlazan a x4
Hay un segundo estrangulamiento debajo del enlace ascendente compartido, fácil de pasar por alto porque se sienta en una tabla de especificaciones en vez de en un titular.
La Guía del usuario de la PERC 12 de Dell, que cubre las controladoras tri-mode H965i, dice:
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3) and 16 GT/s (Gen 4) at maximum x2 lane width.
Cada disco NVMe obtiene dos líneas, no cuatro. Así que antes de cualquier contención por el enlace ascendente, antes de la reserva de tags, antes de la traducción SCSI, un disco Gen4 ya está bajado a unos 3,5 GB/s — la mitad de lo que sabe hacer. Pon un disco Gen5 en esa bahía y negocia a la baja hacia Gen4 x2 y entrega más o menos un cuarto de su ancho de banda nominal.
Merece precisión decir qué cambia esto y qué no. No significa que el adaptador llegue más lejos. Hacen falta unos cuatro discos limitados a x2 para llenar el enlace ascendente de la 9500 en vez de dos, pero solo porque cada disco aporta la mitad. El cuello de botella se ha movido del enlace ascendente al enlace del disco. El total que puedes extraer no ha mejorado.
En conexión directa, esos mismos treinta y dos discos tendrían cada uno su propio camino x4 hacia el complejo raíz, a la generación que el disco y la CPU sepan negociar.
La fila de RAID 5 de esa tabla merece su propia mirada, porque es el número propio de Broadcom y se publica sin adornos. De la ficha de la serie 9600:
900K to 1.1M RAID 5 IOPS (4K RW)
El RAID de paridad en el firmware de la controladora es lo más caro que puedes pedirle a una tarjeta tri-mode, y esta es la generación actual haciéndolo. Vale la pena leerlo antes de que alguien especifique RAID 5 sobre veinticuatro discos NVMe y espere el rendimiento de veinticuatro discos.
¿Y una tarjeta x16?
La objeción obvia a todo lo anterior es que la 9500 es una tarjeta x8 Gen4, y el techo es un artefacto de un enlace de host estrecho. Dale al adaptador dieciséis líneas de Gen5 y el problema desaparece.
Es una objeción justa, y merece el ejemplo más fuerte en vez de un hombre de paja. Así que toma la PERC13 H975i de Dell — la generación actual, y más o menos lo mejor que da el tri-mode. Su guía del usuario especifica «Gen 4 and Gen 5 PCIe x16 host interfaces», y StorageReview midió 52,5 GB/s y 12,5 M IOPS por controladora, frente a hasta dieciséis discos NVMe.
Esos son números serios, y cambian el cuadro sustancialmente. Frente a los 13 700 MB/s y 3 M IOPS de la 9500, eso es más o menos cuatro veces el ancho de banda y cuatro veces las IOPS, repartidas sobre la mitad de discos. Dell no solo ensanchó la tubería — también partió el abanico por la mitad, y la ratio de sobresuscripción mejoró como resultado. En IOPS en particular, 12,5 M sobre dieciséis discos son unos 780K por disco, que está cerca de lo que un disco corriente entrega por su cuenta. En ese punto la controladora de verdad no es lo que te frena.
Mérito donde toca, entonces: una tarjeta tri-mode x16 Gen5 moderna es una pieza de ingeniería mucho mejor que una x8 Gen4, y si el ancho de banda era tu única objeción, x16 en gran parte la responde.
Tres cosas que no arregla.
Los discos siguen enlazando a x2. Esta es la que me sorprendió. La guía de la PERC13, describiendo una controladora Gen5 x16, aún dice:
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3), 16 GT/s (Gen 4), and 32 GT/s (Gen 5) at maximum x2 lane width.
Un enlace de host más ancho no ensancha los enlaces de disco aguas abajo. Cada disco NVMe en la controladora RAID tri-mode más nueva y rápida que vende Dell sigue conectado por dos líneas en vez de cuatro, y sigue cediendo la mitad de su ancho de banda antes de que pase cualquier otra cosa.
El modelo de colas queda del todo intacto. Nada en la sección de colas de este post es función del ancho del enlace de host. nr_hw_queues viene de la asignación de colas de respuesta MSI-X de la controladora; la profundidad por dispositivo de 128 es una constante de controlador y firmware; la reserva de tags es compartida a escala de host porque host_tagset lo dice. Ensancha el enlace de host a x16, x32, lo que quieras — los discos siguen siendo objetivos SCSI compartiendo las colas de la tarjeta, sigue sin haber /dev/nvme0n1, y sigues sin poder pasar un disco a una VM.
Y x16 no fabrica ancho de banda — abanica líneas que ya tenías. Este es el argumento que de verdad lo zanja. Dieciséis líneas Gen5 en una PERC13 te compran 52,5 GB/s compartidos sobre dieciséis bahías. Esas mismas dieciséis líneas cableadas directamente a cuatro discos Gen5 a x4 te compran unos 56 GB/s sobre cuatro bahías — el mismo ancho de banda desde las mismas líneas, salvo que cada disco obtiene sus cuatro líneas enteras, su propio par de colas por núcleo, y un nodo de dispositivo nvme real.
Así que la forma honesta de describir una tarjeta tri-mode x16 no es «un adaptador más rápido». Es un multiplexor de líneas: convierte un presupuesto de líneas fijo en más bahías de disco, y te cobra el modelo de colas por la conversión. Si ese trato es bueno depende de una sola cosa. Bahías o paralelismo.
Qué pasa cuando llenas todas las bahías
Lo que nos lleva al caso que de verdad importa, porque nadie compra un chasis de 24 bahías para meterle cuatro discos.
Pasado el punto de saturación, la línea agregada es plana. Añadir discos añade capacidad, y nada más — así que el rendimiento por disco cae como 1/N. Esa aritmética es implacable en poblaciones realistas:
| Discos en un HBA 9500 | Agregado | Por disco | Fracción de un disco Gen4 |
|---|---|---|---|
| 2 | 13,7 GB/s | 6,9 GB/s | 98 % |
| 12 | 13,7 GB/s | 1,14 GB/s | 16 % |
| 24 | 13,7 GB/s | 0,57 GB/s | 8 % |
Mira la fila de abajo. Veinticuatro discos NVMe detrás de un HBA 9500 entregan unos 570 MB/s cada uno. Un SSD SATA hace alrededor de 550. Has comprado veinticuatro discos NVMe, pagado una controladora tri-mode para conectarlos, y llegado a un ancho de banda por disco de clase SATA.
La aritmética de IOPS tiene la misma forma: 3 M repartidos sobre veinticuatro discos son 125K cada uno, frente al 1 M que un disco Gen4 corriente logra solo — más o menos un octavo de lo que posees.
La tarjeta x16 mejora esto considerablemente pero no escapa de ello. Una PERC13 a sus dieciséis discos completos son 52,5 GB/s ÷ 16 = 3,3 GB/s por disco, o más o menos el 23 % de un disco Gen5 — y eso es antes de que el enlace x2 lo vuelva a partir a la mitad.
Dos efectos con muchos discos son peores de lo que sugiere la división:
- La inanición de tags es entre dispositivos. La reserva de tags compartida del host significa que un solo disco bajo carga pesada puede consumir ranuras que otros discos necesitan. Veinticuatro dispositivos permitidos nominalmente 128 comandos en curso cada uno quieren 3 072 entre todos, sacados del
can_queuede una controladora. El bloqueo de cabeza de línea entre discos separados es un modo de fallo que sencillamente no existe cuando cada disco posee sus colas. - Las reconstrucciones golpean todo. Una reconstrucción de paridad a lo largo de un estante poblado satura el único enlace ascendente compartido, así que la E/S en primer plano hacia todos los demás discos de la tarjeta se degrada a la vez. Con discos en líneas independientes y RAID por software, la reconstrucción compite por CPU, no por una única tubería.
Cuándo nada de esto importa
Hay un contrapeso importante, y es la razón de que un montón de servidores tri-mode de 24 bahías corran perfectamente felices.
El techo del adaptador solo muerde si algo aguas abajo puede consumir más de lo que entrega. Un servidor con 2 × 25GbE tiene 6,2 GB/s de red — no puede llenar ni un HBA 9500. Si esos veinticuatro discos son un nivel de capacidad sirviendo archivos por ese enlace, el adaptador no está ni cerca del cuello de botella y la aritmética por disco de arriba es irrelevante.
El momento en que empieza a importar es cuando el consumidor se vuelve más rápido que la tarjeta: 100GbE (12,5 GB/s) te pone al nivel de todo el techo secuencial de una 9500 por sí solo, y las cargas locales — bases de datos, compilación, analítica, hosts de virtualización con invitados atareados — no tienen red alguna en el camino.
Así que la pregunta que hacerse sobre un estante poblado no es «¿es lento el adaptador?» sino «¿qué va a consumir esto, y puede consumir más de lo que la tarjeta entrega?» Si la respuesta es un enlace de 25GbE, deja de preocuparte. Si la respuesta es 100GbE, NVMe-oF, o una base de datos local, la tarjeta es tu cuello de botella y el número de discos lo empeora.
Qué más se pierde
Más allá del rendimiento, presentar un disco NVMe como un disco SCSI significa que las partes específicas de NVMe de tu kit de herramientas dejan de funcionar:
| Conexión directa | Detrás de un adaptador tri-mode | |
|---|---|---|
| Nodo de dispositivo | /dev/nvme0n1 | /dev/sdb |
| Controlador | nvme | mpt3sas / mpi3mr |
nvme-cli | Funciona | Nada con lo que hablar |
| Datos de salud | Páginas de registro SMART NVMe | Páginas de registro SCSI traducidas |
| Gestión de namespaces | Sí | No |
| Actualizaciones de firmware | nvme fw-download | Herramienta del fabricante vía la controladora |
| Format / sanitize | NVMe Format NVM | Equivalentes SCSI, si están implementados |
| Colas hardware | Un par por núcleo (16 en la máquina de arriba) | Las colas de respuesta de la tarjeta, compartidas por cada disco |
| Profundidad de cola | 1023 por cola | 128 por dispositivo |
Una consecuencia pilla a la gente lo bastante a menudo como para señalarla aparte: no puedes pasar un disco individual a una máquina virtual. El passthrough PCIe necesita que el disco sea un punto terminal PCIe con su propio grupo IOMMU, y detrás de un adaptador tri-mode no lo es — el único dispositivo PCIe presente es la controladora. Puedes pasar el adaptador entero, con todos los discos conectados a él, o nada. Si tu plan implicaba entregar discos NVMe concretos a invitados concretos, la decisión del backplane ya lo ha decidido por ti.
Entonces, ¿quién quiere esto de verdad en 2026?
Aquí es donde el argumento de venta del principio de este post tiene que enfrentarse a una pregunta más dura, porque el mundo para el que se diseñó ha desaparecido casi del todo.
El tri-mode se concibió cuando NVMe era el nivel caro que añadías a un parque SAS. En 2026 es al revés: NVMe es el valor por defecto, los discos U.2 de empresa son abundantes y baratos en el mercado de segunda mano, y «SAS, SATA y NVMe mezclados en un chasis» describe cada vez menos despliegues reales. Entonces, ¿quién lo compra de verdad?
Casi nadie — a propósito. La respuesta honesta es que la mayoría de las controladoras tri-mode no se eligieron. Llegaron, porque el fabricante del servidor envía una, y el fabricante envía una porque una única SKU de backplane U.3 le permite a él vender configuraciones SAS, SATA y NVMe desde el mismo chasis. Eso es una victoria de cadena de suministro para el fabricante. No hace nada por tu rendimiento, y como tal nunca se vendió como que lo hiciera.
Tres de las justificaciones clásicas ya no aguantan bien:
«Necesito tipos de discos mezclados.» Rara vez en el mismo chasis, e incluso cuando lo haces, el tri-mode no es la única vía. Un HBA SAS sencillo para los discos mecánicos más NVMe cableado al complejo raíz te da ambos, sin penalizar a ninguno. Un parque mezclado no implica una controladora mezclada.
«No tengo suficientes líneas PCIe.» Este era el argumento de verdad en 2019, en plataformas de 40 líneas con 24 bahías. Un Epyc Genoa o Turin de un solo zócalo tiene 128 líneas. Veinticuatro discos a x4 son 96. La escasez que justificaba agregar discos detrás de una controladora ha desaparecido casi del todo, y donde no lo ha hecho, un conmutador PCIe hace el trabajo sin terminar el protocolo.
«Las bahías tienen que ser universales.» Esta merece separarse con cuidado, porque es el argumento más usado para justificar el componente equivocado. U.3 es un estándar de backplane, no un requisito de controladora. Un backplane U.3 puede cablearse derecho a las líneas PCIe de la CPU en vez de a través de una controladora tri-mode, y los fabricantes documentan ambas topologías. Puedes conservar las bahías universales y borrar el impuesto. Si has heredado un servidor tri-mode, lo más valioso que puedes comprobar es si el backplane se puede recablear directo.
Lo que queda de verdad:
- RAID hardware a densidad, donde la política o la plataforma lo exijan — un requisito de auditoría, una matriz de soporte, un despliegue de Windows o ESXi sin capa de software que haga el trabajo. Este es el mercado real que queda, es el único caso donde estás comprando el motor RAID en vez de la conectividad, y en el silicio actual es un producto capaz: dieciséis discos NVMe en RAID 5 hardware con una caché protegida por supercondensador, desde dieciséis líneas, es algo que la conexión directa no puede ofrecer en absoluto.
- Capacidad masiva de HDD SAS, donde el €/TB todavía pertenece decisivamente a los discos mecánicos. Pero eso es trabajo de un HBA SAS sencillo, y más barato.
- Recuentos de bahías muy grandes y chasis externos, donde los expansores SAS llegan más lejos y más ancho de lo que PCIe llegará.
- Cargas que nunca van profundas. Si tus profundidades de cola se quedan en dígitos individuales, nada de esto se registra. Muchos sistemas reales viven aquí bastante felices.
Hay además un argumento operativo llano — un tipo de chasis, un controlador, un repuesto en el estante — y para un host de virtualización de propósito general eso vale algo real. Solo valóralo honestamente frente al hecho de que, según la tabla de arriba, un disco Gen5 puede alcanzar todo el techo secuencial de la tarjeta.
Cuándo es la herramienta equivocada
El trato se vuelve malo en proporción a cuánta concurrencia tenga tu carga.
Ceph es el caso más claro. Un nodo de almacenamiento corre un OSD por disco, cada uno con sus propios pools de hilos, todos emitiendo E/S a la vez — y luego un clúster entero de clientes los conduce concurrentemente. Ese es el peor caso de la reserva de tags compartida: veinticuatro demonios contendiendo por las ranuras de comando de una controladora, cada disco topado en 128 en curso, todo embudado por un enlace ascendente x8. Pon esos discos derecho en el complejo raíz y cada OSD obtiene sus propias colas, sus propios tags y sus propias líneas. Un nodo Ceph todo-NVMe no debería tener un adaptador tri-mode en el camino de datos.
La misma lógica aplica a los objetivos NVMe-oF, donde estás reexportando discos y cada capa de serialización se compone; a las bases de datos con E/S asíncrona profunda; y a cualquier cosa construida sobre io_uring o SPDK, que existen específicamente para explotar las colas por núcleo que el adaptador acaba de quitar.
La regla general: cuanto más paralelismo se escribió tu software para explotar, más te cobra un adaptador tri-mode por él.
Cómo saber qué tienes
Si has heredado un servidor y quieres saber de qué lado de esto estás:
# What is the transport? "nvme" is direct, "sas" means it went through a controller
lsblk -o NAME,TRAN,MODEL,SIZE

# Is there a tri-mode controller in the machine at all?
lspci -nn | grep -Ei 'sas|megaraid|serial attached'

# Which driver claimed the disk?
ls -l /sys/block/sdb/device/driver

# Per-device queue depth — 128 is the mpt3sas NVMe default
cat /sys/block/sdb/device/queue_depth

# How many hardware queues does this device actually get?
ls /sys/block/sdb/mq/ | wc -l
ls /sys/block/nvme0n1/mq/ | wc -l    # compare against a direct-attached drive

# On a direct-attached drive, what did the controller actually grant?
# One admin queue plus one I/O queue per core, so expect nproc + 1
cat /sys/class/nvme/nvme0/queue_count
nproc

# The driver says it out loud at load time
dmesg | grep -i 'nr_hw_queues'
Esa última imprime la línea Max SCSIIO MPT commands: N shared with nr_hw_queues = M citada antes. Si nvme list está vacío en una máquina que te dijeron que es todo-flash NVMe, el adaptador es por qué.
La versión corta
Un adaptador tri-mode convierte tus discos NVMe en discos SCSI. Esa conversión no es un efecto secundario. Es cómo una tarjeta sirve tres protocolos, y es lo que estás comprando.
Lo que cedes es específico y medible: pares de colas por núcleo reemplazados por las colas de respuesta compartidas de una controladora, una profundidad por dispositivo de 128, una reserva de tags dividida entre cada disco de la tarjeta, un enlace x2 donde el disco quería x4, y un enlace ascendente compartido donde cada disco antes tenía su propio camino al complejo raíz. El adaptador deja de ser una conexión y se convierte en el cuello de botella, y en el hardware actual se convierte en uno rápido: dos discos Gen4 alcanzan un HBA 9500, cuatro discos Gen5 alcanzan incluso una PERC13.
Un enlace de host más ancho sí ayuda — una tarjeta x16 Gen5 tiene más o menos cuatro veces el ancho de banda y las IOPS de una x8 Gen4 — pero no cambia la forma. Compra bahías, no paralelismo: las mismas dieciséis líneas cableadas derecho a cuatro discos entregan el mismo ancho de banda sin nada del impuesto de colas. Y no rescata un estante lleno. Veinticuatro discos detrás de una 9500 obtienen unos 570 MB/s cada uno, que es lo que hace un SSD SATA.
En 2019, cuando NVMe era el nivel que añadías a un parque SAS y las plataformas andaban cortas de líneas, era un trato razonable. En 2026 normalmente no lo es. NVMe es el valor por defecto, los discos U.2 usados son baratos, un Epyc de un solo zócalo tiene líneas de sobra, y el único beneficio que aún se sostiene — bahías de disco universales — pertenece al backplane U.3, no a la controladora. Muy a menudo puedes conservar las bahías y borrar el impuesto cableando el backplane derecho a la CPU.
Así que compra un adaptador tri-mode si estás comprando su motor RAID y necesitas uno. No lo compres por la flexibilidad, y si has heredado uno en un chasis lleno de NVMe, ve y averigua cómo está cableado ese backplane.
No tiene sentido pagar dos veces por discos que luego no puedes usar como es debido.