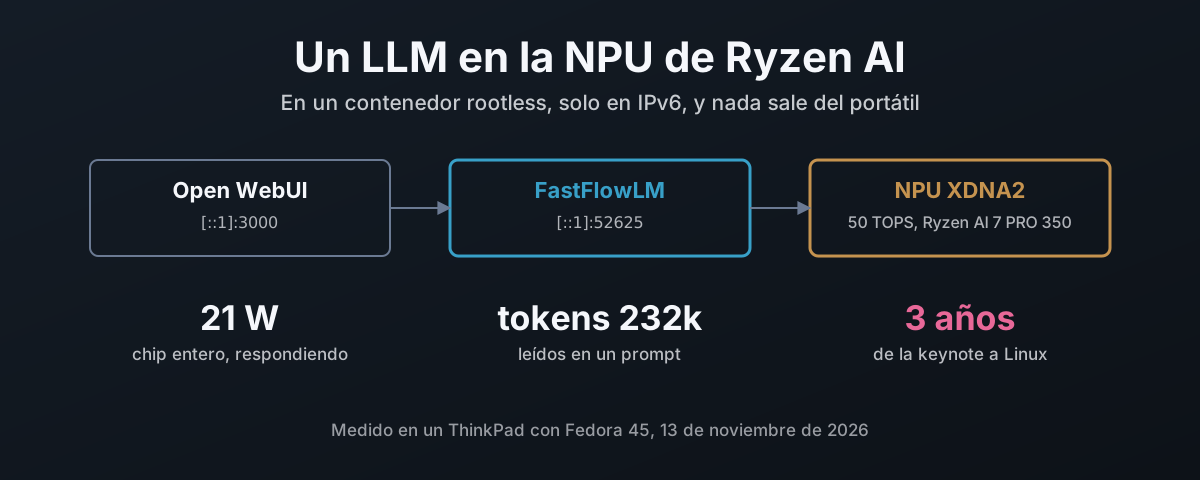
50 TOPS sin dar golpe
Todos los portátiles Ryzen AI vendidos en los últimos dos años llevan dentro una unidad de procesamiento neuronal (NPU), un bloque de silicio construido para nada más que las matemáticas que hay detrás de los modelos de IA. En el mío, un ThinkPad con un Ryzen AI 7 PRO 350, AMD la clasifica en hasta 50 TOPS, billones de operaciones por segundo1. La pagaste. En una instalación Linux de serie no hace nada.
Eso cambió este año. Una vez configurada, la NPU ejecuta un modelo de lenguaje de 4 000 millones de parámetros detrás de una ventana de chat, más voz a texto, todo en el portátil, sin cuenta, sin suscripción y sin que nada salga de la máquina, que para cualquier cosa que preferirías no teclear en la web de otro es justo de lo que se trata. El chip entero consume unos 21 W mientras responde, y en reposo se queda por debajo de 9 W.
| Qué se ejecuta | Dónde | Dirección |
|---|---|---|
| Qwen 3.5 4B, contexto de 256k tokens | NPU, en un contenedor | http://[::1]:52625/v1 |
Voz a texto: Whisper de OpenAI, whisper-v3:turbo | NPU, mismo contenedor | la misma, /audio/transcriptions |
| Open WebUI, la página de chat | CPU, en un contenedor | http://[::1]:3000 |
| driver del kernel amdxdna, firmware | host | /dev/accel/accel0 |
Dos reglas dieron forma al montaje. Solo el driver del kernel y su firmware van en el host; todo framework de modelos se ejecuta en un contenedor podman rootless. Y todo servicio escucha únicamente en el loopback IPv6, sin nada en IPv4. Las dos resultaron ser menos trabajo que hacerlo de la manera chapucera, y las dos cazaron problemas que de otro modo habría dejado pasar.
Lo que hace falta en Linux
La NPU de este chip es el diseño de segunda generación de AMD, XDNA2. Eso importa, porque el software que ejecuta modelos de lenguaje en ella soporta las piezas XDNA2 (series Ryzen AI 300 y 400, Strix Halo) y no la primera generación de los Ryzen 7040 y 80402. Comprueba la tuya antes de empezar:
$ lspci -nn | grep -i 'neural\|signal processing'
c5:00.1 Signal processing controller [1180]: Advanced Micro Devices, Inc. [AMD] Strix/Krackan/Krackan2/Strix Halo Neural Processing Unit [1022:17f0] (rev 20)
Hay cuatro capas entre ese dispositivo y una respuesta del chat, y el reparto entre host y contenedor es todo el diseño:
| Capa | Qué es | Vive en |
|---|---|---|
amdxdna | driver del kernel, crea /dev/accel/accel03 | host, vía DKMS |
| firmware de la NPU | npu_7.sbin, 1.1.2.64 en este chip | host, de linux-firmware |
XRT + plugin amdxdna | la biblioteca de runtime de AMD y su backend para la NPU | contenedor |
| FastFlowLM | el runtime del LLM, kernels de la NPU incluidos | contenedor |
El kernel 7.x trae amdxdna en el árbol, pero AMD lo desarrolla primero en su propio repositorio, y el
plugin de espacio de usuario tiene que coincidir con el módulo del kernel con el que habla4. La distancia entre los dos
no es pequeña. En este portátil:
| En el árbol, los 7.2.15 y 7.3.3 de Fedora | Fuera del árbol, amd/xdna-driver en 24dfd686 | |
|---|---|---|
| Interfaz del driver | 0.105 | 0.19 |
| Versión del módulo | ninguna | 2.27.0_20261113 |
| IDs PCI de NPU que enlaza | 6 | 8 |
| Ficheros de firmware que pide | 7 | 59 |
| Firmware que carga este chip | 17f0_10/npu_7.sbin, 1.1.2.64 | el mismo fichero |
Nueve versiones de interfaz de diferencia, y Linux 7.3, la versión más reciente, sigue llevando la 0.10. Lo único
en lo que coinciden es el firmware, y ese viene del linux-firmware de Fedora, no de ninguno de los dos
drivers. Así que compilo las dos mitades desde un mismo commit de amd/xdna-driver, pongo el módulo en el host
y meto el espacio de usuario correspondiente en la imagen.
El driver: compílalo todo, quédate solo con la parte del kernel
amd/xdna-driver lleva XRT como submódulo de git, y al compilarlo salen RPMs para XRT y un
paquete de plugin. El paquete de plugin lleva además el código fuente del driver, que registra en
DKMS (Dynamic Kernel Module Support, lo que recompila un módulo para cada kernel nuevo).
Nada de eso es difícil:
git clone --recursive https://github.com/amd/xdna-driver.git && cd xdna-driver
sudo ./tools/amdxdna_deps.sh
(cd xrt/build && ./build.sh -npu -opt)    # XRT RPMs in xrt/build/Release/
(cd build && ./build.sh -release)         # plugin RPM, driver source inside
En Fedora 45 el script de dependencias termina con un error. Ignóralo:
| Lo que pide | Qué pasa | ¿Importa? |
|---|---|---|
protobuf-devel | choca con un protobuf3-compiler ya instalado | no, sin él XRT solo se salta una herramienta de trazas |
redhat-lsb | no existe ese paquete, Fedora lo retiró | no |
| todo lo demás | ya instalado |
La última versión etiquetada allí es de febrero, así que main es el canal de publicación. Pasé de una
compilación de mayo a la de noviembre: 550 commits, XRT 2.23 a 2.27.
La actualización borra el driver que acaba de instalar
Mi primer intento de actualizar se llevó el módulo por completo. RPM ejecuta el script de instalación
del paquete nuevo, que compila y registra el driver nuevo en DKMS, y después ejecuta el script de
desinstalación del paquete viejo. Ese script de desinstalación lee la versión del driver de un fichero que el paquete nuevo ya ha
sobrescrito, así que desregistra la versión que se acaba de instalar. La salida de dnf
lo dice en dos líneas, una detrás de otra:
>>> Successfully installed and enabled DKMS for xrt-amdxdna/2.27.0
>>> Removing driver source: xrt-amdxdna/2.27.0...
Nada falló, nada se puso en rojo, y el siguiente arranque habría cargado tan tranquilo lo que trajera el kernel
en su lugar. ¿Puedo preguntar por qué un script de desinstalación se ejecuta en una actualización sin comprobar si es
una actualización? RPM le da esa respuesta a cada scriptlet como primer argumento. Es un solo if.
Es también la razón de que el host ya no reciba los RPMs en absoluto. El código fuente del driver es un tarball dentro del paquete de plugin, así que lo saco y se lo doy a DKMS directamente:
T=$(mktemp -d) && rpm2cpio xrt_plugin*.rpm | (cd $T && cpio -idm --quiet)
D=$T/opt/xilinx/xrt/share/amdxdna
sudo mkdir -p /usr/src/xrt-amdxdna-2.27.0
sudo tar -xf $D/amdxdna.tar.gz -C /usr/src/xrt-amdxdna-2.27.0
sudo cp $D/dkms.conf $D/configure_kernel.sh /usr/src/xrt-amdxdna-2.27.0/
sudo dkms install xrt-amdxdna/2.27.0
sudo modprobe -r amdxdna; sudo modprobe amdxdna
Sin reiniciar. Es Linux, y en ese momento nada tiene abierto el dispositivo, así que el módulo se cambia
en caliente. Después DKMS
lo recompila para cada kernel que instale dnf; cuando llegó el 7.3.3 ya estaba compilado antes de que yo
hubiera arrancado con él.
Comprueba que lo que se cargó es la compilación de DKMS y no la del árbol, y que el firmware es lo bastante nuevo. FastFlowLM quiere la 1.1.0.0 o posterior2:
$ modinfo -F filename amdxdna
/lib/modules/7.2.15-300.fc45.x86_64/extra/amdxdna.ko.xz
$ cat /sys/bus/pci/drivers/amdxdna/*/fw_version
1.1.2.64
$ journalctl -k | grep 'Initialized amdxdna'
[drm] Initialized amdxdna_accel_driver 0.19.0 for 0000:c5:00.1 on minor 0
DKMS aparta el módulo propio del kernel en lugar de borrarlo, a
/var/lib/dkms/xrt-amdxdna/original_module/, así que quitar la compilación de DKMS lo vuelve a poner en su sitio.
Una cosa más que no hay que tocar: amd_iommu=off en la línea de comandos del kernel desactiva la NPU2.
FastFlowLM en un contenedor
FastFlowLM es el runtime que hace útil la NPU para modelos de lenguaje. Es una línea de comandos al estilo de Ollama y un servidor compatible con OpenAI, escrito para XDNA2, y este año pasó a la organización ROCm de AMD6. El runtime tiene licencia MIT. Los kernels de NPU que trae son binarios cerrados, libres de usar y redistribuir sin modificar7. Preferiría que fueran abiertos, y lo digo, pero están en el repositorio y no hay que descargar nada de ningún otro sitio.
La imagen son tres etapas sobre Fedora 45: XRT de la compilación del driver, FastFlowLM compilado contra él, y luego un runtime con solo lo que necesita. La parte que importa:
FROM registry.fedoraproject.org/fedora:45 AS xrt
ARG XDNA_COMMIT
COPY dist/xdna-${XDNA_COMMIT}/ /rpms/
RUN dnf -y install /rpms/xrt_2*-base.rpm /rpms/xrt_2*-npu.rpm \
 && rpm -i --noscripts --nodeps --nosignature \
        --excludepath=/usr/lib/firmware --excludepath=/opt/xilinx/xrt/share/amdxdna \
        /rpms/xrt_plugin*.rpm \
 && echo /opt/xilinx/xrt/lib64 > /etc/ld.so.conf.d/xrt.conf && ldconfig
Cada una de esas opciones está ahí porque algo se rompía sin ella:
| Problema | Arreglo |
|---|---|
| Los scripts del plugin compilan un módulo del kernel, y eso va en el host | --noscripts, y el código del driver y el firmware excluidos |
| El RPM 6 de Fedora 45 exige por defecto la comprobación de firmas8, y un RPM compilado por uno mismo no está firmado | --nosignature: lo compilé yo, sé de dónde viene |
Las bibliotecas de XRT están en lib64, que no está en la ruta del enlazador | /etc/ld.so.conf.d/xrt.conf dentro de la imagen |
FastFlowLM encuentra XRT con pkg-config, y el setup.sh de XRT no fija la ruta | PKG_CONFIG_PATH=/opt/xilinx/xrt/lib64/pkgconfig en la etapa de compilación |
La imagen terminada ocupa 609 MB, y su etiqueta lleva el commit del driver,
fastflowlm:v1.0.12-xdna24dfd686. Una comprobación de salud lo compara con el commit que informa el
módulo cargado y falla si no coinciden. Una imagen compilada para el driver equivocado es el único fallo
aquí que de verdad cuesta diagnosticar, así que se caza antes de que llegue tan lejos.
El contenedor recibe un dispositivo, la NPU, y el límite de memoria bloqueada que FastFlowLM necesita para fijar sus búferes:
podman run --rm --device /dev/accel/accel0 --ulimit memlock=-1:-1 \
  localhost/fastflowlm:v1.0.12-xdna24dfd686 validate
[Linux]  NPU: /dev/accel/accel0 with 8 columns
[Linux]  NPU FW Version: 1.1.2.64
[Linux]  Memlock Limit: infinity
La propia autoprueba de AMD, xrt-smi validate, puso la NPU en 51 TOPS en una multiplicación de matrices. Esos son los
50 de la caja, cumplidos.
Arranca con el sistema, solo en IPv6
Quadlet convierte un fichero .container corto en un servicio de systemd9. Como unidad de usuario se ejecuta
rootless, como yo, y con lingering activado arranca con el sistema sin que nadie haya iniciado sesión10:
[Unit]
Description=FastFlowLM NPU server
ConditionPathExists=/dev/accel/accel0

[Container]
Image=localhost/fastflowlm:v1.0.12-xdna24dfd686
AddDevice=/dev/accel/accel0
Ulimit=memlock=-1:-1
Network=host
Volume=%h/.config/flm:/models:Z
Exec=serve qwen3.5:4b --host ::1 --port 52625 -c 262144 -a whisper-v3:turbo
StopSignal=SIGINT

[Install]
WantedBy=default.target
loginctl enable-linger $USER
cp fastflowlm.container ~/.config/containers/systemd/
systemctl --user daemon-reload && systemctl --user start fastflowlm
-c 262144 fija la ventana de contexto, y la prueba de contexto de más abajo es
la razón de que sea tan grande. -a whisper-v3:turbo carga un segundo modelo junto al modelo de chat, uno que
convierte voz en texto; tiene su propia sección.
Tres líneas de ahí se aprendieron por las malas:
| Línea | Sin ella |
|---|---|
StopSignal=SIGINT | FastFlowLM ignora SIGTERM, la señal de parada de podman, y lo matan diez segundos después |
--host ::1 | escucha en 127.0.0.1, IPv4 |
::1, no [::1] | la forma con corchetes no se analiza; los corchetes van dentro de una URL |
Demuestra la dirección en lugar de fiarte de ella:
$ ss -ltn 'sport = :52625'
LISTEN 0  4096  [::1]:52625  [::]:*
$ curl -s http://127.0.0.1:52625/v1/models || echo refused
refused
localhost sigue funcionando para todo lo que lo resuelva primero a ::1, cosa que hacen tanto el
/etc/hosts de Fedora como Chrome.
Lo que hace, medido
Nueve modelos por el benchmark propio de FastFlowLM, siendo la decodificación la velocidad a la que fluye la respuesta:
| Modelo | Decodificación, contexto 1k | Decodificación, contexto 8k | Lectura del prompt, 8k |
|---|---|---|---|
llama3.2:1b | 77 tok/s | 56 tok/s | 2 009 tok/s |
qwen3.5:2b | 32 | 29 | 1 533 |
llama3.2:3b | 30 | 20 | 857 |
phi4-mini-it:4b | 25 | 17 | 744 |
qwen3:4b | 23 | 15 | 613 |
qwen3.5:4b | 17 | 15 | 657 |
gemma4-it:e4b | 14 | 12 | 642 |
qwen3:8b | 13 | 10 | 418 |
qwen3.5:9b | 11 | 10 | 451 |
El ritmo de lectura es de cinco a ocho tokens por segundo, así que cualquiera de estos va por delante de ti. La decodificación
se reduce más o menos a la mitad cada vez que el modelo se duplica, que es lo esperable cuando el límite es el ancho de banda de
memoria y no el cómputo. Yo uso qwen3.5:4b. Phi-4 mini es más rápido, pero Qwen 3.5 mantiene su velocidad a medida que crece una conversación,
maneja imágenes y llamadas a herramientas, y guarda una caché de prompt que ahorra releer todo el historial en
cada turno. Eso lo decide.
256 000 tokens de contexto
Qwen 3.5 está hecho para una ventana de 262 144 tokens11, y FastFlowLM viene por defecto con 32 768. Pasado ese
límite hace algo que conviene saber: registra Max length reached, stopping prefilling
y cierra la conexión sin respuesta y sin error, así que la ventana de chat se queda ahí con una respuesta
vacía y te toca adivinar si se cayó el modelo, el servidor o el navegador.
Así que lo subí con -c 262144 y lo probé como es debido. Un código escondido en la primera línea de un
prompt de 232 250 tokens, unas 175 000 palabras, preguntado al final:
| Contexto 8k | Contexto 232k | |
|---|---|---|
| Respuesta | correcta | correcta, AMBER-FALCON-7731 |
| Lectura del prompt | 657 tok/s | 210 tok/s |
| Espera hasta la primera palabra | 12 segundos | 18,4 minutos |
| Decodificación | 15 tok/s | 2,4 tok/s |
| Memoria reservada | ~5 GB | ~12,7 GB |
Funciona. Es lento. Y la memoria queda reservada uses la ventana o no. Con 90 GB en la máquina, pago eso por que un texto largo pegado reciba respuesta en lugar de descartarse en silencio.
¿Puede ayudar la GPU?
El mismo chip lleva una Radeon 860M, así que la pregunta obvia es si puede quitarle algo de carga. Repartir un modelo entre la NPU y la GPU, leyendo el prompt en una y escribiendo la respuesta en la otra, no es algo que haga hoy ningún runtime de Linux. Ejecutar un segundo runtime en la GPU sí, así que medí eso.
«Eficiente» aquí significa velocidad y energía juntas. El driver amdgpu informa de la potencia del paquete para
el chip entero sin root, y el driver amdxdna informa de la NPU por separado, así que cada ejecución
de abajo se muestreó cuatro veces por segundo. El mismo modelo a 4 bits en todas.
De los runtimes de GPU que miré, funcionó uno:
| Runtime | Resultado en la 860M |
|---|---|
| llama.cpp, backend Vulkan12 | funciona; imagen de 881 MB |
| llama.cpp, backend ROCm | ve la GPU y luego da un segfault con la primera tarea, con o sin forzar la versión de GPU; imagen de 23 GB |
| MLC-LLM, Vulkan13 | su compilador da un segfault al construir la arquitectura de Qwen 3.5 |
| vLLM, SGLang | no probados: hechos para GPUs de centro de datos y muchos usuarios, no para una iGPU de 8 unidades |
Y la NPU frente al que funcionó:
| Qwen 3.5 4B | NPU, FastFlowLM | GPU, llama.cpp Vulkan |
|---|---|---|
| En reposo, modelo cargado | 8,6 W | 16,0 W, frente a 9,7 W con él parado |
| Lectura del prompt, ~6k tokens | 557 tok/s a 23,8 W | 411 tok/s a 46,1 W |
| Energía por token de prompt | 0,043 J | 0,112 J |
| Decodificación | 18,2 tok/s a 21,0 W | 23,5 tok/s a 40,7 W |
| Energía por token generado | 1,16 J | 1,73 J |
La GPU escribe las respuestas un 29 % más rápido. Quema el doble de potencia haciéndolo. La NPU lee los prompts más rápido y con menos de la mitad de energía. El número gordo es el de reposo: el servidor de GPU cargado y sin hacer nada cuesta 6,3 W por encima de la misma máquina con él parado, todo el día. Ejecutar los dos a la vez bajó la NPU de 18,2 a 14,2 tokens por segundo y la GPU de 23,5 a 13,9, porque comparten la misma memoria. Por eso el contenedor de GPU existe, pero lo arranco cuando quiero un segundo modelo, y no está activado en el arranque.
La NPU en sí consumió menos de 2 W en todas las ejecuciones. La mayor parte de los 21 W son la CPU y la memoria alimentándola. Ese es el techo que merece la pena vigilar en las próximas versiones de FastFlowLM.
Voz a texto, también en la NPU
Whisper es el modelo de reconocimiento de voz de OpenAI: entra audio, sale texto, en 99 idiomas, y publicado con licencia MIT, así que se ejecuta en cualquier parte sin pedir permiso a nadie14. Large-v3 es la versión completa actual. Turbo es el mismo modelo con su decodificador, la mitad que escribe el texto, recortado de 32 capas a 4. La ficha del modelo plantea el intercambio sin rodeos: «way faster, at the expense of a minor quality degradation». Con 809 millones de parámetros, es una quinta parte del tamaño del modelo de chat.
FastFlowLM lo trae ya convertido para la NPU como whisper-v3:turbo, una descarga de 623 MB, y
lo carga junto al modelo de chat con -a whisper-v3:turbo. No sirve Whisper por sí solo;
tiene que haber también un modelo de chat cargado. El audio va al endpoint estándar de transcripción de OpenAI
y el texto vuelve.
| 19,6 segundos de voz | |
|---|---|
| Primera petición, cargando Whisper | 6,2 s |
| Después | 2,0 s, unas diez veces el tiempo real |
| Potencia del chip entero | ~24,7 W |
| Precisión | todas las palabras bien |
Eso sí, escritas con la falsa ortografía del inglés americano: «color» y «program». La API de Whisper acepta un prompt, y un
prompt escrito con la auténtica ortografía británica, el inglés de Inglaterra, de donde viene el idioma,
basta para arreglarlo:
curl -s 'http://[::1]:52625/v1/audio/transcriptions' -F file=@speech.wav \
  -F model=whisper-v3:turbo -F language=en \
  -F 'prompt=British English spelling: colour, programme, organise, centre.'
No deberíamos tener que corregir a estos modelos en absoluto. Whisper se entrenó con 99 idiomas y aun así escribe el inglés a la americana salvo que se le diga lo contrario, porque la gente que lo construyó trata su ortografía como la de serie y la de todos los demás como una opción que hay que pedir. Ese es el molesto defaultismo americano que odia el resto del mundo, y viene horneado como un sesgo. El prompt de sistema del modelo de chat lleva la misma instrucción, en la sección de abajo, por la misma razón.
Una ventana de chat, y 7 000 tokens que nunca escribiste
Open WebUI es la interfaz de navegador15, en su propio contenedor, atada a [::1]:3000 de la misma
manera y apuntando a la NPU. Su botón de micrófono va a Whisper en la NPU en lugar de a su opción
por defecto, que habría descargado un modelo y lo habría ejecutado en la CPU.
El primer mensaje que le mandé eran veinte palabras. Llegó a la NPU como un prompt de 7 223 tokens, porque Open WebUI 0.13 adjunta las definiciones de todas sus herramientas integradas (memoria, notas, calendario, automatizaciones, búsqueda web) a cada mensaje, y un administrador las recibe todas.
| La misma pregunta de veinte palabras | Prompt enviado a la NPU | Espera hasta la primera palabra |
|---|---|---|
| Herramientas integradas activadas, por defecto | 7 223 tokens | ~12 s |
| Herramientas integradas desactivadas para el modelo | 127 tokens | menos de 1 s |
Para un modelo local, ese valor por defecto debería estar desactivado. Doce segundos, en cada respuesta.
Además me dijo muy seguro que había sido «trained by Google» y que se ejecutaba «on Google’s advanced infrastructure». Es un modelo Qwen, hecho por Alibaba, ejecutándose en un portátil. Eso es un disparate de principio a fin, y no debería pasar.
No es la configuración. Un modelo solo ve el texto que se le envía, y el nombre del desplegable es una etiqueta para el servidor, que nunca se pasa al modelo. Así que esa respuesta vino solo del modelo, y se equivocó en el único dato sobre sí mismo que nunca debería estar en duda. Eso es un defecto de diseño, y la responsabilidad es de quien publicó el modelo.
Alibaba sabía cómo evitarlo. La plantilla de chat de Qwen 2.5 abría cada conversación con «You are Qwen, created by Alibaba Cloud» salvo que le dieras otra cosa16. Qwen 3 quitó esa línea17, y Qwen 3.5 también sale sin ella18. Nada la sustituyó, y a juzgar por esa respuesta al modelo nunca se le enseñó lo bastante bien como para apañárselas solo. Pregúntale a un modelo 4B «¿qué eres?» sin prompt y recurre a la respuesta más común de sus datos de entrenamiento, que es la de otro.
¿Es una cosa menor? No. Un modelo que te dice, con total seguridad, quién lo construyó y en el centro de datos de quién se ejecuta, y falla en las dos, hará lo mismo con cualquier otra cosa que no pueda comprobar. Aquí sabes la respuesta correcta. La mayoría de las veces no la sabrás.
Así que hay que decírselo, en un prompt de sistema:
| Pregunta: «what are you, and what are you running on?» | Respuesta |
|---|---|
| Sin prompt de sistema | «a large language model trained by Google… Google’s advanced infrastructure» |
| Con uno | «Qwen 3.5, a large language model created by Alibaba… running locally on your Lenovo ThinkPad using the AMD Ryzen AI 7 PRO 350’s NPU via FastFlowLM» |
El mismo prompt le dice que escriba en inglés británico, otra vez por el defaultismo americano que también tiene Whisper. Si se le dice, lo hace. Lo que sigue sin poder decirte es qué día es. Un modelo sin calendario y sin internet adivina fechas y acontecimientos recientes, y no siempre lo dirá, pida lo que pida el prompt.
Tres años para ejecutar IA en Linux
AMD subió Ryzen AI al escenario en enero de 2023 como «the first dedicated artificial intelligence hardware in an x86 processor»19. Cuenta hacia delante desde esa keynote:
| Cuándo | Qué pasó en Linux | Después de la keynote |
|---|---|---|
| 4 de enero de 2023 | Ryzen AI anunciado, en el Ryzen 7040 | |
| 25 de enero de 2024 | amd/xdna-driver publicado en GitHub4 | 1 año |
| 24 de marzo de 2025 | amdxdna en Linux mainline, 6.1420 | 2 años y 2 meses |
| 27 de marzo de 2025 | sale este chip, el Ryzen AI 7 PRO 3501 | 2 años y 2 meses |
| 11 de marzo de 2026 | FastFlowLM 0.9.35, su primera versión nativa para Linux21 | 3 años y 2 meses |
| 11 de agosto de 2026 | FastFlowLM 1.0.0, ya bajo ROCm de AMD6 | 3 años y 7 meses |
| hoy | todavía ningún runtime de LLM para los 7040 y 80402 | 3 años y 10 meses |
Tres años y dos meses para ejecutar siquiera un modelo de lenguaje en la NPU bajo Linux, y no lo hizo el software de la propia AMD. Lo hizo FastFlowLM, un proyecto que empezó fuera de la empresa y que fue absorbido bajo ROCm este año. Sus notas de versión para Linux abren con «The wait is finally over», y luego dicen que usa «the exact same recipe you already know and love on Windows»21. El Fisher-Price OS (Windows) lo tuvo primero, y lo dijeron. El propio Ryzen AI Software de AMD sigue diciendo, en sus notas de versión actuales, «Model generation is not supported on Linux in this release»22.
Quien compró la primera generación lo tiene peor. Un portátil Ryzen 7040 de 2023 tiene una NPU que ningún runtime de modelos de lenguaje en Linux va a tocar, y nada publicado dice que vaya a llegar uno. La misma pegatina.
¿Puedo preguntar por qué? No quién, por qué. ¿Qué hay en el proceso de AMD que permitió vender un chip con IA en el nombre mientras el software para usar esa IA en Linux aparecía años después, y desde fuera? La ficha técnica dice «Up to 50 TOPS»1. La pegatina dice Ryzen AI. Las dos son afirmaciones hechas a la persona que compra el portátil, y durante el primer año de este chip en Linux las dos no valieron nada.
Apuntado a Copilot, no al centro de datos
No es que a AMD Linux le resulte difícil. En el centro de datos Linux es de primera clase y AMD lo sabe: El Capitan, en Lawrence Livermore, son procesadores AMD EPYC y aceleradores AMD Instinct, fue el ordenador más rápido del mundo hasta junio de este año23, y ejecuta TOSS, la compilación propia de Red Hat Linux de Livermore24. ¿Te imaginas a AMD vendiendo un acelerador Instinct y diciéndole al comprador que el software para Linux llegaría algún día, de mano de otro? La respuesta sería no. AMD incluso escribió el driver del kernel de esta NPU y lo metió en mainline. La última capa, la que hace que el hardware haga el trabajo para el que se vendió, fue la que se quedó esperando.
Nunca debería haber sido un proyecto de portátil. La misma arquitectura XDNA entró en una tarjeta de centro de datos ese mismo año, la Alveo V70, vendida como «the first Alveo production card leveraging AMD XDNA architecture with AI Engines»25. Construye una sola pila de software para el AI Engine, primero en Linux como el resto del centro de datos, y el portátil la recibe gratis. Y el servidor también. Un acelerador pequeño y frugal es exactamente lo que quieres repartir entre máquinas virtuales, un trozo para cada una, para los modelos pequeños que no necesitan una GPU entera. El kernel aprendió a hacerlo justo este año, partiendo una NPU en funciones virtuales en las nuevas piezas AIE426. En la NPU de este portátil no puede hacerlo en absoluto.
En su lugar, el esfuerzo se fue al Fisher-Price OS (Windows), y a Copilot. AMD lanzó la generación de este chip como procesadores que «Unlock Transformational AI Experiences for Windows Copilot+ PCs»27. Casi nadie picó. Las máquinas Copilot+ fueron el 2,3 % de los PCs con Fisher-Price OS (Windows) vendidos en el primer trimestre de 2025, y las funciones más nuevas de Copilot de Microsoft se ejecutan en la nube de todas formas: «only one of its new AI capabilities actually requires an NPU»28. Microsoft además informa de que lo que gana con los fabricantes de PCs bajó un 7 % por «lower PC market demand», con «roughly 30% of the installed base still on Windows 10»29. Así que la NPU se apuntó a un sistema operativo al que la gente no está actualizando, para ejecutar un asistente que no pidió, que en su mayor parte no usa la NPU.
Tampoco es donde se construye la IA. La gente que se dedica a esto vive en Linux, porque ahí es donde corren sus herramientas. TensorFlow dice claramente que la 2.10 «was the last TensorFlow release that supported GPU on native-Windows»30. El servidor de modelos vLLM «does not support Windows natively»31. JAX lista su versión para Fisher-Price OS (Windows) como experimental, y su soporte de AMD como «AMD GPU (Linux)»32. Donde el Fisher-Price OS (Windows) sí ejecuta estas herramientas, es a través de WSL 2, que según la propia descripción de Microsoft es «an actual Linux kernel inside a managed VM»33. AMD apuntó su chip de IA al único escritorio que la profesión de la IA no usa. Darle soporte a medias no basta, AMD.
Y luego AMD se vende a los inversores como empresa de IA. El 11 de noviembre de 2025 su presidenta y consejera delegada dijo que AMD «is uniquely positioned to lead the next generation of high-performance and AI computing», en un comunicado que presume de haber hecho crecer su «AI PC portfolio 2.5x since 2024» y que se despide con «full-stack AI solutions»34. Pila completa. En el PC con IA de este artículo, la parte de arriba de esa pila vino de un proyecto que AMD no empezó, y en la primera generación nunca llegó. ¿Una empresa de IA cuyo propio chip de IA esperó tres años para ejecutar IA en el sistema operativo sobre el que está construido su negocio de centro de datos? De risa.
El soporte de primera clase es fácil de describir. Funciona el día que compras la máquina, en el sistema operativo que usas, de la empresa que te vendió el chip. Esta NPU todavía no lo ha cumplido. Compré el portátil por todo lo demás y la NPU vino con él, que es la única razón de que esto sea un artículo y no una queja. Cualquiera que comprara uno por la IA de la pegatina, y use Linux, compró una promesa que se cumplió tarde, y la cumplió otro.
Sé dueño del silicio que pagaste
La NPU venía con el portátil. Tal como se vende, es la pieza que deja la máquina lista para la IA, y la IA que se ofrece es la de otro, en el centro de datos de otro, leyendo lo que tecleas para poder cobrarse de alguna otra manera. Nada del hardware necesita ese arreglo. Un modelo 4B a 21 W responde una pregunta, lee un texto pegado de 175 000 palabras si le das tiempo, y pone por escrito lo que dices, y nada de eso sale de la mesa.
Software terminado no es, y cada arista de arriba costó una hora encontrarla y una línea o dos arreglarla. Eso es lo que cuesta el código abierto cuando de verdad lo usas. Sigue siendo mejor trato que volver a alquilar la misma capacidad, y la hora te compra saber cómo funciona.
Los contenedores lo mantienen honrado. Nada en el host salvo un módulo del kernel y su firmware, un dispositivo pasado a un contenedor, una dirección a la que nadie más puede llegar, y una comprobación que falla en cuanto las piezas dejan de coincidir. Me llevó un día. Seguirá funcionando, porque sé por qué está ahí cada línea y la comprobación me avisará la mañana en que una de ellas deje de ser cierta.
AMD — Ryzen AI 7 PRO 350 — 8 núcleos, 16 hilos, Radeon 860M, «NPU TOPS: Up to 50 TOPS», fecha de lanzamiento «3/27/2025». ↩︎ ↩︎ ↩︎
Lemonade — LLMs on Linux with FastFlowLM — solo XDNA2 (Ryzen AI 300/400, Strix Halo), no XDNA1; firmware de NPU 1.1.0.0 o posterior; no fijar
amd_iommu=off. ↩︎ ↩︎ ↩︎ ↩︎Linux kernel documentation — amdxdna — el driver de acelerador del árbol para las NPU de AMD. ↩︎
amd/xdna-driver — driver, submódulo XRT y plugin; compila el paquete base de XRT desde el submódulo incluido para que funcione con el plugin; repositorio creado el 25 de enero de 2024. ↩︎ ↩︎
Linux v7.3 — drivers/accel/amdxdna/amdxdna_pci_drv.c —
AMDXDNA_DRIVER_MAJOR 0,AMDXDNA_DRIVER_MINOR 10; lo mismo en la v7.2. ↩︎ROCm/FastFlowLM — runtime de LLM en NPU para XDNA2, servidor compatible con OpenAI, parte de ROCm desde la v1.0.0; la versión usada aquí es la v1.0.12. ↩︎ ↩︎
FastFlowLM — LICENSE_BINARY.txt — condiciones para los binarios de kernels de NPU incluidos. ↩︎
RPM 6.0.0 release notes — «RPM defaults to enforcing signature checking». ↩︎
podman-systemd.unit(5) — unidades
.containerde Quadlet, incluidasAddDevice=,Ulimit=,StopSignal=yExec=. ↩︎loginctl(1) —
enable-lingerarranca un gestor de usuario con el sistema y lo mantiene en marcha tras cerrar sesión. ↩︎Qwen/Qwen3.5-4B — «Context Length: 262,144 natively»; capas híbridas de Gated DeltaNet y atención con compuerta. ↩︎
ggml-org/llama.cpp — la imagen de contenedor
server-vulkanusada para las ejecuciones en GPU, build 12352. ↩︎mlc-ai/mlc-llm — probado con los paquetes nightly 0.26. ↩︎
openai/whisper-large-v3-turbo — «a state-of-the-art model for automatic speech recognition (ASR) and speech translation»; podado a partir de large-v3, «the number of decoding layers have reduced from 32 to 4»; 809M parámetros; licencia MIT. ↩︎
open-webui/open-webui — versión v0.13.3 usada aquí. ↩︎
Qwen/Qwen2.5-7B-Instruct — tokenizer_config.json — el mensaje de sistema por defecto de la plantilla de chat: «You are Qwen, created by Alibaba Cloud. You are a helpful assistant.» ↩︎
Qwen/Qwen3-4B — tokenizer_config.json — plantilla de chat sin mensaje de sistema por defecto. ↩︎
Qwen/Qwen3.5-4B — tokenizer_config.json — plantilla de chat sin mensaje de sistema por defecto. ↩︎
AMD — AMD Highlights Future of High-Performance and Adaptive Computing During Opening Keynote of CES 2023 — 4 de enero de 2023: «AMD also unveiled Ryzen AI Technology – the first dedicated artificial intelligence hardware in an x86 processor.» ↩︎
Kernel Newbies — Linux 6.14 — publicado el lunes 24 de marzo de 2025; «an amdxdna driver for AMD NPUs». ↩︎
FastFlowLM v0.9.35 release notes — 11 de marzo de 2026: «The wait is finally over… FastFlowLM is officially available natively on Linux!» ↩︎ ↩︎
AMD — Ryzen AI Software release notes — problemas conocidos: «Model generation is not supported on Linux in this release.» ↩︎
TOP500 — June 2026 — «LineShine debuts as the new No. 1 system, ending El Capitan’s run atop the list»; El Capitan «is based on AMD 4th generation EPYC processors… and AMD Instinct MI300A accelerators». ↩︎
LLNL — TOSS: Speeding Up Commodity Cluster Computing — «a fully functional cluster operating system, based on Red Hat Linux». ↩︎
AMD — Alveo V70 — «the first Alveo production card leveraging AMD XDNA architecture with AI Engines… designed for AI inference efficiency». ↩︎
Linux — accel/amdxdna: Add basic support for AIE4 devices — «Add initial support for AIE4 devices (PCI device IDs 0x17F2 and 0x1B0B), including… SR-IOV enablement». La tabla del driver da entradas de función virtual solo a esas piezas; la NPU de este portátil es
17f0. ↩︎AMD — AMD Unveils Next-Gen “Zen 5” Ryzen Processors to Power Advanced AI Experiences — Computex, 2 de junio de 2024: «AMD Ryzen AI 300 Series Processors Unlock Transformational AI Experiences for Windows Copilot+ PCs». ↩︎
Engadget — Microsoft’s Copilot+ AI PC plan fizzled, but it still served a purpose — 5 de diciembre de 2025: los sistemas Copilot+ «made up just 2.3 percent of Windows machines sold in the first quarter of 2025»; «only one of its new AI capabilities actually requires an NPU». ↩︎
Windows Latest — Microsoft admits its end of support was the real Windows 11 sales driver — 31 de julio de 2026, citando la presentación de resultados de Microsoft: «Windows OEM and Devices revenue decreased 7%… driven by lower PC market demand»; «roughly 30% of the installed base still on Windows 10». ↩︎
TensorFlow — Install TensorFlow with pip — «TensorFlow 2.10 was the last TensorFlow release that supported GPU on native-Windows.» ↩︎
vLLM — GPU installation — «vLLM does not support Windows natively». ↩︎
JAX — Installation — wheels de CPU para «Windows, x86_64 (experimental)»; secciones de GPU para NVIDIA, Google Cloud TPU, Mac y «AMD GPU (Linux)». ↩︎
Microsoft — Comparing WSL versions — «the use of an actual Linux kernel inside a managed VM». ↩︎
AMD — AMD Unveils Strategy to Lead the $1 Trillion Compute Market and Accelerate Next Phase of Growth — Financial Analyst Day, 11 de noviembre de 2025: «AMD is uniquely positioned to lead the next generation of high-performance and AI computing»; «AMD has expanded its AI PC portfolio 2.5x since 2024»; «AMD delivers full-stack AI solutions». ↩︎