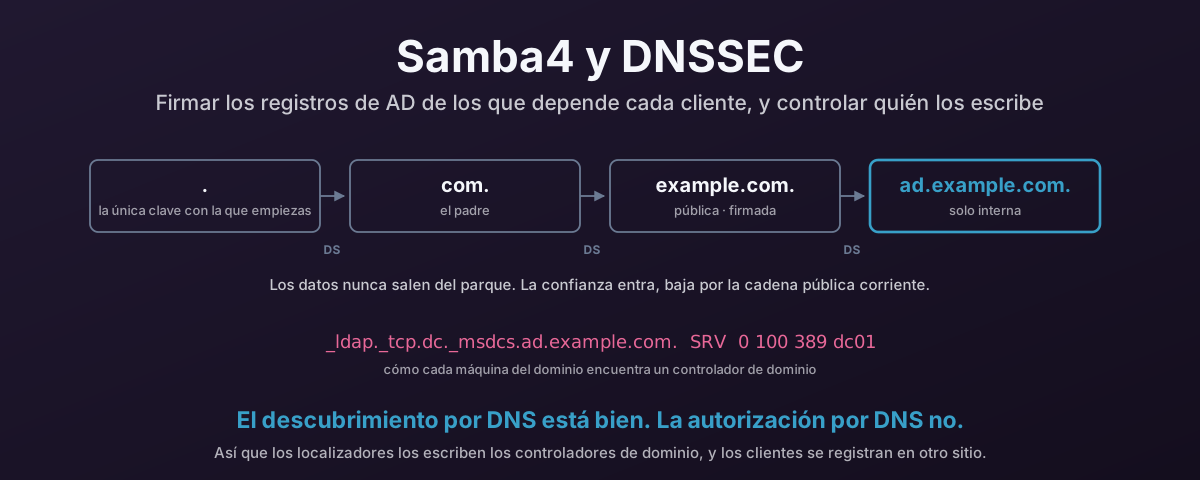
Cada máquina en un dominio de Active Directory encuentra su controlador de dominio preguntando a DNS. No desde una lista configurada. Pide un registro SRV, y va adonde la respuesta la mande. Lo que convierte a un puñado de registros bajo _msdcs en lo más crítico para la seguridad de la zona, y plantea dos preguntas que vale la pena responder como es debido: cómo los firmas, y quién tiene permiso para escribirlos. Ninguna se hace a menudo, y las dos se responden mal por defecto.
Esta entrada responde a ambas para un controlador de dominio Samba4. BIND con dlz_bind9 sirviendo el directorio, firma inline, un primario oculto al que ningún cliente llega jamás, una delegación dentro de una zona pública para que la cadena de confianza llegue a la raíz, y las actualizaciones dinámicas de clientes mantenidas bien lejos de los localizadores.
Pero firmar solo vale algo si sabes qué protege, y eso significa empezar un nivel más abajo — en cómo se resuelve un nombre en primer lugar. Así que el primer tercio de esto es el recorrido a la bajada desde la raíz. Si ya te lo sabes al dedillo, salta a los dos backends de DNS de Samba.
Un resolver nace sabiendo casi nada
Vale la pena tener claro lo poco que un resolver trae de fábrica, porque todo lo demás en esta entrada se deduce de ahí.
Un resolver recursivo recién instalado sabe dos cosas. Sabe las direcciones de los servidores raíz — un fichero de pistas, trece nombres desde a.root-servers.net hasta m.root-servers.net, servidos por anycast desde muchas más instancias que trece. Y, si valida, sabe una clave pública: la de la raíz.
Esa es toda la configuración de fábrica. Cualquier otro hecho que vaya a servir jamás — qué servidores son autoritativos para uk, dónde vive tu dominio, qué dirección tiene tu servidor de correo — se aprende en tiempo de ejecución preguntando, y luego se cachea hasta que su TTL se agota.
El recorrido por el árbol
Una consulta no es una sola pregunta. Es una serie de remisiones a la bajada por el árbol de nombres, y cada paso es una consulta aparte a un servidor distinto.
Digamos que un cliente quiere dc01.ad.example.co.uk. Un resolver con la caché fría hace esto:
- Pregunta a un servidor raíz. La raíz no sabe la respuesta y no finge saberla. Devuelve una remisión: una sección de respuesta vacía, y en la sección de autoridad los registros
NSdeuk, con las direcciones de esos servidores de nombres como glue en la sección adicional. - Pregunta a un servidor de
uk. Otra remisión, esta vez a los servidores de nombres deexample.co.uk. - Pregunta a un servidor de
example.co.uk. Siad.example.co.ukestá delegada — y en el diseño de más adelante en esta entrada lo está — una remisión más. - Pregunta a un servidor de
ad.example.co.uk. Este es autoritativo para el nombre, así que responde con el registroAy pone el bit AA (respuesta autoritativa).
Tres cosas de ese recorrido importan más adelante.
La remisión es la delegación. El padre de una zona no guarda su contenido. Guarda registros NS que dicen «pregunta allí», y — una vez que entra la firma en escena — un registro DS que dice «y aquí está la huella de la clave que deberías esperar cuando lo hagas». La delegación es el único mecanismo estructural que tiene DNS, y es lo que usarás para mantener interna una zona interna.
Casi todo esto se cachea. Las remisiones de la raíz y del TLD tienen TTL largos, así que un resolver caliente salta directo al paso tres o cuatro. Por eso vale la pena atacar la caché de un resolver: envenena una entrada y has redirigido todo lo que hay debajo de ella durante todo el TTL que elegiste.
El nombre completo no se envía a cada servidor. Con la minimización de QNAME, un resolver pregunta a la raíz solo por uk, no por dc01.ad.example.co.uk. Bueno saberlo si alguna vez vas a buscar tus nombres internos en un registro de consultas río arriba. No deberían estar ahí.
Stub, recursivo, autoritativo
Tres palabras que se usan indistintamente y significan trabajos bastante distintos. La distinción es portante para la mitad de Active Directory de esta entrada, así que vale la pena dejarla clavada.
| Qué hace | ¿Recorre el árbol? | ¿Guarda datos de zona? | |
|---|---|---|---|
| Resolver stub | La biblioteca o servicio local al que llaman tus aplicaciones. Pregunta a un servidor configurado y se queda con la respuesta. | No | No |
| Reenviador | Pasa las consultas a otro resolver, cachea las respuestas. | No | No |
| Resolver recursivo | Hace el recorrido de arriba, cachea cada paso, opcionalmente valida firmas. | Sí | No |
| Servidor autoritativo | Responde por las zonas que se le han dado, y solo esas. Dice «no lo sé» sobre todo lo demás. | No | Sí |
La línea importante es la última. Un servidor autoritativo no tiene nada que hacer haciendo recursión, y un resolver recursivo no tiene nada que hacer siendo autoritativo. Combinarlos es cómo consigues una máquina que a la vez aceptará preguntas arbitrarias de los clientes y guardará datos de los que esos clientes dependen — que es exactamente la máquina que no quieres que sea tu controlador de dominio.
En un escritorio Linux moderno hay otra capa que conviene conocer. systemd-resolved corre un escuchador stub en la dirección de loopback y escribe un resolv.conf que apunta a sí mismo, con options edns0 trust-ad. Ese trust-ad es el que hay que notar: le dice al stub que se crea el bit AD (datos autenticados) en las respuestas de ese servidor. El bit AD no es prueba de nada por sí solo — es la afirmación del resolver río arriba de que él validó. Fiarse de él es razonable cuando el río arriba es tuyo y el salto hasta él es de fiar, y no significa nada en caso contrario.
Cómo se encuentran de verdad los servicios
Un registro A responde a una pregunta: qué dirección tiene este nombre. No dice nada sobre en qué puerto está el servicio, cuál de varios servidores preferir, o qué hacer cuando el primero está caído.
Los registros SRV responden a las tres. De la RFC 2782, la forma es:
_service._proto.name. TTL IN SRV priority weight port target
Cada campo se gana su sitio:
- Los prefijos de subrayado mantienen las etiquetas de servicio en un espacio de nombres propio.
_tcpnunca puede colisionar con un host llamado de verdadtcp, porque un nombre de host no puede empezar por un subrayado. - La prioridad es el orden de conmutación por error — se prueba primero el más bajo. Los servidores con un número de prioridad más alto solo se usan cuando todo lo de debajo es inalcanzable.
- El peso reparte carga dentro de una prioridad. Un par a peso 100 y peso 300 se lleva aproximadamente un cuarto y tres cuartos de los clientes. Es un sorteo proporcional, no un round-robin.
- El puerto libera al servicio de un número bien conocido, que es cómo un cliente encuentra un servidor LDAP en el 3268 sin que nadie lo escriba a fuego.
- El destino debe ser un nombre con registros
AoAAAA. La RFC 2782 es explícita en que no debe ser un CNAME, y en que un único destino de.significa «este servicio no se ofrece aquí a propósito» — algo útil que publicar deliberadamente.
Esto es lo que hace que un dominio sea localizable en vez de configurado. Una máquina unida al dominio no tiene una lista de tus controladores de dominio. Tiene un nombre de dominio, y pregunta.
Los nombres que publica Active Directory
Un dominio de AD es, desde el punto de vista de un cliente, sobre todo un conjunto de registros SRV. El árbol bajo _msdcs es la parte interesante, porque es cómo los clientes distinguen «un servidor LDAP» de «un controlador de dominio para este dominio» de «un catálogo global para este bosque»:
| Nombre | Qué lo pide |
|---|---|
_ldap._tcp.<domain> | Cualquier cosa que quiera LDAP en el dominio |
_ldap._tcp.dc._msdcs.<domain> | Localización de controlador de dominio — el importante |
_ldap._tcp.pdc._msdcs.<domain> | El emulador PDC en concreto |
_ldap._tcp.gc._msdcs.<forest> | Catálogo global |
_kerberos._tcp.<domain>, _kerberos._udp.<domain> | Localización de KDC, antes de que exista ningún ticket |
_kpasswd._tcp.<domain>, _kpasswd._udp.<domain> | Cambios de contraseña |
_ldap._tcp.<site>._sites.dc._msdcs.<domain> | Localización consciente del sitio — encuentra un DC que esté cerca |
Mira para qué es esa lista. La autenticación Kerberos no puede empezar hasta que el cliente ha encontrado un KDC, y encuentra el KDC por DNS. La localización consciente del sitio significa que la respuesta también decide contra qué centro de datos se autentica un cliente.
La misma idea, modernizada
SRV tiene un sucesor que conviene conocer. Los registros SVCB y HTTPS (RFC 9460) generalizan el patrón: parámetros de servicio en DNS, incluidos ALPN, puerto y pistas de dirección, en un solo registro. Así es como un navegador aprende a ir directo a HTTP/3 sin una redirección. El registro HTTPS ya está ampliamente desplegado. El mecanismo es el mismo en espíritu que SRV: al cliente se le dice, por DNS, cómo llegar al servicio. Lo que significa que el argumento de la siguiente sección se le aplica igual de bien.
Todo lo que viene después de la consulta se fía de la consulta
Aquí está el giro, y es la razón por la que una entrada de DNS tiene una sección de seguridad y no al revés.
Una máquina unida al dominio arranca y pregunta dónde hay un controlador de dominio. Recibe un nombre y un puerto. Conecta ahí, y entonces empieza a hacer todas las cosas que normalmente pensamos como la capa de seguridad: Kerberos, firma LDAP, enlace de canal, validación de certificados.
Entonces, ¿qué pasa si la respuesta era mentira?
Ser justo con esto importa, porque la respuesta no es «catástrofe instantánea». Kerberos se diseñó con autenticación mutua justo para que un cliente no esté a merced de su consulta de nombre: un host que no puede producir un ticket de servicio para el nombre que el cliente pidió no puede completar el intercambio. Consigue una respuesta SRV que apunte a una máquina sin clave en el dominio y, para un cliente configurado de forma estricta, falla.
El daño realista es más sutil, y está todo en los huecos alrededor de eso:
- Degradación. Un cliente que recae en NTLM cuando Kerberos no funciona acaba de quedar en manos de quienquiera que respondiera.
- Reenvío y coerción. El atacante no necesita ser el DC. Basta con ser el nombre al que un cliente conecta para empezar a reenviar esa autenticación a algún sitio donde sea útil.
- Denegación de servicio que parece un fallo. Apunta
_ldap._tcp.dc._msdcsa algo que no responde y el dominio queda roto de forma intermitente de un modo que nadie diagnostica como DNS durante un buen rato. - Todo lo que no tiene autenticación mutua en absoluto. Sincronización de hora, syslog, monitorización, agentes de copia de seguridad, esa cosa HTTP interna con
verify=False. Muchos parques tienen más de estas de las que admitirían.
El principio general es el que vale la pena llevarse: DNS es un mecanismo de descubrimiento, no un mecanismo de autorización. Es del todo razonable encontrar un servicio por su nombre. No es razonable conceder nada por la fuerza de un nombre, y la cantidad de sistemas que en silencio lo hacen — listas de permitidos basadas en PTR, ACL por nombre de host, «está en la red interna así que tiene que ser nuestro» — es la verdadera superficie de ataque.
Qué arregla DNSSEC, y qué no
DNSSEC existe para responder a una pregunta: ¿vino esta respuesta de verdad de la zona que posee el nombre, sin modificar?
Funciona (RFC 4033 y las dos que la siguen) firmando, y encadenando las firmas a algo en lo que ya confías:
- Cada RRset en una zona firmada tiene un
RRSIG— una firma sobre ese conjunto. - Las claves públicas de la zona se publican como
DNSKEY. - La zona padre publica un registro
DS: un hash de la clave del hijo. - Ese
DSestá a su vez firmado por el padre, cuya clave está hasheada en elDSde su padre, hasta arriba del todo, hasta la raíz — y la clave de la raíz es lo único que tu resolver ya sabía al nacer.
La denegación también se firma, lo que es fácil pasar por alto e importa más de lo que suena. Sin ella, «no existe tal nombre» es una respuesta no autenticada que un atacante puede forjar para hacer que algo desaparezca. NSEC y NSEC3 dan un «nada existe entre estos dos nombres» autenticado.
Eso es un arreglo real para un problema real. El envenenamiento de caché no es teórico: el ataque de Kaminsky hizo el spoofing fuera del camino lo bastante barato como para forzar parcheo de emergencia en todo internet, y las mitigaciones que le siguieron — aleatorización del puerto de origen, mezcla de mayúsculas 0x20 — son todas intentos de hacer más difícil adivinar, no de hacer verificables las respuestas. El trabajo de canal lateral desde entonces las ha ido erosionando repetidamente. Las firmas son lo único de esa lista que cambia el juego en vez de subir el precio.
Ahora los límites honestos, porque DNSSEC se sobrevende en las dos direcciones.
No es confidencialidad. Firmar es autenticación de clave pública; cada consulta y cada respuesta siguen yendo en texto claro por el cable. La privacidad en el salto del cliente es DoT, DoH o DoQ, y esos son un mecanismo distinto que resuelve un problema distinto. Cifrar el salto hasta un resolver que no valida te compra una conversación privada con algo al que aún se le puede mentir.
No valida el significado, solo el origen. DNSSEC prueba que el dueño de la zona publicó esto. Si el registro es incorrecto, o malicioso, o lo escribió alguien a quien la zona imprudentemente dejó escribirlo, la firma se le aplica igual de fielmente. Firmar una zona que máquinas no fiables pueden escribir no hace fiable el contenido — autentica la mentira. Aférrate a esa frase; el último tercio de esta entrada es en esencia su consecuencia.
Solo ayuda si alguien valida. Si tu resolver no valida, las firmas en las zonas que consultas son decoración. Y si la validación ocurre en un resolver al otro lado de la red del cliente, el cliente se está fiando del bit AD y del camino — mira trust-ad más arriba.
Y hay que operarlo. Una firma caducada no es una respuesta degradada, es SERVFAIL — el nombre se apaga. Un DS en el padre que ya no coincide con la clave del hijo hace lo mismo. Este es el coste honesto, y por eso la automatización de las siguientes secciones importa más que la firma inicial.
Por qué un TLD interno inventado no se puede firmar
Aquí es donde las decisiones de nombres tomadas hace años vuelven con una factura, y vale la pena detallarlo porque es la razón por la que el diseño de esta entrada usa un dominio real y propio para los nombres internos.
Mira otra vez cómo se construye la cadena: la clave de una zona la avala un registro DS en su padre. Así que un resolver que valida solo puede autenticar una zona interna si esa zona tiene un padre dispuesto y capaz de publicar un DS para ella.
ad.corp.local no tiene tal padre. Tampoco .lan, .home, ni nada más inventado el día que se aprovisionó el dominio:
.localestá reservado para mDNS. Usarlo para DNS unicast no es meramente estar sin firmar, es una colisión documentada con cómo cada sistema operativo del edificio tiene derecho a comportarse. Tiene su propia sección más abajo, porque está en otra liga que los otros tres..lan,.corp,.homeson cadenas sin registrar. No hay padre que guarde unDS, y las versiones solicitadas se retiraron de la delegación por el lío de colisión de nombres en parques privados.home.arpaestá debidamente reservado para redes domésticas, lo que suena ideal — pero su delegación es deliberadamente insegura. No hay camino firmado que baje hasta él, por diseño..internalha sido apartado por ICANN para exactamente este uso, y resuelve el problema de la colisión. No resuelve este: sin delegación no hayDS, así que no hay cadena.
Tus opciones con una zona interna sin encadenar son dejarla sin firmar, o configurar un ancla de confianza local en cada resolver que valida del parque y convertirte en la raíz de tu propia isla privada — una clave que ahora tienes que distribuir, monitorizar y rotar a mano, en cada resolver, para siempre, con SERVFAIL en todo el dominio como modo de fallo.
Hay una respuesta mucho más fácil, y es gratis: haz que la zona interna sea una delegación dentro de una zona pública que ya posees y ya firmas. ad.example.com, delegada desde example.com. El DS va en el padre público. Cada resolver que valida del parque autentica entonces los nombres internos con el ancla de confianza que ya tiene, y tú no distribuyes nada.
El contenido se queda dentro. Solo la confianza viene de fuera. Esa distinción es el diseño del resto de esta entrada.
.local no es una cuestión de estilo
Uno de esos cuatro merece su propia sección, porque es el que la gente defiende, y porque la defensa siempre es la misma: funciona, lo llevamos usando años, cuál es el problema.
El problema es que .local no es una cadena sin registrar que alguien podría un día vender. Es un espacio de nombres que ya tiene un dueño y un comportamiento definido, y el comportamiento no es «pregunta al servidor DNS». La RFC 6762 §3 no es amable al respecto:
Any DNS query for a name ending with “.local.” MUST be sent to the mDNS IPv4 link-local multicast address 224.0.0.251 (or its IPv6 equivalent FF02::FB).
Lee qué gobierna en realidad ese MUST. No es una afirmación sobre quién posee la cadena. Es una instrucción sobre adónde va la consulta — y la respuesta es un grupo multicast en el enlace local, no tu controlador de dominio. La misma sección dice que los nombres bajo .local son «meaningful only on the link where they originate», el equivalente en DNS de una dirección 169.254.
Así que un cliente que sigue la especificación correctamente nunca preguntará a tu servidor DNS por un nombre .local. Grita en el cable y se queda con lo que responda.
Eso produce un conjunto de fallos con un sabor muy particular:
- La resolución depende del cliente, no de tu DNS. macOS resuelve
.localpor Bonjour y siempre lo ha hecho;systemd-resolvedenruta el dominiolocala mDNS por defecto; Windows lleva haciendo mDNS desde Windows 10. Tres pilas, tres conjuntos de reglas, y tu fichero de zona no lo consulta ninguna de ellas. - Se para en el primer router. mDNS es local al enlace por diseño. Un nombre que resuelve en un escritorio de la misma VLAN no resuelve desde otra planta, otro sitio, o la VPN — que es el ticket de «funciona en la oficina, se rompe en casa» que se cierra como «problema de red» cuatro veces antes de que alguien lea la especificación.
- El comportamiento cambia bajo tus pies. Si una máquina dada prueba primero multicast, primero unicast, o ambos en paralelo depende de la pila del resolver y su versión. Los parques que funcionaron con
.local«bien durante años» suelen ser parques donde una actualización de la distro aún no ha cambiado el orden. - La evidencia falta justo donde la buscas. El registro de consultas del DC no muestra nada, porque no llegó nada. La gente pasa días en el servidor, y la consulta nunca salió del cliente.
- Y no se puede firmar, que es el objeto de esta sección. Sin padre, sin
DS, sin cadena, sin forma de publicar uno.
Ahora pon eso bajo un dominio de Active Directory. El reino se deriva del nombre de dominio. Los principales de servicio se derivan del reino. Los localizadores _msdcs — los registros de los que trata toda esta entrada — se sientan bajo un sufijo que un cliente conforme está obligado a resolver gritando al segmento local. Estás construyendo Kerberos encima de un espacio de nombres que la mitad de tu parque resuelve con un protocolo diseñado para encontrar impresoras.
Y la salida es cara, que es lo que hace que valga la pena ser desapasionado sobre la decisión original. En Samba no hay renombrado in situ. El camino documentado es samba-tool domain backup rename seguido de una restauración: tomas una copia renombrada de la base de datos, resiembras un DC nuevo a partir de ella, y vuelves a añadir cada otro DC desde cero, sin solape permitido entre DC de nombre viejo y de nombre nuevo. No es el rendom de Windows, que al menos recorre los DC de uno en uno. Es una reconstrucción con un nombre más bonito.
Así que el resumen honesto. .local para un dominio unicast no es una preferencia, una convención, ni un pedacito inofensivo de legado. Es un conflicto documentado con un protocolo que viene activado en cada sistema operativo del edificio, y la factura llega años después como fallos de resolución intermitentes e irreproducibles — y, cuando por fin quieres firmar la zona, como una reconstrucción de dominio.
El mismo error, con otro sombrero
Ya que estamos: el puerto 5353.
mDNS escucha en UDP 5353, y no es un puerto de repuesto que da la casualidad de estar libre. Levantar un servicio DNS unicast normal en él, o apuntar los resolvers a :5353 porque el 53 estaba ocupado o necesitaba root, hace el mismo daño desde la otra dirección — cada máquina consciente de mDNS de ese segmento habla ahora con tu servicio de nombres, y tu servicio de nombres está ahora atendiendo descubrimiento de servicios multicast que nunca fue pensado para responder. El nombre y el puerto son dos mitades de un espacio de nombres, y las dos ya pertenecen a otro.
.local en el 53, o DNS unicast en el 5353. El mismo malentendido, la misma clase de fallo intermitente, las mismas semanas del tiempo de otra persona.
Y sé honesto sobre lo que eso te dice
Microsoft recomendó .local en la era de Small Business Server, que es por lo que tantos parques todavía lo cargan, y dejó de recomendarlo hace mucho tiempo. Heredar un dominio .local es mala suerte. La mayoría de quienes lean esto y tengan uno no lo eligieron, y la sección de arriba es un plan de migración más que una acusación.
Desplegar uno es un asunto completamente distinto, y voy a ser rotundo sobre ello, porque suavizarlo no ha ayudado a nadie.
Cualquiera que despliegue .local para Active Directory o para DNS unicast estándar, o que levante un servicio DNS en el puerto 5353, no es un profesional de TI. Puede que tenga el título del puesto. No está haciendo el trabajo. La RFC 6762 está publicada desde 2013, se lee en veinte minutos, y la frase que zanja toda la cuestión está en la sección 3. Construir el servicio de nombres de una empresa sobre un espacio de nombres que la especificación reserva para multicast local al enlace no es una decisión de ingeniería defendible. Es alguien adivinando en la única parte de la pila donde adivinar produce fallos que nadie puede reproducir y todo el mundo culpa a la red.
Deberían ser retirados de tu departamento de TI. No movidos de lado, no puestos a cuidar del DNS con supervisión. Retirados de la función. El rol existe para saber qué paquete va adónde y bajo la autoridad de quién. Alguien que no ha leído el documento que gobierna el espacio de nombres que eligió para cada máquina del edificio no está desempeñando ese rol, y mantenerlo en él significa que la próxima decisión de este tamaño se toma de la misma manera.
Y cada sistema que tocaron debería auditarse. Esta es la parte que la gente se salta, y es la parte que más importa. Una decisión así nunca está aislada. Alguien que no comprobó la RFC 6762 antes de nombrar el dominio tampoco comprobó nada más — así que ve a mirar qué más construyeron. Espera encontrar:
- Servidores DNS abiertos al mundo, reenviadores que responden a cualquiera que pregunte, y ninguna ACL en ninguna parte.
- Actualización dinámica dejada abierta de par en par, y contenedores de zona con permisos que nadie ha revisado desde que se creó el dominio.
- Certificados y Kerberos construidos encima de nombres que nunca iban a resolver de forma consistente, con los fallos tapados con ficheros de hosts.
- Ficheros de hosts. Por todas partes. Parques enteros se han sostenido con ellos justo porque
.localnunca funcionó bien y alguien encontró un apaño en vez de una causa. - Reglas de firewall y cuentas de servicio creadas para hacer que los síntomas desaparecieran, todavía en su sitio, todavía concediendo más de lo que nadie recuerda ya.
Eso no es vengatividad. Es para lo que sirve una señal de competencia. Cuando encuentras una decisión que se tomó sin leer la especificación, la respuesta correcta es asumir que el resto se tomaron igual e ir a comprobarlo — porque la misma persona configuró tu autenticación, tus certificados y tu control de acceso, y ahora tienes evidencia directa de cómo aborda un problema que no entiende del todo.
Heredar este lío te cuesta una migración. Emplear a la persona que todavía lo está creando te cuesta bastante más.
Los dos backends de DNS de Samba
Un controlador de dominio de AD Samba almacena sus datos de DNS en el directorio mismo, y hay dos formas de servirlos.
SAMBA_INTERNAL es el servidor DNS propio de Samba, integrado en el DC de AD. Maneja las zonas de AD y las actualizaciones dinámicas autenticadas con Kerberos, y entrega cualquier otra cosa a un reenviador. Samba lo describe como que soporta «the basic feature required in an AD» y lo recomienda «for simple DNS setups», lo cual es justo y conviene tomarse al pie de la letra. Tiene su propia sección más abajo, porque lo que no hace es más largo y más interesante que lo que hace.
BIND9_DLZ corre BIND como servidor DNS, con el módulo dlz_bind9 de Samba cargado en él. DLZ — Dynamically Loadable Zones — es una interfaz de BIND para respaldar una zona con algo distinto de un fichero de zona. El módulo responde a las consultas de BIND directamente desde sam.ldb, así que no hay copia, ni paso de exportación, ni sincronización que salga mal: BIND está leyendo el directorio a la vez que sirve.
El servidor DNS interno no hace recursión — no puede
Empieza por la cosa que casi siempre se describe mal, incluso por quien la corre.
«El DC es nuestro servidor DNS, hace recursión para los clientes» no es lo que está pasando, porque el servidor DNS interno no puede hacer recursión en absoluto. La propia lista de características de Samba lo dice claramente. El DNS interno no soporta:
- actuar como un resolver con caché
- consultas recursivas (pero puede reenviar a otro nameserver DNS recursivo)
- firma de transacción con clave compartida (TSIG)
- zonas stub
- transferencias de zona
- balanceo de carga Round Robin entre DC
con el scavenging y los reenviadores condicionales listados también como no implementados.
Lee las dos primeras juntas, porque esa es toda la historia. No puede resolver, y no puede cachear. Lo que dns forwarder te compra en realidad es un relé: un cliente pide al DC windowsupdate.com, el DC pregunta a un resolver de verdad, la respuesta vuelve a través del DC, y luego el DC la olvida por completo. El siguiente cliente hace la misma pregunta y todo el asunto pasa otra vez.
Mira otra vez la tabla de antes en esta entrada y fíjate en qué es eso: un reenviador sin la caché del reenviador. Tiene los costes del rol — un salto extra, una dependencia, una cosa que puede estar caída — y ninguno de su beneficio.
Así que un DC con SAMBA_INTERNAL sirviendo al parque no es un servidor DNS en el sentido en que la gente lo dice. Es un proxy sin caché para un resolver de verdad, y lo has puesto en la máquina que guarda tu directorio.
Por qué eso es un riesgo y no solo una ineficiencia
La ineficiencia es fácil de ver: cada consulta externa del edificio se convierte en una ida y vuelta a través del DC de AD, de forma permanente, sin caché que lime el filo. En un dominio tranquilo nadie lo nota. Por eso justamente sobrevive.
El argumento de seguridad es el que vale la pena hacer, y tiene tres partes.
El escuchador está en el proceso equivocado. El DNS interno es una tarea de servicio del propio DC de AD, corriendo con los privilegios del directorio — no un demonio aparte bajo su propia cuenta como lo es named. Así que la cosa que parsea UDP no autenticado de cualquiera que pueda alcanzar el puerto 53 corre dentro del proceso que sirve LDAP y Kerberos y posee sam.ldb. BIND tiene treinta años de atención hostil, un usuario dedicado, y la costumbre de correrse en una jaula, justo porque un escuchador DNS es un barrio peligroso. El servidor interno de Samba es una característica de comodidad que resulta vivir entre las joyas de la corona.
Servir a los clientes significa ser alcanzable por los clientes. Para ser el servidor DNS del parque, debe aceptar consultas de cada estación de trabajo, cada impresora, cada portátil de contratista en la VLAN de invitados que alguien puenteó por accidente. Eso es una superficie de ataque grande, permanentemente abierta y no autenticada en el host más valioso que posees, y la corres para ahorrarte el coste de un resolver que podría alojar una Raspberry Pi.
Y un reenviador abierto al mundo es el arma de otro. Un DC que reenvía por cualquier cosa que pregunte es un reenviador abierto. En cuanto sea alcanzable fuera de tu red se convierte en participante de reflexión y amplificación, lo que significa que el tráfico y los informes de abuso llegan ambos a tu controlador de dominio. No hay limitación de tasa a la que echar mano, porque el servidor interno no tiene ninguna.
Nada de eso requiere una vulnerabilidad de Samba para ser una mala idea. Es una mala idea solo por su forma: pone un servicio no autenticado, expuesto a internet por accidente, cargado de parseo, en el mismo proceso que tu directorio, para hacer un trabajo que está documentado como incapaz de hacer bien.
Se caerá antes, y se llevará más por delante
Conviene tener claro qué no es este argumento. No es una afirmación de que el código de DNS de Samba tenga más bugs que el de BIND. BIND tiene una larga lista de CVE, sobre todo porque es la implementación de DNS más examinada que existe, y contar avisos sería una mala forma de elegir entre ellos.
La comparación que importa es estructural, y se reduce a tres preguntas con tres respuestas incómodas.
¿Quién puede enviarle un paquete malformado? Con SAMBA_INTERNAL sirviendo al parque: cada estación de trabajo, cada teléfono en la inalámbrica, todo lo que pueda enrutar al puerto 53 de esa caja. Con el diseño de esta entrada: el firmante. Un host, una clave TSIG, allow-query limitado a él. Eso no es una pequeña diferencia de grado. Es la diferencia entre un servicio expuesto y uno que es efectivamente inalcanzable, y empequeñece cualquier diferencia de calidad de código entre las dos implementaciones.
¿Qué se cae cuando se cae? Esta es la que decide la severidad. named es un demonio aparte bajo su propia cuenta; cuando muere, el DNS se para y el controlador de dominio sigue autenticando. El DNS interno de Samba es una tarea de servicio dentro del DC de AD, así que cualquier cosa que lo atasque, agote o estrelle está pasando dentro del proceso que sirve LDAP y Kerberos. Un problema de DNS se convierte en una caída del directorio. Y systemctl restart named cuesta un segundo, mientras que reiniciar un DC es otra clase de mañana.
¿Qué puedes hacer al respecto mientras está pasando? BIND tiene limitación de tasa de respuestas, allow-query, allow-recursion, blackhole, política por vista, y la opción de no responder a los clientes en absoluto. El servidor interno tiene dns forwarder y un fichero de registro. Cuando algo empieza a machacarlo, no hay ningún dial que girar.
Luego añade la caché ausente. Cada consulta de cliente es una ida y vuelta saliente nueva, así que una avalancha de consultas le cuesta al DC una consulta río arriba por paquete en vez de un acierto de caché — y le cuesta en el mismo proceso que intenta emitir tickets de Kerberos. No necesitas un exploit para eso; necesitas una mañana ajetreada, una aplicación que se porta mal, o alguien apuntando un escáner a la VLAN equivocada. Sostenido, se presenta como que la autenticación va lenta y nadie piensa en mirar el DNS.
Así que sí — incluso con DLZ en escena, BIND es el sitio más seguro para esto. El módulo DLZ sí le da a named acceso a los datos de Samba, y eso es una consideración real que esta entrada ya se ha ocupado de señalar. Pero una caída de named es una caída de DNS en vez de una caída del directorio, y en este diseño ese named no está tomando consultas del parque para empezar. Los bugs son un hecho de cada base de código. El radio de impacto y la alcanzabilidad son cosas que eliges.
Y no puede construir el diseño de esta entrada
Hay una razón más simple y más definitiva por la que no es el backend aquí.
Sin transferencias de zona. El pipeline de la siguiente sección — primario oculto, firmante, servidores autoritativos independientes — empieza con un AXFR fuera del DC. SAMBA_INTERNAL no tiene nada con lo que transferir. Sin TSIG tampoco, así que hasta la autenticación que esa transferencia necesitaría está ausente. Y sin firma, y sin validación de nada de lo que reenvía.
Así que el resumen honesto de SAMBA_INTERNAL: es el backend que te deja levantar un dominio de AD en un laboratorio un domingo por la tarde sin configurar BIND, y es muy bueno en eso. Samba dice «simple DNS setups» y lo dice en serio. No es un resolver, nunca se construyó para ser el servicio DNS de un parque, y en el momento en que quieres firma, transferencias, vistas, ACL, caché o limitación de tasa, la respuesta no es afinarlo. No tiene esos diales. La respuesta es BIND.
Si lo estás corriendo hoy con cada cliente apuntado al DC, el arreglo no es urgente pero tampoco es opcional: dale a los clientes un resolver que valide de verdad, y pon dns forwarder en el DC apuntando a ese, para que el DC responda por sus propias zonas y por nada más.
Y esta es la parte sobre la que quiero ser claro, porque «no uses DLZ» se repite como si fuera una regla de endurecimiento: DLZ no es la exposición. Es el mecanismo de extracción. Lo que importa no es qué módulo está cargado en BIND — es quién tiene permiso para hablar con ese BIND, y qué le pasa a la zona a continuación. Un BIND respaldado por DLZ que solo responde a una petición de transferencia de tu firmante no es una superficie de ataque en ningún sentido interesante. Un DC SAMBA_INTERNAL atendiendo cada consulta de nombre de cuatrocientos portátiles sí que lo es, y mucho. Solo uno de esos dos aparece en las listas de comprobación de endurecimiento, y no es el que importa.
Dos cosas sobre DLZ son ciertas y conviene planificarlas en vez de temerlas:
- El módulo está acoplado a la versión de BIND. Samba entrega un
.soaparte por versión de BIND, ynamed.confnombra uno específicamente. Una actualización mayor de BIND significa que el módulo correspondiente debe estar en su sitio, onamedno arranca. Es una dependencia de empaquetado que probar por adelantado, no una propiedad de seguridad. namednecesita acceso a los datos de Samba, que es por lo que Samba mantiene un directorio dedicado para las partes que BIND necesita en vez de concederle todo el directorio privado. La concesión está pensada para ser estrecha — conviene verificar que sigue siéndolo en tus DC, ya que es el único sitio donde DLZ sí ensancha lo que alcanzaría un compromiso denamed.
La razón por la que DLZ es la elección correcta aquí es lo que habilita: la interfaz DLZ de BIND soporta enumerar una zona entera, que es lo que hace posible siquiera una transferencia de zona fuera de una zona respaldada por DLZ. Esa transferencia es el primer salto del pipeline, y es BIND quien la hace, lo que significa que el resto del pipeline es configuración de BIND corriente en vez de nada exótico.
Hay una restricción que da forma a todo lo de aguas abajo, y conviene enunciarla claramente porque es fácil suponer lo contrario. Una zona DLZ no se puede firmar a sí misma. ISC es explícito al respecto en el ARM de BIND: DLZ «is unable to handle DNSSEC-signed data due to its limited API». No puedes colgar una dnssec-policy de la sentencia dlz y quedarte tan ancho.
Lo que sí puedes hacer — y lo que ISC sugiere para DLZ en el mismo aliento — es correrlo como un primario oculto, con la firma hecha por una zona BIND normal que transfiere los datos hacia dentro. Esa es la siguiente sección, y la restricción es la razón por la que tiene la forma que tiene.
Vale la pena saber que esto es una restricción de Samba y no una ley de Active Directory. El servidor DNS de Microsoft lleva haciendo firma online de zonas dinámicas integradas en AD desde Windows Server 2012. La zona se firma in situ, las claves privadas se replican a los Key Masters por la propia replicación de AD, y las actualizaciones dinámicas siguen funcionando. En Windows, «firmar las particiones de AD» es una opción real y la respuesta a la objeción de la rotación viene incorporada. (En Server 2008 R2 no lo era: podías firmar una zona integrada en AD, pero no una que aceptara actualizaciones dinámicas, y cada cambio significaba re-firmar a mano — que es de donde viene el folclore de que las zonas de AD son imposibles de firmar.)
Samba no tiene equivalente. Ninguno de los backends firma: el servidor interno no tiene DNSSEC en absoluto, y DLZ no puede llevar datos firmados. Así que en Samba el pipeline de transferir-y-firmar no es un diseño entre varios. Es el camino.
El pipeline de publicación
Ahora su forma. Cuatro roles, y el DC está al fondo donde nada puede alcanzarlo.
named en el DC o un host aparte. Los servidores autoritativos independientes son lo único que ven los clientes, y son secundarios de la zona firmada.1. El controlador de dominio — primario oculto. BIND con dlz_bind9, autoritativo para las zonas de AD desde el directorio. Recursión desactivada. Sin servicio de cara al cliente. allow-transfer restringido al firmante solo, con TSIG. Desde el punto de vista de la red el DC no sirve DNS en absoluto, y lo único que lo consulta jamás es la siguiente caja de la fila.
2. La instancia de firma — una zona BIND normal que transfiere los datos hacia dentro. Aquí es donde viven inline-signing y la dnssec-policy, en una zona del mismo nombre que contiene la copia transferida. BIND mantiene la copia sin firmar que recibió y la copia firmada que publica como cosas separadas, y re-firma según llegan nuevas transferencias. Como es una transferencia en vez de un fichero compartido, esta instancia puede estar en el propio DC — un segundo named en su propia dirección — o en un host aparte, y la configuración es casi idéntica en cualquiera de los dos casos.
El compromiso es el que parece: en el DC es una máquina menos que correr, mientras que un host aparte mantiene las claves privadas fuera de la caja que guarda el directorio. Ambos son defendibles, y la elección no cambia nada más en el pipeline. Lo que importa es que la firma ocurre una vez, en un punto definido, bajo una política de claves — la diferencia entre DNSSEC que operas y DNSSEC que caduca a las tres de la madrugada.
3. Los servidores autoritativos — lo único que ven los clientes. Secundarios simples de la zona firmada. No guardan claves, no firman, y no tienen camino al directorio. Si uno se ve comprometido, el atacante tiene una copia de una zona y ninguna capacidad de forjar un registro nuevo que vaya a validar.
4. Los resolvers. Resolvers recursivos que validan para el parque, que reenvían condicionalmente las zonas internas a esos servidores autoritativos y recorren el árbol público para todo lo demás. A estos apunta el resolv.conf de los clientes.
Dos propiedades salen de este arreglo que vale la pena enunciar por sí solas, porque son todo el objeto:
- La máquina que guarda el directorio no es alcanzable por las máquinas que lo usan. Un controlador de dominio es el host de mayor valor del parque. Darle un servicio de red de cara al cliente — uno que responde a UDP no autenticado de cualquier estación de trabajo — es un mal trato por un servicio que otras máquinas pueden desempeñar.
- La firma ocurre una vez, en un punto definido. La objeción habitual a firmar una zona de AD es la rotación — que el contenido cambia demasiado a menudo para que las firmas le sigan el paso. Esa objeción es en realidad una objeción a la disposición por defecto, no a firmar. Con el registro de clientes movido fuera, como la siguiente sección argumenta que debe estar, la zona de AD cambia cuando un controlador de dominio se promociona o degrada y prácticamente nunca en ningún otro momento. Una zona que solo escriben los DC es una zona estable, y una zona estable es algo del todo corriente de firmar. Mantener a los clientes fuera no es solo un control de seguridad; es lo que hace la zona lo bastante tranquila como para firmarla limpiamente.
Cómo se cablea de verdad la firma
La forma de arriba es la parte importante, pero «una zona BIND normal que transfiere los datos hacia dentro» merece mostrarse en vez de describirse, porque el primer intento de esto suele naufragar al tratar de firmar el DLZ directamente.
En el DC, el lado DLZ se queda deliberadamente soso. Sirve el directorio, entrega la zona a exactamente un par, y no hace nada más:
key "transfer-to-signer" {
    algorithm hmac-sha256;
    secret "...";
};

options {
    recursion no;
    allow-query { key transfer-to-signer; localhost; };
    allow-transfer { key transfer-to-signer; };
    notify no;
};

dlz "AD DNS Zone" {
    database "dlopen /usr/lib64/samba/bind9/dlz_bind9_18.so";
};
Fíjate en que el .so lleva la versión mayor de BIND en su nombre. Ese es el acoplamiento de versión de la sección anterior hecho concreto — una actualización de BIND necesita el módulo de Samba correspondiente en su sitio antes de que named arranque.
En el lado de la firma, la zona es un secundario corriente con las opciones de firma acopladas. Esta es la parte que no puede vivir en el DLZ:
dnssec-policy "ad-internal" {
    keys {
        ksk lifetime P365D algorithm ecdsa256;
        zsk lifetime P90D  algorithm ecdsa256;
    };
};

zone "ad.example.com" {
    type secondary;
    primaries { 192.0.2.10 key transfer-to-signer; };
    file "ad.example.com.axfr";
    inline-signing yes;
    dnssec-policy "ad-internal";
    allow-transfer { key transfer-to-public; };
    also-notify { 192.0.2.20; 192.0.2.21; };
};
Que esto funcione en un secundario es el detalle portante, y el ARM lo dice directamente:
If
yes, BIND 9 maintains a separate signed version of the zone. An unsigned zone is transferred in or loaded from disk and the signed version of the zone is served with, possibly, a different serial number.
Así que BIND mantiene dos copias — la sin firmar que recibió, escrita en file, y la firmada que sirve, escrita junto a ella con una extensión .signed. Llega una transferencia, la versión firmada se regenera, y los servidores de aguas abajo reciben un notify, porque a estas alturas es una zona del todo corriente. inline-signing yes es de hecho el valor por defecto una vez que se acopla una dnssec-policy; se escribe arriba porque una configuración que dice lo que hace merece la línea.
La rotación de claves viene con la política en vez de con un trabajo de cron. Las rotaciones de ZSK no necesitan ninguna intervención; las rotaciones de KSK necesitan que el nuevo DS llegue al padre, que es la automatización de CDS/CDNSKEY de más adelante en esta entrada. rndc dnssec -status ad.example.com te dice dónde está cada clave en su vida.
Si ese bloque corre en el DC o en su propio host es cuestión de a qué dirección apunta primaries. En el DC es una segunda instancia de named en una segunda dirección, transfiriendo desde la primera por el loopback o una interfaz de gestión. Eso es lo que significa «BIND con DLZ puede ser el firmante» en la práctica: el mismo software, la misma caja si quieres, pero la firma ocurre sobre la copia transferida en vez de sobre la zona DLZ.
La única trampa operativa es el notify — y está en el lado DLZ. El manual de ISC es rotundo sobre ello: DLZ «has no built-in support for DNS notify», así que a los servidores secundarios no se les informa automáticamente de los cambios en las zonas de la base de datos. Samba puede cambiar un registro en el directorio y la instancia DLZ no tiene ni idea de que debería decírselo a alguien.
Así que el primer salto es un sondeo, no un empuje. El firmante refresca según el temporizador SOA de la zona que transfiere, lo que significa:
- La propagación de un cambio en el DC a un registro firmado y publicado está acotada por ese intervalo de refresco, no por segundos. Promociona un DC y sus nuevos registros
_msdcsaparecen aguas abajo hasta un refresco más tarde. - Ese intervalo es el dial a girar si el retraso importa. Es un trato contra la frecuencia con la que quieres que se consulte el DLZ, lo que trae a colación la otra cosa que ISC dice sobre DLZ: hace búsquedas en base de datos en tiempo real sin caché y «not recommended for use on high-volume servers».
- Ambas son argumentos a favor de esta topología en vez de en contra. El único cliente que tiene jamás la instancia DLZ es el firmante, preguntando una vez por refresco. La carga real de consultas del parque cae sobre los servidores autoritativos independientes, que sirven un fichero de zona firmado simple a toda velocidad.
Todo lo de aguas abajo del firmante es convencional: los servidores autoritativos son secundarios de la zona firmada, reciben un notify como es debido, y nunca tocan el directorio ni una clave.
Los clientes no deben escribir la zona que contiene los localizadores
Esta es la importante, y es una regla de diseño más que un ajuste.
Active Directory registra registros dinámicamente. Una máquina se une, y se registra a sí misma; un DC arranca, y registra los registros SRV que anuncian sus servicios. Actualización dinámica «segura» significa que esas actualizaciones están autenticadas — la máquina prueba que es quien dice ser con sus propias credenciales, y hay una ACL por registro para que una máquina generalmente solo pueda modificar un registro que creó ella.
Lee eso con cuidado, porque la garantía es más estrecha de lo que parece al principio. La actualización dinámica segura autentica quién está escribiendo. No evalúa qué significa el registro. Y el conjunto de cuentas con derecho a escribir es mucho más ancho de lo que la gente supone: en una zona integrada en AD por defecto el grupo Authenticated Users posee Create All Child Objects sobre el contenedor de la zona en el directorio, porque ADIDNS almacena cada registro como un objeto de AD bajo CN=MicrosoftDNS,DC=DomainDnsZones. No solo las cuentas de máquina — cualquier cuenta autenticada del dominio, incluida la que pertenece a quien abrió el adjunto de la factura esta mañana.
Lo que produce dos modos de fallo en una zona que contiene tanto registros de clientes como localizadores de servicio:
Los nombres que aún no existen no pertenecen a nadie. Las ACL por registro protegen un registro que ya tiene dueño. Un nombre que nunca se ha registrado no tiene objeto sobre el que imponer una ACL, así que la primera cuenta que lo cree se lo queda. Ese es el mecanismo detrás de toda la familia de ataques ADIDNS, siendo el más afilado un comodín: crea * y cada nombre de la zona que nadie ha reclamado explícitamente — erratas, hosts dados de baja, wpad — resuelve al atacante. Los registros existentes quedan intactos, que es justo por lo que pasa desapercibido.
El radio de impacto incluye los localizadores. Los registros bajo _msdcs son cómo cada cliente del dominio encuentra un controlador de dominio y un KDC. Son los registros más críticos para la seguridad que posees, y en un despliegue por defecto se sientan en la misma zona en la que cuatrocientos portátiles escriben cada vez que consiguen una concesión DHCP.
Así que la regla: la zona que contiene los localizadores la escriben los controladores de dominio, y nada más. El registro dinámico de clientes va a otro sitio.
Otro sitio puede ser cualquiera de dos cosas, y ambas están bien:
- Una sub-zona delegada servida en otro sitio. La zona de AD tiene una delegación
NSpara, digamos,dyn.ad.example.com, y los registros caen en un servidor aparte que acepta las actualizaciones. Las particiones de Samba no toman jamás una escritura de cliente. - Una zona aparte en Samba con su propia ACL de actualización. Sigue en el directorio, pero es su propia zona, así que una escritura de cliente no tiene camino a
_msdcsni a los registros propios de un DC.
La primera da la separación más dura; la segunda es menos que correr. Lo que suspende la regla no es ninguna de esas. Es el valor por defecto, donde las dos conviven. Que es como la mayoría de los dominios siguen funcionando, porque nadie lo eligió y nadie ha vuelto a mirarlo.
Y hay un segundo dividendo, el que ata esto de vuelta al pipeline. Una zona que solo escriben los controladores de dominio es una zona que apenas cambia jamás: una promoción de DC, una degradación de DC, y por lo demás silencio. Toda la rotación de una zona de AD por defecto es registro de clientes. Quítala y la objeción a firmar las particiones de AD se va con ella — no hay flujo de actualizaciones que las firmas persigan, así que firmarla es rutina en vez de una pelea. La disciplina de escritura y la firma son la misma decisión vista dos veces.
Junto a cualquiera de esas, hay un permiso que ir a mirar — y en un DC de Microsoft es el arreglo directo. Como los registros ADIDNS son objetos de directorio, el derecho viene de una ACL de AD en vez de de nada del protocolo DNS: Authenticated Users poseyendo Create All Child Objects sobre el contenedor de la zona. Apretar eso es la mitigación más limpia para el problema del nombre no reclamado y del comodín, y en muchos parques el permiso se puede quitar de plano una vez que sabes qué necesita de verdad autorregistrarse. El DNS de AD de Samba almacena sus registros en el directorio de la misma forma, así que se aplica la misma pregunta — ve a mirar qué concede en realidad el contenedor de tu zona.
Pero espera — ¿deberían los clientes registrarse siquiera en 2026?
Todo lo de arriba supone que la actualización dinámica de clientes es algo que necesitas y estás intentando hacer seguro. Antes de aceptar eso, vale la pena hacer la pregunta que nadie hace, porque la respuesta ha cambiado desde que este comportamiento se diseñó.
El registro DNS dinámico se construyó para un escritorio. Una caja bajo una mesa, un cable de red, una dirección que conservaba durante años. En ese mundo una máquina registrando su propio nombre era ordenado y básicamente cierto.
Ahora mira qué es un cliente en 2026. Se despierta en el wifi de casa. Entra a la oficina y se une a la inalámbrica corporativa. Se mete en una estación de acoplamiento y coge además una dirección cableada. Alguien arranca la VPN y aparece un adaptador de túnel con una tercera dirección. Se van a una cafetería, comparten conexión con un teléfono, y la VPN vuelve en una cuarta. Eso es una máquina, un nombre, y media docena de direcciones en una jornada de trabajo — y por defecto intentará registrar unas cuantas de ellas.
Así que la zona se llena de reclamaciones que fueron ciertas una vez.
- Windows registra cada adaptador que tiene, a menos que alguien haya pasado y desmarcado Register this connection’s addresses in DNS por interfaz. Un portátil acoplado en la VPN es una máquina con tres adaptadores vivos y una opinión sobre todos ellos.
- Múltiples registros A para un nombre no es un estado de error, es el resultado normal. Una consulta los devuelve todos, los clientes los prueban en el orden que les apetece, y las conexiones a ese nombre fallan en proporción a cuántas de las direcciones están muertas. Este es el mecanismo detrás de «el soporte remoto puede ver la máquina un minuto y al siguiente no».
- Las direcciones de VPN son las peores de todas, porque una dirección de túnel es válida durante una hora y el registro sobrevive a ella. El túnel se cae, la dirección del pool va a otro, y el nombre ahora apunta a un colega.
- Las estaciones de acoplamiento enturbian la identidad misma. A menos que se configure el paso de dirección MAC, la concesión pertenece al dock en vez de al portátil, así que un parque de hot-desk tiene nombres, concesiones y máquinas separándose entre sí a diario.
- Y la propiedad lo hace permanente. Un registro solo lo puede actualizar la cuenta que lo creó. Cuando un registro lo hizo DHCP bajo una credencial y la máquina más tarde intenta actualizarlo bajo la suya, la actualización falla, en silencio, y la dirección obsoleta se queda exactamente donde está.
La historia de la limpieza tampoco es el rescate que parece. Samba tiene scavenging desde 4.9, pero está desactivado por defecto (dns zone scavenging = yes, con samba-tool dns zoneoptions --aging=1), y Samba misma dice que «should only be enabled on new zones or new installations», porque las versiones antiguas marcaban los registros dinámicos como estáticos y los estáticos como dinámicos. En los parques con más probabilidad de estar llenos de basura — los que llevan años funcionando — la herramienta para despejarla es la que te aconsejan no activar. También ha tenido un CVE propio.
Así que planteemos la pregunta directamente: qué consume en realidad el registro A de un portátil?
En la mayoría de las organizaciones, muy poco. Los usuarios conectan a servidores; los servidores no conectan a portátiles. Los consumidores genuinos son las herramientas de soporte remoto, RDP a una estación de trabajo con nombre, e inventario o monitorización — y casi todo ese instrumental mantiene su propio inventario y funciona a partir de un agente que se registra, porque nunca pudo fiarse de DNS para clientes móviles en primer lugar.
Lo que sugiere invertir el valor por defecto:
- Los servidores y la infraestructura obtienen registros del aprovisionamiento. Con NetBox y Ansible ya en escena, el registro lo crea lo mismo que creó la máquina, es correcto por construcción, y se elimina cuando la máquina se elimina.
- El parque cableado estable puede tomar registros de DHCP si algo los necesita de verdad, con una credencial poseyéndolos para que las actualizaciones no fallen.
- Los clientes móviles no registran nada en absoluto. Son consumidores de DNS, no publicadores de él. Si algo necesita alcanzar un portátil, necesita un agente, no un registro A.
Acabas en el mismo sitio en el que te puso el argumento de seguridad, desde una dirección completamente distinta. Menos escritores significa una superficie ADIDNS más pequeña, una zona que no está llena de reclamaciones caducadas, y — de vuelta al pipeline — una zona lo bastante tranquila para firmar sin pensarlo.
El caso de seguridad dice que los clientes no deben escribir la zona que contiene los localizadores. El caso operativo pregunta por qué escriben DNS siquiera. En 2026, para una flota que cambia de dirección cinco veces al día, «no lo hacen» es una respuesta perfectamente buena, y bastante menos trabajo que hacer seguro su lío.
Vistas separadas, y de dónde viene la confianza
La última pieza ata las dos mitades de la entrada.
Hay dos vistas del espacio de nombres. Una zona pública, publicada a internet, que contiene el puñado de nombres que el mundo necesita. Y una vista interna — el contenido derivado de AD, cada host unido, cada localizador de servicio, la topología de sitios — que el mundo no tiene por qué ver. Ese contenido es un mapa del parque, y debería ser inalcanzable e intransferible desde fuera.
Pero la confianza de la vista interna viene del lado público, y eso es lo que hace este diseño mejor que la isla habitual de DNS interno:
example.comes pública y firmada, con suDSen el padre y una cadena a la raíz.ad.example.comestá delegada de ella. El padre público publica la delegación y unDSpara la clave de la zona interna.- Los servidores autoritativos internos sirven la
ad.example.comfirmada. Los resolvers internos la validan — raíz →com→example.com→ad.example.com— sin usar nada más que el ancla de confianza de la raíz que ya tenían.
Sin ancla de confianza local. Sin isla. Sin clave distribuida a mano. Los datos nunca salen del edificio, y el camino de validación es el público corriente. Cuando añades un resolver, valida los nombres internos correctamente sin ninguna configuración de DNSSEC en absoluto.
Siendo claro sobre el trato, porque lo hay. Publicar una delegación y un DS en la zona pública significa que la existencia de ad.example.com, y los nombres de sus servidores de nombres, son públicos. El contenido no lo es, y nunca lo es — pero le has dicho al mundo que la zona existe. A cambio, cada resolver que posees valida los nombres internos contra la raíz real. Es un buen trato para la mayoría de los parques, y debería ser uno deliberado en vez de una sorpresa.
Dos cosas que acertar junto a ello:
- Mantén la vista interna inenumerable e intransferible.
allow-transferen los servidores autoritativos internos es para el firmante y tus propios secundarios, nada más. Y ten en cuenta que la denegación autenticadaNSECdeja a cualquiera que pueda consultar la zona recorrerla de punta a punta;NSEC3sube ese coste, pero el control real es que los de fuera no pueden alcanzar los servidores en absoluto. - Automatiza el
DS. UnDSen el padre que deja de coincidir con la clave del hijo lleva todo el dominio interno aSERVFAIL.CDS/CDNSKEYexisten para que el hijo pueda señalar un cambio de clave y el padre pueda recogerlo sin que un humano edite un registro durante una rotación. Si la zona padre está en un registrador o proveedor que lo soporta, úsalo; si no, el procedimiento de rotación hay que escribirlo antes de la primera rotación, no durante.
Hacer que Windows y Linux validen de verdad
Todo hasta aquí ha ido de publicar una zona que se puede verificar. Nada de ello hace nada hasta que algo en el lado del cliente insiste en verificarla. Una zona perfectamente firmada y un cliente que nunca comprueba una firma producen exactamente la misma experiencia que una zona sin firmar, justo hasta el día en que no.
Solo hay dos sitios donde la validación puede ocurrir, y la diferencia entre ellos es la diferencia entre un control de seguridad y una sugerencia educada.
Valida en el resolver, y fíate del bit AD. El cliente pregunta a un resolver, el resolver hace la criptografía, e informa del resultado poniendo un bit — AD, datos autenticados — en la respuesta. El cliente se cree el bit. Este es el modelo que usa Windows, y es solo tan fuerte como el camino entre el cliente y el resolver, porque cualquier cosa que pueda responder como el resolver puede poner ese bit.
Valida en el propio cliente. La máquina corre su propio resolver que valida, así que el «camino al resolver» es un socket de loopback dentro de la máquina y no queda nada que suplantar. Esto es más fuerte, y en Linux es del todo alcanzable.
Por defecto no hay nada
Antes de configurar nada, vale la pena ver qué hace una estación de trabajo Linux corriente recién sacada de la caja. Esta es una máquina Fedora 44, systemd 259, sin tocar:
$ resolvectl status | head -3
Global
         Protocols: LLMNR=resolve -mDNS -DNSOverTLS DNSSEC=no/unsupported
  resolv.conf mode: stub

$ grep options /etc/resolv.conf
options edns0 trust-ad

$ dig +dnssec cloudflare.com A | grep flags
;; flags: qr rd ra; QUERY: 1, ANSWER: 3, AUTHORITY: 0, ADDITIONAL: 1
Lee esas tres juntas, porque cuentan una pequeña historia.
El stub está configurado con trust-ad — se le ha dicho que se crea el bit AD. systemd-resolved informa de DNSSEC=no/unsupported, así que él no está validando nada. Y la respuesta para una zona firmada vuelve con los flags qr rd ra y sin ad — nada en ninguna parte de ese camino afirmó haber validado.
Eso no es una mala configuración. Es el valor por defecto. A un cliente se le puede decir que se fíe de una afirmación que nada en la cadena está haciendo. No lo comprueba nadie. Vale la pena quedarse con ello un minuto antes de configurar cualquier otra cosa.
Linux
Tres opciones, en orden creciente de lo poco que tienes que fiarte de la red.
1. systemd-resolved, validando localmente. Un drop-in en vez de editar el fichero entregado:
# /etc/systemd/resolved.conf.d/dnssec.conf
[Resolve]
DNSSEC=yes
DNSOverTLS=opportunistic
Luego systemctl restart systemd-resolved y confirma con resolvectl status que la línea ahora dice DNSSEC=yes.
El ajuste con el que hay que tener cuidado es el del medio. DNSSEC=allow-downgrade parece un compromiso sensato y no es un control de seguridad — resolved.conf(5) lo dice él mismo:
Note that this mode makes DNSSEC validation vulnerable to “downgrade” attacks, where an attacker might be able to trigger a downgrade to non-DNSSEC mode by synthesizing a DNS response that suggests DNSSEC was not supported.
Un atacante que puede forjar respuestas es exactamente el atacante para detener el cual existe DNSSEC, así que un modo que pueden apagar forjando una respuesta no te compra nada contra ellos. Es yes o es decoración.
2. Un resolver que valida de verdad en el host. El validador de systemd-resolved es cómodo en vez de minucioso. Donde importa, corre Unbound o BIND en el loopback y apunta el stub a él:
# unbound: validate against the root anchor, refuse to be stripped
server:
    module-config: "validator iterator"
    auto-trust-anchor-file: "/var/lib/unbound/root.key"
    harden-dnssec-stripped: yes
    val-permissive-mode: no

# the internal zone is reached like any other name — no local anchor needed
forward-zone:
    name: "ad.example.com."
    forward-addr: 192.0.2.53
El equivalente de BIND es una línea — dnssec-validation auto; — que usa su copia incorporada del ancla de la raíz y gestiona la rotación por ti.
3. A escala de todo el parque, en los resolvers que ya corres. Estos son la etapa cuatro del pipeline de antes en esta entrada. La validación ocurre ahí, los clientes se fían del bit AD, y el salto entre ellos es lo que tienes que proteger — con DoT, o con una red sobre la que estés dispuesto a hacer esa suposición.
Y fíjate en lo que no está en ninguna de esas configuraciones: un ancla de confianza para la zona interna. Como ad.example.com es una delegación dentro de una zona firmada públicamente, cada una de estas valida los nombres internos a través de la cadena corriente desde la raíz. Ese es el diseño de la sección anterior pagándose solo. La alternativa es empujar un ancla local a cada cliente y resolver del parque, y re-empujarla en cada rotación.
Windows
Lo importante primero, porque se malinterpreta habitualmente: el Cliente DNS de Windows no valida DNSSEC. No hace criptografía, no comprueba ninguna firma, y no guarda ninguna ancla de confianza. Es un resolver stub, y siempre lo ha sido.
Lo que puedes hacer es forzarlo a rechazar respuestas que no fueron validadas por el servidor en su nombre. Eso es la Name Resolution Policy Table, y es por espacio de nombres en vez de global:
# Require validated answers for the internal zone
Add-DnsClientNrptRule -Namespace ".ad.example.com" `
    -DnsSecEnable -DnsSecValidationRequired

# What is actually in force on this machine, including from Group Policy
Get-DnsClientNrptPolicy -Effective
Get-DnsClientNrptRule
Para el parque, lo mismo vive en la Directiva de Grupo bajo Computer Configuration → Policies → Windows Settings → Name Resolution Policy: crea una regla para el espacio de nombres, marca la opción DNSSEC, y marca el requisito de que el cliente compruebe que los datos fueron validados por el servidor DNS.
Dos cosas se siguen de eso, y ambas importan.
Algo río arriba todavía tiene que hacer la validación. La regla NRPT hace que el cliente exija el bit AD; no lo crea. El resolver al que esos clientes apuntan debe ser un resolver que valida, o cada nombre de ese espacio de nombres falla.
Y esta es la razón por la que la regla NRPT tiene opciones de IPsec al lado. Microsoft las puso ahí por la razón expuesta al principio de esta sección: exigir un bit que cualquier atacante en el camino puede poner no es gran requisito. Si te apoyas en el modelo de que-valida-el-resolver en una red no fiable, el último salto necesita protección — IPsec entre cliente y resolver, o DoT donde el resolver lo soporte.
Falla cerrado, así que despliégalo en ese orden
Forzar la validación convierte una clase de compromiso silencioso en una clase de caída ruidosa. Ese es el trato correcto, y sigue siendo una caída: un RRSIG caducado, un DS en el padre que ya no coincide tras una rotación, o un resolver que no puede alcanzar la zona padre producen todos SERVFAIL, y SERVFAIL para _ldap._tcp.dc._msdcs significa que el dominio está caído en vez de degradado.
Así que hazlo en este orden:
- Activa la validación en los resolvers primero, y deja a los clientes en paz. Vigila los
SERVFAILen los registros del resolver durante un par de semanas — aquí es donde encuentras la zona que ha estado rota en silencio durante un año. - Automatiza el
DSantes de forzar nada, según la sección anterior. La mayoría de las caídas de DNSSEC autoinfligidas son una rotación en la que el padre nunca se actualizó. - Luego fuerza a los clientes, un espacio de nombres cada vez, empezando por tu propia estación de trabajo y una OU de prueba en vez de todo el parque.
El fallo contra el que estás diseñando es que a un cliente se le entregue un controlador de dominio forjado. El fallo que estás arriesgando es que a un cliente no se le entregue nada en absoluto. El segundo es recuperable y obvio; el primero no es ninguna de las dos cosas. Te enterarás de la caída en un minuto. De la otra no te habrías enterado jamás.
Cifrar el último salto: DoT y DoH en los resolvers internos
La sección de validación dejó una cosa colgando. En el modelo de que-valida-el-resolver — el que te da Windows — el cliente se fía de un solo bit puesto por el resolver, y ese bit vale solo lo que el camino por el que viajó. Algo tiene que proteger ese camino.
BIND sí soporta ambos transportes cifrados de forma nativa, así que esto es un trabajo de configuración en vez de uno de compra:
- DNS sobre TLS — un bloque
tlsreferenciado desdelisten-on, convencionalmente en el puerto 853. - DNS sobre HTTPS — el mismo bloque
tlsmás un bloquehttp, en el 443. - DoT saliente, porque
forwarderstoma un transporte TLS por dirección o para la lista entera. - Transferencias de zona sobre TLS, porque la sentencia
primariesde una zonatype secondarytambién toma uno — lo que es directamente útil para el pipeline de antes en esta entrada.
Primero, ten claro qué compra esto, porque DoT y DNSSEC se confunden constantemente y no son alternativas. DNSSEC autentica los datos, todo el camino de vuelta hasta la zona que los publicó. DoT protege la conversación con el resolver. Uno sobrevive a un resolver hostil y a una red hostil entre resolvers; el otro impide que la máquina en tu wifi lea y reescriba lo que tu portátil preguntó. Quieres ambos, y ninguno sustituye al otro. Cifrar el salto hasta un resolver que no valida es una conversación privada con algo al que aún se le puede mentir.
Servirlo
tls internal-resolver {
    key-file "/etc/pki/dns/resolver.key";
    cert-file "/etc/pki/dns/resolver.pem";
    protocols { TLSv1.3; };
};

http internal-doh {
    endpoints { "/dns-query"; };
};

options {
    dnssec-validation auto;

    listen-on          port  53                          { 192.0.2.53; };
    listen-on          port 853 tls internal-resolver    { 192.0.2.53; };
    listen-on          port 443 tls internal-resolver
                                 http internal-doh       { 192.0.2.53; };
    listen-on-v6       port 853 tls internal-resolver    { 2001:db8::53; };
};
El certificado es el trabajo de verdad, y es la parte que se salta. Un cliente que verifica — que es todo el objeto — necesita un certificado válido para el nombre con el que fue configurado, emitido por algo en lo que ya confía. Eso significa tu CA interna y tu automatización de certificados existente, no la palabra clave ephemeral. ephemeral genera un certificado autofirmado de usar y tirar; está ahí para que puedas probar que el escuchador funciona, y no vale nada para ningún cliente que de verdad compruebe.
Reenviar sobre él
Si esos resolvers reenvían a algún sitio en vez de recorrer el árbol ellos mismos, el salto río arriba también se puede cifrar — y hay una distinción aquí que conviene acertar:
tls upstream {
    ca-file "/etc/pki/tls/certs/ca-bundle.crt";
    remote-hostname "dns.example.net";
};

options {
    forwarders port 853 tls upstream { 192.0.2.1; };
};
Sin remote-hostname, obtienes cifrado sin autenticación: el tráfico es ilegible para un observador pasivo, y un atacante activo que puede interceptar la conexión simplemente presenta su propio certificado. Con remote-hostname y ca-file, BIND verifica con quién está hablando. El primero vale algo. Solo el segundo vale llamarlo un control.
La mitad del cliente no es simétrica
Aquí es donde un parque mixto se pone incómodo, y es la razón de configurar ambos transportes en vez de elegir uno.
Linux hace DoT como es debido. systemd-resolved toma DNSOverTLS=yes para el modo estricto, y al servidor se le puede dar el nombre contra el que verificar:
[Resolve]
DNS=192.0.2.53#resolver.ad.example.com
DNSOverTLS=yes
DNSSEC=yes
Como con DNSSEC=, el ajuste del medio es la trampa: DNSOverTLS=opportunistic recae en texto claro cuando TLS no está disponible, lo que un atacante que puede interferir con la conexión puede arreglar.
Windows hace DoH, y no DoT. El soporte de DoH en el cliente llegó en Windows 11 y Server 2022, configurado por servidor con una plantilla:
$doh = "https://resolver.ad.example.com/dns-query"
netsh dnsclient add encryption server=192.0.2.53 dohtemplate=$doh
DoT, al momento de escribir esto, solo ha aparecido en compilaciones Insider. Así que en el Windows publicado la opción cifrada es DoH o nada, que es justo por lo que la sección de NRPT de antes echó mano de IPsec en su lugar.
De ahí servir ambos desde la misma instancia de BIND. DoT para la flota Linux y cualquier otra cosa que lo hable, DoH para Windows, un resolver, un certificado.
Cuál, y dónde
Para un resolver interno, DoT es el transporte mejor y DoH es la respuesta de compatibilidad.
DoT se sienta en su propio puerto. Puedes verlo, permitirlo, denegarlo, y alertar sobre cualquier cosa que haga DNS que no lo esté haciendo así. La ventaja de DoH — indistinguible del tráfico web corriente en el 443 — es un beneficio genuino en una red hostil y un fastidio en la tuya, donde poder saber qué es DNS es una función que pagaste. En el parque que controlas, prefiere el transporte que puedes observar, y corre DoH porque Windows no te deja elección en vez de porque sea mejor.
Ya que estás: cifra las transferencias
El pipeline de antes en esta entrada mueve la zona de AD por AXFR, y la sección de vistas separadas hizo el punto de que su contenido es un mapa del parque. TSIG autentica esas transferencias; no las oculta. Como la sentencia primaries de un secundario acepta una configuración TLS, la transferencia también puede correr sobre TLS — RFC 9103 si quieres el estándar:
zone "ad.example.com" {
    type secondary;
    primaries { 192.0.2.10 port 853 tls xfr-tls key transfer-to-signer; };
    ...
};
Autenticada por la clave, cifrada por el transporte. Si cualquier salto de ese pipeline cruza un enlace de sitio, un hipervisor que compartes, o cualquier cosa sobre la que no pondrías felizmente un hub, valen los veinte minutos.
Lo que no arregla
- No es validación. Cubierto arriba, y vale repetirlo porque los proveedores venden «DNS seguro» queriendo decir solo cifrado.
- No oculta nada del resolver. El resolver ve cada consulta al completo. El cifrado protege el camino, no la privacidad de la consulta frente al operador — lo cual está bien cuando el operador eres tú.
- No hace nada por un cliente que no verifica el certificado, y los modos oportunistas son degradables por exactamente el atacante que te preocupa.
- Y no es una razón para poner un escuchador en el controlador de dominio. DNS cifrado en el DC sería resolver el problema equivocado maravillosamente. El DC sigue sin responder a nadie.
Cómo comprobar lo que tienes
Comandos para lanzar contra tu propio parque. Las salidas son la parte interesante, y un par de ellas suelen ser una lectura incómoda la primera vez.
# Walk the tree yourself, one delegation at a time
dig +trace dc01.ad.example.com

# Validate, and show the chain being built
delv +rtrace +vtrace ad.example.com SOA

# Is the resolver you are pointed at actually validating?
# A deliberately broken test name must come back SERVFAIL, not an address
dig @<resolver> dnssec-failed.org A

# What does the estate advertise as a domain controller?
dig SRV _ldap._tcp.dc._msdcs.<domain>
dig SRV _kerberos._udp.<domain>

# Is a DC answering for names it has no business answering?
# Ask it for something it is not authoritative for. "recursion requested
# but not available" is the answer you want. An actual address means it is
# serving the estate — recursing if it is BIND, relaying to the forwarder
# if it is SAMBA_INTERNAL. Either way it should not be doing that.
dig @<dc> www.example.org A

# Is the DC configured as the estate's DNS relay?
grep -E 'dns forwarder|server services' /etc/samba/smb.conf

# Will a DC hand its zone to anybody who asks?
dig @<dc> AXFR ad.example.com

# Which backend is this DC running, and does named have the module?
grep -r dlz /etc/named.conf /var/lib/samba/bind-dns/ 2>/dev/null
samba-tool dns query <dc> <domain> @ ALL

# Is the internal zone chained to the public parent?
dig DS ad.example.com @<public-authoritative-for-example.com>

# What does the local stub actually do with the AD bit, and is the
# hop to the resolver encrypted?
resolvectl status                    # DNSSEC= and DNSOverTLS= per link
grep options /etc/resolv.conf        # trust-ad, trusting whom exactly?

# Did anything in the path claim to have validated? Look for "ad" in the flags
dig +dnssec ad.example.com SOA | grep flags

# Validate independently of whatever the local resolver believes
delv ad.example.com SOA              # "fully validated" is the line you want

# Is the resolver actually listening for DoT, and does its certificate
# match the name clients are configured with?
kdig +tls @192.0.2.53 ad.example.com SOA
openssl s_client -connect 192.0.2.53:853 \
    -servername resolver.ad.example.com </dev/null 2>/dev/null \
    | openssl x509 -noout -subject -dates
Y en un cliente Windows, para ver si está exigiendo algo en absoluto:
Get-DnsClientNrptPolicy -Effective    # the rules actually in force
Resolve-DnsName ad.example.com -DnssecOk
Get-DnsClientDohServerAddress         # is the hop to the resolver encrypted?
Los dos que más a menudo producen una sorpresa son la comprobación de recursión y el intento de AXFR. Si un DC responde a cualquiera de ellos para un cliente arbitrario, el pipeline de esta entrada no está en su sitio, diga lo que diga el diagrama de la wiki.
El tercero es resolvectl status en una máquina que nadie ha tocado. DNSSEC=no/unsupported junto a trust-ad en resolv.conf es el estado normal de un escritorio Linux, y significa que el trabajo de firma descrito arriba lo está comprobando actualmente nadie.
La versión corta
Un resolver nace sabiendo los servidores raíz y una clave, y aprende todo lo demás porque se lo dicen. Los nombres se encuentran recorriendo delegaciones a la bajada, y los servicios se encuentran pidiendo un registro SRV — así que para cuando un cliente empieza a hacer Kerberos con un controlador de dominio, la identidad de ese controlador de dominio vino de una respuesta DNS. El descubrimiento por DNS es correcto y está bien. La autorización por DNS no lo está, y una cantidad sorprendente de infraestructura la hace en silencio de todas formas.
DNSSEC es lo que hace verificables esas respuestas: firmas en cada conjunto, un DS en cada padre, una cadena a una sola ancla de confianza en la raíz, y denegación autenticada para que no se pueda hacer desaparecer un nombre. Compra autenticación de origen e integridad — no privacidad, y no corrección. Firma lo que sea que diga la zona, que es por lo que no puede rescatar una zona que máquinas no fiables tienen permiso para escribir. Y necesita un padre: un TLD interno inventado no tiene dónde poner un DS, así que .local, .lan, .internal y home.arpa te dejan todos o sin firmar o corriendo una isla privada de claves distribuidas a mano.
Para un dominio de Active Directory, eso produce un diseño en vez de una lista de ajustes. Usa una delegación dentro de una zona pública que posees, para que la confianza baje por la cadena corriente desde la raíz mientras los datos nunca salen. Sirve las particiones de AD con BIND y dlz_bind9 — DLZ no es el riesgo, es cómo sacas la zona del directorio — y deja que el DC sea un primario oculto que transfiere hacia fuera y no responde a nadie más. Una zona DLZ no se puede firmar a sí misma, así que la firma es una zona secundaria normal que contiene la copia transferida, con inline-signing y una dnssec-policy encima: un segundo named en el DC si quieres menos máquinas, un host aparte si quieres las claves privadas fuera del directorio. En cualquier caso se firma una vez, en un punto definido, bajo una política de claves — y el primer salto es un sondeo en vez de un empuje, porque DLZ no puede enviar un notify. Publica desde servidores autoritativos independientes que no guardan claves y no tienen ruta al directorio.
Y mantén a los clientes fuera de la zona que importa. La actualización dinámica segura autentica al escritor, no el significado, y en una zona integrada en AD por defecto los escritores son Authenticated Users — cada cuenta, no solo cada máquina — así que una zona que contiene tanto registros de portátiles como localizadores _msdcs está a un usuario phisheado de que a un cliente se le diga, con una firma perfectamente válida, que el controlador de dominio está en otra parte. Los registros de clientes pertenecen a una sub-zona, delegada fuera o aparte en Samba, donde lo peor que una cuenta comprometida puede hacer es mentir sobre sí misma.
Aunque la mejor pregunta es si los clientes deberían registrarse en absoluto. Un portátil de 2026 tiene una dirección en el wifi de casa, otra en la inalámbrica de la oficina, otra por el dock y otra en la VPN, y publicará alegremente casi todas. Lo que consume el registro A de un portátil es casi nada — las herramientas que necesitan alcanzar una estación de trabajo mantienen su propio inventario, porque DNS nunca fue fiable para clientes móviles de todos modos. Los registros de los servidores deberían venir del aprovisionamiento, y la flota debería no registrar nada.
Luego haz que algo compruebe las firmas, porque nada de lo anterior vale nada hasta que un cliente rechaza una respuesta. En Linux eso significa DNSSEC=yes en systemd-resolved, o un resolver que valida de verdad en el loopback — nunca allow-downgrade, que un atacante capaz de forjar respuestas puede simplemente apagar forjando una respuesta. En Windows significa aceptar que el cliente DNS nunca valida nada por sí mismo, y usar una regla NRPT para hacer que exija una respuesta que el resolver validó, con el último salto protegido porque ese requisito es un solo bit. Actívalo en los resolvers primero y vigila los SERVFAIL, automatiza el DS, luego fuerza a los clientes. Falla cerrado, que es el sentido correcto y aun así una caída.
Nada de esto es exótico. Es delegación, transferencia y firma — las tres cosas que DNS siempre ha hecho — dispuestas de modo que la máquina que guarda tu directorio no sea la máquina que atiende preguntas del aparcamiento, y de modo que cuando algo sí le mienta a un cliente, el cliente lo note.