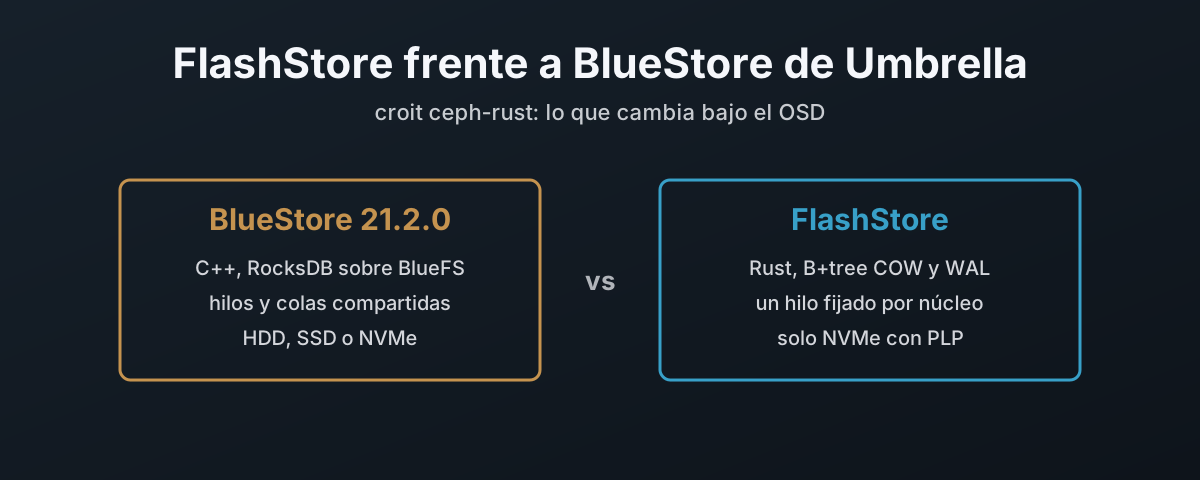
Aviso desde el principio: trabajo para croit, que ha escrito esto. Todo lo que sigue está leído del código fuente y la documentación publicados de los dos proyectos, enlazados al pie de la página, y donde la documentación de croit contradice el código de croit, lo digo.
El OSD de Ceph, reescrito desde cero
croit ha publicado ceph-rust, un OSD de Ceph escrito desde la nada en Rust, con un almacén de objetos propio llamado FlashStore en lugar de BlueStore1.
Entró en vista previa pública el 9 de noviembre de 2026, con la disponibilidad general prevista para el primer trimestre de 20271.
No es un fork.
La regla del propio proyecto es que el C++ de Ceph se lee como referencia, se redacta como especificación con palabras de croit y luego se implementa a partir de la especificación2.
Lo que importa a quien opera Ceph es la promesa de sustitución directa.
Tus monitores, tus managers, la CLI ceph y tus clientes se quedan como están.
Un OSD FlashStore entra en los mismos pools y los mismos placement groups que los OSD clásicos que ya están ahí, y cambias un disco cada vez1.
Así que la pregunta para un operador es práctica. Si cambias un OSD BlueStore por uno FlashStore, ¿qué es distinto por debajo? No en abstracto, y no frente a un BlueStore de una charla de congreso de hace años. Frente al BlueStore que de verdad ejecutas hoy si estás en Umbrella, Ceph 21.2.0, que es la versión contra la que se compila y se prueba FlashStore1.
Esa es la comparación aquí, y solo esa. El BlueStore de Umbrella tal como lo describen su código y su documentación, frente a FlashStore tal como lo describen su código y sus registros de decisiones.
Afecta a cualquiera con clústeres Ceph sobre NVMe, y a cualquiera que haya mirado cuántos núcleos le cuesta un OSD. A los clústeres de HDD no les afecta en absoluto, y el motivo sale más abajo.
Qué hay en el repositorio
El repositorio es una instantánea de solo lectura del árbol de desarrollo privado de croit. Sin gestor de incidencias, sin pull requests; las actualizaciones llegan como nuevos commits de instantánea1. Eso corresponde a la fase de preview, que existe para recoger las opiniones de la comunidad mientras croit pasa internamente sus casos de prueba de producción antes de marcarlo como seguro para su uso. El desarrollo se abre tras la primera versión de producción, como en la mayoría de los proyectos de código abierto respaldados por una empresa. Esta tiene fecha del 10 de noviembre de 2026 y lleva unas 700.000 líneas de Rust y más de 450 registros de decisiones de arquitectura, los ADR, que son los documentos breves donde queda escrito por qué se tomó cada decisión de diseño.
Los ADR son la parte útil para una comparación como esta. Son directos, llevan mediciones y recogen lo que se probó y se tiró además de lo que se quedó.
| Componente | Qué sustituye | Vista previa | GA (prevista) |
|---|---|---|---|
| FlashStore OSD | ceph-osd + BlueStore | nov. 2026 | T1 2027 |
| librustyrados | librados | nov. 2026 | T1 2027 |
| librustyrbd | librbd | nov. 2026 | T1 2027 |
| Transporte RDMA (RoCEv2) | nada en Umbrella | nov. 2026 | T1 2027 |
| CephFS2, RGW en Rust | MDS, RGW | T1 2027 | T2 2027 |
| ceph-mon, ceph-mgr | no se sustituyen | n/d | n/d |
Conviene conocer las licencias antes de construir nada encima. El daemon y las herramientas son LGPL-3.0-only, las bibliotecas cliente son MPL-2.0 y la documentación es CC-BY-SA-4.03. Las bibliotecas cliente pasaron a MPL para que un programa en Rust pueda enlazarlas estáticamente sin las obligaciones de reenlazado que trae la LGPL, lo cual es una decisión razonada y está escrita como tal3.
Vista previa significa lo que dice. El propio README de croit dice que es para pruebas y evaluación y «not yet recommended for production data»1. Yo tampoco pondría datos de clientes encima todavía, y nada en el resto del artículo cambia eso.
Dos almacenes, uno al lado del otro
Un OSD tiene dos mitades. La mitad de arriba habla el protocolo de Ceph, es dueña de los placement groups, hace peering, recupera y hace scrub. La mitad de abajo, el almacén de objetos, convierte «escribe estos bytes en este objeto» en bloques en un disco y promete que sobreviven a un corte de corriente.
BlueStore es la mitad de abajo de Umbrella. Su documentación dice que «reads and writes to the devices directly in a ‘raw’ fashion»4, y que consume «raw block devices or partitions»5. Los datos de los objetos van directos al dispositivo de bloques. Todo lo demás, los metadatos de los objetos, el OMAP y su propia contabilidad, va a una base de datos clave/valor RocksDB embebida, y RocksDB se apoya en BlueFS, un pequeño sistema de ficheros que BlueStore lleva para ella56.
FlashStore se quita todo eso de encima. Un único B+tree copy-on-write por shard del almacén lo guarda todo: colecciones, metadatos de objetos, atributos extendidos, mapas de extents, OMAP, el PG log, contadores de referencias y hasta el propio bitmap del asignador7. A su lado hay un anillo de registro de escritura anticipada (WAL) de tipo redo y la región de datos. No hay RocksDB, no hay BlueFS y no hay una segunda base de datos que afinar.
La otra gran diferencia es el propio disco. BlueStore pasa por la capa de bloques del kernel hacia lo que le des. FlashStore habla con el NVMe o bien con SPDK, un driver en espacio de usuario que le quita el dispositivo al kernel mediante vfio, o bien a través del kernel con io_uring89. SPDK es el backend por defecto. El nivel io_uring es el que funciona donde vfio no, y como tal es en el que acabé en el montaje en Proxmox.
Dónde viven los metadatos
Empieza por aquí. Casi todo lo demás sale de esto.
| BlueStore de Umbrella | FlashStore | |
|---|---|---|
| Metadatos de objetos | claves de RocksDB | B+tree COW por shard |
| OMAP | claves de RocksDB | el mismo B+tree por defecto; LSM o RocksDB opcional en prepare |
| PG log | claves de RocksDB | el mismo B+tree |
| Estado del asignador | asignador hybrid, freelist en RocksDB | bitmap por shard, dentro del árbol |
| Dispositivo de metadatos | block.db y block.wal opcionales | ninguno, el mismo NVMe |
| Checksums de datos | crc32c por cada 4 KiB por defecto | crc32c por cada 4 KiB, en el mapa de extents |
| Almacenes por OSD | uno | uno por núcleo |
Los valores por defecto del lado de BlueStore salen directamente del fichero de opciones de Umbrella: RocksDB como backend clave/valor, el asignador hybrid y checksums crc32c61011. El checksum de metadatos de BlueStore «is handled by RocksDB and uses the crc32c algorithm», y los datos le cuestan «a checksum value (usually 4 bytes) for every 4 KB block of data»4. En checksums los dos almacenes coinciden. FlashStore guarda un crc32c por cada bloque de 4 KiB en el mapa de extents y lo verifica al leer7.
Donde se separan es en la estructura. El RocksDB de BlueStore es un árbol LSM, así que escribe y luego compacta en segundo plano, reescribiendo datos que ya había escrito. El árbol de FlashStore se actualiza por copy-on-write y se vuelca a disco en checkpoints: cada cinco segundos mientras haya algo sin persistir, o cuando el anillo del WAL llega a la mitad7.
Otra consecuencia es que FlashStore no tiene dispositivo rápido para metadatos, porque no lo necesita.
En Umbrella puedes poner block.db en un disco más rápido, y BlueStore pondrá «as much metadata as it can on the DB device»4.
FlashStore da por hecho que todos los discos ya son NVMe rápidos, y guarda sus metadatos junto a los datos.
Es una suposición razonable para el hardware al que apunta. También es exactamente la razón de que no haya nada para HDD.
El OMAP es el único sitio donde FlashStore se cubre las espaldas. El árbol es lo predeterminado, pero un almacén se puede preparar con un motor LSM propio de croit, o con RocksDB, detrás de la misma interfaz12. El motor de OMAP se elige al crear el almacén. No se cambia en un OSD en marcha.
Una escritura de 4 KiB, de dos maneras
Esta es la diferencia que notarías, si es que notas alguna.
Toma una escritura de 4 KiB en un objeto en Umbrella con la configuración por defecto sobre flash.
bluestore_min_alloc_size_ssd es 4 KiB y bluestore_prefer_deferred_size_ssd es 0, así que una escritura entera de 4 KiB va a 4 KiB recién asignados1314.
BlueStore envía esa escritura de datos, y la transacción se queda en STATE_AIO_WAIT hasta que el disco dice que ha terminado15.
Solo entonces se encolan los metadatos para RocksDB, y el hilo de sincronización de RocksDB vacía el dispositivo de bloques antes de hacer commit16.
Después el cliente recibe su confirmación.
Dos viajes al dispositivo, en serie.
FlashStore envía los dos a la vez. Los datos van a un extent nuevo de 4 KiB y la unidad de WAL va al anillo del log en paralelo. El registro del WAL lleva el crc32c de cada bloque de datos nuevo, así que el replay tras un fallo puede saber si los datos llegaron7. La confirmación sale, en orden del log, cuando los datos, la unidad de WAL y todas las transacciones anteriores son duraderos7. La justificación del propio ADR para el diseño es «parallel commit gives one device latency per ack»7.
Dos cosas mantienen esto en su sitio. En un OSD con carga los dos almacenes agrupan commits, así que bajo carga la diferencia es menor que una latencia de dispositivo por escritura. Y un viaje al dispositivo en NVMe son unas pocas decenas de microsegundos. Que lo notes depende de si tus clientes esperan por latencia con poca profundidad de cola, como suelen hacer las bases de datos sobre RBD, o empujan rendimiento, donde se diluye.
croit intentó ir más lejos, a una sola escritura de dispositivo por transacción, al estilo ZFS. Lo construyeron, lo midieron y lo tiraron: la ganancia solo aparecía con profundidad de cola 1 y la complejidad no compensaba17. Eso lo valoro más que cualquier gráfico de benchmark. Es un registro de decisión que dice «lo construimos y no merecía la pena», en público.
La escritura de menos de 4 KiB
La escritura más pequeña es donde los dos se separan de verdad.
Pongamos que un cliente sobrescribe 512 bytes en medio de un bloque que ya tiene datos.
Umbrella sigue usando por defecto su ruta de escritura original; bluestore_write_v2, la reescritura, viene desactivada18.
En esa ruta, una escritura más pequeña que min_alloc_size en un bloque que ya está asignado se convierte en una escritura diferida19.
Los datos viajan dentro de la transacción de RocksDB como una clave con el prefijo L, y solo van a su sitio real después de que al cliente se le haya dicho que están a salvo2021.
Así que los datos llegan al disco dos veces. La documentación de Umbrella no lo esconde: «writes smaller than min_alloc_size must first pass through the BlueStore WAL»4.
FlashStore nunca sobrescribe datos vivos en su sitio, y punto7. Los objetos de hasta 2 KiB van más allá y viven enteros en el árbol, así que una escritura de WAL es todo el commit7.
Eso también significa que FlashStore no tiene cola de escrituras diferidas que vaciar, ni replay diferido al montar, ni claves L que limpiar.
Lo paga en otro sitio: los bloques liberados se retienen hasta el siguiente checkpoint, así que el espacio liberado va con hasta un intervalo de checkpoint de retraso7.
Hilos frente a núcleos
La mitad de arriba del OSD difiere igual de mucho.
El ceph-osd de Umbrella es un servidor de hilos clásico, y cada número de la mitad izquierda del diagrama de abajo es uno de sus valores por defecto sobre flash22.
Una operación cruza varios de esos pools por el camino. Comparten estado detrás de locks.
FlashStore mantiene todo el recorrido en un único núcleo fijado que hace polling, desde la tarjeta de red hasta el disco y vuelta23. Cada placement group pertenece exactamente a un núcleo, y también todo lo que toca el PG: «no locks, no atomics, no shared mutable state»24. El tráfico entre núcleos va por anillos de un solo productor, y la propiedad del mensaje viaja con él.
El almacén sigue el mismo reparto.
flashstore_store_shards usa por defecto un shard por núcleo, cada uno con su propio anillo de WAL, árbol y asignador, y un PG vive en exactamente un shard257.
BlueStore es un almacén por OSD con un RocksDB.
Tiene un precio, y el ADR lo dice: «idle cores burn CPU (accepted; optional adaptive sleep later)»23.
Un trabajo posterior añadió reposo adaptativo y esperas temporizadas al dispositivo para que un núcleo no gire durante toda la latencia del dispositivo con poca profundidad de cola8, pero el principio sigue en pie, y flashstore_cores vale 8 por defecto cuando no fijas un rango25.
A FlashStore le das núcleos enteros.
En un nodo de almacenamiento dedicado, no hay problema. En una máquina hiperconvergente donde esos núcleos también corren VM, es la primera cuenta que hay que hacer.
El disco tiene que cumplir su promesa
BlueStore está escrito para apañarse con un disco que miente sobre cuándo están a salvo los datos. FlashStore se niega a tratar con ese disco.
| BlueStore de Umbrella | FlashStore | |
|---|---|---|
| Qué hace duradera una escritura | vaciado del dispositivo de bloques antes del commit de RocksDB | que la escritura termine en un disco con PLP |
| Vaciado en la ruta caliente | sí | no |
| Disco con caché de escritura volátil | se usa, y se vacía | mkfs lo rechaza; comprobación del host FAIL |
| Forzarlo | no hace falta | solo laboratorio: bit FUA en cada escritura duradera |
El lado de BlueStore es el hilo de sincronización kv ya citado16. El lado de FlashStore es el ADR de durabilidad y la comprobación del host: PLP significa que el disco no declara caché de escritura volátil, así que una finalización significa que los datos están en un medio estable2426.
Para su objetivo es la decisión correcta, pero ten claro lo que deja fuera, porque casi todo el NVMe de consumo tiene caché volátil y no tiene PLP, y lo mismo pasa con bastante material «de centro de datos» que se vende por precio. Sin PLP, no hay FlashStore. Pienses lo que pienses de lo demás.
En qué no funciona FlashStore
Pon los requisitos uno al lado del otro y el mercado al que apunta está claro.
| BlueStore de Umbrella | FlashStore | |
|---|---|---|
| Medios | HDD, SSD, NVMe | solo NVMe |
| Protección ante cortes de corriente | no obligatoria | obligatoria, mkfs se niega sin ella |
| Formato de sector | 512 B o 4 KiB | se espera 4 KiB, avisa si no |
| Disposición | particiones, LVM vía ceph-volume | namespaces enteros, sin particiones |
| Dispositivo DB/WAL aparte | soportado | no existe |
| Cifrado en reposo | --dmcrypt vía ceph-volume | fuera de alcance |
| Clientes msgr1 | escucha por defecto | rechazados, solo msgr2 |
| Cache tiering | obsoleto, aún presente | rechazado, el pool pasa a pasivo |
| Requisitos de kernel | cualquiera soportado | io_uring: Linux 5.19+, o el 5.14 de RHEL 9 con backports; hugepages para SPDK |
La columna de BlueStore es de Umbrella: ceph-volume cifra volúmenes lógicos «using dmcrypt by specifying the --dmcrypt flag»27, y ms_bind_msgr1 sigue valiendo true por defecto28.
La columna de FlashStore sale de su referencia de hardware y de su decisión de alcance2629.
Dos de esas filas merecen más que una línea de tabla.
El cifrado en reposo queda fuera, con un motivo: SPDK se salta dm-crypt, y no está previsto cifrar dentro del almacén. La respuesta del ADR son discos NVMe autocifrados, o cifrar por encima del almacén, en el cliente o en RGW29. Si tienes un requisito de cumplimiento que nombra dm-crypt en el OSD, hoy eso te para en seco.
msgr1 queda fuera como riesgo aceptado. Los clientes de kernel anteriores a 5.11 y los librados anteriores a Nautilus no pueden hablar con un OSD FlashStore en absoluto29. La mayoría de las instalaciones hace tiempo que pasaron eso. Algunas no, y es la vieja máquina olvidada del rincón la que se entera.
Le dice al monitor que es BlueStore
Esta es la que va a pillar a la gente.
Por defecto, un OSD FlashStore arranca y les dice a los monitores osd_objectstore=bluestore30.
No se esconde. Añade al lado sus propias claves flashstore_version y flashstore_build30.
El motivo es la compatibilidad: un monitor de Umbrella solo permite funciones como las sobrescrituras EC en un pool cuando todos los OSD del pool declaran BlueStore, y los módulos del manager como Prometheus y telemetry toman decisiones según ese mismo valor30.
El ADR deja claro que bluestore aquí «is a compat value for mon/mgr feature gates, not a product name»30.
Hay un interruptor, flashstore_report_objectstore=flashstore, que lo renombra todo: los metadatos, las claves bluestore_bdev_*, el perf logger, los comandos tell y los códigos de salud BLUESTORE_*. Necesita monitores parcheados, y el valor por defecto sigue siendo bluestore2530.
Las compilaciones de Ceph de la propia croit llevan esos parches, así que en ellas FlashStore se declara flashstore y nada de lo que sigue aplica.
El nombre bluestore está para los monitores y managers estándar que hoy corren en producción.
Entiendo por qué.
Un control del monitor basado en una cadena es diseño de Ceph, no de croit, y negarse a decir bluestore desactivaría funciones en un clúster sin parchear.
Ahí está la trampa en un clúster estándar.
Cada dashboard, cada script de inventario y cada ceph osd count-metadata osd_objectstore que ejecutes contará los OSD FlashStore como BlueStore.
Durante una migración, justo cuando más necesitas saber qué OSD es cuál, el campo obvio no te dice nada.
Así que mira flashstore_version en ceph osd metadata, no osd_objectstore.
Ponlo en tu runbook antes de que entre el primer OSD FlashStore.
Los mismos mandos, otro comportamiento
FlashStore lee muchas de las opciones que Ceph ya tiene, y eso es sobre todo una buena noticia. No todas las opciones significan lo que significaban en Umbrella, y las que no son donde un clúster afinado se lleva la sorpresa.
| Opción | BlueStore de Umbrella | FlashStore |
|---|---|---|
compression_mode, por pool | none, passive, aggressive, force | los mismos cuatro, el mismo significado |
compression_algorithm | snappy por defecto | snappy, zlib, zstd, lz4; nivel de zstd fijo en 1 |
bluestore_compression_max_blob_size_ssd | 64 KiB | trozos de 64 KiB |
osd_memory_target | 4 GiB, cachés autoajustadas en vivo | se lee una vez al arrancar, dimensiona las cachés del almacén, sin autoajuste |
osd_op_queue | mclock_scheduler | aceptada e ignorada |
osd_mclock_* | activas | aceptadas e ignoradas |
csum_type | crc32c por defecto, variantes xxhash disponibles | crc32c fijo; cualquier otro valor deja un aviso en el log31 |
La compresión coincide.
El modo por defecto de BlueStore es none y su algoritmo por defecto es snappy3233; FlashStore implementa los mismos cuatro modos, las mismas opciones de pool y los mismos trozos de 64 KiB, y el ADR señala que un trozo de 64 KiB comprimible al 50% ocupa lo mismo en los dos34.
No siempre iba a estar. El fichero del ADR todavía se llama no-store-compression, por la decisión original, revocada cuando croit fijó como mandato la paridad funcional completa con el Ceph clásico34.
La memoria no tiene paridad.
Umbrella autoajusta las cachés de BlueStore contra osd_memory_target mientras funciona3536.
FlashStore lee el objetivo una vez al arrancar, lo reparte entre sus shards, y un cambio hecho con ceph config set se aplica en el siguiente reinicio37.
Tampoco mantiene el proceso dentro del objetivo: hugepages, buffers de red y estado de los PG quedan fuera37.
Así que osd_memory_target dimensiona las cachés de FlashStore. No limita la memoria del OSD como puede que estés acostumbrado.
Y mClock se ignora sin más37.
No se rebaja. Se ignora.
No hay planificador de operaciones que configurar, porque cada núcleo es dueño de sus PG.
La recuperación y el backfill se frenan en su lugar con osd_max_backfills, osd_recovery_max_active y las opciones de sleep37.
Si afinaste perfiles de mClock para una reconstrucción en Umbrella, esos ajustes no hacen nada en un OSD FlashStore, y nada te va a avisar.
No hay conversión, en ningún sentido
No puedes convertir un OSD BlueStore en uno FlashStore. La guía de migración de croit lo dice claramente: «There is no in-place conversion of a BlueStore device»38. Ofrece dos órdenes en su lugar, y los dos son backfill38:
| Añadir y luego quitar | Liberar y luego añadir | |
|---|---|---|
| Necesita | una ranura NVMe libre | nada libre |
| Paso 1 | preparar FlashStore en el disco nuevo | ceph osd out, esperar a clean |
| Paso 2 | esperar a active+clean | parar y purgar el OSD clásico |
| Paso 3 | quitar el OSD clásico | preparar FlashStore en el disco liberado |
| Riesgo mientras dura | ninguno más allá del backfill normal | una copia menos hasta que acabe el backfill |
Y no se vuelve más fácil después. El formato en disco de FlashStore tiene bits de características, y un montaje rechaza un bit desconocido: «Every format change means mkfs; unknown bits refuse mount (no downgrade)»7. Así que un cambio de formato en una versión posterior de FlashStore es el mismo vaciar y rellenar que la primera migración.
Hay una cosa que la documentación tiene mal.
La lista de comprobación de la guía de migración dice que te asegures de que «the pools do not use erasure coding on croit-flashstore-osd OSDs»38.
La guía de erasure coding de la misma instantánea dice que FlashStore sirve por defecto los pools EC heredados, y el valor por defecto del propio código para EC optimizado es all3940.
Una de las dos está desactualizada, y por el código es la guía de migración.
Aun así me leería entera la guía de EC antes de mezclar pools EC entre los dos tipos de OSD, porque el fallo que describe es un PG que se degrada y un backfill que se atasca39.
Un almacén hecho para los discos que de verdad compramos
BlueStore se hizo para funcionar en todo. Discos que giran, SSD baratos, NVMe, particiones, LVM, volúmenes cifrados, un dispositivo DB rápido delante de un dispositivo de datos lento. Esa amplitud es la razón de que se convirtiera en el predeterminado, y es la razón de que lleve una ruta de escritura diferida, un vaciado antes de cada commit, una base de datos clave/valor sobre un sistema de ficheros propio y un pool de hilos para que todo eso siga moviéndose. Cada una de esas piezas existe porque algún disco en algún sitio la necesitó.
FlashStore empieza por el otro extremo. Da por hecho que el disco es NVMe, que tiene protección ante cortes de corriente y que es lo bastante rápido como para que ahora el cuello de botella sea el software. Luego tira todo lo que solo existía por los otros discos.
¿Es la apuesta correcta? Para clústeres nuevos todo flash, montados con NVMe empresarial de verdad, sí. Ahí es hacia donde van los clústeres Ceph, y un OSD que gasta sus núcleos en locks, traspasos y una base de datos compactando a su espalda está pagando, cada segundo de cada día, por una flexibilidad que un clúster así no va a usar nunca.
Pero la apuesta tiene un coste, y prefiero que lo veas antes de entrar en ella. Renuncias a HDD, dm-crypt, msgr1, el ajuste de memoria en vivo y mClock. En un clúster estándar te llevas un OSD que les dice a tus monitores que es BlueStore, porque los monitores y managers actuales no le dejan otra; las compilaciones de croit no lo necesitarán. Te llevas un formato al que no puedes convertir, y entre cuyas versiones tampoco puedes convertir. Y te lo llevas en vista previa, de un único proveedor, que resulta que me tiene en plantilla.
Así que toma el código fuente como la prueba, no este artículo ni el informe de benchmarks de croit. Los registros de decisiones son públicos y dicen qué se midió y qué se tiró. Léelos, monta un clúster de pruebas con el material que de verdad desplegarías y mide tu propia carga. Si hace en tus discos lo que dicen los ADR, lo sabrás. Si no lo hace, también lo sabrás, y te habrás enterado en un clúster de pruebas.
croit ceph-rust, README en la instantánea 48f9014 — componentes, estado y hoja de ruta, «not yet recommended for production data», compatible en el protocolo con v21.2.0 y v20.2.4. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
ADR 0003, desde cero, sin fork de Crimson — «No fork, no linking of Ceph code»; el código de Ceph se lee como referencia, especificaciones con palabras propias. ↩︎
ADR 0164, licencias — daemon y herramientas LGPL-3.0-only, bibliotecas cliente MPL-2.0, documentación CC-BY-SA-4.0, y el motivo de la MPL. ↩︎ ↩︎
Ceph Umbrella, BlueStore configuration reference — acceso directo al dispositivo, dispositivo DB, «writes smaller than min_alloc_size must first pass through the BlueStore WAL», checksums. ↩︎ ↩︎ ↩︎ ↩︎
Ceph Umbrella, storage devices — BlueStore «consumes raw block devices or partitions»; RocksDB embebido para los metadatos internos. ↩︎ ↩︎
Ceph v21.2.0,
bluestore_kvbackend— por defectorocksdb. ↩︎ ↩︎ADR 0021, motor de almacenamiento — B+tree COW por shard, anillo de WAL, commit en paralelo, checkpoints, datos en línea, liberaciones retenidas, «Every format change means mkfs». ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
ADR 0004, E/S de almacenamiento — SPDK sobre vfio, ampliado a dos niveles con io_uring, reposo temporizado al dispositivo. ↩︎ ↩︎
ceph-rust docs, prepare and activate —
spdkes el backend por defecto,kernelykernel-cmddejan el NVMe en el driver del kernel. ↩︎Ceph v21.2.0,
bluestore_allocator— por defectohybrid. ↩︎Ceph v21.2.0,
bluestore_csum_type— por defectocrc32c. ↩︎ceph-rust, uso de croit-flashstore-tool — «fresh prepare/mkfs –omap-engine btree|lsm|rocksdb». ↩︎
Ceph v21.2.0,
bluestore_min_alloc_size_ssd— por defecto 4 KiB. ↩︎Ceph v21.2.0,
bluestore_prefer_deferred_size_ssd— por defecto 0. ↩︎Ceph v21.2.0,
BlueStore.cc, máquina de estados de la transacción — las aios pendientes llevan la transacción aSTATE_AIO_WAITantes de encolarla para el commit clave/valor. ↩︎Ceph v21.2.0,
BlueStore.cc, hilo kv sync — «flush/barrier on block device» antes del submit a RocksDB. ↩︎ ↩︎ADR 0027, commit atómico de una sola E/S, rechazado — «gain only at QD1», construido y retirado. ↩︎
Ceph v21.2.0,
bluestore_write_v2— «Use faster write path», por defecto false. ↩︎Ceph v21.2.0,
BlueStore.cc,_do_write_small— lectura de cabeza y cola, luego «chunk-aligned deferred overwrite». ↩︎Ceph v21.2.0,
BlueStore.cc, «journal deferred items» — la transacción diferida se guarda como clave en la misma transacción de RocksDB. ↩︎Ceph v21.2.0,
BlueStore.cc, prefijos de clave —PREFIX_DEFERRED = "L". ↩︎Valores por defecto de hilos en Ceph v21.2.0 —
osd_op_num_shards_ssd8;osd_op_num_threads_per_shard_ssd2;osd_op_queuemclock_scheduler;ms_async_op_threads3; creación de hilos enBlueStore.cc,bstore_kv_syncybstore_kv_final. ↩︎ADR 0006, runtime de un hilo por núcleo — un hilo fijado con busy-polling por núcleo, PG propiedad de un núcleo, «idle cores burn CPU (accepted …)». ↩︎ ↩︎
ADR 0008, concurrencia y durabilidad — «no locks, no atomics, no shared mutable state»; PLP obligatorio,
mkfsrechaza discos sin PLP, FUA forzado para laboratorio. ↩︎ ↩︎ceph-rust docs, referencia de configuración —
flashstore_corespor defecto 8,flashstore_store_shardsauto,flashstore_report_objectstore. ↩︎ ↩︎ ↩︎ceph-rust docs, requisitos de hardware y del host — caché de escritura volátil FAIL, LBA de 4 KiB, sin particiones, requisitos de kernel e io_uring. ↩︎ ↩︎
Ceph Umbrella, cifrado en ceph-volume — «Logical volumes can be encrypted using dmcrypt by specifying the
--dmcryptflag». ↩︎Ceph v21.2.0,
ms_bind_msgr1— por defecto true. ↩︎ADR 0168, cifrado en reposo, msgr1 y cache tiering fuera de alcance — «SPDK bypasses dm-crypt»; los clientes solo v1 «cannot reach croit-flashstore-osd». ↩︎ ↩︎ ↩︎
ADR 0019, declarar
osd_objectstore=bluestore— los controles de funciones del monitor, las clavesflashstore_*adicionales y la opción de declararseflashstore. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ceph-rust,
pgs.rs— «csum_type {v} unsupported; using fixed crc32c per 4096-byte block». ↩︎Ceph v21.2.0,
bluestore_compression_mode— por defectonone. ↩︎Ceph v21.2.0,
bluestore_compression_algorithm— por defectosnappy. ↩︎ADR 0059, compresión del almacén por pool — los mismos modos y opciones que BlueStore, nivel 1 de zstd fijo, espacio con 50% comprimible «identical to BlueStore». ↩︎ ↩︎
Ceph v21.2.0,
osd_memory_target— por defecto 4 GiB. ↩︎Ceph v21.2.0,
bluestore_cache_autotune— por defecto true. ↩︎ADR 0062, objetivo de memoria y mClock — objetivo leído una vez, sin autoajuste, RSS no limitado; opciones de mClock «ACCEPTED and IGNORED». ↩︎ ↩︎ ↩︎ ↩︎
ceph-rust docs, migrar desde el clásico — «There is no in-place conversion of a BlueStore device»; los dos órdenes; la línea de EC de la lista de comprobación. ↩︎ ↩︎ ↩︎
ceph-rust docs, pools con erasure coding —
ec_enable_poolspor defectoall,ec_enable_optimizedpor defectoall, y cómo se ve un pool rechazado. ↩︎ ↩︎ceph-rust, valores por defecto de configuración del OSD —
("ec_enable_optimized", "all"). ↩︎