El host existe esta vez. Solo que está en el hipervisor equivocado
La última vez el problema era que la máquina nombrada en el inventario aún no existía — sin IP, sin SSH, sin Python, nada a lo que conectarse. Cada tarea tenía que delegarse lejos de ella.
Una migración de VMware invierte eso y no cambia nada. La máquina existe, está en marcha, la gente la está usando. Aun así nunca te conectas a ella. Es un nombre y una bolsa de variables que describen algo que reconstruir en otro sitio. Cada tarea sigue corriendo en el nodo de control, y ahora hay dos API al otro extremo en vez de una.
Una nota sobre lo que es esto. Este artículo es el diseño y el playbook, no una batallita. Todavía no lo he corrido contra un parque de producción de principio a fin. Todo lo que digo abajo sobre el comportamiento de los módulos lo leí en el código entregado y lo comprobé, y he dicho claramente dónde una afirmación viene del código en vez de de una ejecución. Cuando haya hecho una migración de verdad con él, los números y las sorpresas tendrán su propio artículo.
Versiones contra las que se comprobó esto:
$ ansible --version | head -1
ansible [core 2.20.7]

$ ansible-galaxy collection list | grep -E 'vmware|proxmox'
community.proxmox 1.6.0
community.vmware  6.2.1
vmware.vmware     2.9.0
Los fragmentos de abajo están recortados de un solo playbook — migrate.yml, un inventario dinámico
de vSphere en inventory/vmware.vms.yml, y un group_vars/all.yml. He
generizado los nombres de datacenter, nodo y almacenamiento por legibilidad.
La forma del trabajo
Cinco pasos, y solo el último cuesta algo.
El orden es todo el diseño. El descubrimiento no cambia nada. Construir la red cambia solo Proxmox. Construir las carcasas cambia solo Proxmox, y una carcasa sin disco es barata de borrar. Mover los discos es lento pero en vivo. Solo el último play apaga algo.
Vete a la mitad y cada invitado sigue corriendo en VMware, intacto.
Dos colecciones, y una de ellas se está retirando
Necesitas las dos, y no por la razón que adivinarías.
collections:
  - name: community.vmware
    version: ">=6.2.1"
  - name: vmware.vmware
    version: ">=2.5.0"
  - name: community.proxmox
    version: ">=1.6.0"
community.vmware es la colección vieja y amplia y se está desmontando. Su MANIFEST.json declara {"vmware.vmware": ">=2.5.0"} como dependencia dura, así que instalar la primera arrastra la segunda, la pidieras o no. Los módulos se están mudando de uno en uno, y los que echas mano en una migración están en distintas etapas de esa mudanza:
vmware_dvs_portgroup_info— todavía solo encommunity.vmware, y es lo que lee tus VLAN.vmware_vmotion— todavía solo encommunity.vmware.vmware_guest_powerstate— obsoleto, eliminado encommunity.vmware7.0.0. Usavmware.vmware.vm_powerstate.vmware_vm_inventory— obsoleto, eliminado en 7.0.0. Usavmware.vmware.vms.
Ansible te avisa de las obsolescencias de módulos en la primera pasada, lo que es decente por su parte:
[DEPRECATION WARNING]: community.vmware.vmware_guest_powerstate has been deprecated.
Use vmware.vmware.vm_powerstate instead. This feature will be removed from
collection 'community.vmware' version 7.0.0.
No te avisa del plugin de inventario, porque los plugins de inventario se analizan antes de que esa maquinaria esté corriendo. Tienes que ir a leer el plugin.
Hay una tercera trampa en la división. vmware.vmware.vm_portgroup_info parece exactamente lo que una migración de red quiere — por VM, por NIC, te da el portgroup y la VLAN. Pero está construido sobre ModuleRestBase e importa com.vmware.vapi, lo que significa que necesita el SDK de vSphere Automation en el nodo de control, no solo pyVmomi. Su retorno documentado también está rancio: el bloque RETURN promete name y vlan_id, mientras que el código de verdad construye portgroup_name y un dict vlan_info para el caso distribuido. Fui por otro camino, abajo, y no necesité ninguno.
El inventario es el descubrimiento
No hay un play de «ir a buscar las VM» en este playbook, porque para cuando la primera tarea corre el inventario ya lo ha hecho — en una consulta del colector de propiedades en vez de un bucle por VM.
# inventory/vmware.vms.yml
plugin: vmware.vmware.vms

hostname: "{{ lookup('ansible.builtin.env', 'VMWARE_HOST') }}"
username: "{{ lookup('ansible.builtin.env', 'VMWARE_USER') }}"
password: "{{ lookup('ansible.builtin.env', 'VMWARE_PASSWORD') }}"
validate_certs: false

search_paths:
  - /Datacenter-1

properties:
  - name
  - config.name
  - config.uuid
  - config.guestId
  - config.firmware
  - config.template
  - config.hardware.numCPU
  - config.hardware.numCoresPerSocket
  - config.hardware.memoryMB
  - config.hardware.device
  - summary.runtime.powerState

gather_compute_objects: true
hostnames: ['name']
filter_expressions:
  - 'config.template'
El nombre del fichero importa. El verify_file del plugin solo reclama ficheros que terminan en vms.yml, vms.yaml, vmware_vms.yml o vmware_vms.yaml. Llámalo vcenter.yml y silenciosamente no es tu inventario.
search_paths filtra antes de la consulta, no después. En un parque grande eso es la diferencia entre segundos y minutos — a diferencia de filter_expressions, sobre el que la documentación es explícita: corre después de la recogida y «does not affect the speed of the inventory plugin» — no afecta a la velocidad del plugin de inventario.
filter_expressions descarta un host cuando la expresión es verdadera. config.template por tanto quita las plantillas, lo que se lee al revés la primera vez.
Y la línea importante es config.hardware.device, que no está en ninguna lista de propiedades por defecto en ningún sitio. Es todo el inventario de hardware de la VM, y lleva tres cosas sin las que esta migración no puede avanzar: la MAC de cada NIC, la clave de dvportgroup a la que cada NIC está adjuntada, y la ruta de datastore de cada disco. Sin ella vuelves a un bucle vmware_guest_info, un viaje de ida y vuelta por VM.
Los dispositivos vuelven como JSON con su tipo de vSphere preservado en _vimtype. Eso vale la pena saberlo porque es cómo distingues una NIC de un disco. Comprobé el codificador en vez de adivinar:
{
  "_vimtype": "vim.vm.device.VirtualVmxnet3",
  "macAddress": "00:50:56:87:a5:9a",
  "backing": {
    "_vimtype": "...DistributedVirtualPortBackingInfo",
    "port": {
      "_vimtype": "vim.dvs.PortConnection",
      "portgroupKey": "dvportgroup-1014"
    }
  }
}
Así que un bloque compose puede subir las rutas incómodas a hostvars planos:
compose:
  vm_moid: moid
  vm_firmware: config.firmware
  vm_memory_mb: config.hardware.memoryMB
  vm_num_cpu: config.hardware.numCPU

  # A virtual NIC is any device with a MAC. Filtering on _vimtype does not
  # work cleanly here, because VMXNET3, E1000 and SR-IOV cards are all
  # different types with no shared substring.
  vm_nics: >-
    config.hardware.device
    | selectattr('macAddress', 'defined')
    | selectattr('macAddress', 'ne', None) | list

  # Disks are one exact type, so this one can match on it.
  vm_disks: >-
    config.hardware.device
    | selectattr('_vimtype', 'eq', 'vim.vm.device.VirtualDisk') | list
Esa asimetría es real y pilla a la gente. No hay un tipo VirtualEthernetCard con el que casar. Esa es la clase base abstracta, y lo que vCenter de verdad te entrega es VirtualVmxnet3, VirtualE1000, VirtualE1000e, VirtualPCNet32 o VirtualSriovEthernetCard. No hay subcadena común a todos ellos. Tener una MAC, en cambio, es una cosa que solo hace una NIC.
Cada módulo de info esconde el campo que necesitas
Este es el hilo conductor de todo el trabajo, y una vez que lo has visto tres veces empiezas a comprobar cada valor por defecto antes de escribir la tarea.
vmware_dvs_portgroup_info tiene seis opciones show_*. Cinco por defecto son true. La sexta es show_vlan_info, y por defecto es false.
show_mac_learning=dict(type='bool', default=True),
show_network_policy=dict(type='bool', default=True),
show_teaming_policy=dict(type='bool', default=True),
show_uplinks=dict(type='bool', default=True),
show_port_policy=dict(type='bool', default=True),
show_vlan_info=dict(type='bool', default=False),
Déjalo en paz y obtienes la política de MAC learning, la política de teaming, el orden de uplinks y la política de puertos de cada portgroup del parque. Todo excepto la etiqueta de VLAN, que es el único campo que una migración de red de verdad está preguntando. Así que la tarea está del revés de lo que escribirías por instinto: enciende la única cosa, apaga las otras cinco.
- name: Read the distributed portgroups
  community.vmware.vmware_dvs_portgroup_info:
    datacenter: "{{ vcenter_datacenter }}"
    show_vlan_info: true
    show_network_policy: false
    show_teaming_policy: false
    show_port_policy: false
    show_mac_learning: false
    show_uplinks: false
  register: dvs_pgs
No es algo de una vez. vmware.vmware.vms tiene gather_compute_objects, que rellena cluster y esxi_host — por defecto false. community.vmware.vmware_vm_info tiene show_allocated, que es el bloque que contiene la CPU y la memoria — por defecto false. En los tres casos el campo caro de recoger es el que la migración necesita, y el valor por defecto protege un caso de uso de informe de solo lectura que no es el que tienes entre manos.
vlan_id son tres tipos distintos
Luego obtienes las etiquetas de VLAN y encuentras que no son una sola forma. Directo de get_vlan_info:
if isinstance(vlan_obj, vim...TrunkVlanSpec):
    ...
    return dict(trunk=True, pvlan=False, vlan_id=vlan_id_list)
elif isinstance(vlan_obj, vim...PvlanSpec):
    return dict(trunk=False, pvlan=True, vlan_id=str(vlan_obj.pvlanId))
else:
    return dict(trunk=False, pvlan=False, vlan_id=str(vlan_obj.vlanId))
Un portgroup de acceso te da la cadena "100". Un PVLAN te da una cadena. Un trunk te da una lista de cadenas, cada una o "20" o "20-30". Y cada switch distribuido tiene al menos un trunk en él lo hicieras o no, porque el portgroup de uplink es un trunk que lleva "0-4094".
Así que | int no está disponible para ti hasta que hayas tirado las otras dos formas:
access_pgs: >-
  {{ dvs_pgs.dvs_portgroup_info | dict2items | map(attribute='value') | flatten
     | rejectattr('vlan_info.trunk') | rejectattr('vlan_info.pvlan')
     | rejectattr('vlan_info.vlan_id', 'in', ['0', 0])
     | list }}
Tres rechazos, en ese orden. Los trunks fuera, los PVLAN fuera, y luego los portgroups sin etiqueta fuera, lo que también se deshace de los grupos de uplink y de cualquier cosa en la VLAN 0.
No estoy traduciendo trunks ni PVLAN automáticamente y le replicaría a cualquiera que lo hiciera. Un trunk de VMware aterrizando en Proxmox necesita o una zona Q-in-Q o un VNet consciente de VLAN, y cuál es el correcto depende de lo que el invitado espere ver. Eso es una decisión, no un mapeo. El playbook los imprime y sigue:
TASK [Report what was found]
ok: [localhost] => {
    "msg": "3 access portgroups -> [100, 200]. Not translated:
            ['dvs_001-uplink'] (trunks), ['isolated'] (PVLANs)."
}
Reflejar las VLAN en el SDN
Una zona de VLAN vinculada a un puente, luego un VNet por VLAN con la etiqueta puesta.
- name: Create the VLAN zone
  community.proxmox.proxmox_zone:
    zone: "{{ sdn_zone }}"
    type: vlan
    bridge: "{{ sdn_bridge }}"
    mtu: "{{ sdn_mtu }}"
    state: present

- name: Create one VNet per VMware VLAN
  community.proxmox.proxmox_vnet:
    vnet: "{{ sdn_vnet_prefix }}{{ item.vlan_info.vlan_id | int }}"
    zone: "{{ sdn_zone }}"
    tag: "{{ item.vlan_info.vlan_id | int }}"
    alias: "{{ item.portgroup_name }}"
    state: present
  loop: "{{ access_pgs | unique(attribute='vlan_info.vlan_id') }}"
  throttle: 1
Los nombres de VNet son cortos y restringidos, y los nombres de portgroup de VMware no. Production-Web-Tier-VLAN100 es un nombre de portgroup perfectamente ordinario y un nombre de VNet imposible. Así que el nombre se genera — v100, a partir de la etiqueta — y el original legible por humanos va en alias, donde se queda visible en la UI y en la salida de pvesh. Derivar el nombre de la VLAN en vez del portgroup también significa que el mapeo es reversible por inspección seis meses después.
Dos portgroups en la misma VLAN colapsan en un VNet. Eso es correcto — eran el mismo dominio de difusión en VMware también — pero deberías verlo pasar, que es lo que unique(attribute='vlan_info.vlan_id') está haciendo. Dos portgroups llamados prod-web y prod-web-b, ambos en la VLAN 100, producen un v100.
throttle: 1 no es cautela, es el módulo. Cada escritura de SDN en community.proxmox toma un bloqueo de clúster global, aplica la configuración pendiente y lo libera — get_global_sdn_lock(), luego apply_sdn_changes_and_release_lock(). Córrelas en paralelo y hacen cola en el bloqueo de todos modos; el throttle solo te impide fingir lo contrario. Vale la pena saber también que la reversión en caso de fallo depende de la versión — el módulo comprueba is_lock_and_rollback_supported y, en PVE más viejo, te dice que no pudo revertir en vez de hacerlo.
Una cosa cosmética que te hará dudar de ti mismo. En 1.6.0 proxmox_vnet emite su dict de params entero como una advertencia de Ansible en cada creación:
self.module.warn(f"{vnet_params}")
self.proxmox_api.cluster().sdn().vnets().post(**vnet_params)
Esa es una línea de depuración que alguien dejó dentro. Es ruido, no un fallo.
Construye las carcasas, sin discos
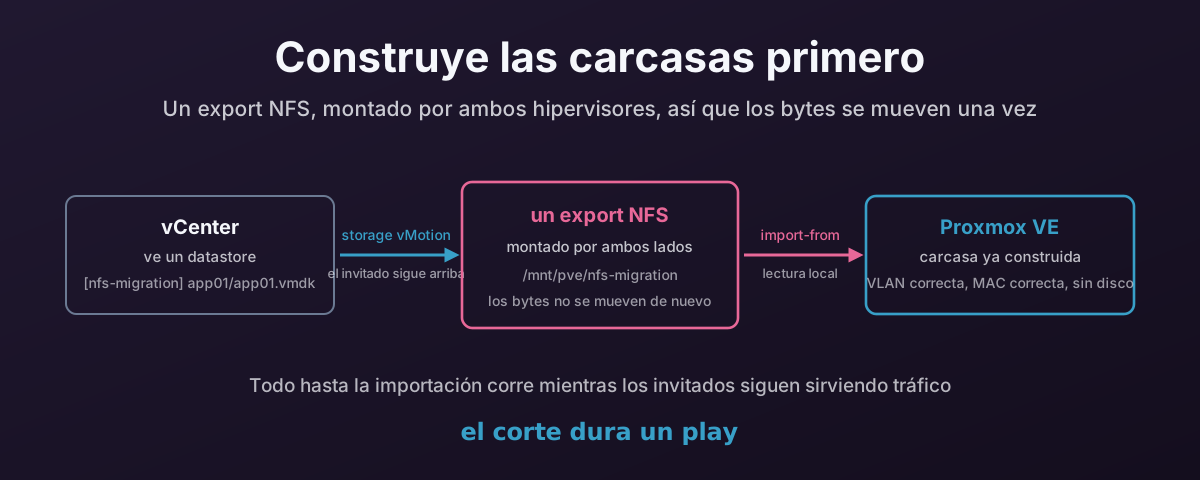
Ahora las VM, y aquí es donde el diseño se gana a sí mismo. Cada VM se construye en Proxmox con el número correcto de CPU, la memoria correcta, el firmware correcto y las NIC correctas en las VLAN correctas. Sin discos en absoluto.
Una carcasa sin disco es rápida de crear, gratis de borrar, y arranca a un prompt PXE si alguien la enciende por accidente. Puedes construir cuatrocientas en una tarde, mirar el resultado, decidir que está mal, borrar el lote y hacerlo de nuevo. Nada se ha copiado, nada se ha apagado, y nadie se ha enterado.
Los valores derivados son declaraciones, no tareas. Ansible los evalúa de forma perezosa contra el host que esté en alcance, así que cada VM obtiene el suyo sin un solo set_fact:
# group_vars/all.yml
pve_vmid: "{{ vmid_base | int + (vm_moid | regex_replace('^vm-', '') | int) }}"
pve_bios: "{{ 'ovmf' if vm_firmware == 'efi' else 'seabios' }}"
pve_cores: "{{ vm_cores_per_socket | int }}"
pve_sockets: "{{ ((vm_num_cpu | int) / (vm_cores_per_socket | int)) | round(0, 'ceil') | int }}"
El VMID viene del MoID de vCenter. vm-42 se convierte en 20042. Eso importa más de lo que parece: el play de conmutación tiene que encontrar la VM que el play de construcción creó, y una nueva ejecución debe aterrizar en la misma en vez de construir en silencio una segunda. Dejar que la API asigne el siguiente ID libre — que es lo que pasa si omites vmid, y sobre lo que escribí la última vez — hace eso imposible.
La memoria no necesita conversión. VMware reporta config.hardware.memoryMB y Proxmox quiere MB. Los sockets sí: VMware te da vCPU totales y núcleos por socket, Proxmox quiere sockets y núcleos.
- name: Create the VM shell
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    name: "{{ inventory_hostname }}"
    cores: "{{ pve_cores }}"
    sockets: "{{ pve_sockets }}"
    memory: "{{ vm_memory_mb }}"
    ostype: "{{ pve_ostype }}"
    bios: "{{ pve_bios }}"
    scsihw: "{{ default_scsihw }}"
    efidisk0: "{{ {'storage': pve_target_storage, 'efitype': '4m',
                   'pre_enrolled_keys': false}
                  if pve_bios == 'ovmf' else omit }}"
    agent: "enabled=1"
    onboot: false
    state: present
onboot: false a propósito. Nada debería arrancar por sí solo en medio de una migración, y menos que nada una máquina cuyos discos todavía está escribiendo otro hipervisor.
El firmware no es opcional acertarlo. Un invitado UEFI importado a una VM SeaBIOS importará perfectamente y luego se negará a arrancar, y te pasarás una hora con ello. config.firmware es efi o bios y mapea directo a ovmf y seabios. Un invitado UEFI también necesita un disco de vars EFI, que hay que crear con la VM — mira abajo por qué.
proxmox_kvm no arreglará una NIC, y no te lo dirá
La última vez escribí que proxmox_kvm se niega a converger en vez de actualizar. Aquí está la versión más afilada de eso, que me mordió mientras escribía esto y vale la pena ser exacto al respecto.
update por defecto es false, así que volver a correr contra una VM que ya existe no hace nada. Bien, y documentado. Pero pon update: true y el módulo todavía se niega a tocar algunos parámetros:
# If update, don't update disk (virtio, efidisk0, tpmstate0, ide, sata, scsi)
# and network interface, unless update_unsafe=True
if update_unsafe is False:
    ...
    if "efidisk0" in kwargs:
        del kwargs["efidisk0"]
Los borra de la petición y sigue. Así que corriges una NIC en tu mapeo de inventario, vuelves a correr con update: true, ves a Ansible reportar changed, y la NIC está exactamente tan mal como estaba. El changed es verdadero — algo más en la carga se actualizó — pero no la cosa que estabas arreglando.
update_unsafe: true levanta la restricción, y el nombre es honesto. La misma protección cubre los discos, así que en una VM que tiene discos, una actualización insegura es una buena manera de adquirir una segunda copia de uno. Ese no es un interruptor al que echar mano durante una migración.
La salida es no usar net en absoluto. Las NIC se ponen con proxmox_nic, que es un módulo cuyo trabajo entero es una interfaz y que converge como es debido:
- name: Attach each NIC to its VNet
  delegate_to: localhost
  community.proxmox.proxmox_nic:
    vmid: "{{ pve_vmid }}"
    interface: "net{{ idx }}"
    bridge: "{{ sdn_vnet_prefix }}{{ pg_vlan[item.backing.port.portgroupKey] }}"
    mac: "{{ item.macAddress }}"
    model: "{{ default_net_model }}"
    state: present
  loop: "{{ vm_nics }}"
  loop_control:
    index_var: idx
Ese es el mismo reparto al que acabé llegando la última vez: proxmox_kvm para definir la máquina, proxmox_disk y proxmox_nic para las cosas que cambian después. El parámetro es mac, no mac_addr.
efidisk0 no se puede sacar del mismo modo — proxmox_disk no tiene efitype ni pre_enrolled_keys — así que tiene que ponerse en el momento de crear y estar bien a la primera.
Lleva la MAC contigo. VMware reparte MAC de 00:50:56:... y Proxmox las tomará sin queja. Mantenerlas significa que las reservas de DHCP siguen casando, las licencias atadas a MAC siguen validando, y cualquier regla de cortafuegos escrita contra una MAC sigue disparando. Cambiarlas significa un día de pequeños misterios. proxmox_nic también acepta model: vmxnet3 si necesitas que el invitado vea la misma NIC que veía antes, pero en KVM, virtio es la mejor tarjeta, y un invitado Windows va a querer drivers nuevos de todos modos.
Negarse en vez de adivinar
Una NIC en un portgroup estándar no tiene backing.port en absoluto. Su backing es un NetworkBackingInfo con un deviceName. No estará en el mapa, y lo correcto que hacer es parar:
- name: Every NIC must sit on a distributed portgroup with a VNet
  ansible.builtin.assert:
    that:
      - vm_nics | rejectattr('backing.port.portgroupKey', 'defined') | list | length == 0
      - vm_nics | map(attribute='backing.port.portgroupKey')
          | reject('in', pg_vlan.keys() | list) | list | length == 0
    fail_msg: >-
      {{ inventory_hostname }} has NICs that do not map to a Proxmox VNet.
      Attaching it to the wrong network is worse than not building it.
Dos condiciones en vez de una, porque la primera tiene que correr antes que la segunda: map(attribute=...) sobre una NIC sin port explotaría en la búsqueda indefinida. Rechaza las sin forma primero, luego comprueba el resto contra el mapa.
Un export, montado dos veces
Aquí está la parte que hace toda la cosa barata.
Pon un export NFS donde ambos hipervisores puedan montarlo. vCenter ve un datastore llamado nfs-migration; los nodos de Proxmox montan el mismo export y ven /mnt/pve/nfs-migration. Ahora haz storage-vMotion de los VMDK sobre él.
Storage vMotion es en vivo. El invitado sigue sirviendo tráfico todo el tiempo. Nada se conmuta, no hace falta ventana, y se puede abandonar a la mitad sin consecuencia más allá de la E/S desperdiciada. Es la etapa más lenta con diferencia y no cuesta nada.
- name: Relocate to the NFS datastore
  delegate_to: localhost
  throttle: 2
  community.vmware.vmware_vmotion:
    moid: "{{ vm_moid }}"
    destination_datastore: "{{ nfs_datastore_vmware }}"
    timeout: "{{ vmotion_timeout }}"
timeout por defecto es 3600 — una hora. Un VMDK de 2 TB no lo logrará, y el modo de fallo es feo de una manera callada: la tarea de Ansible falla mientras el vMotion sigue corriendo en vCenter. Ahora tienes un playbook que dice que falló y un parque que sigue ocupado. Ponlo a algo que refleje tu almacenamiento real.
throttle: 2, porque el cuello de botella no es el nodo de control. Storage vMotion está acotado por la cabina y la red. Seis a la vez no te da seis veces el caudal; te da seis migraciones lentas y un equipo de almacenamiento enfadado.
El módulo es idempotente de la manera que quieres — pone storage_vmotion_needed = False si la VM ya está en el datastore de destino — así que volver a correr para recoger rezagados es seguro.
Para cuando esto termina, los bytes están sentados en un almacenamiento que Proxmox ya monta. Como tal, nada más necesita copiarlos. Nunca.
La conmutación
Este es el único play que cuesta tiempo de inactividad, y el orden dentro de él no es negociable.
Primero, un problema fácil de pasar por alto: el inventario ahora está rancio. Se recogió antes del vMotion, así que vm_disks todavía tiene las rutas de datastore viejas. Importa desde esas y estás apuntando Proxmox a una ruta que no puede ver.
- name: Re-read the inventory now the disks have moved
  ansible.builtin.meta: refresh_inventory
Que es también por lo que el caché está apagado en la configuración del inventario. Un caché caliente le devolvería a refresh_inventory exactamente los datos rancios que se le llamó a reemplazar. Eso es un compromiso real — vCenter no es rápido — pero una ruta equivocada aquí es una conmutación fallida en una ventana, y el viaje de ida y vuelta es barato en comparación.
Luego apaga. Importar un VMDK que un host ESXi todavía tiene abierto te da una copia consistente por caída en el mejor caso:
- name: Shut the guest down in VMware
  delegate_to: localhost
  vmware.vmware.vm_powerstate:
    moid: "{{ vm_moid }}"
    state: "{{ 'shutdown-guest' if vm_power_state == 'poweredOn' else 'powered-off' }}"
    timeout: 600
    force: true
shutdown-guest es un apagado elegante a través de VMware Tools; force: true para en duro cualquier cosa que no se vaya dentro del timeout. En el módulo nuevo el parámetro es timeout, no state_change_timeout como era en el obsoleto.
Luego la importación, que es el pivote:
- name: Import each VMDK onto its VM
  delegate_to: localhost
  throttle: 2
  community.proxmox.proxmox_disk:
    vmid: "{{ pve_vmid }}"
    disk: "scsi{{ idx }}"
    storage: "{{ pve_target_storage }}"
    import_from: >-
      {{ item.backing.fileName
         | regex_replace('^\[[^\]]+\]\s*', '/mnt/pve/' ~ nfs_storage_pve ~ '/') }}
    format: "{{ pve_target_format }}"
    timeout: "{{ import_timeout }}"
    create: regular
    state: present
  loop: "{{ vm_disks }}"
  loop_control:
    index_var: idx
El regex_replace está haciendo la traducción entre los dos mundos. vCenter nombra un disco [nfs-migration] app01/app01.vmdk; Proxmox alcanza el mismo fichero en /mnt/pve/nfs-migration/app01/app01.vmdk. Mismo export, mismos bytes, sin segunda copia. Te quedas el descriptor .vmdk e ignoras el -flat.vmdk que hay a su lado — qemu-img lee el descriptor y lo sigue hasta el extent.
Tres cosas sobre import_from que están todas en el módulo y todas valen la pena conocerlas antes de que la ventana se abra.
Solo se dispara al crear. En la rama de actualización:
# 'import_from' fails on disk updates
playbook_config = self.get_create_attributes()
playbook_config.pop("import_from", None)
Si scsi0 ya existe en esa VM, el parámetro se descarta y obtienes una actualización ordinaria. Así que volver a correr tras una importación mala no reimporta. Silenciosamente no hace nada en absoluto y reporta éxito. Si una importación va mal, borra el disco antes de intentarlo de nuevo.
timeout por defecto es 600 segundos. Diez minutos, para importar y convertir el disco de una máquina virtual. La propia documentación del módulo dice que lo subas; sigue el consejo.
Y una ruta absoluta necesita root. La documentación es tajante al respecto:
<STORAGE>:<VMID>/<FULL_NAME>or<ABSOLUTE_PATH>/<FULL_NAME>.<STORAGE>:import/<FULL_NAME>for PVE 9.x and later, to use storage’s import directory. Attention! Only root can use absolute paths.
Lo que aterriza incómodo contra el consejo que di la última vez, y que sigo defendiendo: usa un token de API acotado, no root. Ese consejo se mantiene para cada otra etapa aquí: el descubrimiento, el SDN, construir carcasas, poner el orden de arranque, todo funciona bien con un token. Esta única tarea no, y ninguna cantidad de privilegio en el rol lo cambiará, porque la restricción está en que el usuario sea root en vez de en un permiso.
Hay tres salidas honestas, y ninguna cuarta ingeniosa:
- PVE 9.x: usa
<storage>:import/<file>y quédate en el token. - PVE 8.x: haz esta única tarea como
root@pam, y solo esta. - PVE 8.x, sin root sobre la API: corre
qm importdisksobre SSH en su lugar.
El playbook toma las dos primeras vía un flag, porque fingir lo contrario solo movería el problema a quien lo corra.
Finalmente el orden de arranque, que es una actualización ordinaria y por tanto intacto por la restricción de update_unsafe:
- name: Boot from the first imported disk
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    boot: "order=scsi0"
    update: true
Nada arranca el invitado. Eso es deliberado. Arráncalo a mano, míralo levantarse, y solo entonces piensa en borrar cualquier cosa en VMware.
Correrlo
Toda la cosa es un solo playbook, etiquetado por etapa, porque estos no son pasos que quieras correr juntos:
ansible-playbook migrate.yml --tags discover   # look, change nothing
ansible-playbook migrate.yml --tags sdn        # build the VLANs
ansible-playbook migrate.yml --tags build      # build the diskless shells
ansible-playbook migrate.yml --tags relocate   # storage vMotion, live
ansible-playbook migrate.yml --tags cutover    # power off and import
--limit es tu amigo de principio a fin. Haz una VM primero. Haz un clúster. El playbook no tiene opinión sobre cuánto muerdes, y el inventario te da grupos gratis — power_poweredOn, cluster_<name>, más vmware_windows y vmware_linux del bloque groups.
Comprueba a qué estás apuntando antes de apuntar a ello:
ansible-inventory --graph
ansible-inventory --host some-vm
Lo que aún vigilaría
Cosas que espero encontrar cuando esto se tope con un parque real, escritas ahora para que no pueda afirmar después que las vi venir:
- Los invitados Windows no arrancarán limpiamente desde una controladora VirtIO SCSI sin que el driver esté presente primero.
virtio-scsi-singlees la controladora correcta y la equivocada que entregar a una VM de Windows que nunca la ha visto. Ese es todo un problema por sí mismo y no lo resuelve nada de lo de arriba. - VMware Tools debería quitarse antes de la mudanza, no después.
- Instantáneas. Una VM con una cadena de instantáneas tiene más de un
.vmdkpor disco e importar la base te da el estado anterior a la instantánea. Consolida primero. - El orden de
config.hardware.devicees lo que decide qué disco se convierte enscsi0. Ha casado con el propio orden del invitado en todas partes donde he mirado, pero lo comprobaría en un servidor de base de datos de varios discos antes de fiarme de ello en una ventana. - Los discos independientes y RDM no harán storage-vMotion como los ordinarios.
Nada de eso cambia la forma. Construye las carcasas primero, mueve los discos mientras todo sigue en marcha, y mantén el corte al único play que lo necesita.