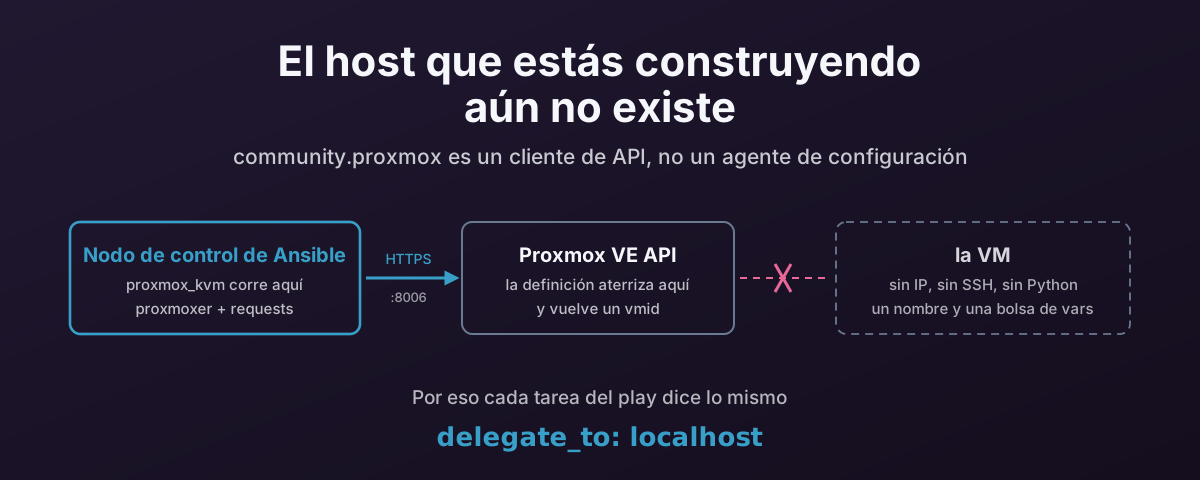
La suposición que Ansible suele poder hacer
Casi todos los módulos de Ansible que has usado funcionan así: Ansible se conecta al host nombrado en el inventario, le copia un pequeño programa Python, lo corre, y lee de vuelta el resultado. El host es la cosa que se cambia y la cosa que hace el trabajo.
Crear una máquina virtual rompe eso de la manera más básica posible. El host que estás construyendo no existe. No tiene IP, ni demonio SSH, ni Python, ni sistema operativo. No hay nada a lo que conectarse.
Así que community.proxmox no es un agente de configuración. Es un cliente de API que resulta que se entrega como una colección de Ansible. Como tal, todo en este artículo se sigue de ese único hecho — dónde corren las tareas, cómo metes las credenciales, por qué volver a correr no hace lo que esperas, y por qué --check no te está diciendo la verdad.
Los ejemplos de aquí están recortados de un playbook que construye VM de Windows y Linux a partir de registros de NetBox: proxmox-create-vms.yml. He generizado los nombres de nodo, almacenamiento y puente por legibilidad — lo de verdad está en ese repositorio.
Todo lo que afirmo sobre el comportamiento de los módulos abajo se comprobó contra community.proxmox 1.6.0, que es la versión que tengo instalada:
$ ansible-galaxy collection list community.proxmox
# /home/damien/.ansible/collections/ansible_collections
Collection        Version
----------------- -------
community.proxmox 1.6.0
Primero: la colección se mudó
Si estás leyendo un playbook más viejo o una respuesta más vieja, los módulos se llamaban community.general.proxmox_kvm. Ahora viven en una colección dedicada, y ahí es donde está pasando el desarrollo. La versión 1.6.0 entrega 47 módulos, cubriendo Ceph, SDN, cortafuegos, reglas de HA y unión al clúster, nada de lo cual existía en la era de community.general.
ansible-galaxy collection install community.proxmox
pip install 'proxmoxer>=2.0' requests
La dependencia de Python no es opcional y no viene empaquetada: la colección declara requirements: ["proxmoxer >= 2.0", "requests"], y esos hay que instalarlos donde el módulo de verdad se ejecuta — que, como explica la siguiente sección, no es el nodo de Proxmox.
requirements.yml, si prefieres fijarlo:
---
collections:
  - name: community.proxmox
    version: ">=1.6.0"
La colección se prueba contra ansible-core 2.17 hasta 2.20. Renombrar tus tareas community.general.proxmox_* a community.proxmox.proxmox_* es la mayor parte de la migración.
Cada tarea de Proxmox corre en localhost
Dos líneas al principio del play hacen el trabajo pesado, y las dos parecen estar deshabilitando algo útil:
- name: Create Proxmox virtual machines
  hosts: "{{ target_hosts | default('cluster_pve:&status_planned') }}"
  gather_facts: false
  serial: 1
gather_facts: false no es una optimización. La recogida de facts se conecta al host del inventario, y el host del inventario es una VM que aún no se ha construido. Déjalo puesto y el play falla antes de la primera tarea.
Luego cada tarea de Proxmox lleva delegate_to: localhost:
- name: Create Proxmox VM
  delegate_to: localhost
  register: created_vm
  community.proxmox.proxmox_kvm:
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    api_host: "{{ proxmox_api_ip }}"
    name: "{{ inventory_hostname }}"
    node: "{{ proxmox_api_host }}"
    ...
El host del inventario ahora es solo un nombre y una bolsa de variables. inventory_hostname se convierte en el nombre de la VM; sus variables describen la máquina que quieres. Nada se conecta a él. La tarea corre en el nodo de control, que abre una sesión HTTPS a api_host y postea una definición de VM.
También verás esto escrito como local_action:, que es la sintaxis más vieja para lo mismo. El playbook de desmontaje en ese repositorio lo usa de principio a fin. Son equivalentes. delegate_to es la grafía actual.
La salida de emergencia apunta al nodo
Algunas cosas de verdad tienen que pasar en un host de Proxmox, y esas tareas se delegan a otro sitio del todo:
- name: Fail if no ISO file exists for the OS
  delegate_to: "{{ proxmox_api_host }}"
  ansible.builtin.stat:
    path: "{{ iso | replace('isos:', '/mnt/pve/isos/template/') }}"
  register: iso_file
  failed_when: not iso_file.stat.exists
Esa es una conexión SSH real a un nodo real, comprobando una ruta real en almacenamiento compartido, porque la API aceptará tan tranquila una referencia de ISO que no resuelve a un fichero y prefieres enterarte ahora que en el arranque. Fíjate en la cirugía de cadenas que traduce una referencia de almacenamiento de PVE (isos:iso/debian.iso) a una ruta de sistema de ficheros. La abstracción de almacenamiento no está disponible para stat.
Así que un solo play tiene tareas ejecutándose en tres sitios distintos, y confundirlos es la manera más común en que estos playbooks fallan:
qm es la única parte que necesita SSH a un hipervisor.Credenciales, y un valor por defecto que está a punto de cambiar
Las opciones de auth las comparten todos los módulos de la colección a través de un fragmento de documentación, así que son las mismas en todas partes: api_host, api_user, y luego o bien api_password o el par api_token_id / api_token_secret. Todas recurren a variables de entorno — PROXMOX_HOST, PROXMOX_USER, PROXMOX_PASSWORD, PROXMOX_TOKEN_ID, PROXMOX_TOKEN_SECRET, PROXMOX_VALIDATE_CERTS — que es la manera más limpia de mantener los secretos fuera del play del todo.
Un token de API es el mejor valor por defecto. Está acotado, es revocable sin cambiar la contraseña de una persona, y se le pueden dar exactamente los privilegios que el playbook necesita en vez de los que una persona resulte tener:
- name: Create Proxmox VM
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    validate_certs: true
    ca_path: /etc/ssl/certs/pve-cluster-ca.pem
Pon validate_certs de forma explícita, hoy. La propia documentación de la colección lo dice claro:
Currently defaults to
falseand changes default totruewith community.proxmox 2.0.0.
Lo que significa que un playbook que nunca lo menciona no está validando TLS ahora mismo, y empezará a validar — y por tanto empezará a fallar contra el certificado autofirmado que trae cada instalación fresca de Proxmox — en el momento en que alguien corra --upgrade. Mejor tomar esa decisión a propósito que tenerla cayendo en medio de un montaje. Si vas a quedarte con el certificado autofirmado, di validate_certs: false y asume el hallazgo; si tienes una cadena en condiciones, apunta ca_path a ella. De cualquier modo queda escrito.
El crear mínimo viable
Recorta la tarea de producción a lo que de verdad define una máquina y se lee bien:
- name: Create Proxmox VM
  delegate_to: localhost
  register: created_vm
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    validate_certs: true

    node: pve1
    name: "{{ inventory_hostname }}"
    cores: "{{ vcpus | int }}"
    memory: "{{ memory }}"
    machine: q35
    bios: ovmf
    ostype: l26
    scsihw: virtio-scsi-single
    scsi:
      scsi0: "vmdata:32,format=qcow2,discard=on,ssd=1"
    sata:
      sata0: "isos:iso/debian-13-netinst.iso,media=cdrom"
    net:
      net0: "virtio,bridge=vmbr0"
    efidisk0:
      storage: vmdata
      format: raw
      efitype: 4m
      pre_enrolled_keys: true
    boot: "order=scsi0;sata0"
    agent: "enabled=1,fstrim_cloned_disks=1"
    onboot: true
    tags:
      - production
Unas cuantas cosas sobre esa forma vale la pena conocerlas antes de escribir la tuya.
Las opciones de dispositivo son sintaxis de PVE dentro de YAML. scsi, sata, net, virtio, ide son todos de tipo dict, con clave scsi0, net0 y demás, y los valores son las cadenas de opciones separadas por comas salidas directamente de man qm — <storage>:<size>,option=value para un disco, [model=]<enum>,option=value para una NIC. El módulo no las modela; las reenvía. Cuando algo se rechaza, la respuesta está en la referencia de opciones de PVE, no en la documentación de Ansible.
También verás estos escritos como una cadena JSON en vez de un mapeo YAML:
net: '{"net0":"virtio,bridge={{ vlan_bridge }}"}'
Ambos funcionan. Ansible coacciona la cadena para un parámetro de tipo dict. La forma JSON existe porque es más fácil plantillar una estructura entera en una sola expresión Jinja. La forma de mapeo es más fácil de leer seis meses después.
boot tiene dos generaciones de sintaxis. El módulo acepta las letras heredadas, donde boot: "cdn" significa «probar disco, luego CD-ROM, luego red». El PVE actual quiere una lista ordenada explícita — boot: "order=scsi0;sata0;net0" — que es inequívoca sobre qué disco. La forma heredada aún funciona. La forma explícita es la que quieres en trabajo nuevo. Un pega de verdad enterrado en la documentación del módulo: el arranque por red requiere poner rng0 desde PVE 8.3.5.
numa y numa_enabled son parámetros distintos. numa_enabled es el booleano que enciende NUMA. numa es un dict que describe una topología (cpus, hostnodes, memory, policy). Poner numa: true es un error de tipo, y es una hora fácil de perder. Si te importa por qué nada de esto importa, la alineación NUMA en Proxmox cubre el problema de fondo.
machine: q35 y bios: ovmf son los valores por defecto correctos, no decoración — ese argumento al completo.
Omitir vmid significa que el módulo le pide a la API el siguiente ID libre. Cómodo, y la causa directa de lo siguiente.
Por qué serial: 1
«Recupera el siguiente ID disponible, luego crea una VM con él» son dos llamadas a la API con un hueco en medio. Dos workers haciendo eso de forma concurrente pueden leer el mismo ID libre, y el perdedor obtiene un error o, peor, una sorpresa.
serial: 1 hace la fase de creación de un host a la vez. No es rápido y no necesita serlo. La parte cara de construir una VM pasa después de que este playbook entregue el testigo. El play compañero que arranca las VM terminadas usa serial: 5, porque arrancar no tiene contador compartido con el que competir.
Si prefieres tener el paralelismo, asigna el VMID tú mismo desde tu fuente de verdad y pásalo de forma explícita. Entonces no hay lectura-modificación-escritura ni carrera.
La idempotencia no es lo que esperas
Esta es la sección para leer dos veces, porque proxmox_kvm no se comporta como ansible.builtin.package.
name no es una identidad. Los nombres de VM no son únicos en un clúster de Proxmox, y el módulo lo dice. Con state: present y sin vmid, si una VM con ese nombre ya existe, el módulo sale changed=false con msg: "VM with name <x> already exists" y no hace nada. No compara tus parámetros con la realidad. No converge. Se niega.
update por defecto es false. Así que editar memory: en tu playbook y volver a correr es un no-op. La VM se queda con la memoria con la que se construyó, la tarea reporta éxito, y nada en ningún sitio te dice que las dos han divergido.
update: true sigue rechazando los parámetros interesantes. De la documentación del módulo:
Because of the operations of the API and security reasons, I have disabled the update of the following parameters
net,virtio,ide,sata,scsi. Per example updatingnetupdate the MAC address andvirtiocreate always new disk…
update_unsafe: true levanta esa restricción, y la advertencia no es de adorno:
Use this option with caution because an improper configuration might result in a permanent loss of data (for example disk recreated).
Así que el disco que creías estar redimensionando puede reemplazarse por uno nuevo vacío. No eches mano de esto — los parámetros rechazados tienen sus propios módulos, y esa es la siguiente sección.
Y --check no cubre nada de esto. La colección declara el soporte de modo check por módulo, y es incoherente exactamente en el sentido equivocado:
| Módulo | check_mode | diff_mode |
|---|---|---|
proxmox_kvm | none | none |
proxmox_disk | none | none |
proxmox_template | none | none |
proxmox_snap | full | none |
proxmox_nic | full | none |
proxmox_pool | full | none |
El reparto no es «los módulos de solo lectura pueden, los de escritura no» — proxmox_nic crea y borra interfaces y honra el modo check perfectamente bien. Es que los tres módulos que tratan con almacenamiento y ciclo de vida de la VM no lo hacen. Una pasada --check de un playbook de construcción se salta la creación de la VM en silencio y luego reporta sobre un mundo donde la VM nunca se hizo, así que cada tarea después de ella razona sobre el estado equivocado. En un playbook de construcción, --check no es una red de seguridad, y tratarlo como tal es peor que no correrlo.
Así que haz de la existencia el filtro
Dado todo eso, el patrón que funciona es dejar de pedirle al módulo que sea idempotente y decidir tú mismo si construir. El playbook de producción lo hace así:
- name: Check if VM is present or manually built
  delegate_to: localhost
  community.proxmox.proxmox_vm_info:
    api_host: "{{ proxmox_api_ip }}"
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    name: "{{ inventory_hostname }}"
    config: current
  register: existing_vm
  ignore_errors: true
  failed_when: (existing_vm.proxmox_vms | length) == 0

- name: Configure Proxmox VM
  when: existing_vm is failed
  block:
    - name: Create Proxmox VM
      ...
proxmox_vm_info con config: current devuelve la VM y su configuración en vivo, o una lista vacía. failed_when convierte «lista vacía» en un fallo, ignore_errors: true impide que ese fallo termine el play, y when: existing_vm is failed se convierte en «la VM no está, constrúyela».
Usar una tarea fallada a propósito como un booleano se lee mal, y no voy a fingir lo contrario. La alternativa es when: (existing_vm.proxmox_vms | default([]) | length) == 0, que es honesta sobre ser una comprobación de longitud y no necesita ignore_errors. Ambas funcionan. La versión de arriba es la que está en producción, y su única ventaja real es que el resultado registrado lleva la configuración existente para que tareas posteriores la lean.
La parte importante es la forma, no la grafía: comprueba, luego bifurca, y trata la creación como un evento de una sola vez. La configuración en marcha de una VM es un problema distinto de la existencia de una VM, y este módulo solo es bueno en el segundo.
Los discos y las NIC tienen sus propios módulos
Aquí está la cosa que pasé por alto arriba, y cambia el cuadro entero: los parámetros que proxmox_kvm se niega a actualizar no son un hueco en la colección. Están delegados. community.proxmox.proxmox_disk y community.proxmox.proxmox_nic añaden, cambian y quitan exactamente las cosas que el módulo de creación no tocará — con clave en los mismos nombres scsi0 y net0 que usaste cuando construiste la VM.
Ambos se portan mejor que proxmox_kvm, y uno de ellos es el único módulo de este flujo que se puede correr en seco.
proxmox_nic — añadir, reetiquetar o quitar una interfaz
- name: Move the VM's primary NIC to a new bridge and VLAN
  delegate_to: localhost
  community.proxmox.proxmox_nic:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    vmid: "{{ created_vm.vmid }}"
    interface: net0
    bridge: vmbr1
    tag: 120
    model: virtio
    mtu: 1
    queues: 4
    firewall: true
    state: present
interface es la única opción requerida más allá de la auth — net[n] donde n es 0 a 31 — y state: present o absent te da añadir y quitar. model por defecto es virtio, que es la respuesta correcta salvo que un invitado no lo aguante.
La razón por la que existe este módulo es la dirección MAC. Recuerda por qué proxmox_kvm se niega a actualizar net: «updating net update the MAC address». proxmox_nic lo arregla de forma explícita:
When not specified this module will keep the MAC address the same when changing an existing interface.
Así que puedes reetiquetar una VLAN, mover un puente, cambiar el MTU o encender el cortafuegos sin que la identidad de la NIC del invitado cambie por debajo. Eso importa más de lo que suena: una MAC nueva invalida las reservas de DHCP, rompe cualquier cosa licenciada a una NIC, y desincroniza el registro de interfaz de NetBox que el playbook de creación escribió con tanto cuidado. Este es el módulo que deja que un cambio de red en día 2 sea aburrido.
Unas cuantas opciones que vale la pena conocer antes de necesitarlas:
ratees en MBps — MegaBytes por segundo, no bits. La documentación es explícita y el error de factor ocho es muy fácil de cometer.link_down: truedesconecta la interfaz, descrita en la documentación como «like pulling the plug» — como tirar del enchufe. Una manera limpia de aislar una VM sospechosa sin pararla ni tocar el invitado.trunkstoma una lista de IDs de VLAN a pasar a través, para un invitado que hace su propio etiquetado.mtu: 1no es un error de tecleo ni un MTU de 1 byte — significa «heredar el MTU del puente», y solo aplica avirtio.queuespone multicola, 0 a 16. Vale la pena igualarlo al número de vCPU en cualquier cosa que empuje tráfico de verdad.
Y soporta el modo check del todo. --check en una tarea proxmox_nic te dice la verdad, lo que la hace la única parte de este flujo que puedes ensayar con seguridad. Sus mensajes también son idempotentes como es debido. Una interfaz sin cambios reporta Nic net0 unchanged on VM with vmid 103 en vez de reclamar un cambio.
proxmox_disk — el ciclo de vida entero del disco
proxmox_disk es el módulo más grande de los tres, y su state está haciendo cinco trabajos distintos:
state | Qué pasa | ¿Reversible? |
|---|---|---|
present | crea el disco, o actualiza opciones de uno existente | n/a |
resized | lo agranda — PVE no puede encoger, y la documentación dice hacer eso a mano | no |
detached | pasa a ser unused[n]; el volumen y sus datos se quedan | sí |
moved | cambia el almacenamiento de respaldo, o entrega el disco a otra VM | el original se guarda salvo delete_moved |
absent | quitado del almacenamiento de respaldo | no |
El hueco entre detached y absent es la red de seguridad que proxmox_kvm nunca te da. Desconectar es un cambio de configuración; borrar destruye datos. Dos palabras distintas, dos consecuencias distintas.
Añadir un segundo disco a una VM que ya existe:
- name: Add a data disk
  delegate_to: localhost
  community.proxmox.proxmox_disk:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    vmid: "{{ created_vm.vmid }}"
    disk: scsi1
    storage: vmdata
    size: 200
    format: qcow2
    iothread: true
    aio: io_uring
    discard: "on"
    ssd: true
    backup: true
    state: present
create es el mando que proxmox_kvm debería haber tenido. Controla lo que a state: present se le permite hacer:
regular(el valor por defecto) — crea el disco si falta, si no actualiza sus opciones.disabled— actualiza opciones solo, y nunca crea. Este es el que hay que buscar cuando estás cambiandocacheoiothreaden un disco que ya tiene que existir. No puede sorprenderte conjurando un volumen nuevo porque una clave se escribió mal.forced— siempre crea. Un disco existente se desconecta y se deja sin usar, no se borra.
Ese último comportamiento es el detalle importante. create: forced es la opción de aspecto destructivo, y aun así no destruye nada: el volumen viejo sobrevive como unusedN y puedes volver a adjuntarlo. Compara eso con proxmox_kvm más update_unsafe, cuyo modo de fallo documentado es un disco recreado. La misma operación a grandes rasgos, un radio de explosión mucho mejor.
Agrandar un disco:
- name: Grow the data disk by 100 GiB
  delegate_to: localhost
  community.proxmox.proxmox_disk:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    vmid: "{{ created_vm.vmid }}"
    disk: scsi1
    size: "+100G"
    state: resized
Cuidado con las unidades, porque size cambia de significado con state. Con state: present es GiB como un número pelado (size: 200). Con state: resized toma un sufijo — +100G para añadir al tamaño actual, o 500G como objetivo absoluto. Un parámetro, dos convenciones, y el fallo es silencioso si aciertas mal.
Mover un disco a distinto almacenamiento, que es el caso de la migración-en-vivo-de-un-volumen:
- name: Move the disk to NVMe storage
  delegate_to: localhost
  community.proxmox.proxmox_disk:
    api_host: "{{ proxmox_api_ip }}"
    api_user: ansible@pve
    api_token_id: automation
    api_token_secret: "{{ proxmox_token_secret }}"
    vmid: "{{ created_vm.vmid }}"
    disk: scsi1
    target_storage: nvme-pool
    bwlimit: 200000
    delete_moved: true
    timeout: 3600
    state: moved
target_storage mueve dentro de una VM; target_vmid entrega el disco a una VM distinta y requiere el mismo almacenamiento en ambas. Son mutuamente excluyentes. delete_moved por defecto es false, así que por defecto acabas con dos copias y el original ahí sentado sin usar — seguro, y una buena manera de llenar un pool de almacenamiento si nunca vuelves a él.
timeout por defecto es 600 aquí, contra 30 en proxmox_kvm. Parámetro de aspecto igual, diferencia de veinte veces, porque estas operaciones copian datos. Súbelo para imágenes grandes o almacenamiento lento — la documentación lo dice para moved y para import_from.
Lo que trae a colación la opción que hace de este módulo la ruta de V2V y de imagen de nube:
import_from: "vmdata:9000/base-debian13.qcow2"
import_from construye el disco a partir de un volumen existente en vez de asignar uno vacío — <STORAGE>:<VMID>/<NAME>, o <STORAGE>:import/<NAME> usando el directorio de importación de almacenamiento en PVE 9.x y posterior. Es mutuamente excluyente con size, y solo root puede usar rutas de sistema de ficheros absolutas.
El resto de la lista de parámetros es la razón para adjuntar discos con este módulo en vez de en línea en la llamada de creación: cache, aio, iothread, discard, ssd, backup, detect_zeroes, y la familia completa de estrangulamiento — iops, iops_rd, iops_wr, sus variantes _max y _max_length, y los controles de ráfaga bps_*_max_length. Nada de eso es alcanzable a través de proxmox_kvm tras la creación.
Dos salvedades, ambas de la propia documentación del módulo:
- Algunos cambios de opción necesitan un reinicio. «Some updates on options (like
cache) are not being applied instantly and require VM restart.» Una tarea en verde significa que la configuración se escribió, no que la VM en marcha se esté comportando distinto. - No soporta el modo check.
check_mode: none, igual queproxmox_kvm. Así que la colección se parte por la mitad: los cambios de NIC se pueden ensayar con--check, los de disco no.
La división del trabajo
| Para hacer esto | Usa |
|---|---|
| Crear la VM | proxmox_kvm, una vez, con filtro de existencia |
| Cambiar núcleos, memoria, tags, agent, onboot | proxmox_kvm con update: true |
| Añadir, reetiquetar, desconectar o quitar una NIC | proxmox_nic |
| Añadir, agrandar, mover, desconectar o quitar un disco | proxmox_disk |
| Instantánea | proxmox_snap (también modo check completo) |
| Cualquier cosa que ninguno exponga | qm set por SSH |
Cambiar un disco o una NIC a través de proxmox_kvm | nada — para esto está update_unsafe, y es por lo que no deberías usarlo |
Construye la VM con una llamada proxmox_kvm mínima, luego adjunta los discos y las interfaces con sus propios módulos. Son más tareas, y es la versión donde los cambios en día 2 tienen una ruta que no implica una opción cuyo riesgo documentado es perder un disco.
Donde el módulo se para
proxmox_kvm tiene una lista de parámetros enorme y aun así no cubre todo lo que qm puede hacer. En vez de esperar, el playbook de producción baja a la CLI en el nodo:
- name: Set RNG source and better SPICE quality
  delegate_to: "{{ proxmox_api_host }}"
  become: true
  ansible.builtin.command:
    cmd: >-
      /usr/sbin/qm set {{ created_vm.vmid }}
      --rng0 source=/dev/urandom
      --spice_enhancements videostreaming=all
No hay nada malo en esto. No es idempotente en ningún sentido con significado — qm set es una escritura, y reportará changed cada pasada — pero es explícito, es legible, y no finge. Si un módulo gana el parámetro más adelante, borras la tarea.
Otras cosas necesitan una segunda pasada por el módulo con update: true, porque no se pueden poner en la misma llamada que crea la VM:
- name: Add SPICE-compatible USB device
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    node: "{{ proxmox_api_host }}"
    vmid: "{{ created_vm.vmid }}"
    usb:
      usb0: "spice,usb3=1"
    update: true
  when: spice_usb | default(false)
Fíjate en que pasa vmid, no name. Una vez que tienes el ID, úsalo. Es el único identificador que la API trata como único.
Y para las cosas que QEMU puede hacer y para las que PVE no tiene opción, está args, que se pasa a la línea de comandos de QEMU verbatim:
    args: >-
      -global scsi-hd.physical_block_size=4k
      -global scsi-hd.logical_block_size=4096
Ese presenta el disco virtual como 4Kn en vez de 512e, lo que importa más de lo que suena — tamaños de bloque, 4Kn y 512e. El módulo etiqueta args «for experts only» — solo para expertos — y la razón es que PVE no lo valida y un flag malo impide que la VM arranque con un error que viene de QEMU en vez de Proxmox.
El clúster no es instantáneamente consistente
- name: Let registration complete on cluster
  ansible.builtin.pause:
    seconds: 5
  when: created_vm.changed
Un pause en un playbook suele ser un olor, y este es de carga. La llamada de creación devuelve cuando la API ha aceptado la definición, que no es lo mismo que cada nodo estando de acuerdo en que la VM existe — y la siguiente tarea justo quiere poner una ACL en /vms/<vmid>. Cinco segundos de paciencia es más barato que un bucle de reintento alrededor de un error que solo aparece bajo carga.
El playbook de desmontaje tiene la misma forma por la misma razón: para, espera, luego borra.
Leer de vuelta lo que construiste
proxmox_kvm documenta tres valores de retorno: vmid, status y msg. En la práctica querrás un cuarto, y no está en la documentación.
- name: Get MAC address of VM
  ansible.builtin.set_fact:
    primary_mac_addr: "{{ created_vm.mac.net0 }}"
created_vm.mac es real — el módulo lo construye en get_vminfo() y lo mete en el resultado — pero está ausente del bloque RETURN documentado, lo que significa que nada promete que siga funcionando. Vale la pena saber exactamente cómo se comporta, porque hay dos trampas en él:
- Solo aparece cuando el módulo de verdad creó la VM.
macsolo se ensambla en la ruta de crear-y-desplegar. Toma la rama de «ya existe» y el resultado tienevmidymsgy nada más. - Solo contiene las interfaces que pasaste. El código recorre los parámetros que tú suministraste y saca los que casan con
net[0-9], luego lee la configuración guardada de cada uno de vuelta desde la API. Sin parámetronet, sin clavemac.
Que es por lo que el playbook de producción necesita las dos mitades, y la segunda es fea:
- name: Get MAC address of VM
  ansible.builtin.set_fact:
    primary_mac_addr: >-
      {{ created_vm.mac.net0 if created_vm is defined and created_vm.changed
         else ((existing_vm.proxmox_vms[0].config.net0 | split(','))[0] | split('='))[1] }}
Cuando la VM ya existía, no hay mac, así que la MAC hay que sacarla de la cadena de configuración en bruto. net0 vuelve de la API como virtio=AE:AE:5C:A8:89:85,bridge=vmbr0, así que: separa por comas, toma el primer campo, separa por =, toma la segunda mitad. Es cirugía de cadenas sobre una respuesta de API, y es el coste honesto de un módulo cuya forma de retorno depende de qué rama tomó.
Si necesitas la MAC de forma fiable en ambos casos, sácala de proxmox_vm_info sin condiciones y parsea una forma en vez de dos.
Manejarlo desde una fuente de verdad
Mira otra vez la línea que abre el play:
hosts: "{{ target_hosts | default('cluster_pve:&status_planned') }}"
Esa es la arquitectura de verdad, y vale la pena decirla claro: las VM que construir no son una lista en un fichero de vars. Son los hosts de tu inventario cuyo estado registrado dice que deberían existir y aún no lo hacen.
El inventario aquí es NetBox. Una VM se solicita creando un registro de NetBox con estado planned, cargando su CPU, memoria, disco, VLAN, dueño y plataforma. El playbook selecciona las máquinas planned, las construye, asigna una IP, escribe DNS, y luego pone el registro a staged — punto en el cual ese host ya no casa con el patrón de hosts del play, y un handler refresca el inventario para que el siguiente play vea el estado nuevo:
handlers:
  - name: Refresh inventory
    ansible.builtin.meta: refresh_inventory
El campo de estado es una máquina de estados, el playbook es una transición en ella, y la cosa entera es re-ejecutable porque un host que ya se ha movido adelante ya no se selecciona. Esa es una propiedad mucho mejor que cualquier cantidad de idempotencia a nivel de módulo, y es la razón por la que la tarea de creación puede salirse con la suya siendo de un solo disparo.
community.proxmox también entrega su propio plugin de inventario, que construye un inventario a partir del clúster — la elección correcta cuando Proxmox es la fuente de verdad. Aquí es al revés: NetBox es autoritativo y Proxmox es donde su intención se realiza. Ese es un artículo entero por sí mismo y lo escribiré aparte.
Quitarlo otra vez
La creación sin desmontaje es media vida, y la ruta de eliminación tiene su propia trampa — no puedes borrar una VM en marcha:
- name: Force stop the VM if it is running
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    name: "{{ inventory_hostname }}"
    state: stopped
    force: true
    timeout: 10

- name: Allow the cluster to stop the VM before removing it
  ansible.builtin.pause:
    seconds: 10

- name: Remove the VM from the cluster
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    api_host: "{{ proxmox_api_ip }}"
    api_user: "{{ proxmox_user }}"
    api_password: "{{ proxmox_password }}"
    name: "{{ inventory_hostname }}"
    state: absent
    force: true
    timeout: 10
state: stopped es un apagado elegante, y la interacción con timeout está documentada y vale la pena memorizarla: si el timeout se alcanza con force: true la VM se apaga en duro; con force: false la tarea falla en su lugar. Una ventana elegante de diez segundos seguida de un tirón del enchufe es una política razonable para una máquina que se está desmontando, y terrible para cualquier otra cosa.
El desmontaje completo (proxmox-remove-vms.yml) luego deshace el resto del registro: DNS, la IP asignada, las interfaces de NetBox, la VM de NetBox, y las entradas rancias en known_hosts. Envuelve el bloque en ignore_errors: true, lo que es defendible en un desmontaje. Estás quitando cosas que puede que ya no estén, y una máquina medio borrada es peor que un log ruidoso.
Lo que cambiaría en un montaje nuevo
Habiendo leído el código fuente del módulo en vez de solo su documentación, cuatro cosas:
- Usa un token de API, no
api_usermásapi_password. Acotado, revocable, y nunca pertenece a una persona. - Pon
validate_certsde forma explícita, antes de que 2.0.0 lo cambie por debajo de ti. - Asigna el VMID tú mismo desde la fuente de verdad. Quita la carrera de lectura-modificación-escritura, deja que tires
serial: 1, y da a cada tarea posterior un identificador estable en vez de un nombre que no es único. - Crea la VM pelada, luego adjunta sus discos y NIC con
proxmox_diskyproxmox_nic. Más tareas, pero cada disco e interfaz tiene entonces un módulo que puede cambiarlo más adelante — incluyendocreate: disabledpara ediciones de solo opciones ystate: detacheden vez de borrado — en vez de una configuración que solo se puede cambiar a través deupdate_unsafe. - Saca la MAC de
proxmox_vm_infoen un solo sitio, así hay una forma que parsear en vez de un condicional entre un valor de retorno documentado y uno sin documentar.
Y no eches mano de --check en un playbook de construcción. El módulo que importa no lo puede honrar.
Una pasada en seco que siempre dice que sí es peor que ninguna pasada en seco, porque te la creerás.
Referencias
- community.proxmox collection docs — la superficie completa de 47 módulos
- community.proxmox on GitHub — donde vive el código de arriba;
plugins/modules/proxmox_kvm.pyes el fichero que leer cuando la documentación es ambigua proxmox_kvmmodule documentation — la lista de parámetros, y las advertencias deupdate/update_unsafecitadas arribaproxmox_vm_infomodule documentation —config: currentyconfig: pending- PVE
qmoptions reference — la especificación real de cada cadenascsi[n],net[n]ybootque pasas - proxmoxer — el cliente de Python sobre el que la colección está construida
- damo2929/ansible-example — los playbooks de donde vienen estos extractos, incluyendo el inventario manejado por NetBox, la generación de DHCP y la construcción del hipervisor