Un LLM en la NPU de Ryzen AI, dentro de un contenedor
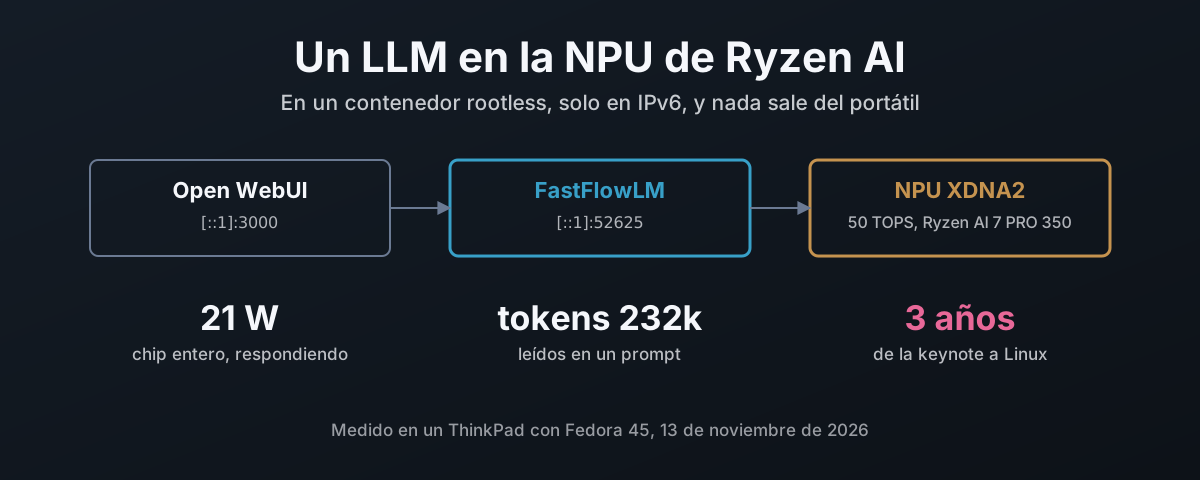
La NPU de un portátil Ryzen AI son 50 TOPS que se quedan parados en la mayoría de instalaciones Linux. Aquí se recorre cómo compilar el driver amdxdna de AMD y dejar en el host solo el módulo del kernel, cómo meter FastFlowLM con el runtime XRT de AMD en un contenedor podman rootless emparejado con ese driver, cómo atarlo todo al loopback IPv6 y arrancarlo con el sistema mediante Quadlet. Luego lo que hace: nueve modelos medidos, una prueba de contexto de 232 000 tokens, voz a texto con Whisper a diez veces el tiempo real, Open WebUI y los 7 000 tokens ocultos que añadía a cada mensaje, y la velocidad y la energía de la NPU medidas frente a llama.cpp en la iGPU Radeon 860M. Por último, la cronología: tres años desde que AMD anunció Ryzen AI hasta un modelo de lenguaje en su NPU bajo Linux, entregado por un proyecto que AMD no empezó, mientras el esfuerzo se iba a Copilot+ en el Fisher-Price OS (Windows) en lugar de al centro de datos y a las herramientas Linux que de verdad usan los profesionales de la IA.