Skip to content
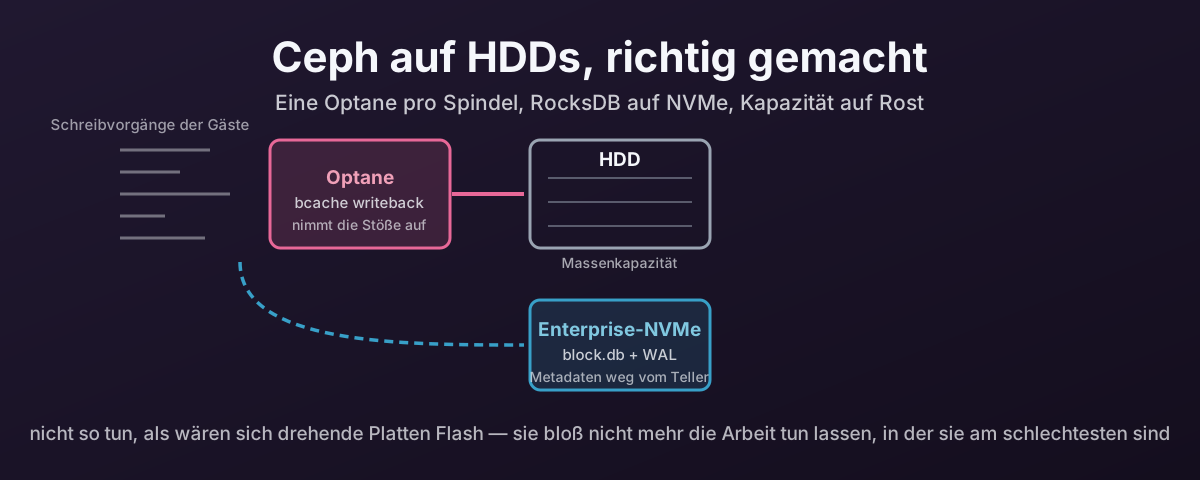
Drei Speicherebenen: Optane nimmt Schreibvorgänge auf, NVMe hält die Ceph-Metadaten, und HDDs liefern die Massenkapazität

Proxmox-Ceph-Cluster auf HDDs schnell machen — Metadaten auf NVMe, eine Optane pro Spindel, und was es dich kostet

Die Preise für Flash machen alles auf NVMe schwer zu rechtfertigen, und HDDs für Unternehmen sind einen zweiten Blick wert. Erträgliche Latenz aus ihnen auf hyperkonvergentem Proxmox-Ceph zu holen heißt, RocksDB von der Spindel wegzuholen, jede Platte über bcache mit ihrer eigenen Optane zu paaren — Optane ausdrücklich, weil die Haltbarkeit von NAND für diese Aufgabe falsch ist — und ehrlich über die Fehlerfälle zu sein, die das einkauft.
7. August 2026 · 36 Minuten · 7457 Wörter · Damien Dye
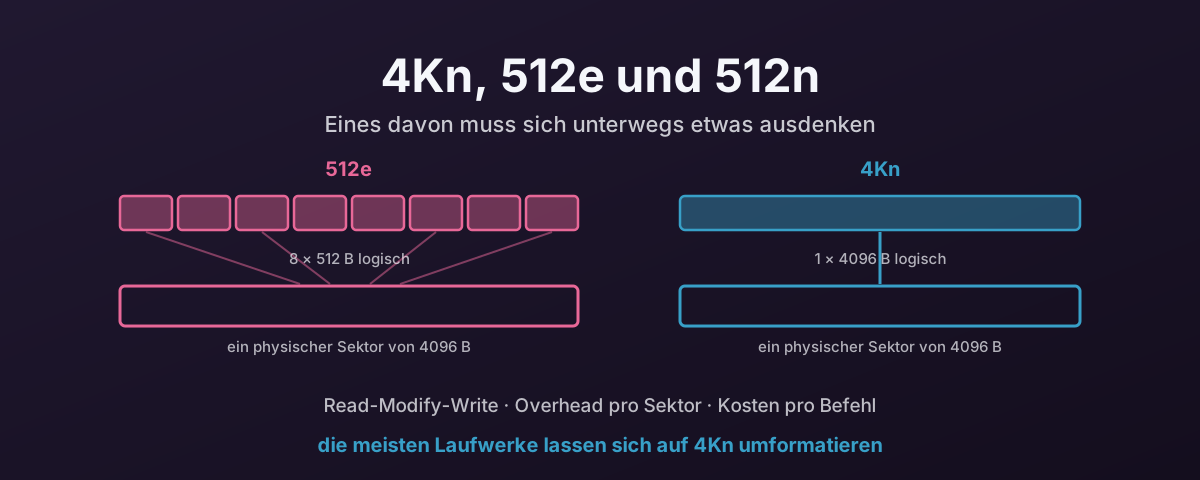
Acht logische Blöcke von 512 Byte, abgebildet auf einen physischen 4-K-Sektor, daneben eine 1:1-Abbildung mit 4 K

4Kn, 512e und 512n — warum natives 4K gewinnt, und was die Emulation kostet

512e-Laufwerke zeigen Sektoren von 512 Byte, die sie nicht haben, und die Firmware macht den Unterschied bei jedem fehlausgerichteten Schreibvorgang wieder gut. Was das auf dem Medium, im Host und an Schreibverstärkung kostet — warum direkte synchrone Schreibvorgänge der schlimmste Fall sind — und wie man einen ganzen Bestand auf 4Kn bringt.

7. August 2026 · 26 Minuten · 5507 Wörter · Damien Dye
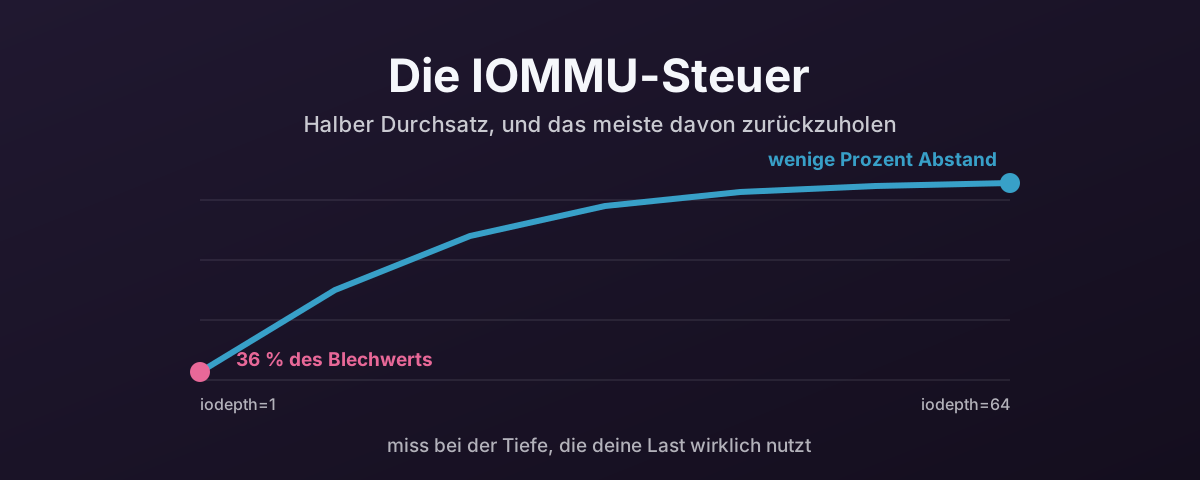
Eine Kurve, die von 36 Prozent des Blechwerts bei Queue-Tiefe 1 bis Queue-Tiefe 32 auf wenige Prozent Abstand steigt

PCIe-Passthrough-Leistung auf Proxmox VE — die IOMMU-Steuer und wie man sie klein hält

Warum PCIe-Geräte Durchsatz verlieren, wenn man sie über VFIO an eine VM durchreicht, und die praktischen Schritte, die den größten Teil davon zurückholen.

7. August 2026 · 19 Minuten · 3916 Wörter · Damien Dye
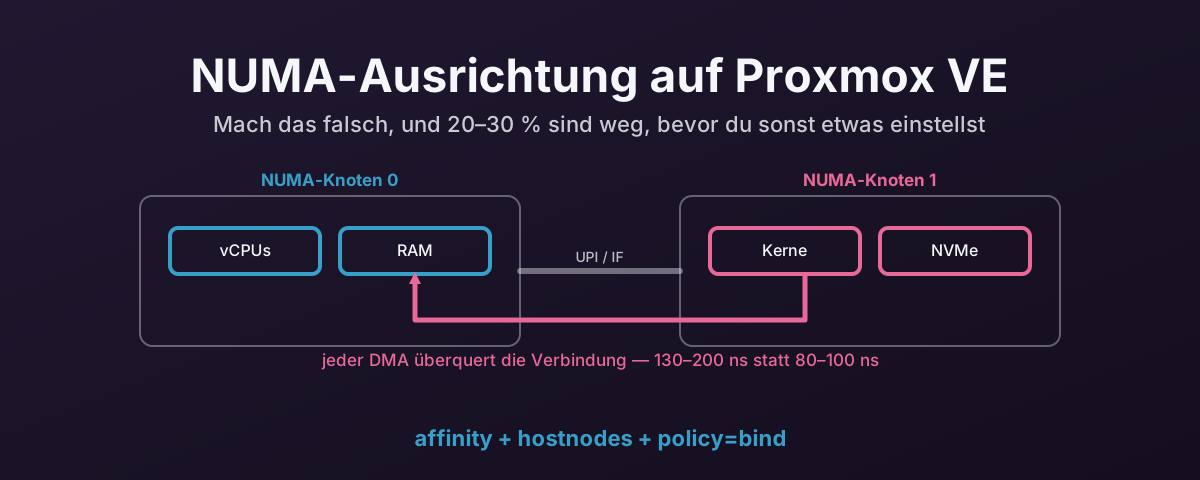
Zwei CPU-Sockel mit einem DMA-Weg, der die Verbindung zwischen ihnen überquert

NUMA-Ausrichtung auf Proxmox VE — warum sie zählt und wie man sie richtig hinbekommt

Auf Systemen mit mehreren Sockeln verliert eine VM, deren vCPUs auf einem NUMA-Knoten und deren durchgereichtes Gerät auf einem anderen sitzt, 20–30 % Durchsatz, bevor du sonst irgendwo hingeschaut hast.

7. August 2026 · 9 Minuten · 1748 Wörter · Damien Dye
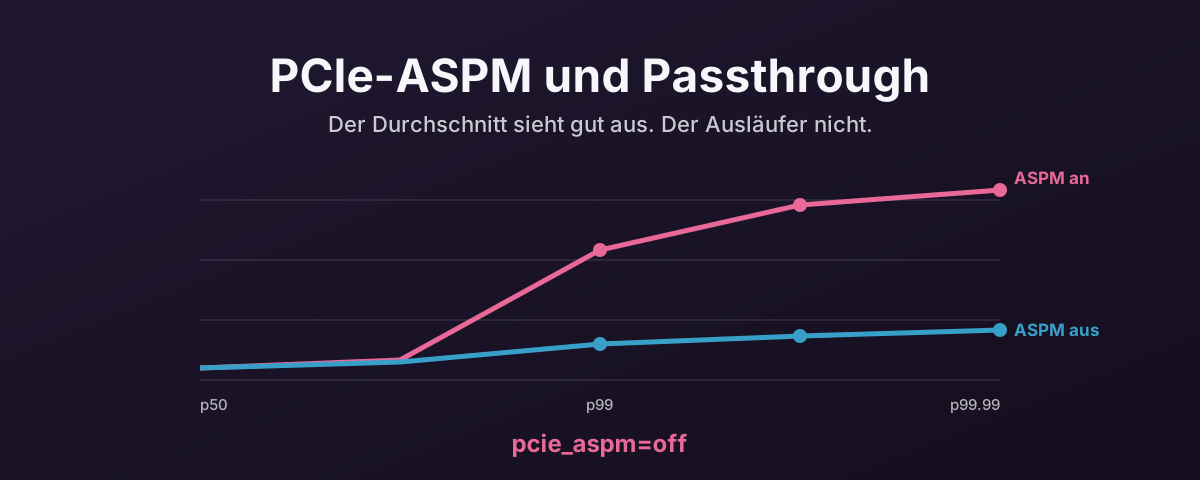
Eine Latenz-Perzentilkurve, die bis p90 flach bleibt und dann steil steigt, neben einer, die flach bleibt

PCIe-ASPM, und warum du es für Passthrough abschalten solltest

Active State Power Management spart auf unbeschäftigten PCIe-Links ein paar Watt. Unter VFIO-Passthrough erzeugt es Latenzzittern, das schwer zu diagnostizieren und leicht zu beheben ist.

7. August 2026 · 8 Minuten · 1610 Wörter · Damien Dye
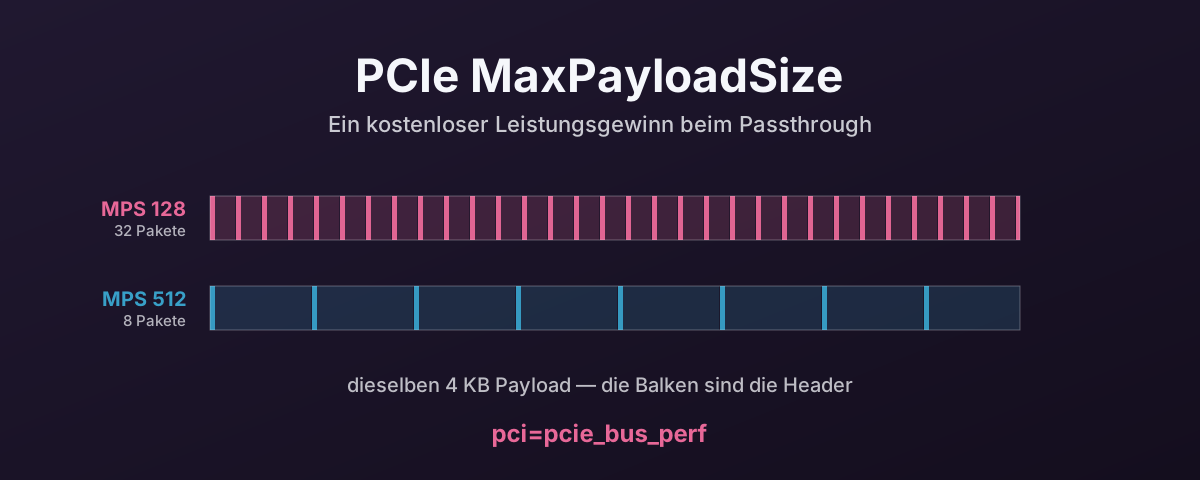
Dieselben 4 KB Payload, gezeichnet als 32 Pakete bei MPS 128 und als 8 Pakete bei MPS 512

PCIe MaxPayloadSize — ein kostenloser Leistungsgewinn beim Passthrough

Der virtuelle Root Complex von QEMU liefert standardmäßig 128 Byte TLP-Payload. Die meisten Geräte können 256 oder 512. Ein Kernel-Parameter behebt das.

7. August 2026 · 7 Minuten · 1365 Wörter · Damien Dye