Ein LLM auf der Ryzen-AI-NPU, im Container
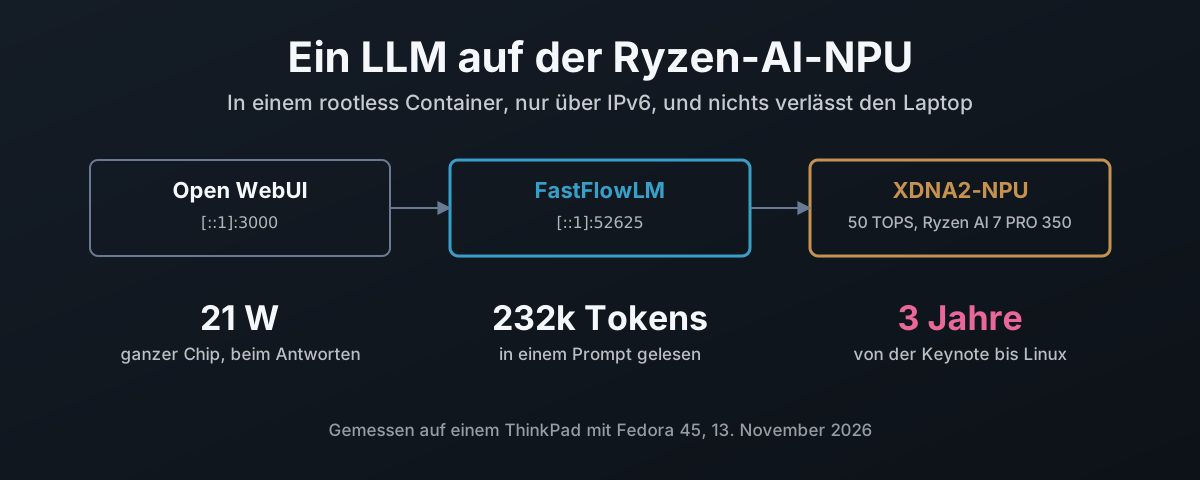
Die NPU in einem Ryzen-AI-Laptop sind 50 TOPS, die auf den meisten Linux-Installationen brachliegen. Dieser Beitrag zeigt, wie man AMDs amdxdna-Treiber baut und nur das Kernelmodul auf dem Host behält, wie man FastFlowLM mit AMDs XRT-Runtime in einen rootless podman-Container baut, der genau zu diesem Treiber passt, alles an IPv6-Loopback bindet und mit Quadlet beim Booten startet. Dann, was es leistet: neun Modelle im Benchmark, ein Kontexttest mit 232.000 Tokens, Whisper-Spracherkennung mit zehnfacher Echtzeit, Open WebUI und die 7.000 versteckten Tokens, die es an jede Nachricht hängte, und Geschwindigkeit und Energie der NPU gemessen gegen llama.cpp auf der Radeon-860M-iGPU. Zuletzt die Zeitleiste: drei Jahre von AMDs Ankündigung von Ryzen AI bis zu einem Sprachmodell auf seiner NPU unter Linux, geliefert von einem Projekt, das AMD nicht gestartet hat, während die Arbeit in Copilot+ auf dem Fisher-Price OS (Windows) floss statt ins Rechenzentrum und in die Linux-Werkzeuge, die KI-Profis tatsächlich benutzen.