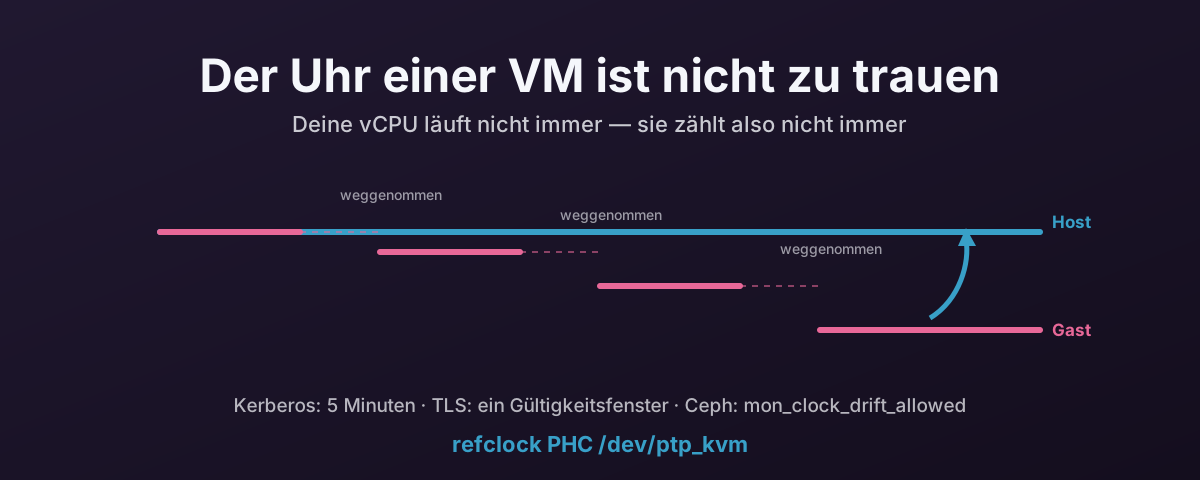
Die Annahme, die jede Uhr macht
Die Uhr eines Computers arbeitet, indem sie etwas Regelmäßiges zählt und darauf vertraut, dass es weiterzählt. Ein Quarz schwingt, ein Zähler steigt, und Software rechnet aus, wie viel Zeit vergangen ist.
Virtualisierung zerbricht den Teil mit dem Vertrauen.
Die KVM-Dokumentation des Kernels zur Zeitmessung bringt das Problem in einen Satz: „the virtual operating system does not run with 100% usage of the CPU, despite the fact that it may very well make that assumption“ — das virtuelle Betriebssystem läuft nicht mit 100 % der CPU, obwohl es genau das durchaus annehmen kann. Alles Weitere folgt daraus.
Deine vCPU läuft nicht immer
Eine vCPU ist ein Thread auf dem Host. Sie läuft, wenn der Scheduler des Hosts es sagt.
Wenn sie nicht läuft, ist der Gast nicht bloß unbeschäftigt — er ist abwesend. Er kann nicht zählen, er kann keinen Timer-Interrupt bedienen, und er hat keine Möglichkeit zu wissen, wie lange er weg war. Der Host führt das als Steal Time, was der ehrliche Name für „Zeit, die dir passiert ist statt für dich“ ist.
Timer-Interrupts sind die Stelle, an der das am meisten weh tut. Ein Gast, der einen periodischen Tick verlangt, verlangt vom Host, Interrupts mit einer festen Rate zuzustellen, und der Host kann das nicht immer leisten. Wieder aus der Kernel-Dokumentation: „the host virtualization engine may not be able to deliver the proper number of interrupts per second, and so guest time may fall behind“ — die Virtualisierung des Hosts kann die richtige Zahl an Interrupts pro Sekunde vielleicht nicht liefern, und dann fällt die Gast-Zeit zurück.
Je höher die Tick-Rate, desto schlimmer, und ein überbuchter Host macht es noch schlimmer. Deshalb verdirbt ein beschäftigter Host auch die Zeitmessung ruhiger Gäste. Sie stehen alle in derselben Schlange für dieselben physischen Kerne.
Die Zähler sind auch nicht deine
Wenn periodische Ticks unzuverlässig sind, ist die naheliegende Antwort, stattdessen einen Zähler zu lesen. Das hat seine eigenen Probleme.
Der TSC ist der schnelle, und die Kernel-Dokumentation ist unmissverständlich: „The TSC is a CPU-local clock in most implementations… the TSCs of different CPUs may start at different times“ — der TSC ist in den meisten Umsetzungen eine CPU-lokale Uhr, und die TSCs verschiedener CPUs können zu verschiedenen Zeiten losgelaufen sein. Seine Rate kann mit den Energiezuständen des Prozessors schwanken, und auf älteren Teilen hält er ganz an, wenn der Kern ruht. Eine vCPU, die zwischen physischen Kernen wandert, kann daher einen Zähler lesen, der dem widerspricht, den sie eine Mikrosekunde vorher gelesen hat.
Die Alternativen sind auf andere Weise schlechter. Der HPET, der PIT und der ACPI-PM-Timer sind alle emulierte Geräte, jedes Lesen fällt also in den Hypervisor. Korrekt, und teuer genug, dass ein Gast, der die Uhr in einer engen Schleife liest, es merkt.
Deshalb gibt es paravirtuelle Uhren. Auf KVM lässt kvm-clock den Host seine eigene Zeitmessung in eine gemeinsame Struktur schreiben, die der Gast direkt liest: kein Hineinfallen, kein Zählen, keine Annahme, dass der Gast wach war.
Und deshalb solltest du die Clocksource des Gasts in Ruhe lassen, statt tsc oder hpet zu erzwingen, weil ein Forumsbeitrag sagte, das sei schneller.
Migration, Snapshots und Suspend
Live-Migration, Wiederherstellung eines Snapshots und Suspend/Resume machen mit der Uhr eines Gasts alle dasselbe: sie halten sie an und starten sie woanders wieder.
Was der Gast sieht, ist kein Weglaufen, es ist eine Stufe. Die Uhr hatte einen Wert, und jetzt hat sie einen anderen, mit nichts dazwischen. Auf einen Host zu migrieren, dessen TSC mit anderer Frequenz läuft, kommt obendrauf.
Stufen sind wichtig, weil die Software, die Uhren korrigiert, dafür gebaut ist, Weglaufen zu korrigieren, nicht Teleportation.
Das ist kein KVM-Problem
Es ist verlockend, all das als Schwäche von KVM zu lesen. Ist es nicht.
Jeder Hypervisor liefert eine paravirtuelle Uhr, weil jeder Hypervisor dasselbe strukturelle Problem hat: KVM hat kvm-clock, Hyper-V hat seine Reference-TSC-Seite, VMware hat einen Pseudo-Leistungszähler plus Abgleich über die Tools, Xen hat seine pvclock. Das sind vier unabhängige Umsetzungen eines Behelfs.
Der eigene Schluss der Kernel-Dokumentation ist, dass es hier keine perfekte Lösung gibt. Nur Abwägungen zwischen Genauigkeit, Leistung und Komplexität.
Wenn du es lieber von einem Anbieter als von Kernel-Entwicklern hörst: Microsofts Grenze der Unterstützung für hochgenaue Zeit ist bemerkenswert offen. Um auf einem virtualisierten Windows-System 50 ms Genauigkeit zu behaupten, lautet eine der genannten Bedingungen, dass „the one-day average CPU utilization of the host must not exceed 90%“ — die über einen Tag gemittelte CPU-Auslastung des Hosts darf 90 % nicht übersteigen. Für 1 ms muss der Host unter 80 % bleiben.
Lies das noch einmal: die Genauigkeit der Uhr des Gasts ist dokumentiert als abhängig davon, wie beschäftigt der Host ist. Das ist keine Windows-Eigenart, es ist dieselbe Physik, die die Kernel-Dokumentation beschreibt, niedergeschrieben als Grenze der Unterstützung.
Warum NTP im Gast das falsche Werkzeug ist
NTP ist gut in dem, wofür es entworfen wurde: eine Maschine mit einem echten Schwinger, der etwas zu schnell oder zu langsam läuft, korrigiert dadurch, dass die Umlaufzeit zu einem entfernten Server gemessen und die lokale Uhr sanft nachgezogen wird.
Jede dieser Annahmen wackelt in einer VM.
Der lokale Schwinger ist nicht etwas falsch, er ist zeitweise abwesend. Die Messung der Umlaufzeit macht ein Prozess, der zwischen dem Lesen der Uhr und dem Senden des Pakets vom Scheduler weggenommen werden kann, was die Messung selbst verdirbt. Und die Korrekturen, die nach einer Migration nötig sind, sind Stufen, mit denen ein nachziehendes Verfahren schlecht zurechtkommt oder die es ganz ablehnt.
chrony kommt hier weit besser zurecht als ntpd. Es zieht schneller nach, verträgt Stufen und ist ehrlich über seine eigene Unsicherheit. Aber es löst noch immer das falsche Problem: Zeit über ein Netz von einem Stratum-2-Server 20 ms weit zu holen, während die richtige Zeit im Hypervisor auf der anderen Seite einer einzigen Speichergrenze liegt.
Was du in der Praxis bekommst, ist ein Gast, der meistens richtig liegt, gelegentlich Dutzende oder Hunderte Millisekunden daneben, und nie richtig sagen kann, welches von beidem gerade gilt.
Was Versatz tatsächlich kaputt macht
Niemand kümmert sich um Uhren um ihrer selbst willen. Man kümmert sich, wenn etwas aufhört zu funktionieren.
Kerberos und Active Directory
Kerberos ist von Entwurf her zeitabhängig, weil die Gültigkeit eines Tickets als Zeitfenster ausgedrückt ist.
Die Dokumentation zu krb5.conf von MIT bestimmt clockskew als „the maximum allowable amount of clockskew in seconds that the library will tolerate before assuming that a Kerberos message is invalid“ — den größten zulässigen Uhrenversatz in Sekunden, den die Bibliothek verträgt, bevor sie eine Kerberos-Nachricht für ungültig hält —, und die Voreinstellung sind 300 Sekunden, also fünf Minuten.
Überschreite das, und die Anmeldung wird nicht schlechter, sie scheitert.
Da die Anmeldung an Active Directory Kerberos ist, heißt das Domänenanmeldungen, net use, Verbindungen zum SQL Server, Exchange, Dateifreigaben — alles.
Fünf Minuten klingen großzügig, bis ein Gast nach der Wiederherstellung eines Snapshots rückwärts springt.
TLS
Ein Zertifikat trägt ein Gültigkeitsfenster: notBefore und notAfter.
Ein Gast, dessen Uhr nachläuft, weist ein Zertifikat ab, das heute Morgen ausgestellt wurde, weil es nach seinem Kenntnisstand noch nicht gültig ist.
Ein Gast, dessen Uhr vorläuft, weist eines ab, das noch nicht wirklich abgelaufen ist.
Dieselbe Rechnung regiert die Frische von OCSP und CRL, die Ansprüche nbf und exp in einem JWT und TOTP-Codes für die Mehrfaktoranmeldung, die in Fenstern von 30 Sekunden leben.
Eine Uhr, die 45 Sekunden daneben liegt, ist ein Anmeldeausfall mit einer sehr verwirrenden Fehlermeldung.
Ceph
Ceph-Monitore kümmern sich darum mehr als fast alles andere im Stapel, weil ihr Konsens davon abhängt.
Die Gesundheitsprüfung MON_CLOCK_SKEW schlägt an, wenn „the clocks on hosts running Ceph Monitor daemons are not well-synchronized“ — die Uhren auf Hosts mit Ceph-Monitor-Diensten nicht gut abgeglichen sind. Genauer: wenn der Versatz mon_clock_drift_allowed übersteigt.
Der Rat der Dokumentation ist, mit ntpd oder chrony gegen mehrere Quellen abzugleichen, und sie hält fest, dass besonders der Abgleich der Monitore untereinander zählt.
Du kannst mon_clock_drift_allowed hochsetzen, aber die Dokumentation ist klar, dass es „significantly below the mon_lease interval“ bleiben muss, also deutlich unter dem mon_lease-Intervall.
Damit ist es ein kleines Budget, und es dafür auszugeben, ein Zeitproblem des Hypervisors zu übertapezieren, ist kein guter Handel.
Alles Übrige
Protokolle über Hosts hinweg passen nicht mehr zusammen, was aus der Zeitachse eines Vorfalls Rätselraten macht. Datenbank-Replikation und verteilter Konsens — etcd, Galera, alles mit Leader-Leases — werden unglücklich. Fenster für Sicherungen und Überwachung laufen aus dem Takt mit dem, was sie beobachten sollten.
Windows-Gäste laufen anders aus dem Takt
Windows verdient eine eigene Anmerkung, weil sein Zeitdienst mit anderen Zielen gebaut wurde, und das merkt man.
Microsoft sagt klar, dass Versionen vor Windows 10 1607 / Server 2016 „can’t guarantee highly accurate time“ — hochgenaue Zeit nicht zusichern können. Was der Windows-Zeitdienst in diesen Ausgaben lieferte, war „the necessary time accuracy to satisfy Kerberos version 5 authentication requirements“ — die Genauigkeit, die Kerberos Version 5 zum Anmelden braucht — und „loosely accurate time“, also lose genaue Zeit, für Maschinen in einem gemeinsamen AD-Forest. Enger als das war „outside of the design specification… and weren’t supported“ — außerhalb der Entwurfsvorgaben und nicht unterstützt.
Mit anderen Worten: älteres Windows zielt darauf, im Fünf-Minuten-Fenster von Kerberos zu bleiben, nicht darauf, richtig zu liegen. Was in Ordnung ist, bis etwas in deinem Bestand es besser braucht. Eine virtualisierte Windows-Kiste, die 90 Sekunden daneben liegt, meldet sich fröhlich an und schreibt dabei Protokolle, die zu nichts passen.
Windows 10 und Server 2016 und neuer können 1 s, 50 ms oder sogar 1 ms — aber nur unter den oben zitierten Bedingungen, samt der Grenzen für die CPU-Auslastung des Hosts. Microsoft hält außerdem fest, dass „anything that introduces network asymmetry, such as a one-way satellite connection or high CPU load on the target system, will negatively influence accuracy“ — alles, was Asymmetrie ins Netz bringt, etwa eine einseitige Satellitenverbindung oder hohe CPU-Last auf dem Zielsystem, verschlechtert die Genauigkeit. Eine umkämpfte vCPU ist hohe CPU-Last auf dem Zielsystem unter anderem Namen.
Für Windows gibt es kein ptp_kvm. Was du stattdessen hast:
- Hyper-V-Uhren-Enlightenments. Proxmox zeigt die Windows-Gästen schon.
PVE::QemuServer::CPUConfigsetzthv_timenebenhv_vapic,hv_spinlocks,hv_relaxedundhv_synic.hv_timeist die paravirtuelle Uhr und das Windows-seitige Gegenstück zukvm-clock. Das ist für VMs vom Typ Windows standardmäßig an; es gibt nichts einzuschalten. - Der QEMU-Gast-Agent. Mit installiertem Agenten kann der Host seine Zeit nach einem Resume oder der Wiederherstellung eines Snapshots in den Gast schieben, und das deckt genau den Stufenfall ab, mit dem NTP am schlechtesten zurechtkommt.
- Wähle eine Autorität. Der klassische Fehlerfall von Windows in einer VM sind zwei Zeitquellen, die sich streiten: Abgleich vom Host in den Gast und Abgleich über die Domänenhierarchie, die beide dieselbe Uhr in verschiedene Richtungen korrigieren. Lass bei einem Gast in der Domäne die Domänenhierarchie gewinnen und hör auf, dem Host Zeit hineinschieben zu lassen. Bei einem eigenständigen Gast ist Abgleich vom Host in Ordnung. Nie beides.
Willst du genau wissen, was dein Hypervisor einer bestimmten VM über die Zeit erzählt, frag ihn, statt zu raten:
# Everything Proxmox actually passes to QEMU for this VM, including -rtc and CPU flags
qm showcmd <vmid> --pretty
Die Lösung auf QEMU/KVM: ptp_kvm
Für Linux-Gäste auf KVM gibt es eine richtige Antwort, und sie lautet nicht „mehr NTP-Server“.
ptp_kvm lässt den Gast den Host direkt über einen Hypercall nach der Zeit fragen — KVM_HC_CLOCK_PAIRING auf x86 und ein entsprechender Firmware-Aufruf auf arm64.
Der Kernel zeigt das als PTP-Hardware-Uhr, aus dem Userspace sieht es also aus wie jede andere Präzisionsuhr, und chrony kann sie als Referenzuhr nutzen.
Die Eigenschaften, auf die es ankommt:
- Kein Netz. Kein Zittern, keine Asymmetrie, kein Stratum, keine Pakete. Der Weg ist eine Speichergrenze.
- Unter einer Mikrosekunde. Die Genauigkeit wird vom Hypercall begrenzt, nicht von einem Umlauf durch ein Rechenzentrum.
- Es umgeht den kaputten Teil. Der Gast zählt nichts und schätzt keinen Umlauf. Er liest einen Wert, den der Host mit einer Uhr berechnet hat, die die ganze Zeit lief.
Umsetzung
Wende das auf jede Linux-VM an, die den Treiber hat. Der Host-Hypervisor braucht sein eigenes funktionierendes NTP oder PTP. ptp_kvm gibt dem Gast die Zeit des Hosts, er erbt also den Fehler des Hosts.
1. Das Kernel-Modul beim Start laden.
# /etc/modules-load.d/ptp_kvm.conf
ptp_kvm
2. Ihm einen stabilen Namen geben und chrony lesen lassen.
# /etc/udev/rules.d/90-ptp-kvm.rules
ACTION=="add", SUBSYSTEM=="ptp", ATTR{clock_name}=="kvm", SYMLINK+="ptp_kvm", GROUP="chrony", MODE="0660"
Der Symlink zählt, weil die Numerierung der PTP-Geräte nicht stabil ist. /dev/ptp0 kann bei einem Start die Uhr einer NIC sein und beim nächsten die KVM-Uhr. Über clock_name zu greifen holt jedes Mal die richtige.
3. chrony darauf zeigen lassen, und die Pools entfernen.
Bearbeite /etc/chrony/chrony.conf auf Debian und Ubuntu oder /etc/chrony.conf in der RHEL-Familie. Lösche die pool-Zeilen und nutze:
refclock PHC /dev/ptp_kvm poll 2 stratum 1 delay 0.0004
Die Pools zu entfernen ist keine optionale Ordnungsliebe. Sie stehen zu lassen heißt, chrony zu bitten, eine lokale Referenz unter einer Mikrosekunde mit Internet-Servern Dutzende Millisekunden weit in Einklang zu bringen, und die Internetquellen können die Antwort nur verschlechtern.
4. Neu starten und prüfen.
systemctl restart chronyd # or chrony, on Debian/Ubuntu
Prüfen
# The symlink exists and points at the KVM clock
ls -l /dev/ptp_kvm
cat /sys/class/ptp/ptp*/clock_name

# chrony should be using PHC0 as its selected source
chronyc sources -v

# and the offset should be microseconds, not milliseconds
chronyc tracking
In chronyc sources erscheint die PHC-Referenzuhr als #* PHC0, sobald sie gewählt ist. Das # markiert eine lokale Hardware-Referenz statt eines Netz-Partners, und das * markiert sie als die genutzte.
Siehst du sie aufgeführt, aber nicht gewählt, hat chrony sie nicht angenommen: prüf die Rechte am Gerät und dass die Gruppe chrony in der udev-Regel zu dem Nutzer passt, unter dem chrony auf deiner Distribution tatsächlich läuft.
Vorbehalte
- Der Host muss richtig liegen. Das bringt den Gast dazu, mit dem Host übereinzustimmen, was nur nützt, wenn der Host mit der Wirklichkeit übereinstimmt. Gib den Hypervisoren echtes NTP oder PTP.
- Jeder Gast braucht es. Ein Bestand, in dem die Hälfte der VMs
ptp_kvmnutzt und die andere Hälfte Internet-Pools, ist ein Bestand mit zwei Zeitautoritäten. - Live-Migration ist in Ordnung, und das ist der Punkt. Nach der Migration liest der Gast die Uhr seines neuen Hosts. Solange die Hosts miteinander übereinstimmen, sieht der Gast nie eine Stufe.
- Nur KVM. Es ist ein KVM-Hypercall. Geschachtelte oder fremde Hypervisoren zeigen das Gerät nicht, und die udev-Regel greift einfach nicht. Das ist ein sauberes Scheitern statt einer stillen falschen Antwort.
Was man nicht tun sollte
- Erzwing die Clocksource nicht. Lass
kvm-clockin Ruhe.tscoderhpetauf der Kernel-Kommandozeile des Gasts zu erzwingen tauscht eine paravirtuelle Uhr, die für genau diese Lage entworfen wurde, gegen einen Zähler, der dir nie gehörte. - Lass
ntpdateoderhwclocknicht aus cron laufen. Das ist eine Stufe nach Zeitplan, und genau das hassen Datenbanken und Kerberos. - Behalte die Pools nicht „als Rückfall“. Mit einer funktionierenden Referenzuhr sind sie kein Rückfall, sie sind eine zweite Meinung aus schlechterer Quelle.
- Setz nicht
mon_clock_drift_allowedhoch und nenn es behoben. Du hast dann einen Teil eines Budgets ausgegeben, das für die Wirklichkeit im Netz da ist, um ein Problem zu vertragen, für das es eine bekannte Lösung gibt.
Der letzte Punkt ist es wert, klar gesagt zu werden: die Schwelle zu weiten ist nicht, die Uhr zu richten. Es ist, den Alarm zu verschieben, damit er aufhört zu gehen.
Quellen
- Linux-Kernel — KVM timekeeping — warum Gast-Zeit zurückfällt, das Problem des TSC als lokale Uhr und der Schluss, dass es nur Abwägungen gibt
- Linux-Kernel — PTP_KVM — die Hypercall-Schnittstelle hinter dem PTP-Uhren-Gerät
- Linux-Kernel — KVM x86 hypercalls —
KVM_HC_CLOCK_PAIRING, die x86-Seite davon - chrony — chrony.conf — die
refclock-Direktive und die Optionen des PHC-Treibers - MIT Kerberos — krb5.conf —
clockskewund die Voreinstellung von 300 Sekunden - Microsoft — support boundary for high accuracy time — die Genauigkeitsziele und die Bedingungen zur CPU-Auslastung des Hosts für virtualisierte Systeme
- Ceph — health checks —
MON_CLOCK_SKEW,mon_clock_drift_allowedund der Zusammenhang mitmon_lease