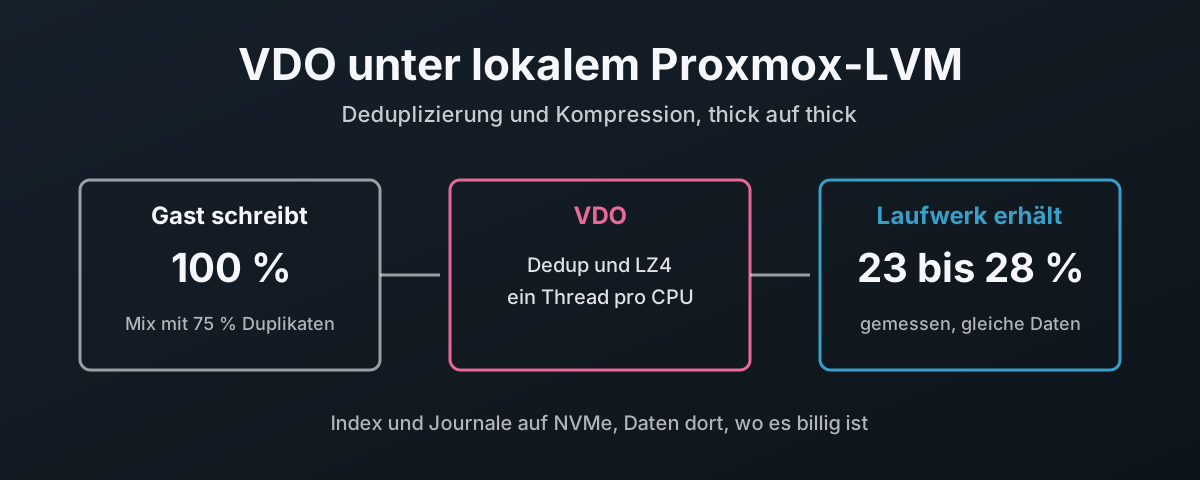
Weniger Bytes erreichen das Laufwerk
VDO ist die Deduplizierungs- und Kompressionsschicht des Linux-Kernels. Es sitzt unter einer Volume Group und arbeitet in Blöcken zu 4 KiB. Jeden Block, den es schon einmal gesehen hat, speichert es nur einmal.
Was das für die Hardware heißt, ist einfach. Weniger Bytes erreichen das Laufwerk. Ich habe einen Mix aus 75 % Duplikaten und 50 % komprimierbaren Daten jeweils 30 Sekunden lang durch VDO geschrieben, und laut den eigenen Zählern des Laufwerks hat es 23 bis 28 % von dem erhalten, was der Gast geschrieben hat. Sechs Full Clones einer Template-Disk haben zusammen 8 Datenblöcke hinzugefügt. Zweiunddreißig Kilobyte.
Weniger Bytes heißt weniger Verschleiß, und weniger Arbeit für jeden Cache auf dem Laufwerk oder im Controller davor. Dahin zu kommen kostet CPU und Latenz, und auf einem schnellen Laufwerk wird dieser Preis weiter unten an derselben Optane ganz ohne VDO gemessen. Auf langsamen drehenden Platten verschwindet derselbe Preis in den Seek-Zeiten, und da wird es interessant.
Zwei Regeln prägen alles, was folgt. Der Stack ist thick auf thick: Nichts über VDO, und VDO selbst auch nicht, kann mehr Platz versprechen, als das Laufwerk hat. Und die eigenen Metadaten von VDO, sein Index und seine Journale, können auf NVMe liegen, während die Daten irgendwo Langsameres liegen.
Jede Zahl hier stammt von einem einzigen Proxmox-VE-9.2-Host, einem Ryzen 7 5700G mit 16 CPUs, Kernel 7.0.14-25-pve, LVM 2.03.31 und den Debian-vdo-Tools 8.3.1.1, auf zwei Intel-Optane-Laufwerken, die hinterher gelöscht wurden.
Was VDO ist und wo es sitzt
Der Kernel beschreibt dm-vdo als Device-Mapper-Target, das „provides block-level deduplication, compression, and thin provisioning“1. Jeder eingehende 4-KiB-Block wird gehasht. Ist ein identischer Block schon gespeichert, legt VDO eine Referenz statt einer Kopie an. Blöcke, die keine Duplikate sind, laufen durch LZ4 und werden zu mehreren in einen physischen Block gepackt, und Blöcke, die nur aus Nullen bestehen, werden gar nicht gespeichert2.
LVM steuert das Ganze.
lvcreate --type vdo legt einen VDO-Pool an, der die echten Blöcke hält, und darauf ein VDO-LV mit der virtuellen Größe, die du verlangst2.
Eine thick Volume Group kommt auf das VDO-LV, und Proxmox nutzt sie als ganz normalen lvm-Storage.
| Schicht | Name im Lab | Was sie tut |
|---|---|---|
| VM-Disks | vm-9901-disk-0 und so weiter | thick LVs, von Proxmox angelegt |
| Volume Group | vdovg, 35 GiB | einfaches LVM, das liest der lvm-Storage von Proxmox |
| VDO-LV | vdolab/vdolv, 35 GiB virtuell | Dedup, LZ4, Nullblöcke verworfen |
| VDO-Pool | vdolab/vdopool, 40 GiB | die echten Blöcke, Metadaten und Index von VDO |
| Physisch | nvme8n1 | VG vdolab |
Thick auf thick, oder gar nicht
VDO ist selbst ein Thin-Provisioner: Dem VDO-LV lässt sich jede beliebige virtuelle Größe geben. Mach es größer, als der Pool fassen kann, und die Volume Group darüber steht thick auf einem Versprechen, und das ist thin auf thin, nur eine Schicht tiefer. Genau das habe ich beim ersten Aufbau gemacht, ein 120-GiB-VDO-LV auf einem 40-GiB-Pool, und Proxmox zeigte ein Drittel des Storage als frei, während VDO voll war.
Also bemiss das VDO-LV auf das, was der Pool tatsächlich adressieren kann, und nicht mehr.
lvcreate gibt diese Zahl aus, „can address 36.00 GB“ bei diesem 40-GiB-Pool, und die Block-Map von VDO für den logischen Platz kommt aus demselben Raum, also habe ich ihm 35 GiB gegeben.
Dann habe ich es auf die harte Tour nachgewiesen. Eine VM-Disk, die jeden Extent nimmt, den Proxmox hergibt, 34 GiB, von vorn bis hinten mit Zufallsdaten gefüllt, mit denen VDO nichts anfangen kann:
# vdostats --human-readable
Device                    Size      Used Available Use% Space saving%
vdolab-vdopool-vpool     40.0G     38.1G      1.9G  95%            0%
Die Disk lief an ihrem eigenen Ende voll, wie es eine thick Disk soll. VDO hatte noch 1,9 GiB frei, mehr als das 1 GiB, das Proxmox noch zu vergeben hatte. Die Zahl von Proxmox ist die echte Grenze, und VDO kann nicht zuerst volllaufen.
Was du aufgibst, ist das Überbuchen: Der Platz, den die Deduplizierung spart, zeigt sich als Laufwerk, das nie beschrieben wird, nicht als zusätzliche Disks für Proxmox. Für diesen Beitrag, in dem es um die Hardware geht, ist das der richtige Tausch. Und setz auch keinen lvmthin-Pool darauf. Zwei Thin-Schichten sind zwei Buchführungen3.
Was es kostet, bevor du ein Byte speicherst
VDO führt einen Deduplizierungsindex, den UDS-Index, auf dem Pool selbst.
Ein leerer 40-GiB-Pool meldete 4,0 GiB belegt und 36,0 GiB verfügbar.
vdolistmetadata aus demselben vdo-Paket listet jeden Metadatenblock auf dem Gerät auf und erklärt fast alles davon:
| Bereich | 4-KiB-Blöcke | Größe |
|---|---|---|
| UDS-Index | 679.127 | 2,59 GiB |
| Recovery-Journal | 32.768 | 128 MiB |
| Referenzzähler und Journale, 18 Slabs | 6.372 | 25 MiB |
| Platz, zu klein für einen neunzehnten Slab | 336.555 | 1,28 GiB |
| Gesamt | etwa 4,0 GiB |
Die Restzeile lohnt sich zu kennen: Slabs sind 2 GiB groß, also bemiss den Pool in ganzen Slabs plus Overhead, sonst bleibt der Rest einfach ungenutzt.
RAM ist die andere Rechnung. Sie wird bezahlt, ob der Pool beschäftigt ist oder nicht:
| Kosten | Regel aus lvmvdo(7) | Dieser 40-GiB-Pool |
|---|---|---|
| Fest | 38 MiB | 38 MiB |
| Block-Map-Cache | 1,15 MiB pro MiB Cache, mindestens 150 MiB | 150 MiB (128 MiB Standard) |
| Physischer Platz | 268 MiB pro TiB | 11 MiB |
| UDS-Index (dense) | mindestens 250 MiB, der Standard | 256 MiB |
| Gesamt | etwa 455 MiB |
Der standardmäßige Dense-Index deckt ein Deduplizierungsfenster von ungefähr 256 GiB ab, denn ein Dense-Index mit 1 GiB RAM „maintains a 1 TiB deduplication window“2. Der Block-Map-Cache von 128 MiB ist bemessen für „efficient access to 100 GB of logical space at a time“, und die Kernel-Dokumentation nennt ihn den wichtigsten Wert, den man anpasst, wenn der Working Set wächst1.
Den Stack aufbauen
LVM ein PV auf einem LV sehen lassen
Die Volume Group sitzt auf einem LV, und LVM ignoriert LVs als Physical Volumes standardmäßig.
devices/scan_lvs schaltet das ein, und die Referenz von LVM bringt die passende Warnung gleich mit: „Caution is required to avoid using PVs that belong to guest images stored on LVs“4.
Bei einem Gast, der in seiner eigenen Disk LVM nutzt, würden sonst dessen Volume Groups auf dem Host auftauchen.
Also ändert sich auch der Filter. Derselbe Eingriff. Der mitgelieferte Filter auf diesem Host wies nur ZFS-Zvols und RBD-Geräte ab. Ich habe eine Abweisung für jede Proxmox-VM-Disk ergänzt:
# lvmconfig devices/global_filter devices/scan_lvs
global_filter=["r|/dev/zd.*|","r|/dev/rbd.*|","r|/dev/mapper/.*-(vm|base)--[0-9]+--disk--[0-9]+|"]
scan_lvs=1
Dieselbe Referenz sagt, dass scan_lvs „does not enable autoactivation of layered VGs“4.
Proxmox braucht das auch nicht. Sein LVM-Plugin aktiviert jede Disk mit lvchange -aey, wenn die VM startet5.
Ich habe es so getestet, wie ein Boot die Dinge hinterlässt, alles deaktiviert und dann dieselben pvscan-udev-Läufe: Die VG unter VDO kam hoch, und qm start aktivierte die Disk der VM selbst.
Der Haken liegt darunter. War die VG unter VDO unvollständig, scheiterte dasselbe qm start mit „Volume group ‚vdovg‘ not found“.
Der VDO-Pool, thick, mit seinen Einstellungen in der Anlegezeile
Das Formatierwerkzeug steckt in Debians vdo-Paket6:
# apt install vdo
Dann der Pool.
-L ist der echte Platz, -V die virtuelle Größe, innerhalb dessen gehalten, was der Pool adressieren kann.
Das Thread-Layout und die Discard-Größe kommen in dieselbe Zeile, weil sich keins von beiden später ändern lässt, ohne jede VM auf dem Pool anzuhalten:
# pvcreate /dev/nvme8n1
  Physical volume "/dev/nvme8n1" successfully created.
# vgcreate vdolab /dev/nvme8n1
  Volume group "vdolab" successfully created
# lvcreate -y --type vdo -L 40G -V 35G -n vdolv vdolab/vdopool /dev/nvme8n1 --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  Wiping vdo signature on /dev/vdolab/vdopool.
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "vdolv" created.
# dmsetup table vdolab-vdopool-vpool
0 73402368 vdo V4 /dev/dm-7 10485760 4096 32768 16380 deduplication on compression on maxDiscard 4096 ack 1 bio 2 bioRotationInterval 64 cpu 3 hash 2 logical 4 physical 4
Das Thread-Layout ist das, das weiter unten für einen Host mit 16 CPUs gemessen wird; max_discard=4096 hat einen eigenen Abschnitt.
Die Volume Group und der Proxmox-Storage
# pvcreate /dev/vdolab/vdolv
  Physical volume "/dev/vdolab/vdolv" successfully created.
# vgcreate vdovg /dev/vdolab/vdolv
  Volume group "vdovg" successfully created
# pvesm add lvm vdo-lvm --vgname vdovg --content images,rootdir --on-volume-remove discard=1
# pvesm status | grep -E "Name|vdo-lvm"
Name             Type     Status     Total (KiB)      Used (KiB) Available (KiB)        %
vdo-lvm           lvm     active        36696064               0        36696064    0.00%
on-volume-remove discard=1 ist wichtig, und es wird weiter unten behandelt.
Was die Deduplizierung gespart hat
Ich habe Dinge geschrieben, die ein Proxmox-Host tatsächlich speichert, und nach jedem die Blockzähler von VDO gelesen.
logical blocks used ist, was die Schichten darüber geschrieben haben; data blocks used ist, was VDO gespeichert hat. Beides sind 4-KiB-Blöcke.
| Was geschrieben wurde | Logische Blöcke dazu | Datenblöcke dazu | Gespart |
|---|---|---|---|
| Rocky-Linux-10-Rootfs, ext4 auf einer 4-GiB-Disk | 114.505 | 60.537 | 47 % |
Sechs Full Clones davon (qm clone --full, je etwa 4 s) | 6.291.456 | 8 | 99,9999 % |
| Proxmox-Datacenter-Manager-1.1-ISO, 1,36 GiB | 356.172 | 351.965 | 1,2 % |
Sein -auto-Neubau, praktisch dieselben Bytes | 356.399 | 40 | 99,99 % |
| 4 GiB Nullen | 1.048.575 | 0 | 100 % |
| 1 GiB Zufallsdaten | 262.143 | 262.144 | 0 % |
Jeder Clone hat die vollen 4 GiB geschrieben, Nullen eingeschlossen, denn ein Full Clone auf ein thick LV kopiert jeden Block. VDO hat die Nullen als nichts gespeichert und den Rest als Referenzen.
VDO ist sehr gut bei Daten, die es schon gesehen hat. Und bei nichts. Bei Daten, die schon komprimiert oder verschlüsselt sind, ist es nutzlos, und deshalb hat das erste ISO, größtenteils squashfs, 1,2 % gespart.
Mit dem Template und seinen sechs Clones zeigte Proxmox den Storage zu 80,01 % belegt, 28 GiB thick Disks von 35. Das Laufwerk hielt 4,3 GiB, und das meiste davon war der Index. Auf thick Storage ist genau das der Punkt: Proxmox zählt, was zugewiesen ist, und das Laufwerk trägt, was tatsächlich verschieden ist.
Was das Laufwerk tatsächlich erhält
Einsparungen auf der Disk sind eine Momentaufnahme. Die Hardware interessiert der Strom.
Also habe ich die Bytes gemessen, die während des Schreibens beim Laufwerk ankommen: fio für 30 Sekunden, der Schreibzähler des Laufwerks aus /sys/block davor und danach, dieselbe Optane mit und ohne VDO, jeweils zweimal.
Der Zähler ist ehrlich. Über den ganzen Lauf summierte er sich auf 794 GB, und die eigenen SMART-„Data Units Written“ des Laufwerks bewegten sich ebenfalls um 794 GB.
| Workload, 30 s | Ohne VDO | Mit VDO, 16 Threads | Bytes beim Laufwerk |
|---|---|---|---|
| 4k zufällig schreiben, QD32, 4 Jobs, 75 % Dup., 50 % kompr. | 582.013 IOPS, p99 244 µs | 460.887 IOPS, p99 1,05 ms | 28 % |
| 128k schreiben, QD8, 75 % Dup., 50 % kompr. | 2.345 MiB/s, p99 490 µs | 2.179 MiB/s, p99 1,02 ms | 23 % |
| 4k zufällig schreiben, QD32, 4 Jobs, Zufallsdaten | 571.721 IOPS | 272.366 bis 381.005 IOPS | 59 bis 100 % |
| 128k schreiben, QD8, Zufallsdaten | 2.346 MiB/s | 1.051 bis 1.854 MiB/s | 100 % |
Bei einem realistischen Mix behielt VDO 79 bis 93 % des Durchsatzes des nackten Laufwerks und schickte ihm ein Viertel der Bytes. Bei reinen Zufallsdaten spart es nichts und kostet viel, und die beiden Läufe lagen so weit auseinander, dass ich nur die Spanne angebe.
Die Tail-Latenz ist die eigene Verarbeitung von VDO, nicht das Laufwerk. Ein p99 von etwa einer Millisekunde, gegenüber einer Viertelmillisekunde ohne.
Die Optane hat keinen Cache, den man entlasten könnte
Die Laufwerke sagen es selbst: vwc 0 aus nvme id-ctrl, write through in /sys/block.
Eine Optane schreibt direkt an Ort und Stelle, ohne DRAM- oder SLC-Zwischenspeicher, also liegt der Gewinn auf dieser Hardware in den Bytes und im Verschleiß, nicht in einem Laufwerkscache, der langsamer vollläuft.
Eine NAND-SSD mit SLC-Cache oder ein RAID-Controller mit Write-back-Cache, da kauft man mit weniger Bytes auch Reaktionsfähigkeit. Das ist der RAID6-Abschnitt weiter unten.
Die Threads von VDO an die CPUs anpassen
Ab Werk gibt LVM VDO zehn Threads: einen logischen, einen physischen, eine Hash-Zone, zwei CPU, vier für Bio-Submission, einen für Acknowledgements. Auf einem Host mit 16 CPUs lässt das den Großteil der Maschine brachliegen, während sich die Block-Map-Arbeit von VDO hinter einem einzigen logischen Thread staut.
Die Kernel-Dokumentation erklärt die Stellschrauben1. Logische Threads besitzen jeweils „a disjoint section of the block map“, physische Threads „a disjoint section of the data blocks“, und beide „can increase throughput“, während überzählige Threads „can waste resources and increase contention“. Logische Threads gehen bis 60, physische bis 16, und der Pool braucht mindestens einen Slab pro physischem Thread. Bei 18 Slabs hat dieser hier Luft.
| Layout | logical | physical | hash | cpu | bio | ack | Gesamt |
|---|---|---|---|---|---|---|---|
| LVM-Standard | 1 | 1 | 1 | 2 | 4 | 1 | 10 |
| Passend zu 16 CPUs | 4 | 4 | 2 | 3 | 2 | 1 | 16 |
| Doppelt so viele | 8 | 8 | 4 | 6 | 2 | 2 | 30 |
Jedes Layout lief dieselben fio-Jobs zweimal, abwechselnd, mit Zufallsdaten, dazu alle sieben Clone-Disks gleichzeitig gelesen, so wie sieben VMs zusammen booten:
| Test, Mittel aus zwei Läufen | Standard | Passend zu 16 CPUs | Doppelt so viele |
|---|---|---|---|
| 4k zufällig schreiben, QD32, 4 Jobs | 292.466 IOPS | 365.314 IOPS | 302.461 IOPS |
| 4k zufällig schreiben p99, 4 Jobs | 2,1 bis 3,7 ms | 1,5 bis 1,6 ms | 2,1 bis 2,2 ms |
| 1M sequenziell schreiben | 1.153 MiB/s | 1.729 MiB/s | 1.507 MiB/s |
| 4k zufällig lesen, QD32, 4 Jobs | 507.450 IOPS | 503.827 IOPS | 485.263 IOPS |
| Sieben Clone-Disks gleichzeitig gelesen | 7,5 s | 3,1 s | 3,4 s |
Passend zur CPU-Zahl gewinnt fast alles: ein Viertel mehr parallele Schreibzugriffe, halb so viel noch einmal dazu bei sequenziellem Schreiben, sieben Disks 2,4-mal schneller gelesen und ein engerer Tail. Noch einmal verdoppeln ist durchweg schlechter. Das ist die Contention, vor der die Dokumentation warnt. Die Standardwerte waren außerdem am wenigsten stabil, das Lesen der sieben Disks schwankte zwischen den Läufen von 6,1 bis 8,8 s.
Die Regel ist damit ein VDO-Thread pro CPU, auf die Typen verteilt wie oben, mit den physischen Threads durch die Slab-Zahl gedeckelt.
Was VDO auf schneller Hardware kostet
Dieselbe Optane ohne VDO gegen VDO mit passenden Threads, Zufallsdaten, Mittel aus zwei Läufen:
| Test | Optane, ohne VDO | VDO, 16 Threads |
|---|---|---|
| 4k zufällig schreiben, QD1 | 42.294 IOPS, 19,4 µs | 55.806 IOPS, 12,1 µs |
| 4k zufällig schreiben, QD32 | 142.416 IOPS | 144.292 IOPS |
| 4k zufällig schreiben, QD32, 4 Jobs | 572.293 IOPS | 365.314 IOPS |
| 4k zufällig lesen, QD1 | 55.276 IOPS, 14,4 µs | 27.988 IOPS, 31,4 µs |
| 4k zufällig lesen, QD32, 4 Jobs | 586.463 IOPS | 503.827 IOPS |
| 1M sequenziell schreiben, QD8 | 2.348 MiB/s | 1.729 MiB/s |
| Sieben Template-Disks gleichzeitig gelesen | 11,1 s | 3,1 s |
Lies es ganz nüchtern. Ein einzelner zufälliger Lesezugriff dauert durch VDO mehr als doppelt so lange. Parallele zufällige Schreibzugriffe verlieren mehr als ein Drittel, sequenzielle ein Viertel. Auf einem so schnellen Laufwerk sind die 17 µs Zusatzarbeit von VDO pro Lesezugriff der größte Teil des Lesezugriffs.
Dass der QD1-Schreibzugriff durch VDO schneller ist, ist kein Geschenk. Weit gefehlt. VDO bestätigt einen Schreibzugriff, bevor er auf dem Laufwerk ist, und die Kernel-Dokumentation sagt klar, dass „unflushed writes may or may not persist after a crash“1. Diese Zahl misst eine Bestätigung. Ein Gast, der flusht, und das tut jedes Dateisystem, bekommt die Dauerhaftigkeit, die er verlangt.
Die Zeile mit den sieben Disks ist die, die VDO klar gewinnt, und es lohnt sich, deutlich zu sagen, warum. Sieben einfache Kopien müssen 28 GiB echter Bytes lesen, Nullen eingeschlossen. VDO liest einen Satz gemeinsamer Blöcke und überspringt die Nullen.
Auf schnellem Flash tauscht VDO also Latenz gegen Bytes. Jede dieser Mikrosekunden ist aber Fixkosten, und sie wächst nicht, wenn das Laufwerk darunter langsamer wird.
Die Metadaten von VDO auf NVMe legen
VDO hat kein eigenes Metadatengerät. Alles liegt auf dem einen Pool-LV. Der dm-vdo-Quellcode zeigt aber, dass das Layout fest ist, und ein LV lässt sich aus Stücken auf verschiedenen Laufwerken bauen.
Der Formatierungscode legt die Block-Map-Wurzeln vom Anfang des Datenbereichs an, dann die Slab-Summary und das Recovery-Journal vom Ende her, und füllt die Mitte mit Slabs7.
Der UDS-Index sitzt vor all dem, direkt nach dem Geometrieblock.
vdolistmetadata hat das auf dem Lab-Pool bestätigt:
| Blöcke | Was | Wo es sitzt |
|---|---|---|
| 0 bis 679.188 | Geometrie, UDS-Index, Superblock, Block-Map-Wurzeln | die ersten 2,59 GiB |
| in jedem 2-GiB-Slab | Daten, Block-Map-Blätter, 130 Referenzblöcke und ein Slab-Journal aus 224 Blöcken | über den ganzen Pool verteilt |
| 10.452.928 bis 10.485.695 | Recovery-Journal | die letzten 128 MiB, beinahe |
| 10.485.696 bis 10.485.759 | Slab-Summary | die allerletzten 256 KiB |
Also bau das Pool-LV aus drei Stücken: der Kopf auf NVMe, die Mitte auf dem langsamen Laufwerk, das Ende auf NVMe.
Dann wandle es in einen VDO-Pool um, was lvmvdo(7) für ein bestehendes LV dokumentiert2.
Hier steht nvme6n1 für die NVMe und nvme8n1 für das langsame Laufwerk:
# lvcreate -y -L 3G -n splitpool vdolab /dev/nvme6n1
  Logical volume "splitpool" created.
# lvextend -l +9408 vdolab/splitpool /dev/nvme8n1
  Size of logical volume vdolab/splitpool changed from 3.00 GiB (768 extents) to 39.75 GiB (10176 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvextend -l +64 vdolab/splitpool /dev/nvme6n1
  Size of logical volume vdolab/splitpool changed from 39.75 GiB (10176 extents) to 40.00 GiB (10240 extents).
  Logical volume vdolab/splitpool successfully resized.
# lvconvert -y --type vdo-pool -n splitlv -V 35G vdolab/splitpool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
  WARNING: Converting logical volume vdolab/splitpool to VDO pool volume with formatting.
  THIS WILL DESTROY CONTENT OF LOGICAL VOLUME (filesystem etc.)
    The VDO volume can address 36.00 GB in 18 data slabs, each 2.00 GB.
    It can grow to address at most 16.00 TB of physical storage in 8192 slabs.
    If a larger maximum size might be needed, use bigger slabs.
  Logical volume "splitlv" created.
  Converted vdolab/splitpool to VDO pool volume and created virtual vdolab/splitlv VDO volume.
Dann prüf, ob VDO seine Metadaten dorthin gelegt hat, wo die Extents liegen:
# vdolistmetadata /dev/mapper/vdolab-splitpool_vdata | grep -v "slab [0-9]* \(reference\|journal\)"
0 .. 0: geometry block
1 .. 679127: index
679128 .. 679128: super block
679129 .. 679188: block map tree roots
10452928 .. 10485695: recovery journal
10485696 .. 10485759: slab summary
Ein Extent sind 1.024 Blöcke. Der NVMe-Kopf sind die Extents 0 bis 767, Blöcke 0 bis 786.431, und das deckt Index und Wurzeln ab, mit etwa 420 MiB Daten des ersten Slabs als Beifang. Das NVMe-Ende sind die Extents 10.176 bis 10.239, Blöcke ab 10.420.224, und das deckt Recovery-Journal und Slab-Summary ab.
Wie viel von der Arbeit von VDO mitwandert, pro 30-Sekunden-Lauf, je Gerät gezählt:
| Workload | Schreib-I/Os NVMe | Schreib-I/Os Datenlaufwerk | Anteil NVMe |
|---|---|---|---|
| 4k zufällig schreiben, 75 % Dup., 50 % kompr. | 388.430 bis 538.223 | 3,42 bis 3,63 Millionen | 10 bis 13 % |
| 128k schreiben, 75 % Dup., 50 % kompr. | 458.214 bis 634.167 | 3,30 bis 3,53 Millionen | 12 bis 15 % |
| 4k zufällig schreiben, Zufallsdaten | 181.457 bis 384.507 | 3,25 bis 8,49 Millionen | 4 bis 5 % |
| 4k zufällig lesen | 0 Schreibzugriffe, 2 % der Lesezugriffe | 0 |
Ungefähr ein Zehntel der Schreiboperationen: das Recovery-Journal, Index-Updates und das Stück von Slab 0 auf dem NVMe-Kopf. Es sind kleine, verstreute Metadaten-Schreibzugriffe, genau die Sorte, mit der eine drehende Platte am schlechtesten klarkommt. Auf NVMe sind sie nichts.
Zwei Grenzen.
Die Metadaten pro Slab, Referenzzähler, Slab-Journale und Block-Map-Blätter, leben in den Slabs und bleiben bei den Daten.
Und das Vergrößern eines aufgeteilten Pools habe ich nicht getestet. Das Journal wird vom Ende her platziert, also lass nach jedem lvextend noch einmal vdolistmetadata laufen und schau, wo es gelandet ist, bevor du dich darauf verlässt.
VDO auf bcache: eine NVMe, zwei Aufgaben
bcache ist der andere Weg, Flash vor langsame Platten zu setzen. Ich betreibe es bereits unter Ceph auf drehenden Laufwerken, mit jeder Einstellung erklärt in dem bcache-Beitrag. Die Frage ist also, was VDO mit einem bcache-Cache macht, wenn es darauf sitzt.
Eine NVMe erledigt beide Flash-Aufgaben, aufgeteilt in zwei Partitionen:
| Gerät | Größe | Aufgabe |
|---|---|---|
nvme8n1p1 | 32 GiB | bcache-Cache, Writeback |
nvme8n1p2 | 8 GiB | Kopf und Ende von VDO: Index, Wurzeln, Recovery-Journal, Slab-Summary |
nvme6n1 | 349 GiB | bcache-Backing-Gerät, wo die Daten liegen |
/dev/bcache0 | 349 GiB | die Mitte des VDO-Pools, die Slabs |
Beide Laufwerke sind wieder Optanes, nvme6n1 steht also für eine drehende Platte.
Behalt das bei jeder Zahl unten im Kopf. Das Backing-Gerät ist hier schnell, also misst das, was beim Cache ankommt, nicht, wie lange eine Spindel braucht, um ihn zu leeren.
Die Partitionen und das Cache-Set, mit den Einstellungen aus jenem Beitrag:
# sgdisk --zap-all /dev/nvme8n1
# sgdisk -n 1:0:+32G -c 1:bcache-cache -n 2:0:+8G -c 2:vdo-meta /dev/nvme8n1
# blockdev --rereadpt /dev/nvme8n1
# apt install bcache-tools
# make-bcache -C /dev/nvme8n1p1 -B /dev/nvme6n1 --writeback
# B=/sys/block/bcache0/bcache
# echo 0 > $B/sequential_cutoff
# echo 40 > $B/writeback_percent
# echo 81920 > $B/writeback_rate
# echo 20480 > $B/writeback_rate_minimum
# CS=/sys/fs/bcache/47bac36f-a1d5-4e8e-8695-2e7ff944172d
# echo 0 > $CS/congested_read_threshold_us
# echo 0 > $CS/congested_write_threshold_us
Diese echo-Zeilen halten bis zum nächsten Reboot. Die udev-Regel im bcache-Beitrag sorgt dafür, dass sie bleiben.
Dann der Pool, genauso aufgeteilt wie oben, mit nvme8n1p2 für die beiden Enden und bcache0 für die Mitte:
# pvcreate /dev/bcache0 /dev/nvme8n1p2
# vgcreate vdolab /dev/bcache0 /dev/nvme8n1p2
# lvcreate -y -L 3G -n vdopool vdolab /dev/nvme8n1p2
# lvextend -l +9408 vdolab/vdopool /dev/bcache0
# lvextend -l +64 vdolab/vdopool /dev/nvme8n1p2
# lvconvert -y --type vdo-pool -n vdolv -V 35G vdolab/vdopool --vdosettings "logical_threads=4 physical_threads=4 hash_zone_threads=2 cpu_threads=3 bio_threads=2 ack_threads=1 max_discard=4096"
# lvs -a --segments -o lv_name,lv_size,segtype,seg_start_pe,seg_size_pe,devices vdolab
  LV              LSize  Type     Start SSize Devices
  vdolv           35.00g vdo          0  8960 vdopool(0)
  vdopool         40.00g vdo-pool     0 10240 vdopool_vdata(0)
  [vdopool_vdata] 40.00g linear       0   768 /dev/nvme8n1p2(0)
  [vdopool_vdata] 40.00g linear     768  9408 /dev/bcache0(0)
  [vdopool_vdata] 40.00g linear   10176    64 /dev/nvme8n1p2(768)
vdolistmetadata gab dieselben Blockbereiche aus wie beim aufgeteilten Aufbau, also sitzen der Index und beide Journale auf nvme8n1p2.
vdovg und der Proxmox-Storage kommen genau wie vorher obendrauf.
Was beim Cache ankommt
Der Vergleich ist ein 8-GiB-LV direkt auf bcache0 gegen ein 8-GiB-LV in vdovg, dieselben fio-Jobs für 30 Sekunden, zweimal, mit vor jedem Lauf sauber geleertem Cache.
Die Gerätezähler in /sys/class/block sagen, wohin die Bytes gegangen sind.
| 75 % Dup., 50 % kompr., 30 s | nur bcache | VDO auf bcache |
|---|---|---|
| 4k zufällig schreiben, QD32, 4 Jobs | 212.222 und 205.585 IOPS | 390.206 und 304.757 IOPS |
| p99 | 1,89 und 2,04 ms | 1,45 und 2,54 ms |
| Gast hat geschrieben | 24,29 und 23,53 GiB | 44,67 und 34,88 GiB |
| In den bcache-Cache geschrieben | 25,00 und 24,26 GiB | 11,48 und 10,44 GiB |
| Auf die Metadaten-Partition von VDO geschrieben | 1,18 und 0,59 GiB | |
| Cache-Schreibzugriffe pro Gast-Byte | 103 % | 26 und 30 % |
| Am Ende dirty im Cache | 6,0 und 6,5 GiB | 5,5 und 5,2 GiB |
| 128k schreiben, QD8 | 2.001 und 1.985 MiB/s | 1.878 und 1.416 MiB/s |
| Cache-Schreibzugriffe pro Gast-Byte, 128k | 101 % | 24 und 27 % |
bcache allein war bei etwa 210.000 kleinen Schreibzugriffen pro Sekunde am Ende, und es schrieb jedes Byte in den Cache plus 3 % eigene. Setz VDO davor, und der Cache nahm ein Viertel der Bytes. Im ersten Lauf trug derselbe Cache dann 390.206 Schreibzugriffe pro Sekunde, fast doppelt so viele, und hatte am Ende trotzdem weniger dirty Daten, die auf das langsame Laufwerk warteten. Der Cache war die Grenze. VDO hat sie verschoben.
Der zweite Lauf ist der ehrliche für einen Pool, der schon in Gebrauch war. fio seedet seine Generatoren standardmäßig bei jedem Lauf gleich8, also schrieb Lauf zwei Daten, die der Index schon gesehen hatte, mit Verweisen auf Blöcke, die inzwischen per Discard freigegeben waren. VDO behandelt den Index als Hinweise und liest jeden Kandidatenblock, um zu prüfen, ob er wirklich ein Duplikat ist, bevor es ihn teilt9. Während eines reinen Schreibtests las dieser zweite Lauf 7,11 GiB aus dem Cache zurück und 1,20 GiB vom Datenlaufwerk. Der erste las 0,12 GiB. Veraltete Hinweise gibt es nicht umsonst, und auf einem Pool, auf dem VMs kommen und gehen, wird es immer ein paar davon geben.
Zufallsdaten sind die andere Seite davon:
| Zufallsdaten, 30 s | nur bcache | VDO auf bcache |
|---|---|---|
| 4k zufällig schreiben, QD32, 4 Jobs | 205.984 und 203.066 IOPS | 203.186 und 85.882 IOPS |
| p99 | 2,04 und 2,15 ms | 5,7 und 17,7 ms |
| 128k schreiben, QD8 | 2.038 und 2.017 MiB/s | 878 und 357 MiB/s |
| 4k zufällig lesen, QD1 | 36.609 und 36.639 IOPS, 21,6 µs | 26.345 und 26.202 IOPS, 33,6 und 33,7 µs |
| 4k zufällig lesen, QD32, 4 Jobs | 471.585 und 471.730 IOPS | 335.461 und 336.941 IOPS |
Nichts zu sparen, also ist VDO reiner Overhead, und im Lauf mit veraltetem Index hat es die kleinen Schreibzugriffe mehr als halbiert. Jeder Lesezugriff in beiden Spalten kam aus dem Cache. Die 12 µs von VDO obendrauf sind dieselben Fixkosten, die es auf der nackten Optane hinzufügt.
Wo sich die Daten wiederholen, passen die beiden also gut übereinander. Der Cache bekommt ein Viertel der Bytes, übersteht einen Burst länger und hat weniger auf die Spindeln zurückzuschreiben. Wo sie sich nicht wiederholen, ist bcache allein besser dran.
Auf HDD-Hardware-RAID6: durchdacht, nicht gemessen
Ich habe keinen HDD-RAID6-Host zum Testen, also ist dieser Abschnitt eine Überlegung, die auf den Messungen oben aufbaut. Miss dein eigenes Array, bevor du dich darauf verlässt.
| Auf HDD-RAID6 | Was VDO ändert |
|---|---|
| Schreibzugriffe, die beim Array ankommen | etwa ein Viertel, bei einem Mix wie dem gemessenen |
| Write-back-Cache des Controllers | füllt sich mit einem Viertel der Rate, übersteht einen Burst also etwa viermal so lange |
| CPU-Kosten von VDO | 17 µs pro Lesezugriff, verloren in einem Seek von 5 bis 10 ms |
| Schreibzugriffe aufs Recovery-Journal | ungefähr ein Zehntel der Schreib-I/Os, klein und geflusht: auf NVMe damit |
| Index-Lookups | dedupe advice timeouts in vdostats beobachten; auf langsamem Storage kann VDO die Suche aufgeben und das Duplikat trotzdem schreiben |
| Einen Clone von vorn bis hinten lesen | langsamer: seine Blöcke zeigen zurück in die des Templates, verstreut über das Array |
Die ersten beiden Zeilen sind die Antwort für die Hardware. Solange der batterie- oder flashgestützte Cache des Controllers Platz hat, sieht der Gast Cache-Latenz. Wenn er voll ist, sieht der Gast die Spindeln. Schick ihm ein Viertel der Bytes, und derselbe Cache hat etwa viermal so viel Reserve und nur ein Viertel so viel abzuarbeiten. Der bcache-Abschnitt oben ist genau das, gemessen mit einem Software-Cache anstelle des Controller-Caches.
Die dritte ist der Grund, warum VDO eher auf langsame Platten gehört als auf schnelle. Auf der Optane hat VDO die Leselatenz verdoppelt. Auf Laufwerken mit 7.200 U/min verschwinden dieselben Fixkosten in einem einzigen Seek.
Die letzten drei sind die Kosten. Ein Boot-Sturm identischer Clones wird schneller, aber ein einzelner Clone, von vorn bis hinten gelesen, wird langsamer, weil die Deduplizierung ihn verstreut. Und die eigenen kleinen Schreibzugriffe von VDO landen auch auf dem Array, und das spricht für das aufgeteilte Layout oben: Index und Journal auf NVMe, Slabs auf dem RAID6.
Eine Disk löschen: Proxmox zum Discard bringen
Das Entfernen eines LV gibt in LVM seine Extents frei. Es sagt VDO nicht, dass die Blöcke ungenutzt sind, also behält VDO sie. Die Kernel-Dokumentation sagt, warum das zählt: „If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space“1. Auf thick Storage kann es nicht volllaufen, aber nicht freigegebene Blöcke sind trotzdem Laufwerksplatz, der für Daten belegt ist, die niemandem gehören.
Die Option on-volume-remove discard=1 am Storage ist die Lösung. Proxmox beschreibt sie so, dass sie „discard (TRIM) requests before removal“ absetzt5:
| Löschen | Freigegebene VDO-Blöcke |
|---|---|
einfacher lvm-Storage, eine Disk mit 1 GiB | 0 |
mit on-volume-remove discard=1, dieselbe | 262.140, das ganze 1 GiB |
Auf einer großen Disk ist das allerdings langsam.
Das Löschen der 34-GiB-Disk aus dem Fülltest dauerte bei Proxmox 262,6 s, während blkdiscard auf derselben Art von Daten 15 GiB in 2,25 s schaffte.
Bei allem, was groß ist, also erst blkdiscard auf die Disk und dann löschen.
Auch die Discard-Größe zählt. Das standardmäßige max_discard von VDO ist ein 4-KiB-Block pro Anfrage1:
| Discard von 15 GiB Zufallsdaten | Laufzeit | CPU (sys) |
|---|---|---|
max_discard=1, der Standard | 8,06 s | 8,06 s |
max_discard=4096, 16 MiB | 2,25 s | 0,00 s |
In den Gästen schalte die Option Discard am Laufwerk ein, damit ihr TRIM beim Storage ankommt10, und lass fstrim regelmäßig laufen.
Wo es seinen Platz verdient
| Passt | Passt nicht |
|---|---|
| viele VMs aus denselben wenigen Templates | Datenbanken und latenzgebundene Arbeit bei hoher Queue-Tiefe |
| HDD-RAID6 hinter einem Write-back-Controller-Cache | ein reiner NVMe-Host, der jede Mikrosekunde braucht |
| drehende Daten mit einer NVMe für die Metadaten von VDO | bereits komprimierte Daten: Medien, Backups, ISOs |
| bcache vor drehenden Daten, wo sich die Daten wiederholen | bcache vor Daten, die sich nicht wiederholen |
| Laufwerke, bei denen die Schreibfestigkeit die Grenze ist | verschlüsselte Gast-Disks, die nie deduplizieren |
| ein Host mit einem halben Gigabyte RAM pro Pool übrig | ein kleiner Pool, bei dem der Index ein Zehntel frisst |
| Einstellung | Standard | Setz sie auf | Später ändern |
|---|---|---|---|
Virtuelle VDO-Größe -V | was immer du verlangst | nicht mehr, als der Pool adressieren kann | nur vergrößern, nie verkleinern |
| VDO-Threads | 10, ein logischer | einer pro CPU, verteilt wie oben | nur mit angehaltenen VMs des Pools |
max_discard | 1, also 4 KiB | 4096, also 16 MiB | nur mit angehaltenen VMs des Pools |
on-volume-remove am Storage | nicht gesetzt | discard=1 | ja, pvesm set |
| Discard an jeder virtuellen Disk | aus | an | ja, pro Disk |
scan_lvs und der Filter | 0, keine Abweisung für VM-Disks | 1, VM-Disks abgewiesen | ja, in lvm.conf |
Nichts davon ist schwer. Nichts davon ist der Standard.
Der billigste Schreibzugriff ist der, den du nie abschickst
Was mir an VDO auffällt, ist, wie schlecht es verkauft wird. Es taucht auf als Mittel, mehr auf eine Disk zu packen, als die Disk fasst, und das ist das am wenigsten Nützliche, was es tut. Ich habe es beim ersten Aufbau aus Versehen gemacht, und Proxmox zeigte ein Drittel des Storage als frei, während VDO voll war. Überbuchen ist ein Kredit, und das Laufwerk fordert ihn bei voller Schreibgeschwindigkeit zurück.
Der echte Wert steht in der Zeile, die die meisten nie messen. Ein Viertel der Bytes beim Laufwerk ist ein Viertel des Verschleißes und ein Controller-Cache, der viermal so lange hält. Das ist keine Kapazität. Das ist die Hardware, die für dasselbe Ergebnis weniger Arbeit macht, und das ist die einzige Art Ersparnis, die dir nicht später auf die Füße fällt.
Es kostet CPU, und auf schnellem Flash kostet es Latenz, und beides ist fix. Das ist der Tausch, klar ausgesprochen: Prozessorzeit, ausgegeben, damit der langsame, teure Teil der Kiste weniger tut. Auf drehenden Platten hinter einem RAID-Controller oder einem bcache, mit Index und Journal auf einer NVMe, geht diese Rechnung gut auf. Auf einem reinen Optane-Host meistens nicht.
Und es kümmert sich nicht um sich selbst. Jeder Standardwert, der zählt, ist für diese Aufgabe falsch: zehn Threads auf sechzehn CPUs, eine Discard-Größe, die einen Kern verheizt, eine virtuelle Größe, die du auf alles Mögliche setzen kannst, und nichts in der Storage-Konfiguration, das Proxmox sagt, Platz zurückzugeben. Nichts davon ist versteckt. Es steht alles in der Dokumentation.
Also bau es thick, einmal, ordentlich, mit den Einstellungen in der Anlegezeile und den Metadaten dort, wo sie hingehören. Mach das, und das Laufwerk erledigt ein Viertel der Arbeit. Lass es, und du hast dir eine weitere Schicht gekauft, die mehr verspricht, als sie hat.
Linux kernel documentation — dm-vdo — das Target „provides block-level deduplication, compression, and thin provisioning“; „If the vdo is thinly provisioned, discarding unused blocks is essential to prevent the target from running out of space“; „unflushed writes may or may not persist after a crash“; der Block-Map-Cache von 128 MB ermöglicht „efficient access to 100 GB of logical space at a time“; die Thread-Parameter, ihre Grenzen und die Hinweise zum Tuning; maxDiscard „in 4096-byte blocks“. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
lvmvdo(7) — Support for Virtual Data Optimizer in LVM — VDO-Pool und VDO-LV, Umwandeln eines bestehenden LV mit
lvconvert --type vdo-pool, Speicherbedarf, der Dense-Index und sein Fenster von 1 TiB pro GiB RAM, und „You cannot reduce the size of a VDOPoolLV“. ↩︎ ↩︎ ↩︎ ↩︎Linux kernel source — drivers/md/dm-thin.c —
disable_discard_passdown_if_not_supported()schaltet das Durchreichen von Discards ab, wenn das Datengerät keinen ganzen Thin-Chunk annehmen kann, und genau das passiert mit dem Standard von VDO unter einem Thin-Pool. ↩︎LVM2 — conf/example.conf.in —
devices/scan_lvs: „Caution is required to avoid using PVs that belong to guest images stored on LVs“ und „This option does not enable autoactivation of layered VGs“. ↩︎ ↩︎Proxmox pve-storage — LVMPlugin.pm — die Eigenschaft
on-volume-remove, „Use ‘discard=1’ to issue discard (TRIM) requests before removal“; Volumes werden einzeln mitlvchange -aeyaktiviert statt mitvgchange -aly. ↩︎ ↩︎Debian trixie — package vdo — „Management tools for Virtual Data Optimizer“, Version 8.3.1.1-1, die
vdoformat,vdostatsundvdolistmetadataliefert. ↩︎Linux kernel source — drivers/md/dm-vdo/encodings.c —
vdo_initialize_layout()legt die Block-Map-Partition an den Anfang, die Partitionen für Slab-Summary und Recovery-Journal an das Ende und das Slab-Depot in das, was übrig bleibt. ↩︎fio documentation — randrepeat — „Seed all random number generators in a predictable way so the pattern is repeatable across runs. Default: true.“ ↩︎
Linux kernel documentation — Design of dm-vdo — „vdo treats the locations in the index as hints, and reads each indicated block to verify that it is indeed a duplicate before sharing the existing block with a new one.“ ↩︎
Proxmox VE documentation — Qemu/KVM Virtual Machines, Trim/Discard — „For the guest to be able to issue TRIM commands, you must enable the Discard option on the drive.“ ↩︎