Das Problem
Das kam bei einem Kundenprojekt auf, in dem wir eine Proxmox-VE-Installation mit NVMe-Passthrough für eine latenzempfindliche Last entworfen haben.
Der Kunde hatte vor dem Gespräch selbst gemessen.
Auf dem Host meldete fio gegen das NVMe-Laufwerk 700K zufällige Lese-IOPS mit einer Completion-Latenz unter 10 µs.
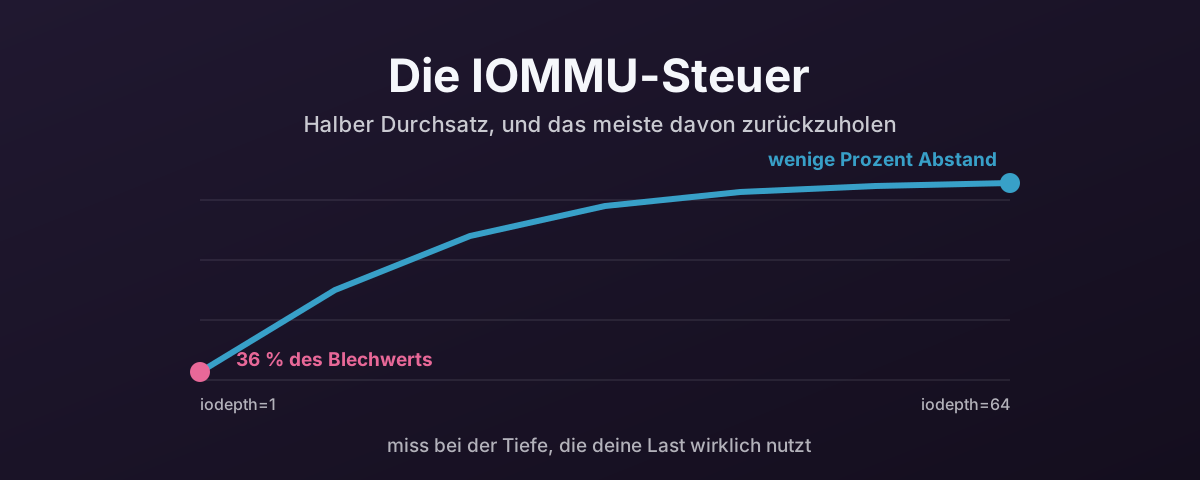
In der VM, mit demselben Laufwerk und demselben Test, bekamen sie etwa die Hälfte davon.
Das Naheliegende hatten sie schon geprüft. Das Laufwerk hatte sich nicht geändert. Die Firmware hatte sich nicht geändert. Der PCIe-Slot war nicht umgezogen. Sie fingen an sich zu fragen, ob Passthrough überhaupt der falsche Ansatz sei.
War es nicht. Was sie sahen, ist die IOMMU-Steuer. Sie erwischt Leute, weil dir niemand davon erzählt, bevor du dich auf den Passthrough-Entwurf festgelegt hast. Die gute Nachricht ist, dass der größte Teil des Overheads zurückzuholen ist, sobald man versteht, woher er kommt.
Genauer hingesehen
Die Probleme, die gelöst werden mussten
Einer VM direkten Zugriff auf ein physisches PCIe-Gerät zu geben klingt geradeheraus. In der Praxis ist es eines der härteren Probleme der Systemvirtualisierung. Einiges, was auf Blech von allein funktioniert, wird gefährlich, wenn ein Gerät zwischen Host und Gast geteilt wird.
DMA-Isolation
Das ist das grundlegende Problem.
PCIe-Geräte gehen zum Lesen und Schreiben von Speicher nicht über die CPU. Sie nutzen Direct Memory Access. Sie schreiben direkt auf physische RAM-Adressen. Auf Blech ist das in Ordnung. Das Gerät und das Betriebssystem vertrauen einander.
Unter Virtualisierung hat die Gast-VM ihre eigene Sicht auf den physischen Speicher. Die Adressen, die der Treiber im Gast dem NVMe-Controller gibt, sind physische Adressen des Gasts. Sie zeigen nicht auf dieselben Stellen im Host-RAM. Nutzt das Gerät sie direkt, liest und schreibt es den falschen Speicher. Das verdirbt den Host, andere VMs oder beides.
Schlimmer noch: ein böswilliger oder fehlerhafter Treiber im Gast könnte das Gerät absichtlich so programmieren, dass es per DMA in jeden Teil des Host-Speichers schreibt. Das ist im Ergebnis Root-Zugriff auf die ganze Maschine, ohne je einen Hypervisor-Fehler ausgenutzt zu haben.
Die Lösung ist die IOMMU — eine Übersetzungseinheit in Hardware (Intel VT-d, AMD-Vi), die zwischen jedem PCIe-Gerät und dem Hauptspeicher sitzt. Sie hält ihre eigenen Seitentabellen, getrennt von denen der CPU. Jede DMA-Anforderung des Geräts läuft durch die IOMMU, die physische Gast-Adressen in physische Host-Adressen übersetzt und jeden Zugriff außerhalb der dem Gast zugewiesenen Speicherbereiche blockt.
Ohne die IOMMU ist sicheres Passthrough unmöglich. Mit ihr ist das Gerät eingehegt.
Gerätegruppen
Die IOMMU isoliert nicht einzelne Geräte. Sie isoliert Gruppen.
Die PCIe-Spezifikation legt Access Control Services (ACS) fest, die regeln, ob Geräte am selben Bus direkt miteinander reden können — DMA von Gerät zu Gerät —, ohne über den Root Complex zu gehen, wo die IOMMU sitzt. Teilen zwei Geräte einen PCIe-Switch, der ACS nicht durchsetzt, kann ein Gerät per DMA in den Speicherbereich des anderen schreiben und die IOMMU komplett umgehen.
Der Kernel fasst Geräte, die einander möglicherweise ohne IOMMU-Durchsetzung erreichen können, zu einer einzigen IOMMU-Gruppe zusammen. Teilt dein NVMe-Controller eine Gruppe mit einem anderen Gerät, bricht das Isolationsmodell, wenn du nur das NVMe durchreichst. Das andere Gerät der Gruppe könnte weiterhin als Seitenkanal um die IOMMU herum dienen.
Hardware auf Server-Niveau mit ordentlicher ACS-Unterstützung an jeder Bridge und jedem Switch gibt jedem Gerät meist seine eigene Gruppe. Consumer- und Workstation-Platinen werfen mehrere Geräte oft zusammen, weil der PCIe-Root-Complex ACS nicht an jedem Port umsetzt.
Proxmox trägt einen Kernel-Patch — pcie_acs_override —, der dem Kernel sagt, jedes Gerät als isoliert zu behandeln, egal was die Hardware an ACS kann.
In der Praxis funktioniert es, aber es belügt den Kernel über die Hardware-Topologie.
Auf einem produktiven System sind saubere Gruppen, die von echtem Hardware-ACS getragen werden, immer vorzuziehen.
Interrupt-Zustellung
Wenn ein NVMe-Controller auf Blech eine IO-Operation fertigstellt, feuert er einen MSI-X-Interrupt direkt an die CPU. Die CPU behandelt ihn in ein paar hundert Nanosekunden.
Unter Virtualisierung muss dieser Interrupt den Gast erreichen, nicht den Host. Der naive Weg ist, jeden Interrupt im Hypervisor abzufangen, einen VM-Exit auszulösen, den Interrupt in den Gast einzuspeisen und weiterzumachen. Das geht, aber jeder VM-Exit kostet 5–20 µs. Bei hohen IOPS — hunderttausenden Interrupts pro Sekunde — ist der Overhead erheblich.
Die Lösung in Hardware heißt Posted Interrupts. Intels APICv und AMDs AVIC erlauben es der IOMMU, den Interrupt direkt in die virtuelle APIC-Seite des Gasts zu schreiben, ganz ohne VM-Exit. Der Gast sieht den Interrupt, als käme er von Hardware auf Blech. Der Overhead fällt auf ein paar hundert Nanosekunden.
Nicht jede Plattform unterstützt Posted Interrupts. Ältere CPUs, manche Workstation-Chipsätze und manche BIOS-Versionen legen die Fähigkeit nicht offen. Fehlt sie, geht jeder Interrupt über den langsamen Weg, und es gibt keinen Ausweg in Software.
Geräte-Reset
Wenn eine VM herunterfährt oder abstürzt, muss das durchgereichte Gerät in einen sauberen, bekannten Zustand zurückkehren. Sonst kann es keiner anderen VM zugewiesen und nicht vom Host zurückgeholt werden.
Auf Blech fährt das Betriebssystem den Gerätetreiber geordnet herunter. Beim Passthrough kann der Gast abstürzen, der Nutzer die VM hart stoppen oder der Hypervisor den Prozess töten. Das Gerät könnte mitten in einer Übertragung stecken, mit DMA-Operationen unterwegs.
PCIe legt dafür den Function Level Reset (FLR) fest — einen Weg, eine einzelne Gerätefunktion zurückzusetzen, ohne den Rest des Busses anzufassen. NVMe-Controller können FLR meist und kommen gut damit zurecht. GPUs sind dabei notorisch schlecht, aber das ist ein anderer Beitrag.
Ist FLR nicht möglich, bleibt als Rückfall ein Secondary Bus Reset, der alles hinter dieser PCIe-Bridge zurücksetzt. Hängen an der Bridge andere Geräte, werden die alle mit zurückgesetzt. Im schlimmsten Fall ist ein vollständiger Neustart des Hosts der einzige Weg, das Gerät zurückzuholen.
Overhead durch Adressübersetzung
Die IOMMU löst das Sicherheitsproblem. Damit ist sie nicht optional. Aber sie schafft ein Leistungsproblem.
Jede DMA-Operation läuft nun durch eine zusätzliche Stufe der Adressübersetzung. Die IOMMU hat ihren eigenen TLB — den IOTLB —, und wenn er trifft, ist der Overhead klein. Wenn er nicht trifft, muss die IOMMU ihre Seitentabellen ablaufen, und das schlägt jeder betroffenen IO-Operation echte Latenz auf.
Das ist die IOMMU-Steuer. Der Rest dieses Beitrags handelt davon, zu verstehen, woher sie kommt, und sie klein zu halten.
BAR-Abbildung und Adressraum
Jedes PCIe-Gerät legt ein oder mehrere Base Address Register (BARs) offen, die die internen Register und den Speicher des Geräts in den MMIO-Adressraum des Hosts abbilden. Die Host-CPU greift über diese Abbildungen auf das Gerät zu. Damit Passthrough funktioniert, muss der Hypervisor diese Abbildungen dem Gast richtig zeigen.
Früher waren BAR-Größen beim Start durch das BIOS festgelegt und passten in das alte 32-Bit-MMIO-Fenster unter 4 GB. Das ging, solange BARs klein waren. Moderne GPUs haben das Bild geändert. Ein Framebuffer von 24 GB braucht ein BAR von 24 GB, und das passt nicht in einen 32-Bit-Adressraum.
Resizable BAR (ReBAR) — vermarktet auch als AMD Smart Access Memory (SAM) — ist eine PCIe-Fähigkeit, mit der die BAR-Größe nach dem Start neu verhandelt werden kann. Für GPUs ist das eine große Sache. Statt über ein Fenster von 256 MB auf den Framebuffer zuzugreifen und stückweise durchzublättern, bildet der Host den ganzen VRAM auf einmal ab.
Für NVMe ist die unmittelbare Wirkung geringer. BARs von NVMe-Controllern sind für den Registersatz des Controllers (BAR0) typisch 16 KB bis 64 KB. Die NVMe-Spezifikation legt einen Controller Memory Buffer (CMB) fest, der ein größeres BAR für Submission Queues im Host-Speicher offenlegen kann, aber die meisten Laufwerke setzen ihn nicht um. ReBAR ändert den NVMe-Durchsatz nicht so, wie es das bei GPUs tut.
Wichtig ist es im Zusammenhang mit NVMe-Passthrough wegen der geteilten PCIe-Umgebung. Reichst du ein NVMe-Laufwerk zusammen mit einer GPU auf demselben Host durch, braucht das vergrößerte BAR der GPU Adressraum oberhalb der 4-GB-Grenze. Das BIOS, die IOMMU und die virtuelle PCIe-Topologie müssen das alle hergeben. Verteilt man den Adressraum falsch, kommen Geräte nicht hoch, und das NVMe-Passthrough scheitert mit allem anderen.
Verwundbarkeit bei Stromausfall
Bei einer virtuellen Platte kümmern sich Hypervisor und Speicherschicht um Schreibreihenfolge und Konsistenz nach einem Absturz. Beim Passthrough redet der Gast direkt mit dem Flash. Verliert der Host mitten im Schreiben den Strom, entscheidet allein, was die Firmware des NVMe-Controllers mit ihrem Schreibcache tut — oder nicht tut —, ob du Daten verlierst.
Enterprise-NVMe-Laufwerke tragen Kondensatoren für den Schutz bei Stromverlust (PLP), die den Schreibcache bei einem Ausfall sicher leeren. Consumer-Laufwerke ohne PLP tun das möglicherweise nicht. Beim Passthrough gibt es kein Netz vom Hypervisor zwischen Gast und Hardware.
Für produktive Arbeit ist ein Enterprise-Laufwerk mit PLP nicht optional.
Betriebliche Abwägungen
Passthrough nimmt auch Fähigkeiten weg, die virtuelle Platten bieten.
Ein durchgereichtes Gerät ist physisch an einen bestimmten Host geschraubt. Die VM kann nicht live migriert werden, solange das Gerät angehängt ist. In einem Proxmox-Cluster mit HA heißt ein Knotenausfall, dass die VM ausfällt und auf einem anderen Knoten kalt startet. Es gibt keine reibungslose Übernahme.
Das Laufwerk ist außerdem für vzdump und den Proxmox Backup Server unsichtbar.
Es wird nicht in Snapshots der VM oder geplante Sicherungen aufgenommen.
Eine eigene Sicherungsstrategie — im Gast, auf Dateisystemebene oder in der Anwendung — muss stehen, bevor die Last live geht.
Wie VFIO-Passthrough tatsächlich arbeitet
Reichst du ein PCIe-Gerät an eine VM durch, gibt der Hypervisor dem Gast direkte Kontrolle über die MMIO-Register des Geräts. Der Treiber im Gast redet mit dem NVMe-Controller, als liefe er auf Blech. Dieser Teil ist nahe an native. MMIO-Registerzugriffe laufen über Extended Page Tables (EPT bei Intel, NPT bei AMD) und kommen meist ohne VM-Exit durch.
Der DMA-Weg ist die Stelle, an der die Kosten auftauchen. Jede DMA-Operation läuft für die Adressübersetzung durch die IOMMU, und wie oben beschrieben hat diese Übersetzung einen Preis. Besonders wenn der IOTLB nicht trifft.
Warum die Benchmarks schlechter aussehen als die Wirklichkeit
Hier gehen die meisten Leute beim Testen falsch vor.
In einem Proxmox-Forum-Thread, der zu diesem Beitrag geführt hat, haben Nutzer fio mit iodepth=1 laufen lassen.
Bei dieser Queue-Tiefe schickt fio ein IO ab, wartet, bis es fertig ist, und schickt dann das nächste.
Der Test misst nichts als die Latenz pro IO.
Jede Mikrosekunde IOMMU-Overhead zeigt sich in voller Höhe.
Die Zahlen aus diesem Thread erzählen die Geschichte klar.
Auf Blech lag die Completion-Latenz im Mittel bei etwa 10 µs.
In der VM lag sie im Mittel bei etwa 28 µs.
Diese zusätzlichen ~18 µs pro IO sind der Overhead der IOMMU-Übersetzung.
Bei iodepth=1 halbiert das den Durchsatz direkt, denn der Durchsatz ist 1 / Latenz, wenn nur ein IO unterwegs ist.
Zieh die Queue-Tiefe auf 32 oder 64 hoch — so sind NVMe-Laufwerke gedacht —, und das Bild ändert sich. Mit mehreren IOs unterwegs verteilt sich der IOMMU-Overhead auf alle. Der Controller arbeitet Fertigmeldungen ab, während neue Übersetzungen laufen. Der Durchsatz kommt bis auf wenige Prozent an den Blechwert zurück.
Praktisch heißt das Folgendes. Läuft deine Arbeit bei Queue-Tiefen über 4, ist der Durchsatzaufschlag der IOMMU wahrscheinlich zu vernachlässigen. Das deckt die meisten Datenbank-, Virtualisierungs- und Speicherlasten ab. Ist deine Arbeit bei niedrigen Queue-Tiefen latenzempfindlich — bestimmte Echtzeitanwendungen, synchrone Metadaten-Operationen —, wirst du sie spüren.
Lass deine Benchmarks bei realistischen Queue-Tiefen laufen, bevor du zum Schluss kommst, Passthrough sei zu langsam:
# Bare metal baseline — run on the host before binding to vfio-pci
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting

# Same test inside the VM after passthrough
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Vergleiche die clat-Perzentile (Completion Latency) und die IOPS-Zahlen.
Bei iodepth=32 mit vier Jobs sollte der Abstand im einstelligen Prozentbereich liegen, nicht bei 50 %.
NUMA-Ausrichtung
Das hat seinen eigenen Beitrag. Siehe NUMA-Ausrichtung auf Proxmox VE — warum sie zählt und wie man sie richtig hinbekommt.
Die kurze Fassung: auf Systemen mit mehreren Sockeln ist jedes PCIe-Gerät an einen bestimmten Sockel verdrahtet. Sitzt das NVMe-Laufwerk auf NUMA-Knoten 1 und sind die vCPUs der VM auf Knoten 0 gepinnt, überquert jede DMA-Fertigmeldung die Verbindung zwischen den Sockeln. Das kostet 50–100 ns pro Operation. Bei hohen IOPS liegt der Durchsatzunterschied zwischen ausgerichtetem und fehlausgerichtetem NUMA bei 20–30 %.
Prüf mit cat /sys/bus/pci/devices/0000:XX:00.0/numa_node und pinn dann die vCPUs der VM mit dem Parameter affinity in der VM-Konfiguration auf Kerne des gleichen Knotens.
Auf Systemen mit einem Sockel ist das kein Thema.
PCIe Active State Power Management (ASPM)
Das hat seinen eigenen Beitrag. Siehe PCIe-ASPM, und warum du es für Passthrough abschalten solltest.
Die kurze Fassung: ASPM erlaubt PCIe-Links, in Zustände mit geringer Leistung zu gehen, wenn sie unbeschäftigt sind.
Beim Passthrough steuert der Host weiterhin den physischen Link, aber der Gast besitzt das Gerät.
Schickt der Gast IO ab, während der Link schläft, schlägt die Aufwachzeit als Latenz auf.
Das Symptom ist eine weite Streuung in deinen clat-Perzentilen. Das p99 kann 5- bis 10-mal höher liegen als der Durchschnitt, während das Mittel gut aussieht.
Schalte es auf dem Host mit pcie_aspm=off in der Kernel-Kommandozeile ab.
Füge außerdem disable_idle_d3=1 zu den Modul-Optionen von vfio-pci hinzu, wenn dein NVMe-Controller Probleme mit der Rückkehr aus Energiezuständen hat. Die Samsung 990 EVO Plus ist ein bekannter Übeltäter.
MaxPayloadSize (MPS)
Das hat seinen eigenen Beitrag. Siehe PCIe MaxPayloadSize — ein kostenloser Leistungsgewinn beim Passthrough.
Die kurze Fassung: PCIe-Geräte übertragen Daten in Transaction Layer Packets.
Der virtuelle Root Complex von QEMU liefert standardmäßig höchstens 128 Byte Payload.
Die meisten Geräte können 256 oder 512 Byte.
pci=pcie_bus_perf in der Kernel-Kommandozeile des Hosts setzt MPS auf das Maximum, das der übergeordnete Bus jedes Geräts zulässt.
Es ist eine kleine Verbesserung des Durchsatzes — niedriger einstelliger Prozentbereich —, aber sie ist kostenlos und ohne Nachteil.
Resizable BAR und das MMIO-Fenster
Das oben beschriebene Problem der BAR-Abbildung hat praktische Schritte sowohl im BIOS als auch auf der VM-Seite.
Schalte zuerst „Above 4G Decoding“ im BIOS ein. Damit können BARs in Adressraum oberhalb der 4-GB-Grenze abgebildet werden, was für jedes Gerät mit großen BARs nötig ist. Schalte es selbst dann ein, wenn du nur NVMe durchreichst. Es hat keinen Nachteil und erspart Ärger, wenn später eine GPU oder ein anderes Gerät mit großem BAR dazukommt.
Ist ReBAR im BIOS vorhanden, schalte das auch ein. Es wirkt sich auf die NVMe-Leistung nicht direkt aus, erlaubt aber GPUs auf demselben Host, ihre volle Framebuffer-Abbildung zu nutzen.
Auf der VM-Seite braucht der virtuelle Q35-Root-Complex von QEMU ein 64-Bit-MMIO-Fenster, das groß genug ist, damit der Gast vergrößerte BARs sieht. Standardmäßig weist OVMF ein recht kleines Fenster zu. Für Passthrough mit nur NVMe ist das in Ordnung. NVMe-BARs passen bequem. Hat die VM aber sowohl ein NVMe als auch eine GPU durchgereicht, vergrößere das MMIO-Fenster:
args: -fw_cfg name=opt/ovmf/X-PciMmio64Mb,string=65536
Das sagt OVMF, 64 GB 64-Bit-MMIO-Raum zuzuweisen, genug für die meisten GPU-Framebuffer neben dem kleinen BAR des NVMe-Controllers.
Die ReBAR-Unterstützung von QEMU wird besser, ist aber noch nicht reibungslos. Manche AMD-GPUs (Vega und neuer) lösen mit eingeschaltetem ReBAR unter QEMU Treiberfehler aus (Code 43 unter Windows). Trifft dich das, schalte ReBAR im BIOS als ersten Schritt ab. NVMe-Passthrough ist so oder so nicht betroffen.
Was Resizable BAR auf der GPU-Seite des Zauns tut, und warum Intel es auf Arc für zwingend hält, während NVIDIA es pro Spiel einschaltet, steht in PCIe Resizable BAR und moderne GPUs.
Interrupts behandeln
Das oben beschriebene Problem der Interrupt-Zustellung hat einen praktischen Schritt. Posted Interrupts (APICv bei Intel, AVIC bei AMD) sind vielleicht nicht standardmäßig eingeschaltet.
Prüfen, ob sie aktiv sind:
# Intel — look for "Posted-Interrupts" in dmesg
dmesg | grep -i "posted"

# AMD — check AVIC support
dmesg | grep -i "avic"
Schalte auf AMD-EPYC-Systemen AVIC im KVM-Modul ein, wenn es nicht schon an ist:
# /etc/modprobe.d/kvm.conf
options kvm_amd avic=1
Auf Intel-Systemen ist APICv mit Posted Interrupts meist automatisch an, wenn VT-d aktiv ist.
Unterstützt deine Plattform keine Posted Interrupts, gibt es keinen Ausweg in Software. Es ist eine Fähigkeit der Hardware. Aber es lohnt sich, nachzusehen, ob sie wirklich an ist, bevor du annimmst, der langsame Weg sei unvermeidlich.
Interrupt-Affinität und Queue-Ausrichtung
NVMe-Controller nutzen mehrere Paare aus Submission- und Completion-Queue. Typisch eines pro CPU-Kern. Passen die vCPUs der VM nicht zu den physischen Kernen, die die NVMe-Interrupts behandeln, müssen Fertigmeldungen per Interprozessor-Interrupt über Kerne hinweg. Das kostet Latenz.
Prüfe im Gast, wie viele IO-Queues der NVMe-Treiber angelegt hat und wie sie abgebildet sind:
# List NVMe IO queues
cat /proc/interrupts | grep nvme

# Check affinity
for irq in $(grep nvme /proc/interrupts | awk '{print $1}' | tr -d ':'); do
    echo "IRQ $irq: $(cat /proc/irq/$irq/smp_affinity_list)"
done
Idealerweise sollte der Interrupt jeder NVMe-IO-Queue auf die vCPU gebunden sein, die in diese Queue einreicht. Die meisten modernen NVMe-Treiber machen das von allein. Es lohnt sich aber nachzusehen, besonders wenn du vCPUs von Hand gepinnt oder die Zahl der vCPUs unter die Queue-Zahl des Controllers gesenkt hast.
Immer Q35, nicht i440fx
Das verdient seinen eigenen Beitrag. Siehe Immer Q35, nicht i440fx.
Die kurze Fassung: i440fx zeigt einen flachen, alten PCI-Bus. Q35 zeigt einen richtigen PCIe-Root-Complex. Durchgereichte Geräte erscheinen auf i440fx als altes PCI, und das zerbricht die MSI-X-Interrupt-Zustellung über mehrere Queues. NVMe-Controller brauchen MSI-X für ihre Architektur mit einer Queue pro Kern. Ohne sie laufen alle IO-Fertigmeldungen durch einen einzigen Interrupt, und du bekommst bei hohen IOPS einen Engpass, den kein Kernel-Tuning behebt.
In Proxmox 8.x und neuer ist Q35 die Voreinstellung für neue VMs. Machst du Passthrough auf einer älteren VM, die noch i440fx ist, stell sie um. RHEL 10 hat i440fx formell für überholt erklärt, und das übrige KVM-Umfeld folgt.
Alles zusammengenommen
Hier eine Übersicht der Tuning-Schritte nach Wirkung geordnet.
NUMA-Ausrichtung — sorge dafür, dass das NVMe-Laufwerk und die vCPUs der VM auf demselben NUMA-Knoten sitzen. Das allein kann auf Systemen mit mehreren Sockeln 20–30 % Durchsatzunterschied ausmachen.
ASPM aus — pcie_aspm=off in die Kernel-Kommandozeile des Hosts.
Beseitigt Latenzzittern durch Wechsel der PCIe-Link-Energiezustände.
Realistische Queue-Tiefen — teste mit iodepth=32 oder höher, nicht mit iodepth=1.
Der IOMMU-Overhead, der bei niedrigen Queue-Tiefen dominiert, verteilt sich bei realistischen Tiefen.
Posted Interrupts — prüfe, ob APICv (Intel) oder AVIC (AMD) aktiv ist. Senkt den Overhead pro Interrupt von Mikrosekunden auf Nanosekunden.
MPS optimieren — pci=pcie_bus_perf in die Kernel-Kommandozeile des Hosts.
Setzt MaxPayloadSize auf das Maximum, das die Topologie hergibt.
Energieverwaltung von vfio-pci — disable_idle_d3=1 ergänzen, wenn dein NVMe-Controller beim Passthrough Probleme mit Energiezuständen hat.
Eine kombinierte Kernel-Kommandozeile für einen Proxmox-Knoten mit NVMe-Passthrough auf einem AMD-EPYC-System sähe etwa so aus:
GRUB_CMDLINE_LINUX_DEFAULT="quiet amd_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Für Intel:
GRUB_CMDLINE_LINUX_DEFAULT="quiet intel_iommu=on iommu=pt pcie_aspm=off pci=pcie_bus_perf"
Wann Passthrough sich nicht lohnt
Bevor du diesen Weg gehst, lohnt die Frage, ob du NVMe-Passthrough überhaupt brauchst.
VirtIO-SCSI und VirtIO-BLK mit einer virtuellen Platte auf NVMe sind schon sehr effizient. Der Overhead gegenüber Passthrough liegt bei der Latenz typisch bei 5–10 %. Der Unterschied im Durchsatz ist für die meiste Arbeit zu vernachlässigen.
Passthrough ist sinnvoll, wenn das Gast-Betriebssystem das Gerät direkt verwalten soll. Dazu gehören SMART-Überwachung, Firmware-Aktualisierungen, Steuerung von TRIM und Discard und bestimmte NVMe-Funktionen wie Reservierungen. Es ist auch sinnvoll für latenzempfindliche Arbeit, bei der schon ein paar Mikrosekunden zählen. Bestimmte Datenbank-Engines und Echtzeit-Datenannahme fallen darunter.
Für alles andere wiegen die betrieblichen Abwägungen von oben — keine Live-Migration, keine Anbindung an Snapshots und Sicherungen — den kleinen Leistungsgewinn meist auf.
Es ist nichts Kluges daran, den härteren Weg zu wählen, wenn der leichtere die Arbeit tut.
Deine Änderungen prüfen
Prüf nach den Tuning-Schritten, ob alles wie erwartet läuft:
# Host side — confirm IOMMU is in passthrough mode
dmesg | grep -i iommu

# Confirm ASPM is disabled
lspci -vv | grep -i "ASPM Disabled"

# Check MPS on the NVMe controller
lspci -vv -s XX:00.0 | grep MaxPayload

# Inside the VM — run the fio comparison
fio --name=randread --ioengine=libaio --direct=1 --bs=4k \
    --iodepth=32 --numjobs=4 --rw=randread --size=1G \
    --filename=/dev/nvme0n1 --runtime=30 --time_based \
    --group_reporting
Vergleiche die Ergebnisse aus der VM mit deiner früheren Grundlinie auf Blech.
Bei iodepth=32 solltest du einen Durchsatz innerhalb von 5 % des Blechwerts sehen.
Die Mittelwerte der Completion-Latenz sollten innerhalb von 10–15 µs der Host-Zahlen liegen.
Ist der Abstand noch groß, prüf zuerst die NUMA-Ausrichtung.
Sie ist der am häufigsten übersehene Punkt.
Und sie kostet nichts als eine Änderung in der Konfiguration, was sie zur besten Sorte übrig gebliebenes Problem macht.
Quellen
- PCI-Dokumentation des Linux-Kernels — Optionen zum Tuning von MPS und MRRS — die maßgebliche Quelle für
pcie_bus_perf,pcie_bus_safeund verwandte Parameter - Proxmox VE Administration Guide — PCI(e) Passthrough — die offizielle Proxmox-Dokumentation zur Konfiguration von VFIO-Gerätedurchgriff
- Proxmox-Forum — NVMe Passthrough Performance — die Diskussion aus der Gemeinschaft, die zu diesem Beitrag geführt hat