Was MPS ist
PCIe-Geräte übertragen Daten in Paketen namens Transaction Layer Packets (TLPs). Jedes TLP hat einen Header und eine Payload. Die maximale Größe dieser Payload ist die MaxPayloadSize (MPS).
MPS wird beim Link-Training zwischen einem Gerät und seiner vorgelagerten Bridge verhandelt. Der verhandelte Wert ist der kleinere von dem, was das Gerät kann, und dem, was die Bridge zulässt. Jede Bridge und jeder Switch auf dem Weg zwischen Gerät und Root Complex hat seine eigene MPS-Fähigkeit. Die endgültige MPS eines Geräts wird von der engsten Stelle der Kette bestimmt.
Übliche MPS-Werte sind 128, 256 und 512 Byte. Manche Geräte können 1024 oder sogar 4096 Byte, aber in der Praxis sind 256 oder 512 typisch für NVMe-Controller und Netzwerkkarten. GPUs können oft 256 Byte.
Warum es zählt
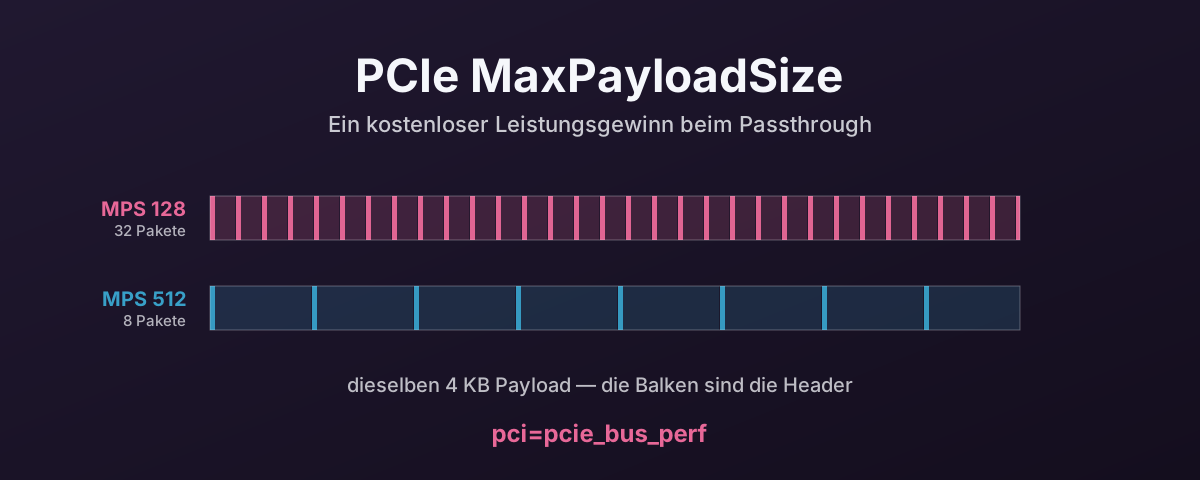
Größere MPS heißt weniger Pakete für dieselbe Datenmenge. Ein 4-KB-IO braucht bei MPS 128 32 TLPs. Dieselbe Übertragung braucht bei MPS 512 8 TLPs.
Jedes TLP trägt Protokoll-Overhead — Header, CRC, Framing. Weniger TLPs heißt weniger Protokoll-Overhead pro übertragenem Byte. Bei hohem Durchsatz ist dieser Unterschied messbar. Nicht dramatisch. Aber echt. Und es ist derselbe Overhead, der bei jedem Paket anfällt.
MPS wirkt sich auch darauf aus, wie gut der PCIe-Link genutzt wird. Kleinere Payloads heißen, dass der Link mehr Zeit mit Headern statt mit Daten verbringt. Größere Payloads verschieben das Verhältnis zu den nützlichen Daten.
Die Wirkung auf die Latenz ist geringer als die auf den Durchsatz. Ein einzelner 4-KB-Lesezugriff zeigt zwischen MPS 128 und 512 keinen Latenzunterschied, der das Messen wert wäre, denn die TLPs laufen in einer Pipeline. Fährt man aber hohe IOPS mit vielen gleichzeitigen Übertragungen, summiert sich der geringere Overhead größerer MPS.
Das Problem beim Passthrough
Auf Blech setzt das BIOS die MPS während des POST anhand der PCIe-Topologie. Ein modernes Server-BIOS setzt MPS meist auf das Maximum, das die Topologie hergibt, üblicherweise 256 oder 512 Byte.
Unter QEMU hat der Root Complex des virtuellen Q35-Chipsatzes seine eigene MPS-Fähigkeit.
Standardmäßig gibt er eine niedrige MPS an.
Die Standard-MPS-Politik des Linux-Kernels (pcie_bus_default) setzt die MPS jedes Geräts auf die seiner übergeordneten Bridge, was in einer virtuellen Topologie der Standardwert des QEMU-Root-Complex ist. Oft 128 Byte.
Damit läuft ein Gerät, das 512-Byte-Payloads könnte, mit 128, weil der virtuelle Root Complex die Obergrenze gesetzt hat.
Wie man es behebt — auf der Host-Seite
Sag dem Kernel, er soll die MPS auf das Maximum setzen, das der übergeordnete Bus jedes Geräts hergibt:
# Add to GRUB_CMDLINE_LINUX_DEFAULT in /etc/default/grub
pci=pcie_bus_perf
Das setzt die MPS jedes Geräts auf den größten Wert, den sein übergeordneter Bus zulässt. Es setzt außerdem die MRRS (Max Read Request Size) entsprechend. Der Kernel-Quelltext sagt, er stelle sicher, dass die MPS eines Geräts nicht größer ist als die des übergeordneten. Das hält die Kette konsistent und holt gleichzeitig die besten Übertragungsgrößen heraus.
Nach dem Neustart die neue MPS prüfen:
# Check MPS on a specific device
lspci -vv -s XX:00.0 | grep -i "MaxPayload"
Du solltest MaxPayload 256 bytes oder MaxPayload 512 bytes sehen statt der voreingestellten 128.
Die anderen Kernel-Optionen
Der Kernel bietet vier MPS-Politiken, jede über den Boot-Parameter pci= gesetzt:
pcie_bus_tune_off — MPS überhaupt nicht anfassen.
Nimm, was das BIOS gesetzt hat.
Auf Blech mit einem guten BIOS ist das oft in Ordnung.
Unter QEMU ist das BIOS OVMF oder SeaBIOS, und die optimieren MPS möglicherweise nicht.
pcie_bus_default — der Kernel-Standard.
Setzt die MPS jedes Geräts auf die seiner vorgelagerten Bridge.
Vorsichtig und sicher, holt aber nicht die Leistung heraus.
pcie_bus_safe — setzt MPS auf den größten Wert, den alle Geräte im System können.
Nützlich für geschlossene Systeme, in denen du alle Geräte kennst und nichts im Betrieb dazugesteckt wird.
Etwas forscher als der Standard.
pcie_bus_perf — setzt MPS pro Gerät auf den größten Wert, den der übergeordnete Bus zulässt.
Jedes Gerät bekommt die beste MPS, die seine lokale Topologie hergibt.
Das ist die richtige Wahl für Passthrough, weil es jeden Weg für sich optimiert.
pcie_bus_peer2peer — setzt MPS überall auf 128 Byte.
Jedes Gerät redet in der kleinsten gemeinsamen Größe.
Wird genutzt, wenn Geräte direkt per DMA miteinander reden müssen (GPU zu GPU, GPU zu NIC über RDMA).
Für gewöhnliches Passthrough nicht nützlich.
pcie_bus_perf ist der richtige für Passthrough.
Wie man es behebt — auf der Gast-Seite
Du kannst pci=pcie_bus_perf auch in der Boot-Konfiguration des Gast-Kernels setzen.
Ob das praktisch etwas bewirkt, hängt davon ab, wie QEMU die virtuelle PCIe-Topologie darstellt.
Der virtuelle Root Complex begrenzt, was der Gast verhandeln kann.
Im Test ist die Host-Seite die, die hält. Der Host besitzt das physische Gerät, und seine MPS-Einstellung bestimmt die tatsächliche TLP-Größe auf der Leitung. Die Einstellung des Gasts fasst nur die virtuelle Topologie in der VM an, und ob das echtes Verhalten ändert, hängt davon ab, wie QEMU den PCIe-Weg für dieses Gerät darstellt.
Setz es auf dem Host. Es zusätzlich im Gast zu setzen schadet nicht, aber verlass dich nicht darauf allein.
Was MRRS ist
Die Max Read Request Size (MRRS) ist verwandt, aber etwas anderes. MPS begrenzt, wie viele Daten ein Gerät in einem TLP senden kann. MRRS begrenzt, wie viele Daten ein Gerät in einer Leseanforderung anfordern kann.
Ein Gerät mit MRRS 4096 kann eine einzelne 4-KB-Leseanforderung stellen. Die Antwort kommt in mehreren TLPs zurück, jedes höchstens so groß wie die MPS. Höhere MRRS heißt, dass das Gerät mehr Daten pro Transaktion anfordern kann, was die Zahl der Leseanforderungs-TLPs auf dem Bus senkt.
pci=pcie_bus_perf setzt sowohl MPS als auch MRRS auf ihre optimalen Werte.
Du musst sie nicht getrennt einstellen.
Wirkung gegenüber anderem Tuning
Der MPS-Unterschied zwischen 128 und 512 Byte hat eine geringere Wirkung auf die Leistung als NUMA-Ausrichtung oder ASPM. Typisch ist eine Verbesserung des Durchsatzes im niedrigen einstelligen Prozentbereich. In Latenz-Benchmarks bei geringer Queue-Tiefe wirst du sie nicht sehen.
Aber sie ist kostenlos. Ein Kernel-Parameter, kein Nachteil, kein Kompatibilitätsrisiko. Es gibt keinen Grund, das auf einem System mit Passthrough nicht zu setzen.
Es kostet nichts, und die Hardware hast du schon bezahlt. Dann nimm auch, was du gekauft hast.
Quellen
- PCI-Kconfig des Linux-Kernels — Optionen zum Tuning von MPS und MRRS — maßgebliche Quelle für alle vier MPS-Politiken
- Linux Plumbers Conference 2017 — MPS vs MRRS (PDF) — Sinan Kayas Vortrag über die MPS-/MRRS-Behandlung im Kernel