Was NUMA ist
NUMA steht für Non-Uniform Memory Access, also ungleichmäßigen Speicherzugriff. Auf einem System mit einem Sockel greift jeder CPU-Kern über denselben Speichercontroller auf den ganzen Arbeitsspeicher des Systems zu. Die Zugriffszeit ist gleich, egal welcher Kern fragt und wo die Daten im physischen Speicher liegen.
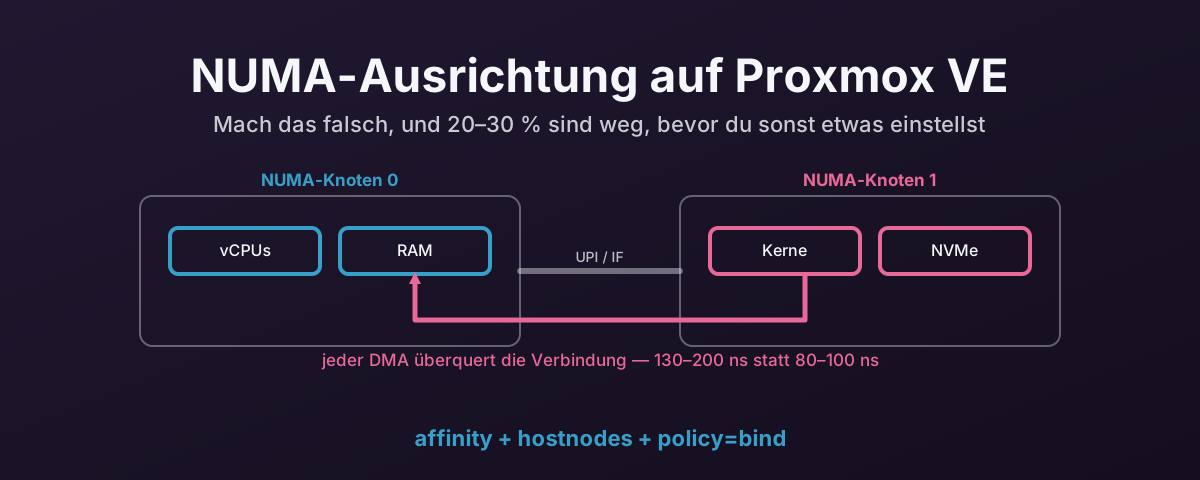
Auf einem System mit mehreren Sockeln hat jeder CPU-Sockel seinen eigenen Speichercontroller und seine eigene Bank RAM. Ein Kern auf Sockel 0 kommt schnell an das RAM, das an Sockel 0 hängt — das ist lokaler Speicher. Er kommt auch an das RAM an Sockel 1, aber diese Anforderung muss über die Verbindung zwischen den Sockeln (Intel UPI, AMD Infinity Fabric). Das ist entfernter Speicher, und der ist langsamer.
Der Kernel nennt jeden Sockel samt seinem lokalen Speicher einen NUMA-Knoten. Ein AMD-EPYC-System mit zwei Sockeln hat mindestens zwei NUMA-Knoten. Manche EPYC-Prozessoren zeigen vier NUMA-Knoten pro Sockel (einen pro CCD), was auf einer Platine mit zwei Sockeln acht Knoten ergibt.
Der Leistungsunterschied zwischen lokalem und entferntem Speicherzugriff ist nicht subtil. Lokaler Zugriff liegt bei etwa 80–100 ns. Entfernter Zugriff liegt bei etwa 130–200 ns. Das sind 50–100 % Aufschlag pro Speicheroperation. Für sich genommen ist das eine sehr kleine Zahl. Bei jedem Speicherzugriff über die Lebensdauer der VM bezahlt, hört sie auf, klein zu sein.
Warum es für Virtualisierung zählt
Wenn Proxmox eine VM anlegt, weist es vCPUs und RAM zu. Standardmäßig können diese vCPUs auf jedem physischen Kern auf jedem Sockel eingeplant werden. Das RAM der VM kann aus dem Speicherpool jedes NUMA-Knotens kommen.
Legt der Scheduler eine vCPU auf Sockel 0 und liegt das RAM der VM auf Sockel 1, überquert jeder Speicherzugriff dieser vCPU die Verbindung zwischen den Sockeln. Springen die vCPUs zwischen den Sockeln — und das tun sie, wenn sie nicht angepinnt sind —, wird das Zugriffsmuster ein Durcheinander. Manche Zugriffe sind lokal, manche entfernt, und die Leistung der VM zittert entsprechend.
Für allgemeine Lasten — ein Webserver, ein Fileserver, eine Desktop-VM — ist das oft erträglich. Der Overhead ist da, verteilt sich aber über viele Operationen und dominiert nicht.
Für IO-lastige Arbeit — Datenbanken, Storage-Server, alles mit schwerem Disk- oder Netzwerk-IO — wächst der Aufschlag zusammen. Jede DMA-Fertigmeldung, jede Interrupt-Zustellung, jedes Kopieren eines Puffers geht über den Speicher. Überqueren diese Zugriffe die Sockel, summiert sich der Overhead schnell.
Warum es beim Passthrough zählt
PCIe-Geräte sind physisch an einen bestimmten CPU-Sockel verdrahtet. Jeder Sockel hat seinen eigenen PCIe-Root-Complex. Das NVMe-Laufwerk in Slot 3 hängt vielleicht an den PCIe-Lanes von Sockel 0. Die GPU in Slot 5 vielleicht an denen von Sockel 1.
Wenn ein Gerät DMA macht, landen die Daten im Speicher, der an dem NUMA-Knoten hängt, auf den die IOMMU sie abbildet. Kommt das RAM der VM aus dem lokalen Knoten des Geräts, geht der DMA-Schreibvorgang direkt in den lokalen Speicher. Liegt das RAM auf dem anderen Knoten, überquert jede DMA-Operation die Verbindung zwischen den Sockeln.
Für ein NVMe-Laufwerk mit hunderttausenden IOPS summieren sich diese 50–100 ns pro Operation.
Bei iodepth=32 mit zufälligen 4-KB-Lesezugriffen kann der Durchsatzunterschied zwischen ausgerichtetem und fehlausgerichtetem NUMA 20–30 % betragen.
Und das, bevor du auf IOMMU-Overhead, ASPM, MPS oder irgendwas anderes geschaut hast.
Dasselbe gilt für Netzwerkkarten, GPUs und jedes andere durchgereichte Gerät. Der DMA-Verkehr des Geräts sollte im lokalen Speicher landen, und die vCPUs, die diesen Verkehr verarbeiten, sollten auf demselben Knoten sitzen.
Wie du deine Topologie prüfst
Herausfinden, auf welchem NUMA-Knoten ein Gerät sitzt
# Replace 0000:XX:00.0 with your device's PCI address from lspci
cat /sys/bus/pci/devices/0000:XX:00.0/numa_node
Das gibt die Nummer des NUMA-Knotens zurück.
Kommt -1 zurück, konnte der Kernel den Knoten nicht bestimmen. Das passiert manchmal bei Geräten hinter bestimmten PCIe-Switches.
Verfolge in diesem Fall die PCIe-Topologie mit lspci -tv von Hand und ordne den Root Port dem Sockel zu.
Das ganze NUMA-Layout ansehen
numactl --hardware
Das zeigt dir jeden NUMA-Knoten, wie viele CPU-Kerne darauf sitzen, wie viel Speicher daran hängt und die Distanz (die relativen Kosten) zwischen den Knoten.
Beispielausgabe von einem EPYC-System mit zwei Sockeln:
available: 2 nodes (0-1)
node 0 cpus: 0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
node 0 size: 131072 MB
node 1 cpus: 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31
node 1 size: 131072 MB
node distances:
node   0   1
  0:  10  32
  1:  32  10
Die Distanztabelle nennt dir die relativen Kosten. 10 ist lokal. 32 ist entfernt. Höhere Zahlen heißen mehr Sprünge. Bei EPYC-Aufbauten mit vier Knoten pro Sockel haben manche Knotenpaare eine Distanz von 32 und andere von 16, je nachdem, auf welchem CCD sie sitzen.
Geräte den Knoten zuordnen
# List all PCI devices and their NUMA nodes
for dev in /sys/bus/pci/devices/*; do
    node=$(cat "$dev/numa_node" 2>/dev/null)
    echo "$(basename $dev) node=$node $(lspci -s $(basename $dev) 2>/dev/null | cut -d' ' -f2-)"
done
Das gibt dir ein vollständiges Bild davon, welche Geräte auf welchen Knoten sitzen. Halte Ausschau nach deinen NVMe-Controllern, Netzwerkkarten und allen GPUs, die du durchreichst.
Wie man eine VM in Proxmox ausrichtet
vCPUs auf den richtigen Knoten pinnen
In der Konfigurationsdatei der VM (/etc/pve/qemu-server/<vmid>.conf):
numa: 1
affinity: 0-15    # Adjust to match cores on the correct NUMA node
Der Parameter affinity pinnt die vCPUs der VM auf bestimmte physische Kerne.
Setz ihn auf den Bereich der Kerne, die auf demselben NUMA-Knoten sitzen wie dein durchgereichtes Gerät.
Sitzt dein NVMe auf Knoten 1 und hat Knoten 1 die Kerne 16–31, dann setz affinity: 16-31.
Braucht die VM nur 8 vCPUs, pinn auf eine Teilmenge: affinity: 16-23.
Speicher vom richtigen Knoten zuweisen
numa: 1 in der VM-Konfiguration sagt Proxmox, der VM eine NUMA-Topologie zu zeigen.
QEMU wird dann versuchen, den Speicher der VM von dem NUMA-Knoten zu nehmen, auf den die vCPUs gepinnt sind.
Für ausdrückliche Kontrolle kannst du die NUMA-Topologie in der VM-Konfiguration setzen:
numa0: cpus=0-7,hostnodes=0,memory=16384,policy=bind
Das sagt QEMU, den ersten NUMA-Knoten der VM (aus Sicht des Gasts Knoten 0) an den NUMA-Knoten 0 des Hosts zu binden, mit den Kernen 0–7 und 16 GB Speicher.
Das policy=bind stellt sicher, dass der Speicher strikt von diesem Knoten kommt und nicht auf andere Knoten ausweicht, wenn der lokale Pool unter Druck steht.
Das Pinnen prüfen
Nachdem die VM gestartet ist, prüfen, ob die vCPUs wirklich dort laufen, wo du sie erwartest:
# Find the QEMU process
pgrep -a qemu | grep <vmid>

# Check CPU affinity of the process
taskset -cp <pid>

# Or check per-vCPU thread affinity
for tid in $(ls /proc/<pid>/task/); do
    echo "Thread $tid: $(taskset -cp $tid 2>/dev/null)"
done
Häufige Fehler
Überhaupt nicht pinnen
Setzt du affinity nicht, können die vCPUs der VM auf jedem Kern eingeplant werden.
Der Scheduler des Kernels wird sie zum Lastausgleich zwischen den Knoten verschieben.
Jedes Mal, wenn eine vCPU von einem Knoten auf einen anderen wandert, werden alle Daten, mit denen sie im Cache des alten Knotens gearbeitet hat, entfernt.
Für allgemeine VMs ist das hinnehmbar. Für Passthrough-VMs mit schwerem IO nicht.
Auf den falschen Knoten pinnen
Prüfe den NUMA-Knoten des Geräts, bevor du pinnst.
Nimm nichts an.
Auf manchen Mainboards passt die physische Numerierung der Slots nicht auf einleuchtende Weise zur Zuordnung der NUMA-Knoten.
Prüf es immer mit cat /sys/bus/pci/devices/.../numa_node.
Einen Knoten überbuchen
Pinnst du zu viele VMs auf denselben NUMA-Knoten, werden die Kerne dieses Knotens überbucht und der lokale Speicherpool geht zu Ende. Wenn der Speicher auf den entfernten Knoten überläuft, hast du das Schlechteste von beidem: gepinnte vCPUs mit entferntem Speicher.
Verteile deine VMs im Gleichgewicht über die Knoten. Hast du zwei NUMA-Knoten und vier VMs, verteile sie gleichmäßig.
Die Speicherzuweisung vergessen
vCPUs zu pinnen, ohne auch die Speicherzuweisung zu steuern, bringt dir die Hälfte des Nutzens.
Die vCPUs sitzen auf dem richtigen Knoten, der Speicher vielleicht nicht.
Nutze policy=bind oder mindestens numa: 1, damit QEMUs Zuweisung dem CPU-Pinning folgt.
Systeme mit einem Sockel
Auf einem System mit einem Sockel sitzt alles auf NUMA-Knoten 0. Es gibt nur einen Speichercontroller und einen Satz PCIe-Lanes. NUMA-Ausrichtung ist kein Thema.
Du kannst numa: 1 trotzdem in der VM-Konfiguration setzen — es schadet nicht —, aber es hilft auch nicht.
Ein Sockel, ein Speichercontroller, nichts auszurichten.
Spar die Mühe für eine Kiste, die zwei hat.
Damit gelten die hier beschriebenen Leistungsgewinne nur für Systeme mit mehreren Sockeln, bei denen es die Verbindung zwischen den Sockeln überhaupt gibt.
Quellen
- Proxmox VE Administration Guide — CPU and NUMA Configuration — die offizielle Dokumentation zu vCPU-Pinning und NUMA-Optionen
- NUMA-Dokumentation des Linux-Kernels — Referenz zur Speicherpolitik im Kernel
- AMD EPYC 7003 Series — BIOS & Workload Tuning Guide (Dokument 58002) — AMDs Dokumentation zu NUMA pro Sockel und zur CCD-/CCX-Topologie