Die Frage, mit der jede Proxmox-Bewertung anfängt
„Ist Proxmox wirklich für Unternehmen tauglich?“
Sie kommt in fast jedem Migrationsgespräch auf, und die Sorge darunter ist so gut wie nie die Weboberfläche. Niemand fürchtet ernsthaft, dass ein Browser-Dashboard seine Daten verdirbt. Was Leute fragen, ist, ob das Ding, das zwischen einer virtuellen Maschine und der Hardware steht — das Bauteil, das einen Mieter aus dem Speicher eines anderen Mieters heraushalten muss, für immer, ohne einen einzigen Fehler — ein ernstes Stück Technik ist oder ein Gemeinschaftsprojekt, das beliebt geworden ist.
Genau davor sollte man nervös sein. Es zielt bloß auf die falsche Schicht, denn Proxmox VE enthält keinen Hypervisor.
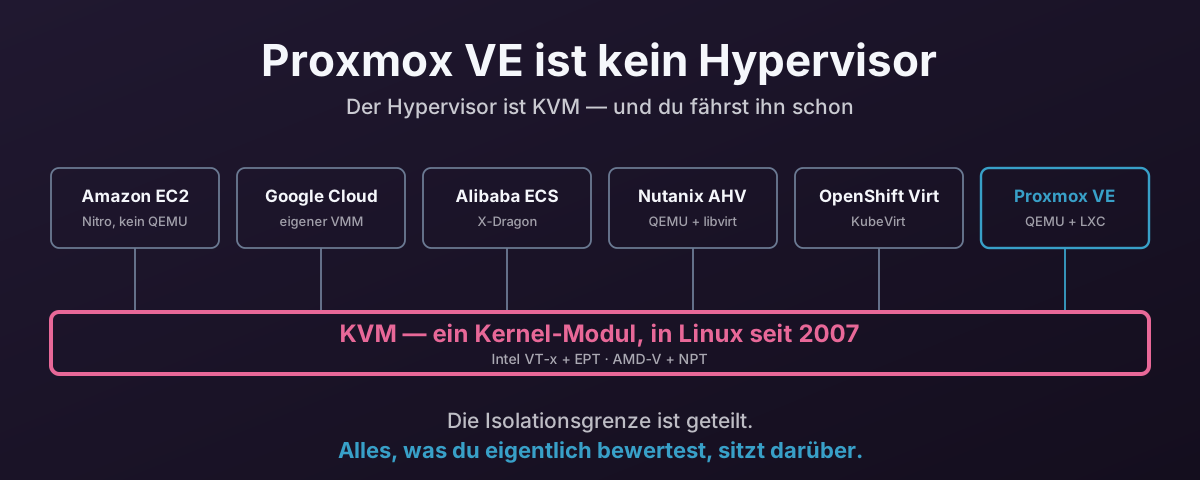
Der Hypervisor ist KVM. Er ist Teil von Linux, er ist seit 2007 da, und nutzt deine Organisation EC2, Google Cloud, Oracle Cloud, Alibaba Cloud, DigitalOcean oder Nutanix, dann fährst du ihn heute schon produktiv — du hast bloß nie darüber nachdenken müssen, weil jemand anders die Schichten darüber besaß.
Dieser Beitrag handelt davon, was dieses gemeinsame Fundament tatsächlich bedeutet. Beide Hälften davon: der Teil des Arguments, der wirklich hält, und der Teil, der in Hersteller-Folien überzogen wird.
Proxmox VE ist eine Verwaltungsschicht
Virtualisierung auf Linux sind vier verschiedene Schichten, von vier verschiedenen Gruppen Menschen gebaut und gepflegt.
1. Hardware-Virtualisierungserweiterungen. Intel VT-x mit EPT, oder AMD-V mit NPT. Silizium. Das ist, was einen Gast befähigt, seinen eigenen Kernel mit voller Geschwindigkeit und eigenen Seitentabellen zu fahren, ohne dass etwas Befehle nachbildet.
2. KVM — der Hypervisor.
Kernel-Module: kvm.ko für den architekturunabhängigen Kern, plus kvm-intel.ko oder kvm-amd.ko für die Herstellererweiterungen. Das ist das Bauteil, das die Isolationsgrenze besitzt. Es setzt die Kontrollstrukturen der virtuellen Maschine des Gastes auf, behandelt VM-Exits, verwaltet die Seitentabellen der zweiten Ebene und liefert Interrupts.
3. Der VMM — der Virtual Machine Monitor, im User Space. Auf Proxmox VE ist das QEMU. Es baut das virtuelle Mainboard: Chipsatz, PCIe-Topologie, Platten, NICs, seriell, Firmware. KVM fährt die CPU; QEMU entscheidet, welche Hardware der Gast zu haben glaubt.
4. Die Verwaltungsschicht.
Das ist Proxmox VE: pve-manager und pveproxy für API und Oberfläche, qemu-server, um aus einer VM-Konfigurationsdatei eine QEMU-Kommandozeile zu machen, pve-container für LXC, pmxcfs auf Corosync für die replizierte Cluster-Konfiguration, pve-ha-manager für Fencing und Neustart, plus Firewall und SDN-Stapel.
Diese vier Schichten gibt es auch auf der Plattform, von der du migrierst, und sie machen dieselben vier Aufgaben — vCenter ist Schicht 4, VMkernel ist Schicht 2 —, und ich komme auf diesen Vergleich zurück, sobald die Teile auf dem Tisch liegen.
Was Proxmox tatsächlich pflegt
Proxmox VE besitzt Schicht 4 ganz. Es wäre allerdings falsch zu sagen, es packe die Schichten 2 und 3 bloß ein, und das ist das häufigste Missverständnis dessen, was die Firma tut.
pve-qemu trägt zum Zeitpunkt des Schreibens 78 Patches gegen Upstream-QEMU in seiner Series-Datei:
debian/patches/series gezeichnet. Der größte Teil der Reihe ist Proxmox’ eigene Arbeit, und sie sitzt vollständig in Schicht 3 — keiner dieser Patches berührt kvm.ko.Sie bauen auch ihren eigenen Kernel und pflegen Pakete oder Patches für den größten Teil des umgebenden Stapels — pve-edk2-firmware für OVMF, plus lxc, zfsonlinux, openvswitch, libiscsi, corosync-pve, lvm und ceph.
Die echte Grenze ist also: ganz Schicht 4, erhebliche Arbeit in Schicht 3 und ein Kernel, den sie kompilieren. Was sie nicht getan haben, ist einen Hypervisor zu schreiben. Der KVM-Code von Schicht 2 ist Upstream-Linux.
Und nichts davon ist eine Kritik an Proxmox. Es ist eher der Grund, warum man einer Firma von der Größe Proxmox’ die Aufgabe überhaupt zutrauen kann. Eine kleine Firma in Wien hat sich nicht hingesetzt und einen Hypervisor von Grund auf geschrieben; sie hat auf einem aufgebaut, für dessen Pflege Intel, AMD, Red Hat, Google, Amazon und IBM schon Ingenieure bezahlten, und ihre eigene Kraft in die Schicht darüber und in die Integrationsarbeit gesteckt, die diese Schicht braucht. Dort kann ein Team dieser Größe einen Unterschied machen, und die Patch-Reihe zeigt sie dabei.
Was KVM tatsächlich ist
KVM steht für Kernel-based Virtual Machine, und der Name ist genau: es ist eine Kernel-Funktion, kein Programm.
Lade die Module, und Linux gewinnt ein Zeichengerät, /dev/kvm, plus eine kleine Menge ioctl-Aufrufe darauf — KVM_CREATE_VM, KVM_CREATE_VCPU, KVM_SET_USER_MEMORY_REGION, KVM_RUN.
Diese Schnittstelle ist die ganze Hypervisor-API. Alles, was einen Dateideskriptor öffnen und ioctl aufrufen kann, kann virtuelle Maschinen anlegen.
Geschrieben wurde es von Avi Kivity bei Qumranet und in Linux 2.6.20 aufgenommen, veröffentlicht im Februar 2007 — vor neunzehn Jahren. Red Hat kaufte Qumranet 2008, und KVM ist seither in jeder Kernel-Veröffentlichung ausgeliefert, im üblichen Takt des Kernels von neun bis zehn Wochen. Es ist weit über x86 hinaus portiert worden: arm64, POWER, s390 auf IBM Z und RISC-V.
Der wichtige Architekturpunkt ist, warum es klein ist.
KVM hat keinen Scheduler, denn Linux hat einen. Eine vCPU ist ein gewöhnlicher Host-Thread, und der Completely Fair Scheduler legt ihn auf einen Kern wie jeden anderen Thread. Es hat keine Speicherverwaltung, denn Linux hat eine. Gast-RAM ist eine normale Abbildung im User Space, kann also ausgelagert, mit Hugepages hinterlegt oder mit derselben Maschinerie wie bei jedem anderen Prozess auf einen NUMA-Knoten gelegt werden. Es hat keinen Treiberstapel, keine Blockschicht, keinen Netzstapel und kein Dateisystem, denn Linux hatte all das schon, und es sind die, gegen die dein Hardware-Hersteller testet.
Das ist das eigentliche Reife-Argument, und es ist viel stärker als eine Versionsnummer. Jede Verbesserung am NUMA-Balancing, jede Änderung an io_uring, jeder Netztreiber, jede neue Umgehung eines CPU-Errata, die in Linux landet, landet unter deinen virtuellen Maschinen, denn es gibt keinen eigenen Hypervisor-Kernel, in den es jemand portieren müsste.
Das Typ-1-Argument zieht die Linie an der falschen Stelle
Der Einwand, der darauf folgt, verlässlich, ist, dass KVM „nur ein Typ-2-Hypervisor“ sei. Er laufe auf einem Host-Betriebssystem, anders als ESXi, das auf blankem Blech läuft.
Diese Einteilung ist drei Jahrzehnte älter als Hardware-Virtualisierung, und das, worum sie eine Linie ziehen wollte, liegt nicht mehr dort, wo alle es vermuten.
Was tatsächlich passiert, wenn eine vCPU läuft
QEMU ruft ioctl(vcpu_fd, KVM_RUN). Die Kontrolle geht an kvm.ko, das den CPU-Zustand des Gastes lädt und VMLAUNCH ausführt. Von diesem Befehl bis zum nächsten VM-Exit läuft der Gast direkt auf dem physischen Kern, im Gastmodus, mit seinen eigenen über EPT aktiven Seitentabellen, mit voller Hardware-Geschwindigkeit. Darunter ist nichts, das irgendetwas auslegt. Das „Host-Betriebssystem“ ist nicht im Weg. Es läuft auf diesem Kern nicht einmal.
Tut der Gast etwas, das behandelt werden muss, tritt die CPU zum Host aus — und landet in kvm.ko, im Kernel, auf genau der Privilegienstufe, die ESXis VMkernel einnimmt. Die meisten Exits werden dort aufgelöst und wieder betreten, ohne dass der User Space je beteiligt ist.
ESXi hat dieselbe Aufteilung
Sieh nun die Plattform an, die die Unterscheidung angeblich belegt.
VMwares eigene Architekturdokumentation beschreibt VMkernel als „a POSIX-like operating system“, das „process creation and control, signals, file system, and process threads“ bereitstellt. Das ist ein Betriebssystem, nach der Beschreibung seines Autors. Und eine laufende VM auf ESXi ist kein Ding im Kernel — sie ist eine Gruppe von Userworld-Prozessen: ein VMM je virtuelle CPU, der die Befehle des Gastes virtualisiert und seinen Speicher verwaltet, und ein VMX-Prozess je VM, der das I/O zu den Geräten übernimmt, die nicht leistungskritisch sind, und mit dem Snapshot-Manager und der Fernkonsole spricht.
Lies das mit QEMU im Kopf. Ausführungskontext je vCPU im Kernel, Prozess je VM im User Space, der Geräte nachbildet und verwaltet. VMware hat es aus demselben Grund aufgeteilt wie alle anderen.
Hyper-V ist nicht anders. Microsofts Dokumentation ist ausdrücklich, dass der Virtual Machine Worker Process, vmwp.exe, „a user mode component of the virtualization stack“ ist, je VM gestartet, und dass alle nachgebildeten Geräte darin umgesetzt sind — laufend in der Root-Partition, und die ist Windows. Selbst Xen, die Architektur, auf die die Einteilung am besten passt, braucht ein Linux für allgemeine Zwecke in dom0, um zu funktionieren, und bekommt sein Gerätemodell für voll virtualisierte Gäste von QEMU.
Wo ist die Linie also?
Das Kriterium war nie „nutzt es den User Space“. Goldbergs Einteilung von Anfang der 1970er fragt, ob der Hypervisor eine Anwendung ist, die auf einem bereits vorhandenen Betriebssystem läuft, das die Hardware schon besitzt und das Scheduling macht. Das ist ein Typ-2-Hypervisor, ein beherbergter: VMware Workstation, VirtualBox, Parallels Desktop, einfaches QEMU ohne Beschleunigung. Du installierst ein Betriebssystem für allgemeine Zwecke, dann installierst du darauf ein Programm, und dieses Programm bittet das Betriebssystem um Speicher und CPU-Zeit wie jedes andere Programm.
Das ist nicht, was KVM ist. kvm.ko ist kein Programm auf Linux. Es ist Teil von Linux, es läuft auf derselben Privilegienstufe wie der Code, der die Hardware besitzt, und tritt ein Gast aus, landet er direkt dort. Unter dem Hypervisor gibt es kein Host-Betriebssystem. Der Kernel ist der Hypervisor. Proxmox VE liefert diesen Kernel als das System aus, genau so, wie ESXi VMkernel als das System ausliefert.
Und die Fassung „es braucht User Space, also ist es Typ 2“ lässt sich nicht retten, denn gleichmäßig angelegt erwischt sie alles. Keine VM läuft auf ESXi ohne ihren VMX-Prozess, keine auf Hyper-V ohne vmwp.exe, keine auf Xen als HVM-Gast ohne QEMU. Eine Prüfung, die jeden ausgelieferten Hypervisor in einen Eimer legt, unterscheidet nichts.
| Kernel, der CPU- und Speichervirtualisierung besitzt | Gerätemodell je VM im User Space | Braucht ein vorhandenes Host-Betriebssystem? | |
|---|---|---|---|
| VMware ESXi | VMkernel | VMX je VM | Nein |
| Microsoft Hyper-V | Hypervisor plus die Windows-Root-Partition | vmwp.exe | Nein |
| Xen | Xen-Hypervisor plus dom0-Linux | QEMU, in dom0 oder einer Stub-Domain | Nein |
| KVM | kvm.ko | QEMU | Nein |
| VirtualBox, VMware Workstation | der Kernel des Hosts, über einen installierten Treiber | die Anwendung selbst | Ja |
Vier Produkte, eine Form — und dann eine fünfte Zeile, die wirklich anders ist. Diese letzte Zeile ist, was „Typ 2“ beschreiben sollte, und es ist die einzige, in der etwas anderes die Hardware schon in der Hand hatte.
Die Einteilung zieht also durchaus eine Linie. Sie zieht sie bloß nirgends in der Nähe der Stelle, die das Argument annimmt: KVM und ESXi sind auf derselben Seite davon. KVM Typ 2 zu nennen leiht ein Wort aus der VirtualBox-Kategorie und legt es auf etwas, das architektonisch in der ESXi-Kategorie liegt.
Damit leistet das Etikett in einer Bewertung keine nützliche Arbeit, denn beide Produkte, zwischen denen du wählst, sitzen im selben Kasten. Was sich unterscheidet, ist nicht die Typnummer. Es ist, dass ein Hersteller auch den Kernel geschrieben hat und dich nicht hineinsehen lässt — eine Unterscheidung über Lizenz und Offenheit im Gewand eines Architekturdiagramms. Nutanix zeigt den Punkt kaufmännisch: es liefert denselben KVM-Code aus wie Proxmox und beschreibt AHV als Typ-1-Hypervisor auf blankem Blech. Derselbe Code, umgekehrtes Etikett, andere Marketingabteilung.
Es steckt doch eine echte Sorge in dem Vorwurf, und sie verdient einen besseren Namen: ein Kernel für allgemeine Zwecke macht tausend Aufgaben, die ein zweckgebauter nicht macht, und das ist mehr Code und mehr Angriffsfläche neben der Isolationsgrenze. Das ist berechtigt und messbar, und ich komme am Ende darauf zurück.
Wo die Arbeit tatsächlich passiert
Die eine Stelle, an der das Gefühl „es läuft auf einem Host-Betriebssystem“ einen echten Punkt hat, ist die Behandlung der Exits, und es lohnt sich, klar zu sein, welche Exits wohin gehen.
| Der Gast tut das | Behandelt von | Kosten |
|---|---|---|
| Berührt eine Seite, die in EPT/NPT noch nicht abgebildet ist | kvm.ko, im Kernel | Ein Exit, Mikrosekunden |
| Schreibt in seinen lokalen APIC | Die CPU selbst, über APICv/AVIC | Oft überhaupt kein Exit |
| Sendet einen Interrupt zwischen Prozessoren | Posted Interrupts in Hardware | Oft kein Exit |
Sendet auf einer virtio-net-Queue mit vhost-net | Kernel-Thread, kein Sprung in den User Space | Eine Türglocke |
| Liest ein Register an einem nachgebildeten e1000 oder IDE-Controller | Ganz hinaus zu QEMU | Exit plus Hin und Her im User Space |
Nur die letzte Zeile sieht überhaupt wie das Typ-2-Zerrbild aus — und es ist auch die Zeile, die du wegkonstruierst, indem du virtio-Geräte nutzt und keine nachgebildete Altgeräte-Hardware zeigst, die du nicht brauchst. Das ist dieselbe Begründung wie hinter Q35 statt i440fx: weniger abgefangene Registerzugriffe, weniger Altgeräte, die durchlaufen werden müssen.
Das Host-Betriebssystem ist eine Funktion, kein Ballast
Die andere Hälfte dieser Rechnung schafft es nie in das Argument, also hier ist sie: ein Proxmox-Knoten ist eine Maschine, an der du tatsächlich arbeiten kannst. Es ist Debian, das ganze Debian-Archiv ist also ein apt install entfernt.
- Überwachung, die du schon fährst — ein Prometheus-Node-Exporter,
smartmontools, dein vorhandener Agent — statt dessen, was die Appliance zu zeigen beschließt. - Diagnose, wenn etwas langsam ist:
fio,iperf3,nvme-cli,perf,bpftrace. - Sicherungsagenten von jedem Hersteller, der eine Linux-Binärdatei ausliefert.
- Konfigurationsverwaltung, sodass der Hypervisor im selben Ansible-Inventar sitzt wie alles andere, statt ein Sonderfall zu sein.
fwupdfür Firmware, auf Hardware, deren Hersteller LVFS unterstützt.
Nichts davon braucht ein Plugin-Format, ein signiertes Bündel oder den Segen eines Herstellers. Vergleich das mit dem ESXi-Modell, wo die Shell absichtlich eingeschränkt ist, Code von Dritten als VIB ankommt und es überhaupt keine Paketverwaltung gibt, nach der man greifen könnte.
Es greift in den Speicherstapel hinein
Überwachungsagenten sind die langweilige Fassung davon. Proxmox’ eigene Speicherdokumentation listet die eingebauten Plugins — dir, NFS, CIFS, CephFS, ZFS, BTRFS, LVM, LVM-thin, iSCSI, FC/SAS, RBD, ZFS-über-iSCSI, PBS — und fügt dann einen Satz an, den man wörtlich nehmen sollte:
you may use all storage technologies available for Debian Linux
Das ist eine Aussage darüber, wo die Grenze liegt, und der Mechanismus dahinter ist allgemein: hol ein Blockgerät auf jeden Knoten, leg LVM darauf, füg es als LVM-Speicher mit eingeschaltetem shared hinzu. Genau so arbeiten die unterstützten Wege über Fibre Channel und iSCSI, alles, was ein gemeinsames Blockgerät erzeugen kann, kann also denselben Weg nutzen.
NVMe over TCP oder RDMA ist der Fall, den man kennen sollte, denn er ist schnell, aktuell und fehlt in dieser Plugin-Liste. nvme-tcp und nvme-rdma sind Host-Treiber im Linux-Baum — NVMe/TCP ist seit 5.0 im Mainline —, es gibt also nichts zu kompilieren. nvme-cli ist ein Debian-Paket (nvme discover, dann nvme connect), und nvmetcli konfiguriert das nvmet-Target im Kernel am anderen Ende. Ein verbundenes Namespace erscheint als /dev/nvmeXnY, und von da an ist es ein gewöhnliches Blockgerät.
ATA over Ethernet macht denselben Punkt vom anderen Ende des Spektrums — alt, obskur, als Plugin genauso nicht unterstützt. Der aoe-Treiber ist im Mainline; aoetools gibt dir aoe-discover und aoe-stat; vblade macht aus jeder Datei oder jedem Blockgerät auf einer anderen Maschine ein Target. Derselbe Weg, dasselbe Ergebnis.
Keins von beiden ist eine Plugin-API, ein SDK oder ein Zertifizierungsprogramm. Es ist, was passiert, wenn die Speicherschicht des Hypervisors die Linux-Blockschicht ist.
Die ehrlichen Vorbehalte, denn das liest sich wie ein Partytrick, bis es 3 Uhr morgens ist. Keiner der beiden Transporte ist ein getesteter Proxmox-Speichertyp, die Integration und ihre Fehlerfälle — Verhalten beim Wiederverbinden, Multipath, Zeitüberschreitungen unter Last — gehören also dir, und du musst sie testen, bevor etwas Wichtiges darauf wohnt. Und AoE ist ein nacktes Protokoll auf Schicht 2, nicht routbar und ohne Anmeldung, es gehört also auf ein abgetrenntes Speicher-VLAN und nirgendwo sonst. NVMe/TCP hat zumindest ein Modell für die Entdeckung und lässt sich routen, und das ist ein großer Teil davon, warum es das ist, nach dem man heute greift.
Wer sonst KVM fährt
Hier kommt die Behauptung „du fährst es schon“ her. Jede Plattform unten fährt dasselbe Kernel-Modul.
| Plattform | Wo du ihm begegnest | Der KVM-Teil | Der VMM im User Space |
|---|---|---|---|
| Amazon EC2 (Nitro) | Öffentliche Cloud | KVM-Kernmodul | Eigen — QEMU entfernt, Gerätemodell in den Nitro-Karten |
| AWS Lambda, Fargate | Serverless | /dev/kvm | Firecracker — ein minimaler MicroVM-Monitor in Rust |
| Google Compute Engine | Öffentliche Cloud | KVM seit dem Start | Googles eigener VMM, absichtlich nicht QEMU |
| Alibaba Cloud ECS | Öffentliche Cloud | Vereinfachtes KVM (X-Dragon) | Eigen, mit Netz und Speicher auf eine MoC-Karte ausgelagert |
| Oracle Cloud (OCI) | Öffentliche Cloud | Oracle Linux KVM — derselbe Stapel, den Oracle auch vor Ort ausliefert | QEMU-Abstammung |
| DigitalOcean, Linode/Akamai, Vultr, Hetzner, OVHcloud, Scaleway, UpCloud | Öffentliche Cloud | Standard-KVM | QEMU |
| Nutanix AHV | HCI vor Ort | Standard-KVM | QEMU mit libvirt und Open vSwitch |
| OpenStack (Nova) | Private Cloud | Standard-KVM | QEMU über libvirt — der voreingestellte und bestgetestete Treiber |
| Apache CloudStack, OpenNebula, oVirt | Vor Ort | Standard-KVM | QEMU über libvirt |
| OpenShift Virtualization, SUSE Harvester | Kubernetes | Standard-KVM | QEMU in einem Pod, über KubeVirt |
| Proxmox VE | Vor Ort | Standard-KVM | QEMU, mit LXC daneben für Container |
Alle behalten die Kernel-Hälfte und schreiben die User-Space-Hälfte neu
Die Hyperscaler haben KVM nicht geforkt. Sie haben die Aufgabe von QEMU geforkt.
AWS hat EC2 von Xen auf den Nitro-Hypervisor bewegt, der auf dem KVM-Kernmodul aufbaut, mit QEMU vollständig hinausgeworfen. Das Gerätemodell wohnt stattdessen in eigenen Nitro-Karten, und so bekommen sie Leistung, die von blankem Blech nicht zu unterscheiden ist. Jeder EC2-Instanztyp der aktuellen Generation fährt das. Getrennt davon fahren Lambda und Fargate Firecracker, einen zweckgebauten VMM in Rust, der mit demselben /dev/kvm spricht.
Google hat jede Compute-Engine-VM seit dem Start von Compute Engine auf KVM gefahren und einen eigenen VMM im User Space geschrieben statt QEMU zu nutzen, ausdrücklich, um QEMUs riesiger Matrix aus Gästen, Geräten und Modi zu entgehen. Sie sind auch den anderen Weg gegangen und haben das Kernel-Modul im Upstream gehärtet, nachgebildete Geräte entfernt, die niemand brauchte, und die Menge der nachgebildeten Befehle verengt. Diese Arbeit ist in dem KVM, das du fährst.
Alibaba hat mit X-Dragon dieselbe Form gemacht: ein abgemagerter KVM-Hypervisor mit der Netz- und Speichervirtualisierung auf eine FPGA-gestützte MoC-Karte ausgelagert.
Nutanix AHV ist KVM plus libvirt plus QEMU plus Open vSwitch plus Nutanix’ Orchestrierung — von jedem kommerziellen Produkt auf dieser Liste der nächste Verwandte, den Proxmox VE hat. Eine andere Schicht 4, und eine sehr andere Rechnung.
Proxmox VE behält QEMU mit Absicht
Es ist verlockend, die Tabelle als Rangliste zu lesen, mit AWS und Google oben, weil sie QEMU ersetzt haben. Das ist die falsche Lesart, denn ihre Randbedingung ist nicht deine.
AWS und Google fahren ein Hardware-Profil, in einem Maßstab, in dem ein einzelner Fehler in der Geräte-Nachbildung ein flottenweites Ereignis ist, und sie beherrschen jede Gast-Abbildgrenze, die ihnen wichtig ist. In dieser Welt ist QEMUs Breite fast nur Haftung, sie zu löschen ist also offensichtlich richtig.
Du bist nicht in dieser Welt.
Du hast ein Appliance-Abbild von 2013, das eine e1000 will. Du hast eine Windows-VM, deren Maschinentyp für den Rest ihres Lebens festgenagelt bleiben muss. Du hast eine GPU zum Durchreichen, einen nachgebildeten SAS-Controller, um ein Installationsprogramm zufriedenzustellen, einen UEFI-Variablenspeicher zu erhalten. QEMU ist genau das, was eine Plattform für allgemeine Zwecke zu all dem Ja sagen lässt.
Was AWS Angriffsfläche nennt, nennst du eine Kompatibilitätsmatrix. Beide Beschreibungen sind zutreffend; der Unterschied ist, ob du deine Lasten wählen darfst.
Es erklärt auch die Form dieser Patch-Reihe. AWS und Google haben Sicherung und Momentaufnahmen außerhalb des VMM gelöst, in ihren eigenen Speicherdiensten. Proxmox hatte keinen Speicherdienst, in dem sie es lösen konnten, also haben sie es in QEMU gelegt — und deshalb existieren savevm-async und der PBS-Blocktreiber als Patches und nicht als Produkte.
Und das ist aus einem praktischen Grund zu wissen wert: die Teile von Proxmox VE, die du am meisten vermissen würdest, sind die, die nicht Upstream sind. Deine VM-Konfigurationen sind einfacher Text und deine Plattenabbilder sind Standardformate, eine Maschine wird also umziehen. Aber eine Momentaufnahme samt RAM-Zustand und eine inkrementelle Kette des Proxmox Backup Servers hängen an Proxmox’ QEMU-Fork. Das ist eine viel leichtere Abhängigkeit als ein geschlossener Hypervisor — der Fork ist öffentlich, AGPL, und du kannst jeden Patch darin lesen —, aber sie ist nicht null, und „keine Bindung auf Softwareebene“ sollte diese Fußnote tragen.
Also — ist es für Unternehmen tauglich?
Die faule Form dieses Arguments funktioniert nicht, und das ist klar zu sagen wert. „AWS nutzt KVM, also ist Proxmox VE für Unternehmen tauglich“ ist ein Fehlschluss: es nimmt eine Behauptung über eine Schicht und legt sie still auf ein ganzes Produkt.
Hier ist die Fassung, die hält.
Geteilt ist die Schicht, die am schwersten richtig zu machen und am gefährlichsten falsch zu machen ist. CPU- und Speichervirtualisierung und die Isolationsgrenze zwischen Mietern sind der Teil, in dem ein Fehler ein Einbruch und kein Ausfall ist. Dieser Code wird von Ingenieuren geprüft, die Amazon, Google, Red Hat, Intel, AMD, IBM und Alibaba bezahlen, und seine Fehler werden von den Läden gefunden, die die größten Flotten betreiben, die es gibt — meist, bevor der Kernel dich erreicht. Landet doch eine Lücke, mit der ein Gast entkommt, kommt die Behebung über die normale Kernel-Aktualisierung, die du sowieso einspielen wolltest. Du wartest nicht auf den Veröffentlichungstakt eines Herstellers für einen Hypervisor, den nur dieser Hersteller sehen kann.
Nicht geteilt ist alles über der Grenze. Was heißt, dass die Frage in zwei viel beantwortbarere zerfällt:
- Ist die Verwaltungsschicht gut genug für die Art, wie du arbeitest?
- Kannst du dafür Unterstützung mit Bedingungen kaufen, mit denen du leben kannst?
Beides lässt sich in einem Proof of Concept prüfen und in einen Vertrag schreiben. Keines verlangt Glauben an einen Hypervisor.
Das ist eine viel bessere Lage als die, welche die ursprüngliche Frage annimmt — dass du einem neuartigen Hypervisor von einem kleinen Hersteller vertrauen sollst. Sollst du nicht. Der Proxmox-eigene Code ist eine Verwaltungsschicht, meist in Perl und zunehmend in Rust, plus diese Patch-Reihe gegen QEMU, und beachte, wo die Patches landen: im Gerätemodell und im Sicherungsweg, nicht an der Isolationsgrenze.
Es ist auch wert zu wissen, was es kostet, wenn die Proxmox-eigene Schicht ausfällt. Die QEMU-Prozesse sind gewöhnliche eigenständige Prozesse auf dem Host, ein umkippender pveproxy hält also keine einzige virtuelle Maschine an. Das ist eine ganz andere Wirkungsweite als das Bauteil zu verlieren, das die Isolationsgrenze besitzt.
Was „derselbe Hypervisor“ dir nicht kauft
Hier hören Vertrauensdokumente von Herstellern meist auf, und das sagt dir etwas darüber, für wen sie geschrieben sind. Es ist die nützlichere Hälfte.
Es kauft dir nicht die Verlässlichkeit von AWS. Nitros Verfügbarkeit hat sehr wenig mit KVM zu tun. Sie kommt von der Steuerebene, dem Netzgewebe, dem Speicherdienst, der Kapazitätsverwaltung und der betrieblichen Praxis darum herum. Die Verlässlichkeit deines Clusters kommt aus deinem Corosync-Quorum-Entwurf, deiner Fencing-Konfiguration, deiner Speicherwahl und deiner Netzredundanz. KVM hat zu keinem davon eine Meinung. Einen Hypervisor mit einem Hyperscaler zu teilen erbt nicht dessen Betrieb.
Es kauft dir nicht Nitros Angriffsfläche, und hier landet die berechtigte Hälfte des Typ-2-Vorwurfs.
Du fährst QEMU auf einem Kernel für allgemeine Zwecke, und historisch war QEMUs Gerätemodell die Stelle, an der die einprägsamen VM-Fluchten wohnten — VENOM, in einem nachgebildeten Floppy-Controller, den niemand nutzte, ist das kanonische Beispiel. Google konnte damals anmerken, dass Compute Engine genau deshalb nicht betroffen war, weil es QEMU nicht fährt. Du fährst es, die ausgleichenden Maßnahmen sind also deine: virtio statt nachgebildeter Hardware bevorzugen, keine Geräte zeigen, die du nicht brauchst, die AppArmor-Profile in Ruhe lassen, und QEMU mit derselben Disziplin patchen wie den Kernel. Proxmox’ extra/-Patches sind sie dabei, genau das für dich zu tun, und es ist vernünftig zu prüfen, dass sie es weiter tun.
Es macht das Verhalten von VMs zwischen Plattformen nicht übertragbar.
Die Wahl des CPU-Modells, die Versionierung des Maschinentyps, die Kompatibilität für Live-Migration und das Verhalten der Uhr werden alle in den Schichten 3 und 4 entschieden, und sie unterscheiden sich überall. Ein Cluster mit gemischten CPU-Generationen wird dich weiter dafür bestrafen, den CPU-Typ auf host zu setzen, und Gastuhren laufen weiter auseinander, welches Logo auch auf der Plattform steht. Derselbe Hypervisor ist nicht dasselbe Verhalten.
Es beantwortet nicht die Frage nach der Unterstützung — und die ist die, die den Einkauf tatsächlich interessiert, und das zu Recht. Proxmox VE ist AGPLv3 und im Produktivbetrieb kostenlos zu fahren. Das Abonnement kauft das für Unternehmen getestete Repository und Hersteller-Unterstützung, ab 120 € je Sockel und Jahr. Proxmox’ eigene Unterstützung wird zu österreichischen Geschäftszeiten geleistet, Abdeckung rund um die Uhr kommt also von Partnern und nicht aus Wien. croit, wo ich arbeite, ist einer dieser Partner und deckt 24/7 an 365 Tagen im Jahr. Das ist eine kaufmännische Verhandlung und kein technisches Risiko — und dass es eine kaufmännische Verhandlung ist, ist der Sinn von allem oben.
Was tatsächlich stattdessen zu bewerten ist
Ist der Hypervisor erledigt, sollte ein Proof of Concept seine Zeit auf der Schicht verbringen, die wirklich Proxmox-VE-eigen ist:
- Fencing und HA. Zieh einem Knoten mit laufenden HA-Gästen den Strom und nimm die Zeit für den Neustart. Dann mach es mit zwei Knoten und bestätige, dass die übrigen sich so verhalten, wie du es erwartest, wenn das Quorum verloren ist.
- Live-Migration über CPU-Generationen. Mit dem CPU-Modell, auf das du dich tatsächlich festlegen willst, nicht
host. - Sicherung und, wichtiger, Wiederherstellung. Wiederherstellungszeiten unter Last, nicht Sicherungszeiten. Niemandem wurde je für eine schnelle Sicherung gedankt.
- Das Rechtemodell. Ob du einem Anwendungsteam Konsole und Ein-Aus-Kontrolle über die eigenen VMs geben kannst und nichts weiter, feinkörnig genug, um einen Prüfer zufriedenzustellen.
- Die API. Alles, was die Weboberfläche tut, ist ein API-Aufruf; kann deine Automatisierung sie nicht antreiben, passt die Plattform nicht zu deiner Arbeitsweise.
- Der Aktualisierungsweg. Eine Aktualisierung auf eine neue Hauptversion auf dem PoC-Cluster, bevor 400 VMs darauf sind.
Keine davon ist eine Frage über KVM. Das ist eher der Punkt.
Der Hypervisor ist der erledigte Teil. Verbring den Proof of Concept mit den Teilen, die es nicht sind.
Quellen
KVM selbst
- KVM-API-Dokumentation — die
/dev/kvm-ioctl-Schnittstelle, und die ist der ganze Vertrag des Hypervisors - Veröffentlichungshinweise zu Linux 2.6.20 — die Veröffentlichung, in die KVM aufgenommen wurde, Februar 2007
- Some KVM developments — LWN, Januar 2007, über KVM in den Tagen, nachdem es im Mainline landete
Wie die anderen Hypervisoren gebaut sind
- Interpreting virtual machine monitor and executable failures — Broadcoms eigene Beschreibung einer laufenden ESXi-VM als „several processes or userworlds“, mit einem VMM je vCPU und einem VMX je VM
- The Architecture of VMware ESXi (PDF) — das Whitepaper, das VMkernel „a POSIX-like operating system“ nennt, mit Prozessen, Signalen, Dateisystem und Threads. Über einen Spiegel verlinkt, weil die ursprüngliche VMware-URL die Broadcom-Umstellung nicht überlebt hat, was für sich ein kleiner Kommentar zur Beständigkeit von Herstellern ist
- Hyper-V-Architektur — Microsoft über den Virtual Machine Worker Process als Bauteil im User Mode, einer je VM, in dem alle nachgebildeten Geräte wohnen
- The Nutanix Bible — AHV-Architektur — AHV beschrieben als KVM mit libvirt, QEMU und Open vSwitch
Wer KVM fährt, und wie sie es verändert haben
- 7 ways we harden our KVM hypervisor at Google Cloud — Google über den Betrieb von KVM ohne QEMU und die Härtung, die sie im Upstream gemacht haben
- Das AWS-Nitro-System — welche EC2-Instanztypen den Nitro-Hypervisor fahren