Warum HDDs wieder auf der Karte stehen
Jahrelang war der Rat einfach genug für einen Klebezettel: leg alles auf SSDs.
Dieser Rat war richtig, und er war auch billig. Beides stimmt jetzt nicht mehr ganz. Das Angebot an NAND ist knapper geworden, die Nachfrage aus der KI hat die Flash-Preise hochgeschoben, und NVMe mit hoher Kapazität ist für eine kostenbewusste Proxmox-Installation schwer zu rechtfertigen — die Art, die betriebsfähig und verlässlich sein muss und so billig, wie Ehrlichkeit es zulässt.
HDDs für Unternehmen sind aus demselben Grund wieder interessant, aus dem sie es immer waren: Kapazität pro Pfund, und nichts sonst kommt heran.
Der Haken ist, dass jeder, der VMs auf sich drehenden Platten betrieben hat, weiß, wie schlecht das ausgehen kann. Diese Erfahrung ist echt, und meist ist die Architektur schuld und nicht die Platten.
Den Platten die Schuld zu geben ist allerdings leichter. Es ist auch falsch, und es ist teuer, denn es redet Leuten Flash ein, den sie nicht gebraucht hätten.
Alles Folgende geht von Proxmox mit hyperkonvergenten Ceph-OSDs aus, denn dort beißen die Entscheidungen zum Layout tatsächlich.
Das Problem ist Latenz, nicht Durchsatz
Eine moderne Unternehmens-HDD bewegt große sequentielle Daten völlig in Ordnung. Das war nie der Engpass.
Eine Unternehmensplatte mit 7,2k min⁻¹ liefert irgendwo um 80 bis 100 IOPS bei zufälliger Arbeit, denn jede zufällige Operation wartet auf eine Kopfsuche und eine Umdrehung des Tellers. Diese Zahl hat sich in zwanzig Jahren kaum bewegt. Es ist Mechanik, nicht Elektronik. Eine Einsteiger-SSD für Unternehmen ist drei oder vier Größenordnungen davon entfernt.
Gib derselben Platte sequentielle Arbeit, und sie ist ein brauchbares Gerät. Die Rate der Operationen verdoppelt sich etwa, auf rund 200 IOPS, aber jede dieser Operationen trägt jetzt einen großen Block, weil der Kopf schon an der richtigen Stelle ist und weiterströmen kann. Du bekommst also echten Durchsatz, 150 bis 250 MB/s davon, zu einem Preis pro Terabyte, an den nichts anderes herankommt.
Das ist die wichtige Ungleichheit, und sie heißt nicht „HDDs sind langsam“. Eine sich drehende Platte ist gut bei sequentieller Arbeit und hoffnungslos bei zufälliger, und die zwei Zahlen liegen nur deshalb nah beieinander, weil das Begrenzte die Zahl der Operationen ist und nicht die Byte.
Das legt die ganze Aufgabe fest. Du versuchst nicht, die Platte schneller zu machen. Das kannst du nicht. Du versuchst dafür zu sorgen, dass sie ihre Zeit in dem Modus verbringt, in dem sie schon taugt, und den kleinen zufälligen Verkehr von ihr wegzuhalten. Damit ist alles Folgende diese eine Idee, zweimal angewandt.
Das Problem ist, dass virtuelle Maschinen nicht die Last erzeugen, in der HDDs gut sind. Sie erzeugen Metadaten-Aktualisierungen, Journal-Schreibvorgänge, kleine synchrone Leerungen, Protokollierung, Hausarbeit des Dateisystems und Stöße zufälliger Aktivität von einem Dutzend Gästen gleichzeitig, die verschachtelt an der Platte eintreffen.
Ceph legt seine eigene Schicht darauf. Jeder Schreibvorgang trägt neben den Daten RocksDB-Metadaten-Aktualisierungen. Landet all das auf nackten Spindeln, verbringen die Platten ihre Zeit mit Suchen statt mit Liefern, und du bekommst das Symptom, das jeder Administrator kennt: hohes I/O-Warten, träge Gäste, ungleichmäßige Reaktion und ein Cluster, der sich weit langsamer anfühlt, als sein Datenblatt vermuten lässt.
Die eigene Hardware-Empfehlung von Ceph ist unmissverständlich darüber, wohin das führt. Sie warnt, man solle „consider carefully the ostensible cost-per-gigabyte advantage of larger HDDs, and the concomitant limitations of IOPS per TB“ — den scheinbaren Vorteil größerer HDDs bei den Kosten pro Gigabyte und die damit einhergehenden Grenzen der IOPS pro TB sorgfältig bedenken —, und sagt, Platten über 8 TB seien „may be best suited for storage of large files / objects that are not at all performance-sensitive“, also am besten für große Dateien und Objekte, bei denen Leistung überhaupt keine Rolle spielt.
Diese Rechnung lohnt sich, denn die Platten, die das überhaupt wirtschaftlich machen, sind große. 20 TB und mehr. Eine Platte mit 20 TB macht weiter ihre 80 bis 100 zufälligen IOPS, denn Kapazität kauft dir überhaupt keine Operationen. Sie bietet also etwa 4 bis 5 zufällige IOPS pro Terabyte, wo eine Platte mit 8 TB rund elf schafft und eine mit 2 TB vierzig.
Nach Cephs eigenem Maß liegt eine Spindel mit 20 TB also deutlich in dem Gebiet, auf das es dir sagt, keine leistungsempfindliche Arbeit zu legen.
Das ist kein Argument dagegen, sie zu kaufen. Es ist der Grund, warum der Rest dieses Beitrags existiert. Der Entwurf unten ist genau das, was eine Spindel mit 20 TB für VM-Speicher tragfähig macht, indem er dafür sorgt, dass die kleine zufällige Arbeit sie nie erreicht.
Die Metadaten von der Spindel wegholen
Die wertvollste Änderung an einem Cluster auf HDDs ist, die Spindel nicht mehr Cephs Buchhaltung speichern zu lassen.
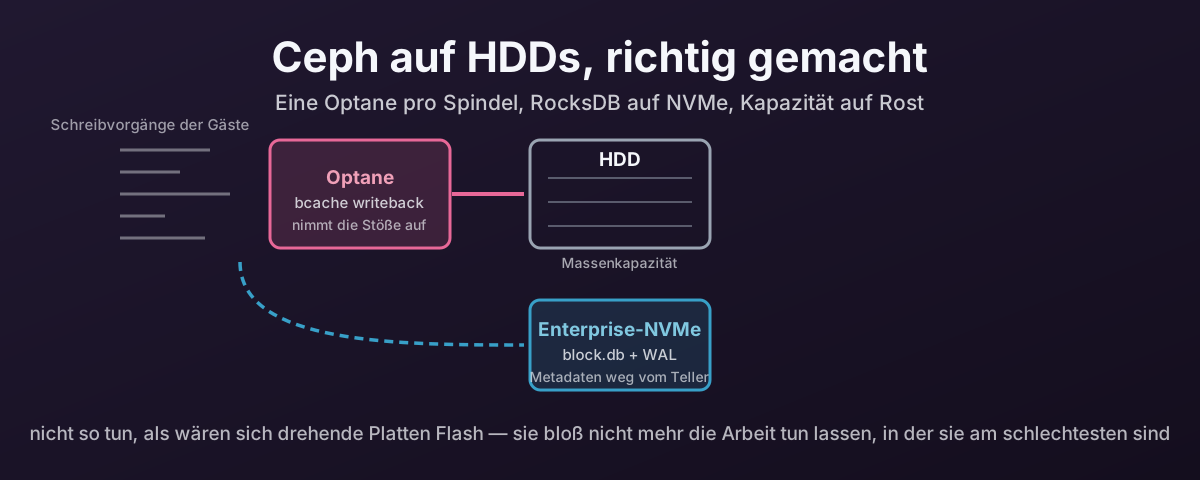
BlueStore hält pro OSD drei Dinge: die Daten selbst auf block, die RocksDB-Metadatenbank auf block.db und das Write-Ahead-Log auf block.wal. Standardmäßig wohnen alle drei auf demselben Gerät. Leg block.db stattdessen auf NVMe, und eine große Menge kleines zufälliges I/O verlässt die Platte vollständig.
Cephs Hardware-Dokumentation sagt es klar: „HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD“ — HDD-OSDs können eine deutliche Verbesserung der Schreiblatenz sehen, wenn man WAL und DB auf eine SSD auslagert.
Nimm hier richtige NVMe für Unternehmen, keinen Consumer-Flash. Der Grund sind nicht die Zahlen auf dem Titelblatt. Es ist gleichmäßige Latenz unter Dauerlast, und Schutz bei Stromverlust. Cephs Dokumentation ist direkt: „Enterprise-class SSDs are best for Ceph: they feature power loss protection (PLP)“, SSDs der Unternehmensklasse sind für Ceph am besten, denn sie haben Schutz bei Stromverlust, und „bargain client-class or off-brand SSDs are a false economy“, billige Client-SSDs oder solche ohne Namen sind Sparen am falschen Ende.
Samsung PM9A3 und Micron 7450 Pro sind die Klasse, die hierher gehört. Unter Schreibdruck kümmert sich Ceph weit mehr um Gleichmäßigkeit als um Spitzenwerte, und genau das trennt eine Platte für Unternehmen von einer schnellen für Consumer.
block.db bemessen, und was Überlaufen kostet
Bemiss es falsch, und der Nutzen verpufft still, denn wenn block.db voll wird, scheitert RocksDB nicht — es fällt zurück auf das langsame Gerät, genau dorthin, wo es ohne die NVMe gewesen wäre.
Das ist das Schlechteste von beidem: du hast den Flash gekauft und suchst weiter auf der Spindel.
Die aktuelle Empfehlung von Ceph:
| Last | block.db als Anteil von block |
|---|---|
| RBD / Block — VM-Platten | 1 % bis 2 % |
| RGW / Objekt | mindestens 4 % |
| Allgemeine Empfehlung beim Auslagern von WAL+DB | mindestens 2,5 % |
VM-Speicher unter Proxmox ist die RBD-Zeile, 1–2 % sind also die ehrliche Planungszahl, und 2,5 % sind ein bequemer Platz.
Rechne das gegen eine Platte mit 20 TB, und die Zahlen holen deine Aufmerksamkeit:
block.db für eine OSD mit 20 TB | |
|---|---|
| Bei 1 % | 200 GB |
| Bei 2 % | 400 GB |
| Bei 2,5 % | 500 GB |
Nimm das mit den RocksDB-Ebenenstufen weiter unten, und 300 GB pro OSD sind der sinnvolle Landeplatz. Die nützliche Stufe, die der Mitte des Bereichs am nächsten liegt.
Das ändert, was das gemeinsame Metadatengerät eigentlich ist. Acht OSDs mit 20 TB wollen 2,4 TB NVMe zwischen sich; fünfzehn davon, Cephs angegebenes Maximum hinter einer NVMe, wollen 4,5 TB. Auf so großen Platten entscheidet die DB-Kapazität, wie viele OSDs hinter ein Gerät passen, nicht das Verhältnis. Dir gehen die Gigabyte weit früher aus als Cephs Segen.
Es gibt noch einen Haken, der es wert ist, denn er macht intuitives Bemessen falsch. Die Ebenenstruktur von RocksDB heißt, dass eine DB-Partition nur Größen voll nutzen kann, die den Summen ihrer Ebenen entsprechen — historisch mit nützlichen Stufen um 3 GB, 30 GB und 300 GB, wobei Größen dazwischen nichts über die Stufe darunter hinaus bringen. 18 GB auf 30 GB aufzurunden ist in der Praxis oft kostenlos; sie auf 20 GB abzurunden bringt dir im schlimmsten Fall nichts über 3 GB hinaus.
Prüf auf Überlaufen, nachdem der Cluster eine Weile gelaufen ist, nicht am ersten Tag. Es ist ein Problem, das langsam einsetzt.
Du brauchst kein eigenes WAL-Gerät
Das spart eine Partition und viel Gefummel.
Gibst du ein DB-Gerät an und kein ausdrückliches WAL-Gerät, legt Ceph das WAL automatisch mit der DB auf das schnelle Gerät. Die Dokumentation stellt fest, dass „whenever a DB device is specified but an explicit WAL device is not, the WAL will be implicitly colocated with the DB on the faster device“ — wann immer ein DB-Gerät angegeben ist und ein ausdrückliches WAL-Gerät nicht, wird das WAL stillschweigend mit der DB auf das schnellere Gerät gelegt.
„DB und WAL auf NVMe legen“ ist also das richtige Ziel, aber es ist ein Argument und nicht zwei. Ein eigenes block.wal hat nur Sinn, wenn du eine dritte, schnellere Ebene hast, auf die es kann.
Den Schreibcache der HDD abschalten
Klein, unglamourös und leicht zu übersehen.
Cephs Dokumentation hält fest, dass die Leistung einer OSD „may be dramatically increased … by disabling this write cache“ auf HDDs, also drastisch steigen kann, wenn man diesen Schreibcache abschaltet. Der flüchtige Cache in der Platte sortiert Schreibvorgänge um und verzögert sie auf Weisen, die Cephs Leerungssemantik zuwiderlaufen, und ihn abzuschalten macht die Sache meist schneller statt langsamer.
Sobald bcache im Spiel ist, wird es Pflicht statt Empfehlung, und das ist der nächste Abschnitt.
Während du dabei bist: du brauchst keinen HBA mit RAID-Fähigkeit. Ceph sagt es direkt: „You do not need an RoC (RAID-capable) HBA.“ Gib den OSDs die Platten.
Eine Optane pro Spindel
Die Metadaten von der Platte wegzuholen behebt den Dauerzustand. Es behebt keine Stöße, denn ein Stoß kleiner synchroner Schreibvorgänge muss weiter bestätigt werden, und die Spindel bestätigt weiter mit Spindelgeschwindigkeit.
Dafür ist bcache da, und was es hier funktionieren lässt, ist Optane.
Worauf es ankommt, ist nicht Kapazität. Es ist das Verhalten unter Schreiblast. Gegen NAND bietet Optane sehr niedrige Latenz, sehr hohe Haltbarkeit und keine der Klippen der Speicherbereinigung, die die Leistung eines Schreibcaches auf SSD unvorhersehbar machen, sobald sie eine Weile im Einsatz war. Kleinen, stoßweisen, schreiblastigen Verkehr aufzunehmen ist das, worin es das Beste der Welt ist.
Das Layout, auf das es ankommt: eine Optane pro HDD, jedes Paar sein eigenes bcache-Gerät. Nicht eine Optane, geteilt über ein Regal voll Platten.
Die Paarung ist eine bewusste Wahl, und sie kauft zwei Dinge.
Kein Gerangel. Jede Spindel bekommt die Latenz und Queue-Tiefe einer ganzen Optane für sich, statt hinter den Stößen von sieben anderen OSDs zu warten.
Ein Fehlerbereich, den Ceph schon zu überleben weiß. Ein gemeinsamer Schreibcache hält schmutzige Daten für jede OSD dahinter, ihn zu verlieren verliert also alle auf einmal; eins zu eins gepaart kostet eine verlorene Optane genau eine OSD. Dieser Unterschied ist die wichtigste einzelne Folge dieses Entwurfs, und er bekommt seine eigene Behandlung unter was du aufgibst.
Das muss Optane sein. Nicht NAND.
Das Wort „Optane“ ist hier keine Markenvorliebe und kein Nice-to-have. Eine NAND-NVMe einzusetzen — wie teuer auch immer — baut etwas, das sich abnutzt, und der Grund ist Haltbarkeit.
Sieh, wo das Cache-Gerät sitzt. Weil dieser Entwurf die sequentielle Umleitung von bcache abschaltet — das sequential_cutoff=0 in der Regel unten —, geht jeder einzelne Schreibvorgang an diese OSD hindurch: nicht nur die Stöße, alles. Das macht den Cache zum Gerät mit dem höchsten Arbeitsanteil im Knoten, das das Schreibvolumen einer ganzen sich drehenden Platte über die Lebensdauer der Maschine aufnehmen soll.
Haltbarkeit wird in Laufwerksschreibvorgängen pro Tag angegeben, und der Abstand ist nicht schrittweise:
| Gerät | Angegebene Haltbarkeit |
|---|---|
| Optane P5800X | 100 DWPD |
| Optane P4800X | 30 DWPD |
| Schreibintensives Unternehmens-NAND, Oberklasse | etwa 10 DWPD |
| Unternehmens-NAND für gemischte Nutzung | 3 DWPD oder weniger |
| Gängiges Unternehmens-NAND — Klasse PM9A3, 7450 Pro | etwa 1 DWPD |
Optane hat zwischen zehn- und hundertmal die Haltbarkeit des NAND, das du sonst dorthin legen würdest. Steck eine Platte mit 1 DWPD an die eine Stelle, die jeden Schreibvorgang des Clusters bekommt, und du hast keinen Cache gebaut, sondern einen Verbrauchsartikel.
Es ist schlimmer, als die Tabelle vermuten lässt, denn NAND leidet innen an Schreibverstärkung und Optane nicht. Die angegebenen DWPD einer NAND-Platte sind, was sie an der Schnittstelle nimmt; was ihre Zellen tatsächlich aufnehmen, ist mehr. Optanes Zahl braucht kein solches Sternchen.
Wiederaufbauten sind die Stelle, an der das geprüft wird. Backfill schiebt Terabyte an Schreibvorgängen in einem gedrängten Zeitfenster durch die überlebenden Knoten, jedes Byte davon über ihre Cache-Geräte — ein Ereignis der Haltbarkeit, nicht bloß der Latenz, und es kommt genau dann, wenn du ein zweites Gerät am wenigsten ausfallen lassen willst.
Die zwei Flash-Ebenen wollen also verschiedene Platten, aus verschiedenen Gründen:
| Ebene | Schreibvolumen | Was das Gerät braucht |
|---|---|---|
| DB/WAL | klein — nur RocksDB | Eine schnelle Unternehmens-NVMe. Niedrige Latenz, hohe zufällige IOPS, PLP. Unternehmens-NAND ist die richtige Technik; eine PM9A3 oder 7450 Pro ist der richtige Kauf |
| Schreibcache | alles davon | PLP und Haltbarkeit im Bereich von Dutzenden DWPD. NAND ist zu jedem Preis die falsche Technik |
Eine Sorte Platte für beide Aufgaben zu kaufen ist der Fehler, den dieser Abschnitt verhüten soll — lies die erste Zeile aber nicht als Erlaubnis zu sparen, denn kleines Schreibvolumen ist keine kleine Anforderung.
Das DB-/WAL-Gerät muss weiterhin wirklich schnelle NVMe sein, aus drei Gründen, die nichts damit zu tun haben, wie viele Byte darüber gehen.
Es bedient jede OSD dahinter gleichzeitig, die Queue, die es sieht, sind also vier oder fünfzehn Sätze Metadatenverkehr, nicht der einer Platte.
Seine Latenz landet direkt bei deinen Clients. RocksDB-Abfragen liegen auf dem kritischen Weg, um Objekte zu finden, fürs Peering und fürs Scrubbing, und sie sind kleine zufällige Lesevorgänge. Die Last, bei der der Abstand zwischen einer schnellen und einer mittelmäßigen NVMe am größten ist. Jede Mikrosekunde wird mit jeder OSD multipliziert, die davon abhängt.
Und Compaction ist stoßweise. RocksDB schreibt seine Ebenen periodisch neu und verwandelt gleichmäßiges Rühren in eine gebündelte Spitze von Lese- und Schreibvorgängen. Ein Gerät, das mit dem Durchschnitt zurechtkommt und an der Spitze hängt, lässt im selben Moment jede OSD dahinter hängen.
Cephs eigene Verhältnisse sind das Anzeichen. Es erlaubt dreimal so viele OSDs hinter einer NVMe wie hinter einer SATA-SSD, und das sagt die Schnittstelle und die Geräteklasse, nicht die Kapazität. Nimm NVMe.
Also: das Cache-Gerät muss Optane sein, das DB-/WAL-Gerät darf NAND sein, und keine der beiden Stellen ist die, an der du Geld sparst.
Welche Optane: eine M10 mit 32 GB täte es oft
Nichts davon heißt, die größte Optane sei die richtige. Das Gerät, das du brauchst, entscheidet deine Schreiblast — auch wenn der Gebrauchtmarkt es letztlich unabhängig davon für dich entscheidet. Die Rechnung zählt trotzdem, denn sie sagt dir, was du zu viel oder zu wenig kaufst.
Fang damit an, wofür der Cache da ist. Er hält einen Stoß, nicht eine Platte. Bei writeback_percent=40 gibt ein Gerät mit 32 GB etwa 13 GB schmutzigen Puffer, und das sind sehr viele kleine synchrone Schreibvorgänge.
Lass dich also vom Verhältnis nicht abschrecken. Ein Modul mit 32 GB vor einer Platte mit 20 TB sind 0,16 % davon, was absurd klingt, bis man sich erinnert, dass es ein Stoßdämpfer ist und kein Cache, der heiße Daten halten soll. Ein Gerät mit 375 GB vor derselben Platte sind 1,9 %, und das ist einfach mehr Luft, als du nutzen wirst.
Das bringt das billige Ende des Bereichs ins Spiel. Hier ist das kleine Consumer-Modul gegen das Rechenzentrumsteil, denn der Abstand liegt nicht dort, wo Leute ihn erwarten:
| Optane Memory M10 32 GB | Optane DC P4800X 375 GB | |
|---|---|---|
| Zufälliges Lesen, 4K | 240.000 IOPS | 550.000 IOPS |
| Zufälliges Schreiben, 4K | 65.000 IOPS | vergleichbar mit Lesen |
| Sequentielles Lesen | 1.200 MB/s | 2.400 MB/s |
| Sequentielles Schreiben | 290 MB/s | 2.000 MB/s |
| Typische Latenz | — | unter 10 µs |
| Haltbarkeit | 365 TBW | 12,3 PBW — 30 DWPD |
| Schnittstelle | PCIe 3.0 x2, M.2 2280 | PCIe 3.0 x4, U.2 oder Steckkarte |
Sieh zuerst auf die Zeile mit den Schreib-IOPS. Die kleine M10 macht 65.000 zufällige Schreibvorgänge pro Sekunde; die Spindel dahinter macht 80. Selbst die billigste Optane ist etwa 650-mal die Platte, die sie zwischenspeichert, auf der Leistungsachse ist das Argument also vorbei, bevor es anfängt. Die zusätzlichen IOPS des Rechenzentrumsteils haben nichts, wohin sie könnten, wenn eine 7,2k-Platte dahinter hängt.
Die Zeile, die den Kauf entscheidet, ist die Haltbarkeit, und dort ist der Abstand 34×. In ein Tagesbudget über fünf Jahre Lebensdauer umgerechnet:
| Gerät | Tragbare Schreibvorgänge pro Tag über fünf Jahre |
|---|---|
| M10 32 GB — 365 TBW | etwa 200 GB/Tag |
| P4800X 375 GB — 12,3 PBW | etwa 6,7 TB/Tag |
Unter 200 GB Schreibvorgängen am Tag übersteht eine M10 mit 32 GB den ganzen Aufbau. Beim Doppelten davon bekommst du zweieinhalb Jahre. Bist du richtig schreiblastig, verdient das Rechenzentrumsteil seinen Preis — nicht wegen der IOPS, die du nicht nutzen kannst, sondern wegen des gut dreißigmal höheren Schreibens, das es verträgt.
Miss also, statt zu raten. nvme smart-log auf einem vorhandenen Cache-Gerät gibt dir data_units_written; nimm eine Woche später eine zweite Probe, teile, und vergleiche mit dem angegebenen TBW dessen, was du in Erwägung ziehst. bcache führt seine eigenen Summen unter /sys/block/bcacheN/bcache/stats_total/, wenn du es lieber dort liest.
Zwei Vorbehalte zur M10. Ihre Zahlen für zufällige Zugriffe sind über eine Spanne von 8 GB angegeben und nicht über das ganze Gerät, auf einem Cache, den du weitgehend voll betreiben willst, behandle sie also als das optimistische Ende. Und es ist ein Consumer-Teil ohne PLP-Zusage für Unternehmen — Optanes Medium wird an seinem Platz beschrieben, ohne DRAM-Puffer im Schreibweg, und deshalb verhalten sich diese Module bei plötzlichem Stromverlust weit besser als Consumer-NAND, aber „verhält sich in der Praxis gut“ ist keine Spezifikation. Willst du die Zusage schriftlich, kauf ein Teil der DC-Reihe.
Der Boden ist Bandbreite, nicht Kapazität — die Module mit 16 GB fallen weg
Es gibt eine zweite Einschränkung, unabhängig von allem oben, und sie schließt das billigste Teil der Reihe aus.
Der Cache muss sequentiell schneller sein als die Platte, sonst ist er eine Bremse. Die M10 mit 16 GB ist es nicht, und es ist das Modul, das dich am meisten verlocken wird, weil es fast nichts kostet:
| Sequentielles Schreiben | |
|---|---|
| Optane Memory M10 16 GB | 150 MB/s |
| Optane Memory M10 32 GB | 290 MB/s |
| Optane DC P4800X 375 GB | 2.000 MB/s |
| Eine 7,2k-Unternehmens-HDD | 150–250 MB/s |
Lies die erste und die letzte Zeile zusammen. Ein Modul mit 16 GB schreibt sequentiell etwa so schnell wie die sich drehende Platte, die es beschleunigen soll, und langsamer als eine gute. Es bleibt bei zufälliger Arbeit ungeheuer schneller — 35.000 zufällige Schreib-IOPS gegen die 80 der Platte —, aber auf einem sequentiellen Strom ist es bestenfalls ein Nullsummenspiel und schlimmstenfalls eine Decke unter dem, was die nackte Platte allein geschafft hat.
Und dieser Entwurf sorgt dafür, dass du diese Decke erreichst, denn die sequentielle Umleitung abzuschalten schickt alles durch den Cache und macht die eigene sequentielle Schreibbandbreite des Caches zur harten Decke für die ganze OSD. Bei der Wiederherstellung beißt es am härtesten: eine OSD mit 20 TB aufzufüllen ist etwa so sequentiell, wie diese Last je wird, und sie auf 150 MB/s zu begrenzen macht einen schon langsamen Wiederaufbau langsamer.
Die M10-Reihe hat also einen Boden bei 32 GB, und es ist ein Boden der Bandbreite und nicht der Kapazität. Die Kapazitätsrechnung sagte, 32 GB seien reichlich; die Bandbreitenrechnung schließt 16 GB aus, egal wie wenig du speichern musstest. Beide Prüfungen müssen bestehen, und das billige Teil scheitert an der, die Leute nicht machen.
Was du auch in Erwägung ziehst, stell seine Zahl fürs sequentielle Schreiben neben 250 MB/s, bevor du es kaufst.
Ein Produkt kaufen, das niemand mehr herstellt
Optane ist abgekündigt. Intel hat das Geschäft 2022 abgewickelt, 559 Millionen Dollar Lagerbestand abgeschrieben und die Entwicklung beendet. Es gibt keine neue Produktion und keinen Nachschub; der Gesamtvorrat geht von hier an nur nach unten.
Was eine naheliegende Frage aufwirft, denn es ist überraschend viel davon zu verkaufen. Zu verstehen, woher es kommt, sagt dir, was du kaufst.
Es ist Lagerbestand aus Ersatzteilprogrammen von OEMs, der abgestoßen wird. Die drei großen Serverhersteller hielten Optane als Ersatzteile vor, um die Plattformen zu unterstützen, in denen sie es verkauft haben. Diese Plattformen sind aus dem Lebenszyklus und aus der Unterstützung gefallen, die Ersatzteile dahinter wurden also über Nacht toter Bestand — Lagerhallen voller Teile für Maschinen, die niemand mehr vertraglich reparieren muss. Dieser Bestand ist, was auf AliExpress und zu den Aufarbeitern fließt.
Zwei Folgen, und beide sind gute Nachrichten.
Viel davon ist unbenutzt und nicht ausgebaut. Ersatzteile lagen im Regal und warteten auf einen Ausfall, der nie kam, der Verschleißwert bei Ankunft ist also oft praktisch null — nicht „ein paar Jahre leichter Dienst“, sondern nie beschrieben. Prüf statt zu vertrauen: nvme smart-log gibt dir percentage_used und data_units_written, und bei echtem Ersatzteilbestand sollten die verblüffend niedrig sein. Alles mit echtem Verschleiß ist ein Ausbau, der als etwas anderes verkauft wird, wobei die Luft bei der Haltbarkeit auch dann heißt, dass eine gebrauchte Optane mehr Leben übrig haben kann als eine brandneue NAND-Platte derselben Kapazität.
Es erklärt, welche Kapazitäten du finden wirst. OEM-Ersatzteile wurden für Server vorgehalten, das heißt Rechenzentrumsteile. Hier ist die ganze Reihe, und achte darauf, wo das Spitzenteil anfängt:
| Teil | Kapazitäten | Form |
|---|---|---|
| Optane Memory M10 | 16, 32, 64 GB | M.2 2280, Consumer |
| Optane SSD 800P | 58, 118 GB | M.2 2280, Consumer |
| Optane SSD P1600X | 58, 118 GB | M.2 2280, Rechenzentrumsteil für Start und Cache |
| Optane SSD DC P4801X | 100, 200, 375 GB | M.2 110 mm oder U.2 |
| Optane SSD DC P4800X | 375 GB als Kleinstes, 750 GB, 1,5 TB | U.2 oder Steckkarte |
| Optane SSD P5800X | 400 GB, 800 GB, 1,6 TB | U.2 oder Steckkarte |
Theoretisch sind die kleinen M.2-Teile die elegante Antwort — die M10, die 800P, die P1600X und die P4801X mit 100 GB tun alle die Arbeit, und billig. In der Praxis hat der Markt sie nicht, denn niemand hat Desktop-Beschleunigermodule als Server-Ersatzteile eingelagert. Angeboten wird 375 GB und aufwärts, Hardware der P4800X-Klasse.
Plane also damit, mehr Kapazität zu kaufen, als die Rolle braucht, denn das ist, was zu verkaufen ist. Es ist kein schlechtes Ergebnis. Ein Cache-Gerät zu groß zu kaufen bringt dich auf 30 DWPD und Latenz unter 10 µs, wenn deine Last einen Bruchteil von beidem verlangte, und für eine Spindel mit 20 TB, die du Jahre behalten willst, ist das die richtige Richtung zu irren. Es heißt, dass der Einstiegspreis höher ist, als die Rechnung vermuten lässt, und dass das Bemessen oben eine Prüfung gegen zu kleines Kaufen wird und keine Einkaufsliste.
Drei Dinge, mit denen zu planen ist, denn das ist eine Abwicklung und keine Lieferkette:
Kauf deine Ersatzteile mit dem Aufbau. Ein endlicher Vorrat wird geräumt. Fällt in drei Jahren ein Gerät aus, wirst du keinen Ersatz bestellen, sondern jagen — kalkuliere die Ersatzteile also jetzt ein, solange der Bestand da ist.
Rechne mit OEM-Firmware und prüf das Namespace. Teile aus dem Ersatzteilprogramm eines Herstellers tragen oft dessen Firmware und können mit einer LBA-Größe oder Metadaten-Einstellungen ankommen, die zu dem passen, wofür sie eingelagert waren. Bestätige es mit nvme id-ns, bevor du darauf baust, und sei bereit, mit nvme format auf ein einfaches Format mit 4096 Byte zu gehen.
Es gibt keine Garantie, keine Unterstützung und keine weiteren Firmware-Aktualisierungen. Intels eigener Support-Hinweis behandelt, was die Abwicklung für Geräte bedeutet, die schon im Einsatz sind, und das ist die Lage, in der alles ist, was du kaufst. Zu prüfen, dass das angekommene Teil das aus dem Angebot ist, liegt bei dir.
bcache ersetzt das Auslagern von DB und WAL nicht
Es lohnt sich, das ausdrücklich zu sagen, denn es ist die naheliegende Stelle, an der man Geld sparen will, und es geht nicht: du brauchst weiterhin block.db auf NVMe. Beide Schichten, nicht die eine oder die andere.
Die Optane ist ein Schreibcache. Nichts weiter. Sie verkürzt den Weg zur Bestätigung von Schreibvorgängen, die zur Platte unterwegs sind, und sonst tut sie nichts.
RocksDB schreibt nicht nur. Ceph liest seine Metadaten ständig — um Objekte zu finden, fürs Peering, um Scrubs zu beantworten —, und ein Schreibcache bietet einem Lesevorgang genau nichts, sobald die Daten aus ihm herausgeleert sind. Der Cache nimmt den Metadatenverkehr auch nicht weg; er schiebt ihn auf und bündelt ihn, jede RocksDB-Aktualisierung kommt also irgendwann doch an der Spindel an und konkurriert um dieselben Suchen. Und Compaction macht aus bescheidenem Rühren weit mehr Geräteverkehr als die Schreibvorgänge, die ihn verursacht haben.
Die zwei Änderungen beheben also verschiedene Probleme, und keine ersetzt die andere:
| Was es behebt | Was es nicht tut | |
|---|---|---|
block.db auf NVMe | Metadaten wohnen auf Flash — Lesen und Schreiben, dauerhaft weg von der Spindel | nichts für einen Stoß von Gast-Schreibvorgängen |
| Optane über bcache | Latenz der Bestätigung bei Stößen von Daten-Schreibvorgängen | nichts für Metadaten-Lesevorgänge; schiebt Metadaten-Schreibvorgänge nur auf |
Lass das Auslagern der DB weg und behalte die Optane, und RocksDB ist zurück auf dem Teller, mit seinen Lesevorgängen bei 80 IOPS bedient. Lass die Optane weg und behalte das Auslagern der DB, und der Dauerzustand ist anständig, aber Stöße bleiben mit Spindelgeschwindigkeit hängen.
Die udev-Regel, Zeile für Zeile
Die Stellräder von bcache wohnen in sysfs, und sysfs setzt sie jedes Mal zurück, wenn das Gerät registriert wird — also bei jedem Start. Sie gehören daher in eine udev-Regel und nicht in ein Skript, das sich jemand zu starten merken muss:
# /etc/udev/rules.d/99-bcache.rules
ACTION=="add|change", SUBSYSTEM=="block", KERNEL=="bcache*", \
  ATTR{bcache/cache_mode}="writeback", \
  ATTR{bcache/sequential_cutoff}="0", \
  ATTR{bcache/congested_read_threshold_us}="0", \
  ATTR{bcache/writeback_rate}="81920", \
  ATTR{bcache/writeback_rate_minimum}="20480", \
  ATTR{bcache/writeback_percent}="40"
KERNEL=="bcache*" greift jedes bcache-Gerät des Knotens, eine Regel deckt also alle Paare ab. ACTION=="add|change" heißt, dass sie neu greift, wann immer ein Gerät erscheint oder wieder angehängt wird, und nicht nur beim Start.
Was jede Einstellung tut, und warum:
cache_mode=writeback — der ganze Sinn. Im voreingestellten writethrough wird ein Schreibvorgang erst bestätigt, wenn er die HDD erreicht, der Cache tut also nichts für die Schreiblatenz. In writeback bestätigt die Optane, und die Spindel holt später auf.
sequential_cutoff=0 — standardmäßig erkennt bcache sequentielles I/O und leitet es ab 4 MB direkt am Cache vorbei, in der Annahme, die Platte dahinter komme mit sequentiellem gut zurecht. Null schaltet diese Umleitung ab, sodass alles zwischengespeichert wird. Auf einem hyperkonvergenten Knoten ist das richtig: was für ein bcache-Gerät sequentiell aussieht, hört am Teller auf sequentiell zu sein, sobald mehrere OSDs sich verschachteln, und du willst jeden Schreibvorgang mit Optane-Geschwindigkeit bestätigt haben, egal was. Es bringt allerdings eine Pflicht mit — ohne Umleitung wird die eigene sequentielle Schreibbandbreite des Cache-Geräts zur Decke für die ganze OSD, und das ist der Grund, warum die Module mit 16 GB wegfallen.
congested_read_threshold_us=0 — bcache beobachtet die Latenz seines eigenen Cache-Geräts und fängt an, den Cache zu umgehen, wenn es ihn für verstopft hält, voreingestellt bei 2000 µs fürs Lesen. Optane verstopft nicht so, wie NAND es tut, das ist also bcache, das ein Gerät zweitrangig überstimmt, das es falsch gemessen hat. Null schaltet die Beobachtung ab.
writeback_rate=81920 und writeback_rate_minimum=20480 — die Rate der Leerung im Hintergrund, in Sektoren pro Sekunde, also etwa 40 MB/s Ziel mit einem Boden von 10 MB/s. Ein PD-Regler bewegt die tatsächliche Rate dazwischen. Das Ziel liegt nahe an dem, was eine Spindel sequentiell aufnehmen kann, und der Boden hindert den Regler daran, die Leerung gegen null zu drosseln und schmutzige Daten unbegrenzt aufzustauen. Beides sind Startpunkte und keine Konstanten — wie man sie ändert steht unten.
writeback_percent=40 — wie viel des Caches bcache schmutzig liegen lässt, bevor es hart gegenhält, gegen eine Voreinstellung von 10. Vierzig gibt dir einen viel tieferen Stoßpuffer. Es heißt auch, dass bis zu 40 % dieser Optane die einzige Kopie von Daten im System halten, und das ist die Abwägung, und der Grund, warum das Layout mit einer pro Spindel zählt. Das ist der Wert, den man am ehesten noch einmal ansieht, wenn man eine echte Last beobachtet hat.
Die Füll- und Leerungswerte später ändern
Die 40 % und die zwei Raten oben sind die Werte, die hier laufen, keine allgemeinen Konstanten. Sie sind das Erste, was du bewegen willst, sobald du eine echte Last beobachtet hast, es lohnt sich also zu wissen, dass es zwei Stellen gibt, sie zu ändern, und die zwei verschiedene Dinge tun.
sysfs ändert es jetzt. Die udev-Regel ändert es beim nächsten Start. Du willst beides, und in dieser Reihenfolge.
Live ändern, auf einem Gerät:
echo 30 > /sys/block/bcache0/bcache/writeback_percent
Oder über jedes Paar des Knotens:
for d in /sys/block/bcache*/bcache; do
  echo 30 > "$d/writeback_percent"
done
Die Leerungsrate geht genauso. Beide Werte sind in Sektoren pro Sekunde, das hier halbiert also Ziel und Boden:
for d in /sys/block/bcache*/bcache; do
  echo 40960 > "$d/writeback_rate"
  echo 10240 > "$d/writeback_rate_minimum"
done
Das wirkt sofort und hält genau so lange, bis das Gerät neu registriert wird. Die Kernel-Dokumentation ist ausdrücklich, dass diese Einstellungen „do not persist across reboot“, also über einen Neustart nicht bestehen bleiben — und das ist der ganze Grund, warum die udev-Regel existiert.
Bist du mit einem Wert zufrieden, bearbeite die Regel und lade sie neu, ohne neu zu starten:
udevadm control --reload
udevadm trigger --subsystem-match=block --action=change
Hier verdient sich ACTION=="add|change" seinen Platz. Der Trigger feuert ein change-Ereignis an Geräte, die schon da sind, die Regel greift also auf einem laufenden Knoten neu, statt auf den nächsten Start zu warten. Hätte die Regel nur auf add gegriffen, würde dieser Befehl nichts tun.
Dann lies die Werte zurück, denn ein Tippfehler in einer udev-Regel scheitert still:
grep . /sys/block/bcache*/bcache/writeback_percent
Wissen, in welche Richtung man sie bewegt
Stell das nicht aus Grundsätzen ein — bcache legt offen, was du brauchst, im selben sysfs-Verzeichnis.
dirty_data ist das, was man beobachtet: wie viele Daten gerade im Cache und nirgends sonst liegen. Die Dokumentation beschreibt es als „continuously updated unlike the cache set’s version, but may be slightly off“, also fortlaufend aktualisiert, anders als die Fassung des Cache-Sets, aber möglicherweise leicht daneben, und das genügt hier. Nimm über einen normalen Arbeitstag und ein Sicherungsfenster Proben.
cache_hits, cache_misses und cache_hit_ratio sagen dir, ob der Cache genutzt wird, mit dem Vorbehalt, dass „a partial hit is counted as a miss“, ein Teiltreffer als Fehlschlag gezählt wird. bypassed zählt IO, das vollständig am Cache vorbeiging — mit sequential_cutoff=0 sollte das nahezu flach sein, eine wachsende Zahl heißt also, dass etwas noch darum herum läuft.
All das kommt als laufende Summen plus Fassungen, die über den letzten Tag, die letzte Stunde und die letzten fünf Minuten abklingen, und das macht die kurzen Fenster zum Aufspüren eines Problems weit nützlicher als den Wert über die Lebensdauer.
Von dort aus:
| Symptom | Stellrad | Richtung |
|---|---|---|
| Stöße hängen — Schreibvorgänge treffen mitten im Stoß Spindellatenz | writeback_percent | hoch, für einen tieferen Puffer |
| Mehr Daten auf dem Cache ausgesetzt, als dir behagt | writeback_percent | herunter |
dirty_data bei normaler Arbeit an der Decke festgenagelt | writeback_rate | hoch — nicht der Puffer ist das Problem, das Abfließen ist es |
| Leerung im Hintergrund konkurriert mit Gast-Lesevorgängen auf der Spindel | writeback_rate | herunter |
dirty_data steigt über Tage statt Stunden | writeback_rate_minimum | hoch, damit der Regler nicht auf ein Kriechen drosseln kann |
Sitzt dirty_data an der Decke festgenagelt, egal was du tust, ist keines der Stellräder die Antwort — der Cluster schreibt schneller, als die Spindeln aufnehmen können, und die ehrlichen Lösungen sind mehr Spindeln oder weniger Schreibvorgänge.
Eine Datei, die man in Ruhe lässt: writeback_running. Sie abzuschalten stoppt die Leerung ganz, und die Dokumentation sagt, es sei „only meant for benchmarking“, nur für Benchmarks gedacht. Auf einer produktiven OSD heißt es, dass schmutzige Daten sich anhäufen, bis der Cache voll ist, und nie abfließen.
Was du aufgibst
Die meisten Darstellungen dieses Entwurfs hören bei den guten Nachrichten auf. Das hier sind die Teile, die dir wirklich weh tun werden, und jeder einzelne ist es wert, vor dem Bauen gekannt zu werden statt danach.
Eines der beiden Flash-Geräte zu verlieren zerstört die OSD. Nicht stoppt sie — zerstört sie. Beide Geräte halten Zustand, den es nirgends sonst gibt: block.db hält das RocksDB, das block erst Sinn gibt, und ein Writeback-Cache hält jeden noch nicht geleerten Schreibvorgang. Die Kernel-Dokumentation windet sich beim zweiten nicht: „In writeback mode you’ll lose data if something happens to your SSD“ — im Writeback-Modus verlierst du Daten, wenn deiner SSD etwas passiert. So oder so kommt die OSD nicht zurück, sie wird neu angelegt und aufgefüllt.
Es ist also dieselbe Klasse Risiko, und darüber klar zu sein lohnt sich, statt den Cache als den unheimlichen zu behandeln. Die Optane ist kein gefährlicheres Gerät als die NVMe. Zwei Dinge trennen sie, und keines davon ist die Schwere pro OSD.
Das erste ist die Wirkungsweite, und sie ist die ganze Rechtfertigung der Paarung. Eine Optane pro Spindel heißt, dass ein Cache-Ausfall eine OSD kostet — ein Verlust einer einzelnen Platte, genau das Ereignis, für dessen Abfangen ein replizierter Pool existiert, und das Ceph erledigt, ohne dass jemand geweckt wird. Das DB-/WAL-Gerät ist geteilt, es zu verlieren kostet also jede OSD dahinter auf einmal, und das ist ein zusammenhängender Ausfall, vor dem Replikation nicht schützt. Derselbe Ausfall, ein Gerät gegen fünf.
Das zweite ist, wie sich der Ausfall zeigt, und das ist eine betriebliche Falle. Stirbt ein Cache im Writeback-Modus, hält das Gerät dahinter an und gibt I/O-Fehler zurück, und das ist in Ordnung — Ceph markiert die OSD als unten und macht weiter. Der schlechte Fall ist ein Neustart, bei dem das Gerät dahinter ohne seinen Cache hochkommt. Es sieht dann aus wie ein einbindbares Dateisystem, dem einfach jeder schmutzige Schreibvorgang fehlt, und das ist verdorben und nicht bloß veraltet. Ein fehlendes block.db scheitert laut, und die OSD weigert sich zu starten; ein fehlender Cache kann still scheitern und dich das Wrack einbinden lassen. Behandle ein bcache-Gerät ohne seinen Cache als nicht einbindbar, und lass es nie etwas hilfsbereit für dich einbinden.
bcache sichert von sich aus kein Writeback zu, das gegen Stromverlust hält. Hier hört der Schreibcache der HDD auf, eine Optimierung zu sein, und wird zur Pflicht — schalte ihn ab, und betreibe einen Kernel, der neu genug für die FUA-Behandlung ist, damit synchrone Schreibvorgänge über den ganzen Stapel geachtet werden statt irgendwo in der Mitte zu früh bestätigt. Ein Cache-Gerät ohne Schutz bei Stromverlust verschärft das Problem, denn es kann Daten verlieren, die es schon als sicher gemeldet hat.
Und das macht das DB-/WAL-Verhältnis zur Zahl, auf die es ankommt. Ceph erlaubt 4–5 HDD-OSDs pro SATA-SSD und nicht mehr als 15 pro NVMe und warnt vor dem „balancing the risk of reducing costs by placing too many responsibilities into too few failure domains“, also dem Abwägen des Risikos, Kosten zu senken, indem man zu viel Verantwortung in zu wenige Fehlerbereiche legt. Anders als bei der Cache-Ebene gibt es hier keine Paarung, die das einhegen könnte — Teilen ist der Sinn des Geräts.
Auf Platten mit 20 TB ist das das ganze Gespräch, denn der Wiederaufbau ist riesig. Eine ausgefallene OSD sind 20 TB aufzufüllen; bei den 150–250 MB/s, die eine Spindel durchhält, gedrosselt, damit die Wiederherstellung die Gäste nicht aushungert, schaust du auf gut mehr als einen Tag verminderten Betriebs für eine einzelne Platte. Verlier ein gemeinsames DB-Gerät, das fünf davon trägt, und es sind 100 TB zu bewegen.
Das Verhältnis ist also nicht wirklich eine Kostenentscheidung. Es ist eine Entscheidung darüber, wie lange du bereit bist, vermindert zu fahren, und wie viel Wiederaufbauverkehr der Cluster tragen kann, während er noch VMs bedient.
Der Entwurf hängt von einem Gerät ab, das niemand mehr herstellt. Das ist das eine ohne technische Antwort. Optane ist das richtige Teil für die Cache-Stelle, und nichts Aktuelles ersetzt es — NAND kann das Schreibvolumen nicht nehmen, und der CXL-gestützte Speicher, zu dem Intel geschwenkt ist, ist kein Ersatz für einen Block-Cache. Die Abmilderung ist also kaufmännisch statt raffiniert, sie steht weiter oben, und die ehrliche Zusammenfassung ist, dass diese Architektur irgendwo in der Zukunft ein Enddatum hat.
Nichts davon macht aus einem HDD-Cluster einen Cluster auf Flash. Dauerhafter zufälliger Schreibverkehr, der die Leerungsrate überholt, wird den Cache füllen, und sobald er voll ist, schreibst du mit Spindelgeschwindigkeit und zusätzlichen Schichten im Weg. Dieser Entwurf nimmt Stöße auf und entfernt den Overhead der Metadaten. Er stellt keine IOPS her.
Was es zusammengenommen ist
Drei Ebenen, jede macht das Eine, worin sie am besten ist — und alle drei sind nötig:
- Optane nimmt zufällige Schreibstöße auf, ein Gerät pro Spindel. Es muss Optane sein, denn jeder Schreibvorgang geht darüber, und die Haltbarkeit von NAND ist für diese Stelle falsch
- Eine schnelle Unternehmens-NVMe hält RocksDB und das WAL, geteilt über eine Handvoll OSDs in einem Verhältnis, das du bewusst gewählt und nicht hingenommen hast
- HDDs liefern die Massenkapazität, von Metadaten und Stößen befreit
Der Sinn ist nicht, so zu tun, als wären sich drehende Platten Flash. Er ist, ihnen die Arbeit nicht mehr zu schicken, in der sie am schlechtesten sind, damit die Kapazität, für die du bezahlt hast, nutzbar ist.
Das ist der ganze Trick, und es ist nichts Kluges daran. Leg jede Aufgabe auf das Gerät, das darin gut ist, und hör auf, doppelt für die zu zahlen, die es nicht sind.
Für einen hyperkonvergenten Proxmox-Cluster, der Kapazität in vielen Terabyte ohne die Preise von reinem Flash braucht, ist das ein vertretbarer Entwurf. Richtig gebaut fühlt er sich weit schneller an als nackte HDDs, er fällt auf Weisen aus, mit denen Ceph umgehen kann, und das Geld geht dorthin, wo es das Ergebnis ändert.
Zwei verwandte Dinge, die es wert sind, daneben gelesen zu werden: die Arbeit an der Sektorgröße in 4Kn, 512e und 512n zählt sehr für das, was die Spindeln mit den Schreibvorgängen tun, die sie erreichen, und baust du das auf direkt verbundenen Knoten, behandelt das Mesh ohne Switch die Netzseite eines kleinen Ceph-Clusters.
Quellen
- Ceph — Hardware Recommendations — die Warnung zu IOPS pro TB bei großen HDDs, „HDD OSDs may see a significant write latency improvement by offloading WAL+DB onto an SSD“, die Verhältnisse von 4–5 HDDs pro SATA-SSD und ≤15 pro NVMe, Schutz bei Stromverlust auf SSDs für Unternehmen, das Abschalten des HDD-Schreibcaches und dass man keinen RoC-HBA braucht
- Ceph — BlueStore Configuration Reference —
block.dbbei 1–2 % vonblockfür RBD und mindestens 4 % für RGW, die allgemeine Empfehlung von 2,5 %, das Überlaufen zurück auf das Hauptgerät, die RocksDB-Ebenengrößen hinter den Stufen von 3/30/300 GB, und dass das WAL stillschweigend mit der DB zusammengelegt wird - Linux-Kernel — bcache admin guide — die Cache-Modi,
sequential_cutoffund seine Voreinstellung von 4 MB, die Voreinstellung von 2000 µs für Lese-Verstopfung,writeback_ratein Sektoren pro Sekunde, der PD-Regler vonwriteback_percent, die Zählerdirty_data/cache_hit_ratio/bypassedund ihre abklingenden Fassungen für Tag, Stunde und fünf Minuten, die Warnung, dasswriteback_running„only meant for benchmarking“ ist, die Feststellung, dass diese Einstellungen „do not persist across reboot“, und „in writeback mode you’ll lose data if something happens to your SSD“ - Intel — Daten der Optane Memory M10 32 GB — 365 TBW, 240.000 zufällige Lese- und 65.000 zufällige Schreib-IOPS bei 4K über eine Spanne von 8 GB, 1200/290 MB/s sequentiell, PCIe 3.0 x2
- Intel — Daten der Optane Memory M10 16 GB — die 150 MB/s sequentielles Schreiben und 35.000 zufällige Schreib-IOPS, die dieses Teil beim sequentiellen Durchsatz unter eine sich drehende Platte setzen
- PC Perspective — Leistung der Optane SSD DC P4800X — 550K zufällige 4K-Lese-IOPS des Teils mit 375 GB, 2400/2000 MB/s sequentiell, typische Latenz unter 10 µs, und 12,3 PBW bei 30 DWPD
- ServeTheHome — Optane DC P4801X 100GB M.2 review — die Rechenzentrumsteile in M.2 mit kleiner Kapazität, für die Kapazitätsleiter
- StorageReview — Intel Optane SSD P5800X — die Angabe von 100 DWPD, die 30 DWPD der P4800X, und der Vergleich mit NAND-Platten für Unternehmen, die bei etwa 10 DWPD für schreibintensive Teile und 3 oder weniger für gemischte Nutzung enden
- Bcache — ArchWiki — die praktischen Fehlerfälle, darunter ein Gerät, das nach einem Neustart ohne seinen Cache hochkommt, und die Anforderungen an Stromsicherheit rund um den HDD-Schreibcache und FUA
- Intel — Optane business update — die Abwicklung, und was sie für Garantie und Unterstützung auf Geräten bedeutet, die schon im Einsatz sind, und das ist die Lage, in der alles auf dem Recyclermarkt schon ist