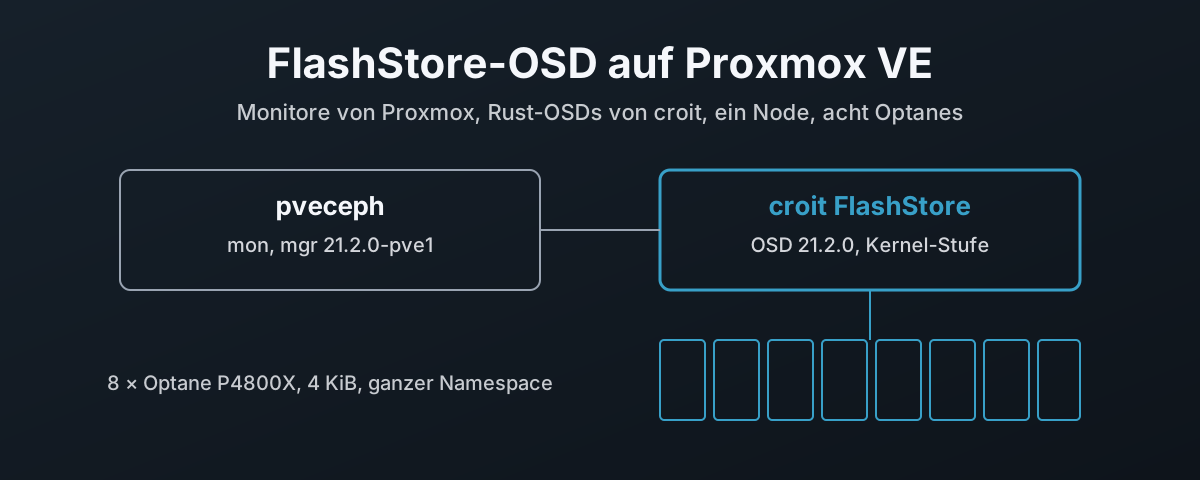
Ein Rust-OSD, am Tag seines Erscheinens
croit hat FlashStore OSD am 9. November 2026 in die Public Preview gebracht1.
Es ist ein Ceph-OSD, von Grund auf in Rust geschrieben, mit einem eigenen Object Store anstelle von BlueStore, und es spricht das Ceph-Wire-Protokoll.
Das Versprechen: Es fügt sich in einen Cluster ein, den du schon betreibst. Deine Monitore, deine Manager, dein ceph-CLI und deine Clients bleiben, wie sie sind, und du tauschst ein Laufwerk nach dem anderen aus1.
Für einen Proxmox-Betrieb zählt dieses Versprechen mehr als für die meisten.
Auf einem hyperkonvergenten Proxmox-VE-Node installierst du Ceph nicht separat.
Es kommt aus der Proxmox-GUI, aus Proxmox’ eigenen Repositorys, gebaut und gepatcht von Proxmox, und das Ganze wird von pveceph gesteuert.
Wenn ein OSD von jemand anderem darin sitzen kann, ohne etwas kaputt zu machen, bekommst du eine neue Storage-Engine, ohne das Werkzeug aufzugeben.
Wenn nicht, merkst du es auf die harte Tour, auf einem Node, auf dem auch deine VMs laufen.
Also habe ich es ausprobiert.
Ich arbeite für croit, die FlashStore machen. Deshalb habe ich es innerhalb von zwei Tagen nach dem Release ausprobiert, und genau deshalb wird unten auch nichts beschönigt. Es ist eine Preview, die README nennt es „not yet recommended for production data“1, und das hier ist ein Bericht darüber, was es auf echter Hardware gebraucht hat, keine Broschüre.
Kurze Antwort: Es funktioniert. Während ich das schreibe, liefern acht FlashStore-OSDs einen RBD-Pool an eine VM auf einem unveränderten Proxmox-VE-9.2-Node, HEALTH_OK. Die lange Antwort: Es hat zwei Korrekturen gebraucht, die in der Dokumentation nicht stehen, eine wegen der Art, wie Proxmox seine Ceph-Konfiguration ablegt, und eine wegen des Proxmox-Kernels. Der Rest dieses Posts handelt von diesen Korrekturen und davon, wie sie gefunden wurden. Wenn du es nur zum Laufen bringen willst: Gegen Ende steht ein Skript, das all das erledigt, und es ist auf diesem Node gelaufen.
Die Maschine
Das Lab ist ein einzelner Node, pve2, in meinem Heimnetz, und es ist ein mieser Minisforum-B550-Mini-PC von 2021.
Single-Node-Ceph betreibt man nicht in Produktion, und die CRUSH-Regel weiter unten ist der Preis dafür, aber jeder Schritt hier ist derselbe auf einem Node mit Nachbarn.
| Proxmox VE | pve-manager 9.2.26, Kernel 7.0.14-28-pve, Debian 13.7 |
| Maschine | Minisforum-B550-Mini-PC, 2021; das Board meldet BESSTAR TECH B550, BIOS 5.17 |
| CPU | AMD Ryzen 7 5700G, 8 Kerne, 16 Threads, 1 NUMA-Node |
| Arbeitsspeicher | 58 GiB |
| OSD-Laufwerke | 8 × Intel Optane P4800X 375 GB (6 mit Dell-Branding, 2 Intel Retail) |
| PCIe zu den Optanes | alle acht hinter einem Broadcom-PEX880xx-Switch, an einer einzigen PCIe-3.0-x16-Verbindung von der APU |
| Boot-Laufwerk | WD SN750 512 GB, VG pve, aus alldem herausgehalten |
| Netzwerk | ein 2,5-GbE-Port, vmbr0 |
| FlashStore | snapshot-2026-11-10, Upstream-Commit c5792750020e2 |
Die Optanes sind da, weil FlashStore zwei harte Anforderungen hat, an denen viele Laufwerke scheitern.
Das Laufwerk braucht Schutz bei Stromausfall, und der Namespace muss 4096-Byte-Blöcke nutzen, als ganzer Namespace ohne Partitionen oder Dateisystem darauf1.
FlashStore bestätigt einen Schreibvorgang, sobald er auf dem Laufwerk dauerhaft ist, also wird ein Laufwerk, das mit einem flüchtigen Cache über die Dauerhaftigkeit lügt, bei mkfs abgewiesen3.
Jede P4800X meldet in ihren Identify-Daten keinen flüchtigen Schreibcache (vwc 0). Das ist das Laufwerk selbst, das sagt: Der Cache kann keinen bestätigten Schreibvorgang verlieren.
Als solcher ist der Mini-PC der begrenzende Faktor bei diesem Deep Dive, nicht FlashStore und nicht die Laufwerke. Acht Kerne heißt einer pro OSD und keiner übrig, 58 GiB müssen Ceph und die VMs gleichermaßen versorgen, und acht Optanes teilen sich eine PCIe-3.0-Verbindung, weil die APU nicht mehr hergibt. Lies jede Zahl unten als das, was diese Maschine zulässt.
Umbrella oder gar nichts
FlashStore wird jeweils für ein Ceph-Release gebaut.
Der Branch entscheidet: main spricht Ceph 21.2.0 Umbrella, und ein Branch v20.2.4 spricht 20.2.4 Tentacle4.
Der Daemon prüft beim Start das Release des Clusters und verweigert eines außerhalb seines Fensters4.
Die Pakete auf der Release-Seite sind aus main gebaut, und das Binary sagt es selbst: croit-flashstore-osd 21.2.0 umbrella.
Proxmox VE 9 bietet drei Ceph-Repositorys an, und nur eines davon passt.
Tentacle ist der Proxmox-Standard, also die sichere Wahl?
Es ist die, die nicht funktioniert.
Das Proxmox-Repository führt Tentacle bis 20.2.5-pve1, und FlashStores Tentacle-Branch zielt genau auf 20.2.4.
Umbrella im Proxmox-Repository ist 21.2.0-pve1, dasselbe Release, auf das main zielt.
Proxmox verschweigt nicht, was Umbrella ist.
PVE/Ceph/Releases.pm führt es mit unsupported => 15, und der GUI-Assistent sagt es in klaren Worten, sobald du es auswählst.
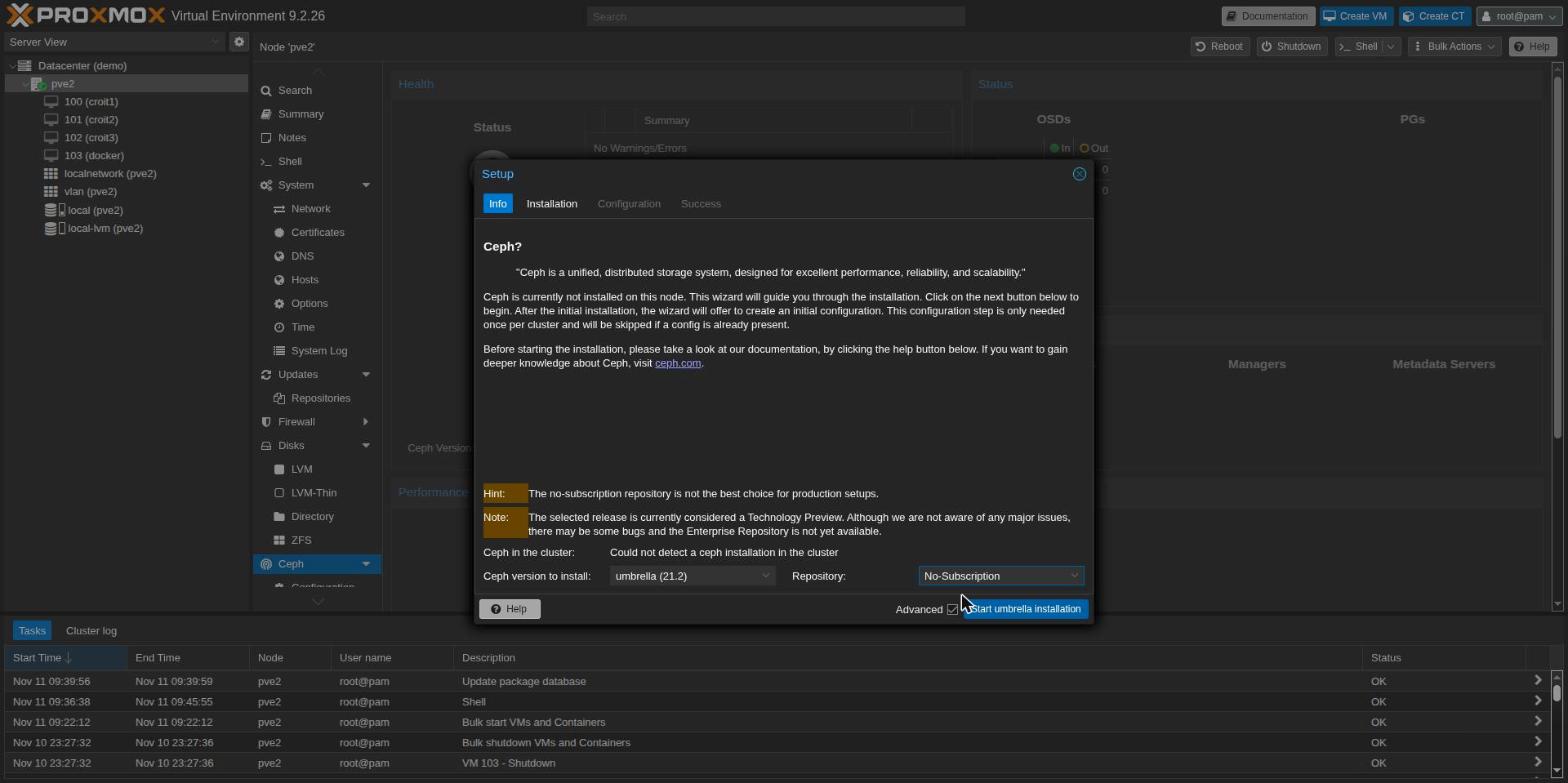
„Technology Preview“, kein Enterprise-Repository, und der Installer fragt im Terminal ein zweites Mal, continue (y/N)?, bevor er apt anfasst.
Das ist das richtige Maß an Warnung, und es lohnt sich, es als Aussage über den ganzen Stack zu lesen: ein Preview-OSD auf einem Preview-Release von Ceph.
Die Installation ist Proxmox von der Stange. Datacenter → Ceph → Install, Version Umbrella, Repository No-Subscription, dann das öffentliche Netz und der erste Monitor.
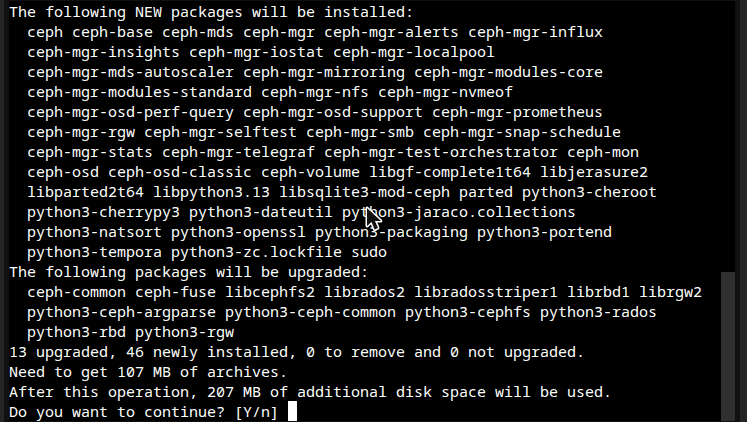
Dreizehn Pakete aktualisiert, 46 neu, 107 MB heruntergeladen.
Eins auf der Liste ist neu in Umbrella: ceph-osd-classic neben ceph-osd.
Keins von beiden wird hier benutzt, weil nie ein klassisches OSD angelegt wird.
Etwa eine Minute später liefen mon.pve2 und mgr.pve2, ceph versions meldete 21.2.0 … umbrella, und der Zustand war OK, noch ohne etwas zu speichern.
Vier Laufwerke mit 512 Byte
Vier der acht Optanes waren an eine Lab-VM durchgereicht gewesen und standen noch im 512-Byte-Format, mit alten ZFS-Labels darauf. Zwei weitere hatten das richtige Format und dieselben Labels. Die Lösung ist für beide schlicht: von der VM nehmen, auf 4 KiB formatieren, Labels löschen.
Die P4800X bietet 4096 Byte ohne Metadaten als LBA-Format 3 an, was nvme id-ns als lbaf 3 : ms:0 lbads:12 meldet.
nvme format /dev/nvme0n1 --lbaf=3 --force --timeout=900000
wipefs -a /dev/nvme0n1
sgdisk --zap-all /dev/nvme0n1
Der erste Versuch schlug fehl, ein späterer auch.
Beide Male kam nvme format mit Interrupted system call zurück, und das Laufwerk stand noch auf 512 Byte.
Das Kernel-Log nennt den Grund:
nvme nvme0: I/O tag 0 (0000) opcode 0x2 (Admin Cmd) QID 0 timeout, reset controller
nvme nvme1: I/O tag 9 (0009) opcode 0x6 (Admin Cmd) QID 0 timeout, reset controller
Opcode 0x2 ist Get Log Page, 0x6 ist Identify.
Keiner davon ist das Format.
Eine P4800X formatiert das ganze Medium, und das hat hier 345 bis 351 Sekunden pro Laufwerk gedauert.
Solange das läuft, beantwortet der Controller keine anderen Admin-Befehle, also wartet alles, was dem Laufwerk eine Frage stellt.
Nach dem 60-Sekunden-Admin-Timeout des Kernels gibt er auf und setzt den Controller zurück, und der Reset bricht das Format ab.
| Versuch | Was das Laufwerk erreichte | Ergebnis |
|---|---|---|
| nvme0, erster | ein Get Log Page um 09:53:04, mitten in der Ceph-Installation | abgebrochen, noch 512 B |
| nvme0, in einer Unit | nichts | 4 KiB in 345 s |
| nvme1 | mein eigenes nvme list, um den Fortschritt zu prüfen | abgebrochen, noch 512 B |
| nvme2, nvme3 | nichts | 4 KiB in 351 s und 350 s |
| nvme1, allein | nichts | 4 KiB in 346 s |
Die Lösung: jedes Format in einer transienten Unit mit langem Timeout laufen lassen, ein Laufwerk nach dem anderen, und die Laufwerke in Ruhe lassen, bis es fertig ist:
systemd-run --unit=fmt4k /root/fmt4k.sh
journalctl -u fmt4k -f       # read progress from the journal, not from the drive
So ist die einzige Fortschrittskontrolle das Journal, und nichts erreicht den Controller.
Danach zeigten alle acht 4 KiB in nvme list.
Das Paket
Die Release-Seite bietet .deb- und .rpm-Pakete an, darunter Debian 13 trixie, worauf Proxmox VE 9 aufbaut2.
Ein Build bedient jede Distribution und braucht glibc 2.34 oder neuer6.
B=https://github.com/croit/ceph-rust/releases/download/snapshot-2026-11-10-0b6783237291
curl -LO "$B/flashstore_21.2.0+git.20261110063351.c5792750020e_debian-trixie_amd64.deb"
curl -LO "$B/sha256sums.txt"
sha256sum flashstore_*_debian-trixie_amd64.deb
grep debian-trixie/flashstore_ sha256sums.txt
Prüf es von Hand.
sha256sum -c kann diesen Download nicht prüfen, weil die Prüfsummendatei ihn debian-trixie/flashstore_…_amd64.deb nennt, während das Asset flashstore_…_debian-trixie_amd64.deb heißt.
Die Hashes stimmen überein, ce1fb352…26c8 auf beiden Seiten. Die Datei ist also in Ordnung, nur die Liste passt nicht zu den Assets.
apt install ./flashstore_*_debian-trixie_amd64.deb
croit-flashstore-osd --version
croit-flashstore-osd 21.2.0 umbrella (build 0.0.0) git c5792750020e
net tiers: kernel (+rdma upgrade)
Es ließ sich sauber neben Proxmox’ eigenem ceph-osd und ceph-osd-classic installieren.
Das Paket installiert ein minimales ceph-osd.target nur auf Hosts, denen eins fehlt6, und Proxmox hat schon eins, also hängen die FlashStore-Units am selben Target wie die klassischen.
Drei Dinge am Paket, die du kennen solltest, bevor du Skripte dagegen schreibst:
| Was die Doku sagt | Was das Paket ist | |
|---|---|---|
| Paketname | apt remove flashstore …6 | croit-flashstore-osd, die Asset-Datei heißt flashstore_… |
| Store-Backends | das Produktions-Feature-Set von main ist knet,spdk,rdma,mimalloc1 | kein SPDK: --check meldet „SPDK NVMe driver: compiled out“ |
Werte für flashstore_dev | spdk:<pci>, oder file: in Entwicklungs-Builds7 | die Kernel-Stufe, kernel:/dev/…, ist in diesem Build der einzige echte Store-Pfad |
Die mittlere Zeile zählt.
Die SPDK-Stufe, der NVMe-Treiber im User Space, der das Laufwerk an vfio-pci gebunden braucht, ist nicht im veröffentlichten Debian-Paket.
Drin ist die Kernel-Stufe: Das Laufwerk bleibt beim kernel-eigenen nvme-Treiber, und FlashStore spricht über io_uring mit ihm.
Der Quellcode zeigt sie als einkompiliert, weil das Feature knet kernel-nvme mitzieht8, auch wenn die Zusammenfassung des Host-Checks sie „compiled out of this build“ nennt.
Diese Zeile ist falsch.
Wer ihr glaubt, hört genau dort auf.
Was der Host-Check sagt
croit-flashstore-osd --check ist rein lesend und läuft, bevor irgendetwas geschrieben wird.
Er prüft Build, CPU, Speicher, IOMMU, jeden NVMe-Controller, die NIC, den Kernel und die Konfiguration, und gibt für jeden Befund die genaue Korrektur aus9.
Auf diesem Node lief er 115 Prüfungen durch, und er ist gut: Jeder Befund kommt mit dem Befehl, der ihn behebt, und das hat mir eine Menge Sucherei erspart.
| Befund | Ergebnis | Was ich gemacht habe |
|---|---|---|
| Hugepages: keine reserviert | FAIL | die verlangten 16 GiB reserviert, dauerhaft in /etc/sysctl.d |
| Boot-Laufwerk SN750: flüchtiger Schreibcache | FAIL | nichts, es ist kein OSD-Kandidat |
vfio-pci nicht geladen | WARN | nichts, dieser Build hat kein SPDK, das es nutzen könnte |
| memlock-Limit 8 MiB | WARN | nichts, er misst die Shell; die Unit setzt LimitMEMLOCK=infinity |
kein isolcpus / nohz_full | WARN | notiert, Latenz-Tuning |
IOMMU übersetzt, nicht iommu=pt | WARN | notiert |
init_on_alloc=1 | WARN | notiert, kostet laut Check 15 bis 20 % CPU bei großen Reads |
| 2,5-GbE-Port, Standard-NIC-Ringe, IRQs auf fünf CPUs | WARN | notiert |
| 8 × P4800X: kein VWC, 4096+0 aktiv, x4 mit 8 GT/s, frei | OK | |
| io_uring mit SEND_ZC und festen Puffern, Kernel 7.0 | OK |
Plan den zweiten FAIL ein.
Der Check zählt jeden Controller im Gehäuse, und die Boot-SSD hat einen Schreibcache, also fällt sie durch den Stromausfall-Test, obwohl derselbe Check sie korrekt als „in use, not a candidate“ markiert.
Das Tutorial sagt, Exit 0 heißt kein FAIL9.
Auf jedem Host, der von einer Consumer-SSD bootet, und das sind viele Proxmox-Hosts, kann --check nie mit 0 enden, egal was du behebst.
Schreib Skripte gegen die Zeilen der einzelnen Prüfungen, nicht gegen den Exit-Code.
Die Tuning-WARNs blieben. Jeder davon braucht eine Änderung der Kernel-Kommandozeile und einen Neustart, und das hier ist ein Deployment, kein Benchmark. Sie sind die richtige Liste zum Abarbeiten, bevor irgendwer eine Zahl von dieser Maschine zitiert.
Kerne und Hugepages für acht OSDs
FlashStore läuft Thread-per-Core, und der Check buchstabiert aus, was das heißt: „one core = one shard/PG owner“, höchstens 8 Kerne pro OSD, und jeder OSD-Kern auf einem eigenen physischen Kern statt geteilt mit einem SMT-Geschwister.
Acht physische Kerne und acht OSDs ergeben je einen Kern, flashstore_lcores = 0 bis 7, und die SMT-Geschwister bleiben Proxmox und den VMs.
Mit diesem Stand in der Konfiguration erneut ausgeführt, markiert der Check jeden Kernplan als OK.
Schau dir die Hugepages noch einmal an.
Der Check verlangt 2048 MiB pro OSD, das ist der Standardwert --mem des Daemons, also brauchen acht OSDs 16 GiB reserviert.
Im Betrieb hat jedes OSD 512 MiB seiner 2048 genutzt.
Das passt zu croits eigener Design-Notiz für das Kernel-Backend, die ein Viertel von --mem für seinen Payload-Allocator veranschlagt10.
Auf dieser Maschine sitzen also, mit allen acht laufenden OSDs, 12 GiB RAM als Hugepages reserviert, die nichts anfasst, auf einem Host, der auch VMs zu versorgen hat.
Einem reinen Storage-Node wäre das egal.
Auf einem Proxmox-Node war dieser Speicher eine VM, und weiter unten wird er auf das gekürzt, was die OSDs nutzen.
Darf ich fragen, warum es ceph.conf nicht lesen kann?
Laufwerke formatiert, Paket drin, Host-Check sauber, und das erste OSD startete nicht.
croit-flashstore-tool: refused: /etc/ceph/ceph.conf: Permission denied (os error 13)
Auf Proxmox ist /etc/ceph/ceph.conf ein Symlink auf /etc/pve/ceph.conf, und /etc/pve ist pmxcfs, das Cluster-Dateisystem, das die Konfiguration aller Nodes im Gleichschritt hält.
Dateien dort sind root:www-data 0640, und pmxcfs lässt dich das nicht pro Datei ändern11.
Proxmox’ eigene Ceph-Daemons kommen damit klar, weil sie als root starten, die Konfiguration lesen und dann zum Benutzer ceph wechseln. Genau das macht --setuser ceph --setgroup ceph in jeder ceph-osd@-Unit.
FlashStores Unit startet nicht als root.
Sie ist User=ceph ab der ersten Anweisung, ExecStartPre eingeschlossen12, und kommt deshalb nie dazu, die Datei zu lesen.
Darf ich fragen, warum ein Paket, das für Debian gebaut ist, für ein Drop-in-Produkt, nicht gegen die verbreitetste Debian-basierte Ceph-Plattform überhaupt ausprobiert wurde? Ich frage nicht, wer. pveceph legt seine Konfiguration auf pmxcfs ab, und jedes FlashStore-OSD auf einem von pveceph verwalteten Node läuft beim ersten Start genau hier hinein.
Der Daemon hat die Antwort schon eingebaut.
Sein Quellcode beschreibt einen klassischen --setuser/--setgroup-Wechsel: „started as root by a classic unit (--setuser ceph --setgroup ceph), the daemon becomes that user before it opens the store, a socket or a file“13.
Ein Drop-in, das die Unit so startet, wie Proxmox seine eigenen OSDs startet, sollte also reichen.
Ganz reichte es nicht. Als reines root gestartet, kam die nächste Ablehnung vom Laufwerk.
activate: device kernel:/dev/ng0n1 not ready: /dev/nvme0n1: Permission denied (os error 13)
Das CapabilityBoundingSet der Unit lässt CAP_DAC_OVERRIDE weg12, also gelten für root die normalen Dateirechte, und die Namespace-Nodes gehören ceph:ceph.
Als root mit Gruppe ceph zu starten deckt beides ab: root gehört die Konfigurationsdatei, die Gruppe ceph öffnet das Laufwerk, und der Daemon wechselt zu ceph, bevor er irgendetwas anderes tut.
# /etc/systemd/system/croit-flashstore-osd@.service.d/pve-ceph-conf.conf
[Service]
User=root
Group=ceph
ExecStart=
ExecStart=/usr/bin/croit-flashstore-osd run --id %i --cluster ${CLUSTER} -f --setuser ceph --setgroup ceph
Der Daemon bestätigt den Wechsel in seinem eigenen Log: set uid:gid to 64045:64045 (ceph).
Es gibt eine kürzere Lösung, SupplementaryGroups=www-data, und ich habe sie nicht genommen.
Sie würde das OSD jede gruppenlesbare Datei unter /etc/pve lesen lassen, nicht nur die Ceph-Konfiguration.
Ein OSD hat im Rest der Cluster-Konfiguration nichts verloren, und das Drop-in oben gibt ihm nichts mehr, als Proxmox seinen eigenen gibt.
Dann die Device-Nodes.
FlashStores Doku sagt, der Namespace-Node muss für ceph schreibbar sein, „(udev rule)“14, und das Paket liefert keine mit.
Diese hier erkennt die Laufwerke am Modell, kann also das Boot-Laufwerk nicht erwischen, egal was die Nummerierung macht:
# /etc/udev/rules.d/70-croit-flashstore-optane.rules
SUBSYSTEM=="nvme-generic", KERNEL=="ng*n*", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
SUBSYSTEM=="block", KERNEL=="nvme*n*", ENV{DEVTYPE}=="disk", ATTRS{model}=="Dell Express Flash NVMe P4800X*|INTEL SSDPE21*", OWNER="ceph", GROUP="ceph", MODE="0660"
Nach udevadm trigger waren die sechzehn Optane-Nodes ceph:ceph 0660, und die SN750 blieb root.
Das Passthrough, das dieser Kernel verweigert
Die Kernel-Stufe hat zwei Modi, und der Node, den du angibst, wählt zwischen ihnen.
kernel:/dev/ngXnY schickt NVMe-Befehle über io_uring direkt ans Laufwerk, was croit kernel-cmd nennt.
kernel:/dev/nvmeXnY macht O_DIRECT-Reads und -Writes auf dem Block-Device, genannt kernel oder Direct10.
croit hat kernel-cmd in jeder getesteten Zelle vorn gemessen10, und der Quick Start der README nutzt es selbst1, also habe ich das konfiguriert.
Mit geklärten Rechten wechselte der Daemon zu ceph, las seine Konfiguration und blieb beim ersten Read stehen:
croit-flashstore-osd: --dev kernel:/dev/ng0n1: /dev/ng0n1: kernel-cmd fixed-buffer probe read: Errno(13)
Dieselbe Probe war eine Minute vorher in activate durchgegangen, das noch die Capabilities von root hatte.
Die Frage ist also, ob dieser Kernel einen unprivilegierten Prozess I/O-Befehle über /dev/ngXnY schicken lässt.
Das lässt sich ohne FlashStore beantworten, mit demselben Read über nvme-cli, als ceph:
| Als | Befehl auf /dev/ng0n1 | Ergebnis |
|---|---|---|
ceph | Identify Namespace | erlaubt |
ceph | Read, LBA 0, 4 KiB | Permission denied |
root | Read, LBA 0, 4 KiB | erlaubt |
Alle acht Optanes gaben dieselbe Antwort, auch zwei, die ich nie formatiert oder zurückgesetzt hatte und die Intels Firmware statt Dells fahren. Es liegt also nicht an den Laufwerken und nicht an den Formaten vom Morgen.
Upstream sagt, es sollte gehen.
In Linux 7.0 lässt nvme_cmd_allowed() einen unprivilegierten Prozess einen I/O-Befehl schicken, wenn das Commands Supported and Effects Log des Laufwerks ihn als unterstützt ohne ungewöhnliche Effekte markiert, und verlangt ein schreibbares Öffnen nur für Befehle, die Daten schreiben oder ändern15.
Das Effects Log der P4800X markiert Read als unterstützt, 00000001, und sonst nichts.
Der Read ist erlaubt.
Proxmox’ Kernel ist nicht der von Upstream.
Sein Changelog für diesen Build enthält einen zurückportierten Fix genau auf diesem Pfad, CVE-2026-90227: nvme/ioctl: check SUBMIT_IO with nvme_cmd_allowed(), der dem Anschein nach einen anderen ioctl betrifft als den, den ich getestet habe.
Ich habe nicht festgenagelt, welche Änderung im Kernel 7.0.14-28-pve den Unterschied macht, und ich rate nicht.
Sicher ist das Verhalten: Auf diesem Kernel wird unprivilegiertes NVMe-Passthrough-I/O verweigert.
FlashStore hat einen Fallback für verweigertes Passthrough, und er griff nicht.
croits Design-Notiz sagt, wenn Identify verweigert wird, fällt ein kernel-cmd-Device auf Direct I/O über seinen Block-Node zurück und meldet das beim Start10.
Hier ist Identify erlaubt und Read nicht, also greift der Fallback nie, und das OSD bleibt stattdessen stehen.
Direct I/O ist das egal. Es ist eine Zeile pro OSD:
flashstore_store_backend = kernel
Damit kam osd.0 hoch.
croit-flashstore-osd: store mounted (1 shards, replayed 4 txns in 16 ms)
croit-flashstore-osd: set uid:gid to 64045:64045 (ceph)
[    1.398] crush location set (create-or-move updating item name 'osd.0' weight 0.3359 at location {host=pve2,root=default} to crush map)
[    2.406] osd.0 is now active (up_from 10, map 10)
Aktiv in 2,4 Sekunden.
OSDs vorbereiten und starten
Jedes OSD bekommt einen Abschnitt in der Ceph-Konfiguration, was auf Proxmox heißt, /etc/pve/ceph.conf zu bearbeiten, und das von Hand zu tun ist in Ordnung.
[osd.0]
	flashstore_dev = spdk:0000:05:00.0
	flashstore_store_backend = kernel
	flashstore_lcores = 0
Das Gerät wird per PCI-Adresse benannt, nicht als /dev/nvme0n1, und das Präfix spdk: bedeutet hier nicht SPDK.
Ist ein Kernel-Backend gesetzt, schlägt der Daemon die Adresse bei jedem Start in sysfs nach und findet die aktuellen Nodes des Controllers10.
Das zählt hier.
Das Boot-Laufwerk SN750 war im Oktober nvme7 und ist jetzt nvme8, und die Minor-Nummern der generischen Nodes folgen auch nicht der Laufwerksreihenfolge, mit ng1n1 auf Minor 0 und ng0n1 auf Minor 2.
Eine Konfiguration, die /dev/nvme4n1 sagt, kann nach einem Neustart auf ein anderes Laufwerk zeigen.
Eine Konfiguration, die 0000:0b:00.0 sagt, kann das nicht.
Dann ein Befehl pro Laufwerk, der den Store schreibt und das OSD beim Monitor registriert:
croit-flashstore-tool prepare --dev spdk:0000:05:00.0 --id 0
kernel-cmd /dev/ng0n1: fixed-buffer NVMe passthrough probe ok (IORING_URING_CMD_FIXED on)
mkfs: device lba 4096 B x 91573146 (375083606016 B), awupf 1 lba, vwc false, max_xfer 32 lba
mkfs: 1 store shards, WAL ring 4096 MiB each
osd.0 prepared in /var/lib/ceph/osd/ceph-0
Zwei Sekunden, als root.
prepare liest den Bootstrap-Schlüssel aus /var/lib/ceph/bootstrap-osd/ceph.keyring16, den pveceph erst schreibt, wenn es zum ersten Mal ein eigenes OSD anlegt. Ohne klassische OSDs muss er also vorher geholt werden:
ceph auth get client.bootstrap-osd -o /var/lib/ceph/bootstrap-osd/ceph.keyring
Sechs Laufwerke ließen sich auf Anhieb vorbereiten. Zwei wurden abgewiesen:
croit-flashstore-tool: refused: device is not empty (non-zero data in the first 8192 bytes); --wipe destroys it
croit-flashstore-tool: refused: device is not empty (non-zero data at 65536 bytes); --wipe destroys it
lsblk und blkid hatten beide Laufwerke als leer gemeldet.
Darauf lag der Text-Metadatenbereich einer LVM-Volume-Group aus einem früheren Lab, längst entfernt, mit dem Label vorn schon genullt.
FlashStores Probe liest die ersten 8 KiB und die Bereiche bei 64 KiB und 256 KiB17, weiter als die üblichen Werkzeuge schauen, und sie hatte recht.
Ein Laufwerk abzuweisen, auf dem überhaupt etwas liegt, außer man sagt --wipe, ist genau das, was ein OSD-Werkzeug tun sollte.
Sie zu löschen ist eine Entscheidung für den, dem die Laufwerke gehören, nicht für das Werkzeug. Als das entschieden war, hat --wipe beide in etwa zwei Sekunden vorbereitet, und sie sind erst nach der Installation weiter unten dazugekommen. Deshalb zeigen der Screenshot des Panels und die Zahlen der Installation sechs.
Dann starten:
systemctl enable --now croit-flashstore-osd@0
ID  CLASS  WEIGHT   TYPE NAME      STATUS  REWEIGHT  PRI-AFF
-1         2.01535  root default
-3         2.01535      host pve2
 0   nvme  0.33589          osd.0      up   1.00000  1.00000
 1   nvme  0.33589          osd.1      up   1.00000  1.00000
 2   nvme  0.33589          osd.2      up   1.00000  1.00000
 3   nvme  0.33589          osd.3      up   1.00000  1.00000
 4   nvme  0.33589          osd.4      up   1.00000  1.00000
 5   nvme  0.33589          osd.5      up   1.00000  1.00000
Jedes OSD hat sich selbst unter host=pve2 mit der Device-Klasse nvme eingetragen.
Was sie dem Cluster über sich erzählen, lohnt sich, einmal zu lesen:
| Feld | Monitor und Manager | FlashStore-OSDs |
|---|---|---|
ceph versions | 21.2.0 (087cd25db8f1) umbrella (dev - None) | 21.2.0 (b060042deb05) umbrella (dev - croit-flashstore-osd) |
| Gebaut von | Proxmox, -pve1-Pakete | croit, aus dem Upstream-Commit v21.2.0, den die README nennt1 |
osd_objectstore | bluestore, mit jedem bluestore_bdev_*-Feld ausgefüllt | |
| Was es wirklich ist | FlashStore, kein BlueFS, kein RocksDB |
Die BlueStore-Antwort ist Absicht.
flashstore_report_objectstore steht standardmäßig auf bluestore, weil klassische Monitore manche Features nur aktivieren, wenn jedes OSD das meldet, also hält der Standard einen gemischten Cluster am Laufen7.
Es stimmt nicht, und das solltest du wissen, bevor du die Metadaten des Clusters liest und ihnen glaubst.
Was Proxmox daraus macht
Das OSD-Panel von Proxmox listet alle sechs, up und in, Klasse nvme, Version 21.2.0, je 344 GiB.
Es nennt sie außerdem FileStore.
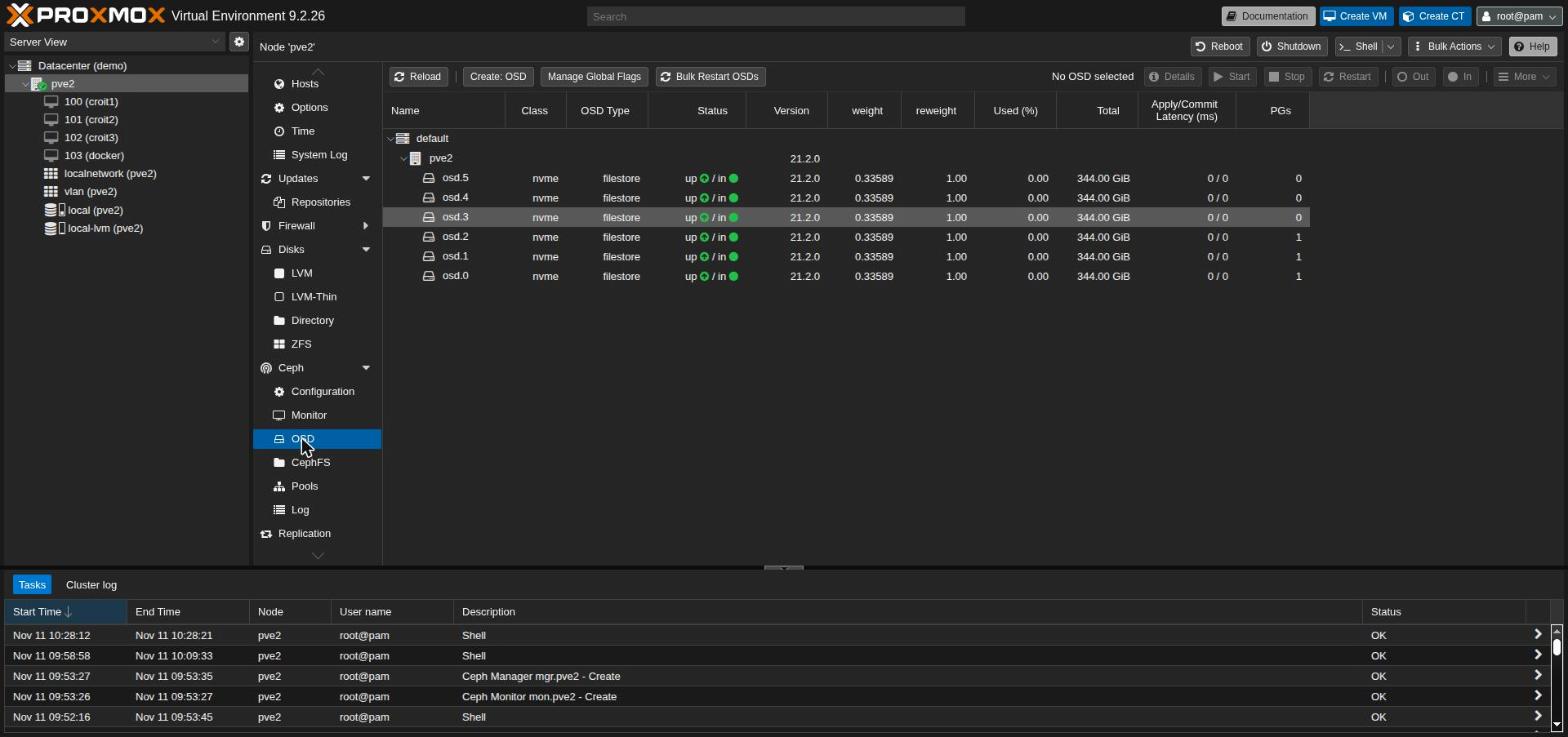
FileStore ist der Object Store, den BlueStore abgelöst hat.
Proxmox ermittelt das Label in PVE/API2/Ceph/OSD.pm: Haben die Metadaten des OSD einen Schlüssel bluefs, ist es BlueStore, alles andere ist FileStore18.
FlashStore hat kein BlueFS, weil kein RocksDB darunter liegt, also meldet es in einem Feld BlueStore und wird aus einem anderen als FileStore etikettiert.
Keins von beiden stimmt.
Und das Panel ist der Ort, an dem die meisten Proxmox-Admins zuerst nachsehen.
Die Latenzspalten zeigen im Leerlauf 0 / 0.
Während der Installation unten meldete ceph osd perf Commit-Latenzen von 0 bis 3 ms über die sechs.
Start, Stop und Restart im Panel steuern ceph-osd@N, die klassische Unit, und die läuft hier nicht19.
Das Panel ist für diese OSDs also eine Ansicht, keine Steuerung.
Nimm systemctl … croit-flashstore-osd@N und das CLI für alles, was die Daemons anfasst, und lass bei diesen Create: OSD und Destroy schön in Ruhe.
Ein Pool, ein Storage und eine VM mit Fisher-Price OS (Windows)
Die erste PG im Cluster, der .mgr-Pool des Managers, stand undersized+degraded, sobald die OSDs hochkamen.
Schuld ist der einzelne Node.
Die Standardregel replicated_rule legt jede Kopie auf einen anderen Host, und es gibt nur einen Host.
ceph osd crush rule create-replicated replicated_osd default osd nvme
ceph osd pool set .mgr crush_rule replicated_osd
Eine Regel mit Failure Domain osd und Device-Klasse nvme20 legt jede Kopie auf ein anderes OSD, und die PG ging innerhalb von Sekunden auf active+clean.
In einem echten Cluster mit drei oder mehr Hosts behältst du die Host-Regel und lässt das weg.
Alles danach ist die Proxmox-GUI wie gewohnt.
Ceph → Pools → Create: Name flashstore, Size 3, Min. Size 2, Regel replicated_osd, Add as Storage angehakt.
Später ging er für den Lasttest weiter unten auf Size 2, Min. Size 1.
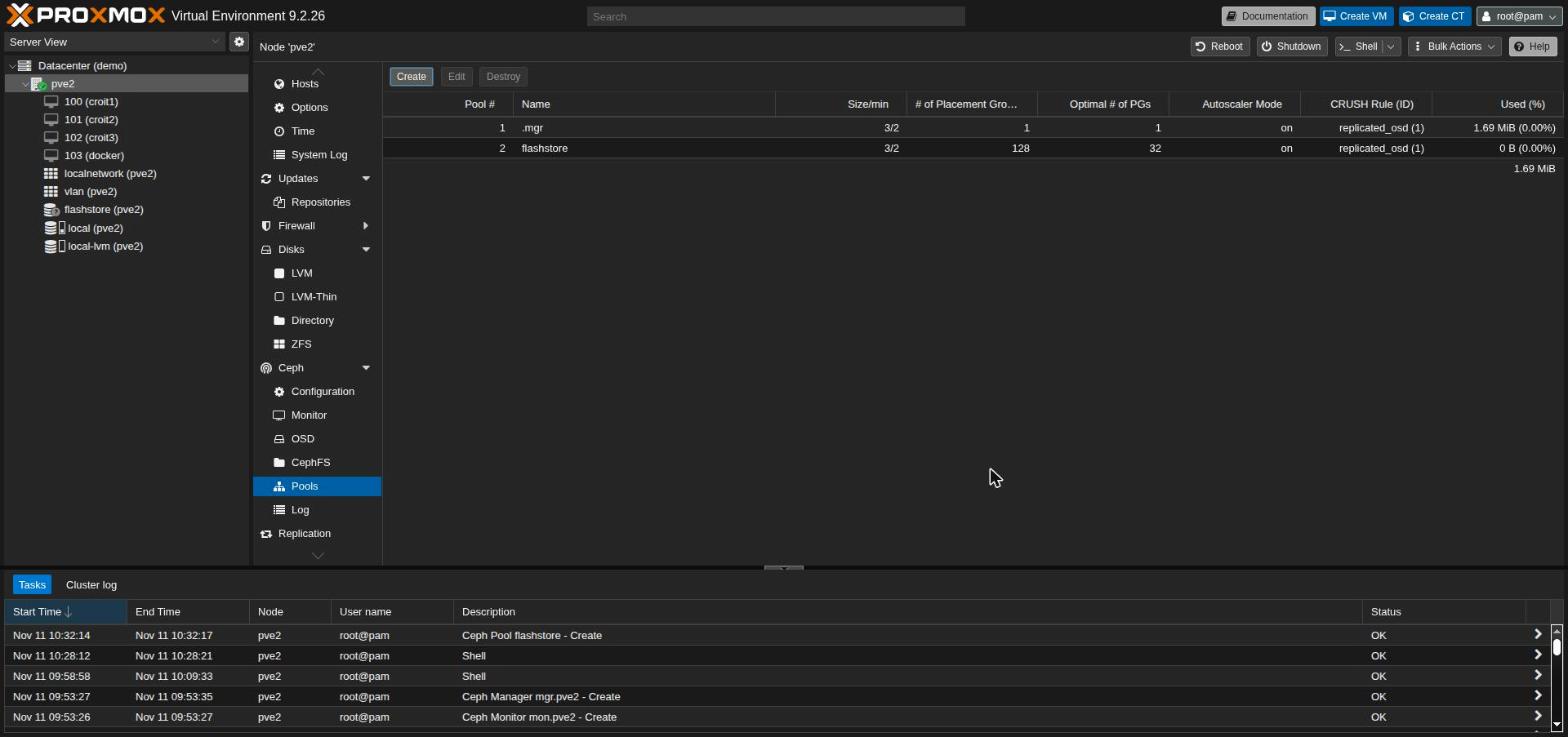
Proxmox hat Pool und RBD-Storage-Definition in einem Zug angelegt, und flashstore erschien im Baum mit 654 GiB nutzbar, also die 2 TiB roh geteilt durch drei Kopien, abzüglich Overhead.
129 PGs gingen auf active+clean, und der Autoscaler hat den neuen Pool kurz danach von 128 auf 32 heruntergesetzt.
Der Testgast ist eine VM mit Fisher-Price OS (Windows).
Das ist keine Vorliebe. Es ist das, was ein großer Teil der Kunden tatsächlich auf ihren Proxmox-Pools betreibt, also ist es die Last, die zählt: 16 GiB Speicher, 4 Kerne, eine 60-GiB-Disk auf flashstore mit discard und iothread an.
Es ist außerdem gesprächig gegenüber der Disk und geht ineffizient mit ihr um, und genau darum geht es: Ein Storage-Test will den Gast, der sich am stärksten auf die Disk stützt.
Den Pool während der ersten fünfzehn Minuten der Installation alle zehn Sekunden abgefragt:
| Pool-Writes | Median 9,3 MB/s bei Aktivität, Spitze 302 MB/s |
| Schreiboperationen | Spitze 2.486 pro Sekunde |
| Pool-Reads | Spitze 60 MB/s |
| Rohspeicher belegt | 35 GiB über sechs OSDs |
| Zustand | HEALTH_OK in allen 90 Proben |
| OSD-Neustarts | 0 |
| Residenter OSD-Speicher | danach 565 bis 871 MiB je OSD |
Das sind die Zahlen eines Installers, mit VM und OSDs auf demselben Host und unangetasteten Tuning-WARNs, und sie sagen nichts über die Geschwindigkeit von FlashStore. Was sie sagen: Ein klassischer Proxmox-Client hat eine Betriebssysteminstallation auf Rust-OSDs gefahren, 35 GiB roh, ohne einen Fehler, und genau das wollte dieser Post prüfen.
Was es unter Last macht
Eine Installation beweist, dass es läuft. Sie sagt dir nicht, wie sich die VM im Alltag anfühlt.
Also bekam die VM CrystalDiskMark 9.0.321, dreimal: das Profil Real World Performance [+Mix], Read&Write [+Mix], eine 16-GiB-Datei auf C: und ein Mix aus 70 % Lesen und 30 % Schreiben, einmal mit drei Durchläufen und zweimal mit neun. Dieses Profil schickt alles einzeln ab, eine Anfrage nach der anderen auf einem Thread, und genau das macht ein Desktop oder eine kleine Datenbank wirklich, nicht ein Datenblatt.
Bis dahin hatte sich das Setup seit der Installation verändert. Die VM hatte sechs Kerne, und der Pool war in der GUI auf Size 2, Min Size 1 und 256 PGs umgestellt. Size 2 mit Min Size 1 ist eine Laboreinstellung auf einer einzelnen Maschine: Mit nur noch einer Kopie nimmt der Pool weiter Writes an, die ein einziger Ausfall dann verlieren kann. Überall sonst: 3 und 2.
Die Disk lief mit dem Proxmox-Standard, kein Cache, der seit Proxmox 2 der Standard ist22.
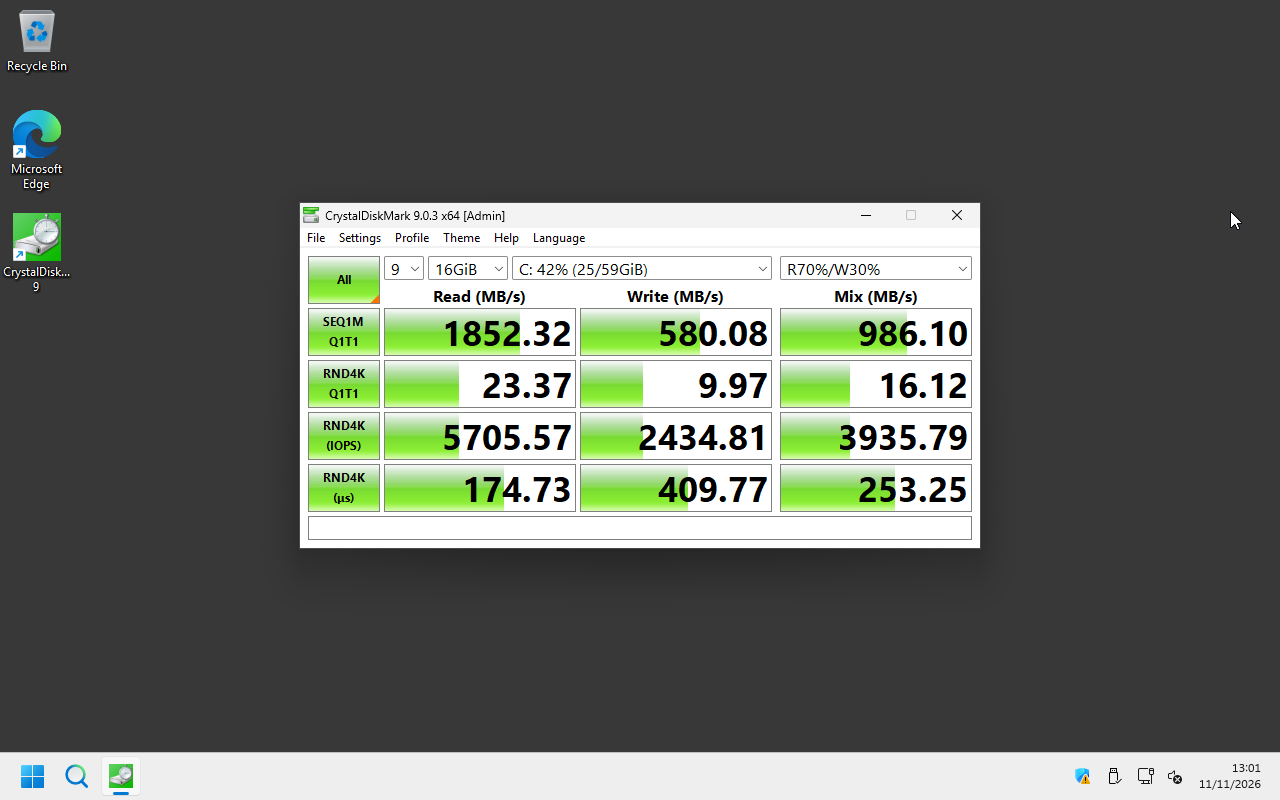
| Real World Performance [+Mix], 16 GiB | 3 Durchläufe | 9 Durchläufe | nochmal 9 Durchläufe |
|---|---|---|---|
| SEQ1M Q1T1 Lesen | 1.279,71 MB/s | 1.675,33 MB/s | 1.852,32 MB/s |
| SEQ1M Q1T1 Schreiben | 563,67 MB/s | 576,65 MB/s | 580,08 MB/s |
| SEQ1M Q1T1 Mix | 1.043,75 MB/s | 1.043,28 MB/s | 986,10 MB/s |
| RND4K Q1T1 Lesen | 5.342 IOPS, 186,57 µs | 5.659 IOPS, 176,17 µs | 5.706 IOPS, 174,73 µs |
| RND4K Q1T1 Schreiben | 2.419 IOPS, 412,51 µs | 2.405 IOPS, 414,79 µs | 2.435 IOPS, 409,77 µs |
| RND4K Q1T1 Mix | 3.938 IOPS, 253,13 µs | 3.826 IOPS, 260,49 µs | 3.936 IOPS, 253,25 µs |
Writes und die Latenz kleiner Blöcke bleiben von Lauf zu Lauf auf etwa 1 % gleich. Sequenzielles Lesen steigt über die drei Läufe um 45 %. Das ist das erste Zeichen, dass die Lese-Spalte nicht misst, wonach sie aussieht.
Der Host wurde durch alle drei Läufe alle fünf Sekunden abgetastet, aus /proc/diskstats für die acht Optanes, ceph status für den Pool und /proc für jeden Prozess und jeden Thread, und die beiden Sichten erzählen nicht dieselbe Geschichte.
Writes: Die Disk ist der kleine Teil
| Ein 4-KiB-Random-Write nach dem anderen, letzter Lauf | |
|---|---|
| Zeit pro Write aus Sicht der VM | 409,77 µs |
| Zeit pro Write an jeder Optane | 17 µs |
| Writes an den Optanes pro Write der VM | 4,05: zwei Kopien, je rund zwei Writes |
| Große sequenzielle Writes | 580 MB/s von der VM, 1,14 GB/s an den Optanes, die zweite Kopie verdoppelt es |
Die Disk macht unter 5 % eines kleinen Writes aus. Die übrigen 393 µs sind der Weg: QEMU, librbd, der Messenger ins OSD, das OSD selbst und das Warten auf die zweite Kopie. Nichts davon wurde hier einzeln gemessen, also hänge ich an kein Teil eine eigene Zahl. Was es aber sagt: Auf dieser Maschine sind die Optanes nicht die Grenze für I/O, das einzeln kommt, und eine schnellere Disk würde an den 410 nicht viel ändern. Die Grenze liegt jetzt beim Client, beim librbd, das Proxmox mitliefert, und dazu kommt mehr, sobald croits eigenes librustyrbd hier läuft.
Lesen: Der Cache, nicht die Optanes
Im letzten Lauf schaffte der 4-KiB-Random-Read 5.700 Reads pro Sekunde über die ganze 16-GiB-Datei, und die acht Optanes lasen überhaupt nichts.
Der sequenzielle Durchlauf erreichte am Pool 2,2 GB/s, während die Reads der Disks selbst von 755 MB/s auf null fielen.
CrystalDiskMark umgeht den Cache des Gasts, und die Disk hat in QEMU keinen, also sitzt der Speicher, der die Arbeit macht, in den OSDs.
flashstore_obj_cache ist in diesem Build standardmäßig an, der Anteil jedes OSD an der Datei liegt bei Size 2 bei etwa 2 GiB, und jedes OSD war auf etwa 2,6 GiB gewachsen.
FlashStore meldet seine Treffer nicht, also nenn das nahezu sicher, nicht bewiesen.
Darum stieg sequenzielles Lesen auch mit jedem Lauf: Mehr von der Datei war schon da.
Lies die Lese-Spalte als Cache-Wert, nicht als Wert des Stores.
CPU: Wohin die Kerne gingen
| Letzter Lauf, in Kernen | Host belegt | OSDs | vCPUs des Gasts | librbd und Ceph-Client | QEMU |
|---|---|---|---|---|---|
| Leerlauf zwischen Durchläufen | 20 bis 24 % | 3,3 | 0,1 | 0,03 | 0,03 |
| 4-KiB-Random-Write | 30 % | 3,9 | 0,38 | 0,20 | 0,08 |
| 4-KiB-Random-Read | 30 % | 3,6 | 0,47 | 0,39 | 0,15 |
| Sequenzieller Mix | 41 bis 53 % | 3,8 | 1,5 bis 2,3 | 0,5 | 0,12 |
Die drei Spalten der VM kommen aus ihren Threads: QEMU benennt die vCPUs des Gasts, und die Messenger- und Worker-Threads von librbd laufen im selben Prozess.
Die OSD-Spalte bewegt sich kaum. Acht pollende OSDs kosten 3,3 Kerne beim Nichtstun und 3,9 unter Volllast, also ist auf einer Maschine mit 16 Threads ein Fünftel der CPU weg, bevor eine VM überhaupt etwas will. Nichts anderes kam an seine Grenze. Der am stärksten belastete einzelne Thread war eine vCPU des Gasts mit 47 %, und der von librbd blieb unter 15 %. Bei einer Anfrage nach der anderen ist die Grenze das Warten, nicht die Arbeit, und eine CPU-Zahl kann kein Warten zeigen.
Speicher: Plane für die Spitze
| Über alle drei Läufe | |
|---|---|
| Health | HEALTH_OK in jedem Sample, jede PG active+clean, keine OSD-Neustarts |
| Belegte Hugepages | 4 GiB von Anfang bis Ende |
| Was der Host noch vergeben kann, mit einer laufenden 16-GiB-VM | 3,1 bis 4,0 GiB |
Die Hugepage-Zeile ist der Budget-Abschnitt noch einmal, diesmal unter Last: 512 MiB pro OSD, und die anderen 12 GiB nie angefasst.
Normaler Speicher ist die Zahl, auf die du achten musst, denn aus ihm besteht der Cache oben. Sobald ein Read die Datei hereingeholt hatte, stand jedes OSD bei etwa 2,5 GiB, und so viel hielt Ceph auf einem Host mit 58,7 GiB:
| Cephs Speicher in der Spitze, Standardziel 4 GiB | |
|---|---|
| OSD-Prozesse, alle acht zusammen | 19,9 GiB, 2,4 bis 2,6 GiB je OSD |
| Für die OSDs reservierte Hugepages | 16 GiB, davon 4 GiB belegt |
| Monitor und Manager | 0,3 GiB |
| Gesamt | 36,2 GiB, 62 % des Hosts |
| Was der Host noch vergeben kann, mit einer laufenden 16-GiB-VM | 3,6 GiB |
Er kommt zurück, aber nach keinem Fahrplan, den ich erkennen konnte.
Er hielt sich 25 Minuten lang bei 19,9 GiB, Leerlaufpausen eingeschlossen, fiel dann am Ende des letzten Laufs auf 13,9 GiB, und der Host hatte wieder 10,2 GiB zu vergeben.
osd_memory_target stand bei alldem auf dem Standard von 4 GiB pro OSD, also standen acht OSDs 32 GiB zu, bevor auch nur eine Hugepage gezählt ist.
Auf einem Node, der auch VMs tragen soll, ist die Spitze das Budget, das du vor den Disks ausrechnest, und genau dort tun die 12 ungenutzten GiB an Hugepages am meisten weh.
Drei VMs gleichzeitig, mit knapperem Budget
Eine VM lässt reichlich Platz. Bei drei muss das Budget stimmen. Also änderten sich zuerst zwei Einstellungen.
ceph config set osd osd_memory_target 1073741824   # 1 GiB per OSD, was 4
sysctl -w vm.nr_hugepages=2048                     # what eight OSDs use, was 8192
Das Ziel braucht sonst nichts: Jedes OSD meldete den neuen Wert innerhalb von Sekunden, und sie wurden trotzdem einzeln neu gestartet, mit allen 257 PGs wieder auf active+clean vor dem nächsten.
Die Hugepages haben einen Haken.
Vor jedem OSD-Start will croit-flashstore-prep ein ganzes --mem frei haben, 2048 MiB, und vergrößert den Pool, wenn es zu wenig ist, verkleinert ihn aber nie wieder.
Der Neustart von osd.7 nach dem Kürzen zog den Pool sofort wieder hoch:
croit-flashstore-prep[7]: hugepages 2048kB: free 256 < need 1024, nr_hugepages 2048 -> 2816
Die Untergrenze, die einen Neustart oder Reboot übersteht, ist also, was die OSDs nutzen, plus die Reserve für einen Start: 2.816 Pages, 5,5 GiB, statt der 16 GiB, die der Check verlangt. Das Setup-Skript oben reserviert jetzt genau das. Sind alle acht oben, bringt ein erneutes Kürzen auf 2.048 bis zum nächsten Neustart weitere 1,5 GiB.
Dann liefen drei Klone der VM mit je 10 GiB gleichzeitig CrystalDiskMark: Real World Performance [+Mix], drei Durchläufe, aber auf einer 1-GiB-Datei je VM statt 16 GiB. Damit ist die Lese-Spalte noch mehr ein Cache-Wert als zuvor, also lies die Writes.
| CrystalDiskMark, drei VMs gleichzeitig | VM 104 | VM 105 | VM 106 | Alle drei | Eine VM allein |
|---|---|---|---|---|---|
| SEQ1M Q1T1 Schreiben | 346,99 MB/s | 318,99 MB/s | 446,98 MB/s | 1.113 MB/s | 580,08 MB/s |
| SEQ1M Q1T1 Lesen | 796,05 MB/s | 905,03 MB/s | 1.160,93 MB/s | 2.862 MB/s | 1.852,32 MB/s |
| RND4K Q1T1 Schreiben | 1.901 IOPS | 1.928 IOPS | 1.862 IOPS | 5.691 IOPS | 2.435 IOPS |
| RND4K Q1T1 Schreiblatenz | 524,56 µs | 517,00 µs | 535,42 µs | 409,77 µs | |
| RND4K Q1T1 Lesen | 3.773 IOPS | 3.916 IOPS | 3.909 IOPS | 11.598 IOPS | 5.706 IOPS |
| RND4K Q1T1 Mix | 2.978 IOPS | 3.027 IOPS | 3.411 IOPS | 9.416 IOPS | 3.936 IOPS |
Drei VMs schafften das 2,3-Fache der kleinen Writes einer einzelnen, und jede zahlte dafür etwa 27 % an Latenz. Die Optanes waren immer noch nicht der Grund. Sie kamen auf höchstens 20.900 Writes pro Sekunde bei je 17 µs, dieselben 17 µs wie bei einer VM, und die am stärksten belastete der acht war zu 14 % ausgelastet.
| Host, alle fünf Sekunden über den Lauf | Standardziel 4 GiB, eine VM | Ziel 1 GiB, drei VMs |
|---|---|---|
| Größter OSD-Prozess | 2,7 GiB | 1,15 GiB in der Spitze, danach 0,8 |
| Alle acht OSD-Prozesse zusammen | 19,9 GiB | 8,0 GiB in der Spitze, danach 5,8 |
| Reservierte Hugepages | 16 GiB, 4 belegt | 4 GiB, alle belegt |
| Speicher für VMs | 16 GiB | 30 GiB |
| Was der Host noch vergeben kann, am niedrigsten | 3,1 GiB | 14,8 GiB |
| Swap-Wachstum | keins | keins |
FlashStore hält sich also an osd_memory_target.
In der Spitze eines Read-Durchlaufs lag es 15 % darüber und kam wieder darunter, mit dem Cache, der seine Arbeit innerhalb des Budgets macht statt außerhalb.
Zwischen Ziel und Kürzung bekamen die VMs auf derselben Maschine 26 GiB zurück.
| CPU in Kernen, drei VMs | Host belegt | OSDs | Gäste | librbd und Ceph-Client | QEMU |
|---|---|---|---|---|---|
| Drei Boots von Fisher-Price OS (Windows) | 81 bis 89 % | 3,4 bis 3,6 | 6,3 bis 7,9 | 0,4 bis 0,7 | 0,3 |
| Benchmark | 42 bis 73 % | 3,7 bis 4,5 | 1,2 bis 4,0 | 0,4 bis 1,6 | 0,2 bis 0,4 |
| Leerlauf danach | 20 bis 24 % | 3,3 | 0,3 | 0 | 0 |
Drei Gäste zu booten hat die CPU härter rangenommen, als sie zu benchmarken. Der Storage darunter kam nie in die Nähe, und das ist der Mini-PC, der die Grenze setzt, wie es von Anfang an klar war.
Alles in einem Skript
Alles oben steckt in einem Skript. Gib ihm die PCI-Adressen der Laufwerke, die OSDs werden sollen, und es erledigt den Rest, in der Reihenfolge dieses Posts, mit den beiden Proxmox-Korrekturen eingebaut.
flashstore-pve-setup.sh: FlashStore-OSDs auf einem Proxmox-VE-Nodelspci -D -d ::0108 # find the drives
bash flashstore-pve-setup.sh --dry-run 0000:05:00.0 # show the plan, change nothing
bash flashstore-pve-setup.sh 0000:05:00.0 0000:06:00.0
| Es prüft | Es schreibt | Es führt aus |
|---|---|---|
| Proxmox VE 9 und Ceph 21.2.0 Umbrella | den bootstrap-osd-Keyring | einen Passthrough-Lesezugriff als ceph, um kernel-cmd oder kernel zu wählen |
| jedes Laufwerk: NVMe, kein Schreibcache, nicht eingehängt, partitioniert oder belegt | das Drop-in, das als root startet und dann --setuser nutzt | prepare und systemctl enable --now pro Laufwerk |
| keine Daten in den Bereichen, die FlashStores eigene Prüfung liest | eine udev-Regel pro Laufwerk, per Seriennummer | den Host-Check, der nur bei dem anhält, was die OSDs brauchen |
| 4-KiB-Blöcke | einen [osd.N]-Abschnitt pro Laufwerk, je ein physischer Kern | den Paket-Download, geprüft gegen die SHA-256 des Releases |
Nichts wird zerstört, wenn du es nicht verlangst.
--format-4k formatiert ein Laufwerk neu, das nicht auf 4 KiB steht, eins nach dem anderen in einer eigenen Unit, damit nichts dazwischenfunkt, und --wipe erlaubt ihm, ein Laufwerk mit Daten zu überschreiben.
--single-node legt die Regel replicated_osd an, und ein zweiter Lauf überspringt Laufwerke, die schon OSDs sind.
Es wurde hier getestet, nicht nur geschrieben.
Es hat die SN750 wegen ihres Schreibcaches abgelehnt, das Laufwerk von osd.7 abgelehnt, solange noch ein Store darauf lag, und dann, mit osd.7 entfernt und seinen Geräteknoten wieder bei root, das OSD in 10,5 Sekunden aus dem Nichts neu gebaut und dabei selbst das Backend kernel gewählt.
Was es nicht tut: Ceph installieren.
Dieser Schritt verlangt, dass du eine Technology Preview akzeptierst, und das ist deine Entscheidung, nicht die eines Skripts.
Was repariert werden muss
Nichts davon hält einen entschlossenen Admin auf, und alles davon würde einen beschäftigten aufhalten. Jeder Punkt ist eine Aussage, die croit jedem macht, der das Paket herunterlädt, und auf jeden bin ich beim ersten Versuch gestoßen.
| Wo | Was passiert | Was es beheben würde |
|---|---|---|
| systemd-Unit | User=ceph kann pmxcfs nicht lesen, also startet das OSD auf einem pveceph-Node nie | den Start als root mit --setuser ausliefern, oder ein Proxmox-Drop-in |
| Fallback von kernel-cmd | greift nur, wenn Identify verweigert wird; auf PVEs Kernel wird Read verweigert und das OSD bleibt stehen | bei jedem verweigerten Passthrough-I/O auf Direct I/O zurückfallen |
| udev | die Doku verlangt eine Regel, die ceph die Namespace-Nodes gibt; mitgeliefert wird keine | eine ausliefern, die auf die konfigurierten Geräte zielt |
Zusammenfassung von --check | nennt Kernel-NVMe „compiled out“, obwohl es der einzige einkompilierte Store-Pfad ist | das Label korrigieren |
Exit-Code von --check | die Boot-SSD fällt durch den PLP-Test, also ist Exit 0 unerreichbar | nur konfigurierte oder Kandidaten-Geräte bewerten |
| Hugepages | bemisst 2048 MiB pro OSD, und prep will das bei jedem Start frei haben; das Kernel-Backend nutzt 512 | das Kernel-Backend nach dem bemessen, was es nutzt, und prep dasselbe verlangen lassen |
sha256sums.txt | Dateinamen passen nicht zu den Release-Assets | sie so benennen, wie sie veröffentlicht sind |
| Paketname | die Doku sagt apt remove flashstore; das Paket heißt croit-flashstore-osd | ein Name, oder der richtige in der Doku |
Referenz zu flashstore_dev | nennt nur spdk: und file: | kernel: und spdk: mit Kernel-Backend dokumentieren |
Nichts davon ist neue Arbeit. Der Daemon hat den Rechtewechsel, das Direct-Backend und die Fallback-Logik schon. Sie sind nur noch nicht für die Plattform zusammengesteckt, auf der die meisten es zuerst ausprobieren werden.
In einer Preview findet man so etwas heraus
Eine Preview ist der richtige Ort für jeden dieser Befunde, und der falsche Ort, um sie liegen zu lassen. Dafür ist eine Preview da: Jemand nimmt sie mit nach Hause, setzt sie auf die Hardware, die er tatsächlich hat, und schreibt auf, wo sie umfällt. Die Teile, auf die es ankommt, haben gehalten. Der Store kam in Millisekunden hoch, die OSDs sind einem Cluster beigetreten, den das Werkzeug von jemand anderem gebaut hat, und eine Betriebssysteminstallation ging ohne Fehler darauf.
Gestolpert ist es über alles rund um den Daemon. Eine Konfigurationsdatei auf einem Dateisystem, das die Unit nicht lesen konnte, ein Kernel, der zu einem Aufruf nein sagt, den Upstream erlaubt, ein Boot-Laufwerk, das der Check nicht aufhören wollte mitzuzählen. Nichts davon ist schwer. Alles davon ist der Unterschied zwischen Software, die funktioniert, und Software, die auf deiner Maschine funktioniert, und schließen lässt er sich nur, indem man auf den Maschinen testet, die die Leute haben, statt auf denen, die man dafür gebaut hat.
Trotz alledem ist das ein vielversprechender Anfang. Auf einem miesen Mini-PC, mit dem klassischen librbd noch auf der Client-Seite und allen acht Laufwerken an einer PCIe-3.0-Verbindung, werden die Optanes hier härter rangenommen als unter BlueStore. Wenn sich das weiterentwickelt, komme ich darauf zurück und grabe tiefer, je mehr vom Stack ersetzt wird, und mit einem Blick auf CephFS2.
„Drop-in“ ist ein Versprechen an einen Admin, der keine Zeit hat, den Quellcode zu lesen. Proxmox’ Monitore, Proxmox’ GUI, Proxmox’ Kernel und ein Paket von jemand anderem: Genau für diese Lage ist das Versprechen da. Fast hält es es jetzt. Neun kleine Korrekturen, dann hält es, und ich finde sie lieber an einem Mittwochmorgen, als dass ein Kunde sie an einem Freitagabend findet.
croit/ceph-rust README — Public Preview seit 9. November 2026, „not yet recommended for production data“, Anforderungen, Quick Start, Produktions-Feature-Set, getesteter Ceph-Commit. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
croit/ceph-rust release snapshot-2026-11-10 — die hier verwendeten Pakete, darunter
flashstore_…_debian-trixie_amd64.debundsha256sums.txt. ↩︎ ↩︎croit/ceph-rust — hardware requirements — Prüfung auf flüchtigen Schreibcache, Hugepages, Hinweise zur Kernel-Version. ↩︎
croit/ceph-rust — branches and versions —
mainzielt auf v21.2.0,v20.2.4auf v20.2.4; „The daemon refuses a cluster release outside its supported window.“ ↩︎ ↩︎Proxmox pve-manager, PVE/Ceph/Releases.pm —
umbrellageführt mitrelease => '21.2'undunsupported => 1. ↩︎croit/ceph-rust — build and install packages — Distributionen, glibc 2.34, Umgang mit
ceph-osd.target, dieapt remove-Zeile. ↩︎ ↩︎ ↩︎croit/ceph-rust — configuration reference —
flashstore_dev,flashstore_lcores,flashstore_report_objectstoreund warum es standardmäßigbluestoremeldet. ↩︎ ↩︎croit-flashstore-osd Cargo.toml — Zeile 29,
knet = [… "kernel-nvme"]. ↩︎croit/ceph-rust — first OSD tutorial — der rein lesende Host-Check; „Exit 0 means no FAIL.“ ↩︎ ↩︎
croit/ceph-rust — ADR 0169, kernel NVMe backend — die zwei Kernel-Modi, der gemessene Vergleich, das Budget des Payload-Allocators, die Auflösung von
spdk:-Adressen und der Fallback nur bei Identify (Nachtrag 6). Am Abend des Releases ins Repository aufgenommen. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎Proxmox VE — Proxmox Cluster File System (pmxcfs) — das Cluster-Dateisystem unter
/etc/pveund seine festen Besitzer und Rechte. ↩︎croit-flashstore-osd@.service —
User=ceph,ExecStartPre=… activateund einCapabilityBoundingSetohneCAP_DAC_OVERRIDE. ↩︎ ↩︎croit-flashstore-osd privdrop.rs — der klassische Rechtewechsel mit
--setuser/--setgroup. ↩︎croit/ceph-rust — prepare the host — „the namespace node must be readable and writable by user
ceph(udev rule)“. ↩︎Linux v7.0, drivers/nvme/host/ioctl.c —
nvme_cmd_allowed(), die Regel für unprivilegiertes NVMe-Passthrough. ↩︎croit/ceph-rust — security — „
preparedefaults--keyringto/var/lib/ceph/bootstrap-osd/<cluster>.keyring“. ↩︎croit/ceph-rust — prepare, activate and list — die Prüfung auf nicht leere Geräte und
--wipe. ↩︎Proxmox pve-manager, PVE/API2/Ceph/OSD.pm —
osdtypeist nur dannbluestore, wenn die Metadatenbluefsenthalten, sonstfilestore. ↩︎Proxmox pve-manager, PVE/Ceph/Services.pm —
ceph_service_cmd()bildetosd.Nauf die systemd-Unitceph-osd@Nab. ↩︎Ceph documentation — CRUSH maps — replizierte Regeln, Failure Domains und Device-Klassen. ↩︎
CrystalDiskMark — Crystal Dew World’s disk benchmark; “Various measure mode (Peak/Real World/Demo)”. ↩︎
Proxmox VE wiki — Performance Tweaks — the disk cache modes: “cache=none seems to be the best performance and is the default since Proxmox 2.X”. ↩︎