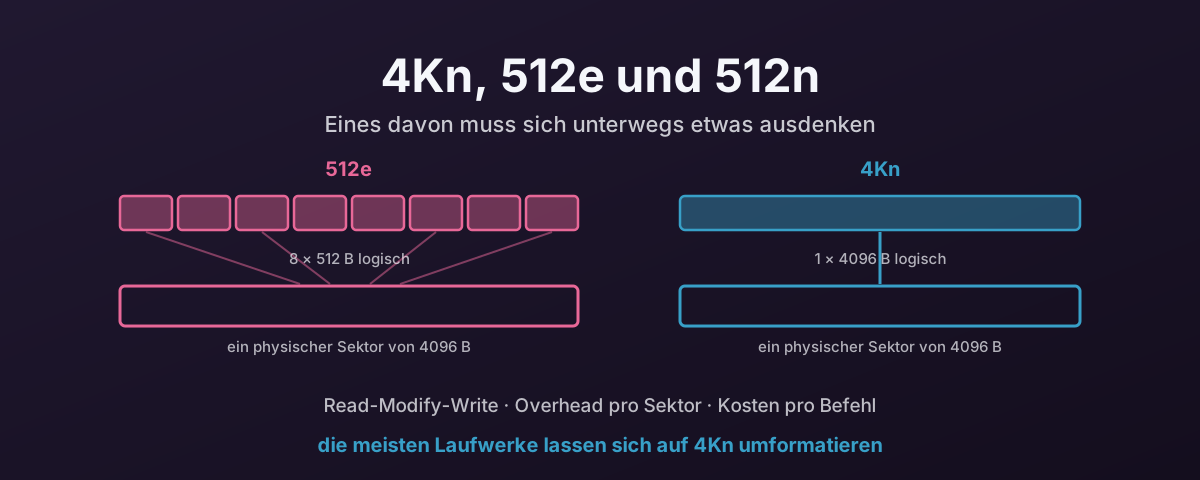
Drei Weisen, wie sich ein Laufwerk darstellen kann
Ein Laufwerk hat zwei Blockgrößen, und der Unterschied zwischen ihnen ist die ganze Geschichte.
Der physische Sektor ist das, womit das Medium tatsächlich arbeitet — die kleinste Einheit, die das Laufwerk ohne Zusatzarbeit lesen oder schreiben kann. Der logische Block ist das, womit das Laufwerk dem Host sagt, dass es arbeitet — die Einheit, die der Host adressiert.
Es gibt drei Kombinationen in der Welt.
512n — natives 512. Beide Größen sind 512 Byte. Das ist die alte Welt: Festplatten von vor 2010, und nichts, was du heute neu in einer erwähnenswerten Größe kaufen würdest.
512e — Emulation von 512 Byte. Der physische Sektor ist 4096 Byte, aber das Laufwerk meldet logische Blöcke von 512 Byte und übersetzt in der Firmware. Das gibt es aus einem Grund: Kompatibilität mit Betriebssystemen, Bootloadern und Anwendungen, die für immer 512 angenommen haben. Als Technik vernünftig genug, und die Wurzel so gut wie allen Ärgers, der folgt.
4Kn — natives 4K. Beide Größen sind 4096 Byte. Das Laufwerk sagt die Wahrheit, der Host adressiert es in der Einheit, die das Medium nutzt, und es sitzt keine Übersetzungsschicht dazwischen.
Was 512e bei jedem fehlausgerichteten Schreibvorgang tut
Lesen ist in allen drei Fällen billig. Das Laufwerk liest den 4-K-Sektor und gibt die 512-Byte-Scheibe zurück, die du wolltest.
Schreiben ist die Stelle, an der die Fiktion teuer wird.
Schreibt der Host einen einzelnen logischen Block von 512 Byte, kann das Laufwerk keine 512 Byte schreiben. Das Medium hat keine solche Einheit. Also tut es stattdessen dies:
- Den ganzen physischen Sektor von 4096 Byte lesen.
- Die 512 Byte neue Daten einmischen.
- Den ganzen Sektor von 4096 Byte zurückschreiben.
Das ist ein Read-Modify-Write, und es macht aus einem kleinen Schreibvorgang ein Lesen plus ein Schreiben. Auf einer sich drehenden Platte heißt das warten, bis der Teller wieder herumkommt. Eine volle Umdrehung bei 7.200 min⁻¹ sind etwa 8 ms, mit denen du nicht gerechnet hast. Auf Flash sind die Kosten anderer Art, und sie verschwinden nicht, wenn der Schreibvorgang fertig ist. Das hat weiter unten seinen eigenen Abschnitt.
Fehlausrichtung ist die Fassung davon, die am härtesten beißt. Beginnt eine Partition an einem ungeraden 512-Byte-Versatz — der Klassiker ist die alte Konvention mit 63 Sektoren —, dann liegt jeder 4-K-Schreibvorgang des Dateisystems über zwei physischen Sektoren. Das ist nicht ein Read-Modify-Write, sondern zwei, bei jedem einzelnen Schreibvorgang, für immer, bis jemand das Laufwerk neu partitioniert.
Schreibverstärkung auf Flash
Auf einer Festplatte kostet dich der Read-Modify-Write eine Umdrehung, und dann ist es vorbei. Auf Flash kostet er dich Lebensdauer, und das ist eine Rechnung, die du einmal bezahlst und weiter bezahlst.
Schreibverstärkung ist das Verhältnis von dem, was wirklich in das NAND geschrieben wurde, zu dem, was der Host schreiben wollte. Ein Verhältnis von 1,0 hieße, das Laufwerk hat genau geschrieben, was es bekommen hat. Es ist nie 1,0, denn Flash kann nicht an derselben Stelle überschreiben: das Laufwerk programmiert eine frische Seite, markiert die alte als veraltet, und die Speicherbereinigung lagert später die überlebenden Seiten um, damit ein ganzer Block gelöscht werden kann. Diese Umlagerungen sind auch Schreibvorgänge.
512e legt darauf eine vermeidbare Schicht, und der Grund ist eine Einzelheit, die klar gesagt werden sollte: die Übersetzungsschicht des Laufwerks bildet in Einheiten von rund 4 KB ab, egal welche logische Blockgröße es angibt. Ein Laufwerk, das Blöcke von 512 Byte meldet, führt innen weiter Einheiten von 4 KB.
Ein Schreibvorgang von 512 Byte vom Host wird also im Laufwerk: die 4-KB-Abbildungseinheit lesen, die 512 Byte einmischen, eine neue 4-KB-Einheit programmieren. 4096 Byte erreichen das NAND, damit 512 Byte sich ändern konnten. Achtmal der Schreibvorgang, für diesen Schreibvorgang.
Fehlausrichtung ist pro Schreibvorgang weniger dramatisch und in der Summe schlimmer. Ein 4-KB-Schreibvorgang, der über zwei Abbildungseinheiten liegt, schmutzt beide, es werden also 8 KB für 4 KB Daten programmiert. Das sind 2× Verstärkung bei jedem einzelnen Schreibvorgang, dauerhaft, bis die Partitionstabelle stimmt.
Die Folgewirkungen sind es, die das wichtig machen, statt bloß unordentlich zu sein:
- Mehr NAND-Schreibvorgänge heißen, dass die Speicherbereinigung öfter läuft, und ihre Umlagerungen sind selbst Verstärkung.
- Ein SLC-Schreibcache füllt sich früher, das Laufwerk fällt also früher in seinen langsameren Dauerzustand, und der Durchsatz beim Dauerschreiben sinkt.
- Programmier-/Löschzyklen werden im Verhältnis zu dem verbraucht, was das NAND erreichte, nicht zu dem, was der Host schickte. Verdopple die Verstärkung, und du hast die Lebensdauer des Laufwerks für dieselbe Arbeit halbiert.
- Angaben zur Haltbarkeit — TBW, DWPD — sind gegen die Schreibvorgänge des Hosts angegeben. Verstärkung frisst diesen Spielraum still auf, und das Laufwerk nutzt sich vor der Garantierechnung ab, die du beim Kauf gemacht hast.
Direkte und synchrone Schreibvorgänge sind der schlimmste Fall
Die meiste Zeit verbirgt der Page-Cache all das. Der Kernel sammelt kleine Schreibvorgänge, führt sie zusammen und schickt IO von 4 KB oder mehr an das Laufwerk, der Read-Modify-Write passiert also nie.
Zwei Flags nehmen diesen Schutz weg, und Anwendungen, denen Dauerhaftigkeit wichtig ist, setzen beide.
O_DIRECT umgeht den Page-Cache.
Es steht nun nichts mehr zwischen der Anwendung und dem Laufwerk, das einen 512-Byte-Schreibvorgang zu etwas Sektorgroßem zusammenführen könnte.
O_SYNC oder O_DSYNC verlangt, dass der Schreibvorgang auf beständigem Medium liegt, bevor der Aufruf zurückkommt.
Das hindert das Laufwerk daran, den Schreibvorgang in einen flüchtigen Puffer aufzunehmen und ihn später mit seinen Nachbarn zusammenzuführen.
Nimm beides zusammen, und jeder 512-Byte-Schreibvorgang ist ein vollständiger Read-Modify-Write-Durchlauf, der jetzt fertig werden muss, für sich, ohne etwas, worauf er sich verteilen ließe. Dort nähert sich die Verstärkung auf einem 512e-Laufwerk ihren theoretischen 8×, und es ist genau das Muster, das ein Commit-Log einer Datenbank, ein ZFS-ZIL oder ein Ceph-BlueStore-WAL erzeugt.
Schutz bei Stromverlust ist das, was das auf Hardware für Unternehmen rettet. Ein Laufwerk mit PLP kann einen synchronen Schreibvorgang bestätigen, sobald er in einem kondensatorgestützten DRAM-Puffer liegt, was beständig ist, und intern trotzdem zusammenführen, bevor es NAND programmiert. Ein Consumer-Laufwerk ohne PLP muss den Flash erreichen, bevor es antworten darf, und zahlt also die vollen Kosten pro Schreibvorgang. Ein weiterer Grund, warum PLP für diese Art Arbeit nicht optional ist.
In Proxmox entscheidet der Cache-Modus, welches davon du bekommst:
cache=noneistO_DIRECT— die Voreinstellung von PVE und die richtige Wahl für HA komplett auf Flash. Der Page-Cache des Hosts ist aus dem Weg, die Schreibmuster des Gasts erreichen das Laufwerk also so, wie der Gast sie abgeschickt hat.cache=directsyncistO_DIRECTplusO_DSYNC— jeder Schreibvorgang synchron. Es ist eine Nischeneinstellung für Laufwerke, die nur ein Datenbank-Log tragen, und für allgemeine Arbeit unbrauchbar.
Auf einem 512e-Gerät als Unterlage ist cache=directsync mit einem Gast, der in Datensätzen von 512 Byte committet, ungefähr die ineffizienteste Anordnung, die zu haben ist: kein Zusammenführen im Host, kein Zusammenführen im Laufwerk, und ein Read-Modify-Write pro Commit.
Und hier ist der Teil, der 4Kn strukturell macht statt bloß vorzuziehen.
O_DIRECT verlangt, dass Versatz, Länge und Puffer an der logischen Blockgröße des Laufwerks ausgerichtet sind.
Auf einem 512e-Laufwerk sind das 512 Byte, ein direkter Schreibvorgang von 512 Byte ist also erlaubt, und das Laufwerk bezahlt still dafür.
Auf 4Kn ist der logische Block 4096, der kleinste direkte Schreibvorgang, den der Kernel annimmt, ist also 4 KB.
Das krankhafte Muster hört auf, etwas zu sein, das du vermeiden musst, und wird etwas, das der Stapel nicht ausdrücken kann.
Overhead auf dem Medium
Die zweiten Kosten sind strukturell, und sie sind der Grund, warum Advanced Format überhaupt existiert.
Ein Sektor ist nicht bloß seine Daten. Auf einer Festplatte trägt jeder eine Synchronisationsmarke, damit der Kopf weiß, wo der Sektor beginnt, eine Lücke, damit aufeinanderfolgende Sektoren nicht ineinanderlaufen, eine Adressmarke und ein ECC-Feld, um Lesefehler zu korrigieren.
Mit Sektoren von 512 Byte zahlst du all das achtmal für jede 4 K Daten. Mit einem 4-K-Sektor zahlst du es einmal.
Das hat zwei Folgen, und die zweite zählt mehr als die erste:
- Ein Teil des Tellers, der Overhead war, wird nutzbare Kapazität. Das war die erklärte Absicht der Branche beim Übergang zu Advanced Format, im niedrigen einstelligen Prozentbereich.
- Das ECC-Feld kann bei gleichem Gesamt-Overhead viel größer sein. Ein starker Code, der 4096 Byte schützt, korrigiert weit mehr als acht schwache Codes, die je 512 Byte schützen. Als die Flächendichte stieg, hörte das auf, eine Annehmlichkeit zu sein, und wurde der einzige Weg, die Fehlerraten erträglich zu halten.
Flash hat keine Synchronisationsmarken und keine Lücken aus der Drehung, aber dieselbe Logik gilt eine Ebene höher: NAND wird in Seiten programmiert, Seiten sind weit größer als 512 Byte, und die Abbildungstabellen des Laufwerks haben einen Eintrag pro adressierbarer Einheit. Kleinere logische Blöcke heißen mehr Metadaten, um dieselbe Kapazität zu führen.
Overhead im Host: Befehle und Interrupts
Die dritten Kosten sind die, die Leute übersehen, denn sie fallen überhaupt nicht auf dem Laufwerk an.
Die logische Blockgröße setzt den Boden dafür, wie klein ein IO sein kann. Auf einem Laufwerk mit logischen 512 Byte darf ein Dateisystem oder eine Anwendung 512 Byte schreiben, und jeder davon ist ein vollständiges IO: ein Befehl gebaut und eingereicht, ein Schreibvorgang auf die Türklingel, ein Eintrag in der Completion Queue und ein Interrupt, der sagt, dass es fertig ist.
Jedes davon hat feste Kosten, denen es gleich ist, wie viele Daten beteiligt waren. Bewege 4 KB als acht Befehle über 512 Byte, und du zahlst diese Kosten achtmal. Bewege sie als einen 4-K-Befehl, und du zahlst sie einmal.
Zwei ehrliche Einschränkungen, denn hier wird das Argument meist überzogen.
Für großes IO ändert die logische Blockgröße nichts an der Zahl der Befehle. Ein einzelner Befehl kann viele Blöcke beschreiben, ein sequentieller Schreibvorgang über 1 MB ist also ein Befehl, ob die Blöcke 512 Byte oder 4 K groß sind. Die Einsparung ist nur dort echt, wo kleines IO abgeschickt wird.
Wo kleines IO abgeschickt wird, ist die Wirkung allerdings nicht subtil: jede dieser acht Anforderungen ist eine, die der Kernel bauen, einplanen und abschließen muss, jede mit ihrem eigenen MSI-X-Interrupt und ihrem eigenen Übergang vom Nutzer- in den Kernbereich, und bei hohen Queue-Tiefen kommt so ein Interrupt-Sturm zustande. In einer VM ist es noch schlimmer, denn jeder dieser Interrupts ist außerdem ein Kontextwechsel im Gast.
Und moderne NVMe-Controller fassen Interrupts zusammen, die Zahl der Interrupts ist also nicht einfach die Zahl der Befehle. Die Arbeit fürs Einreichen und Abschließen pro Befehl bleibt aber, und bei ein paar hunderttausend IOPS sind die CPU-Kosten pro Befehl ein messbarer Bruchteil eines Kerns. Das ist dieselbe Rechnung wie bei Posted Interrupts in der Passthrough-Reihe — kleine feste Kosten, mit einer sehr großen Zahl multipliziert.
4Kn, Sektor-Metadaten und Hardware-RAID
Auf ein Format von 4096 + 0 zu gehen hat eine Folge, die Leute erwischt, und sie trifft geradewegs Hardware-RAID.
Manche RAID-Controller und Speicher-Arrays nutzen überhaupt keine einfachen Sektoren von 512 oder 4096 Byte. Sie formatieren Laufwerke auf eine erweiterte Größe — 520 oder 528 Byte, oder die 4-K-Gegenstücke wie 4104, 4160 und 4224 —, denn diese zusätzlichen Byte pro Sektor sind der Ort, an dem der Controller seine eigenen Metadaten hält. Das sind Schutzinformationen nach T10-PI/DIF oder Integritätsdaten des Herstellers, direkt bei den Daten gespeichert, die sie beschreiben.
Ein Format von 4096 + 0 hat keinen Platz dafür. Der Sektor ist Daten, von Anfang bis Ende, und das ist genau der Sinn, ihn zu wählen.
Ein Controller, der Metadaten innen drin will, hat also drei Möglichkeiten, und keine ist kostenlos:
- Das Laufwerk abweisen.
- Es zurück auf ein erweitertes Format formatieren und die 4Kn-Arbeit, die du gerade gemacht hast, zunichte machen.
- Seine Metadaten woanders auf dem Laufwerk halten.
Die dritte ist die, bei der Flash dich bestraft. Metadaten, die getrennt von den Daten geschrieben werden, die sie beschreiben, sind ein zweiter Schreibvorgang, an einem anderen Versatz, in einer anderen Abbildungseinheit. Eine weitere programmierte NAND-Seite für jede, die du wirklich schreiben wolltest. Das ist die Verstärkung aus dem Abschnitt oben, absichtlich wieder eingeführt, um Integritäts-Metadaten zu tragen, die das Laufwerk für nichts innen hätte halten können, wenn du es in einem erweiterten Format gelassen hättest.
Du kannst nicht beides haben. Entweder trägt der Sektor die Metadaten des Controllers, oder er trägt nur deine Daten.
Weshalb Flash die Argumente für Hardware-RAID ziemlich untergraben hat
Der Rest davon ist Ermessen und kein Mechanismus, nimm es also so.
Ein Hardware-RAID-Controller ist Firmware-RAID auf einem eigenen Prozessor. Die „Hardware“ ist eine CPU, etwas DRAM und eine Batterie. Keine grundlegend andere Art, Parität zu rechnen. Was er dir früher gebracht hat, war ein batteriegestützter Schreibcache und das Auslagern der Paritätsrechnung, und auf Flash sind beide Argumente stark geschwächt. NVMe für Unternehmen hat schon einen eigenen Cache mit Schutz bei Stromverlust, und der Controller wird zur Bandbreitendecke vor Geräten, von denen jedes mehrere Gigabyte pro Sekunde sättigen kann.
Er kostet dich außerdem Dinge, die du jetzt aktiv willst:
- Der Zustand der Geräte verschwindet. SMART-Einzelheiten, Verschleißanzeigen und die Herstellerprotokolle, mit denen du die Schreibverstärkung ausrechnen kannst, liegen alle hinter einer undurchsichtigen Abstraktion.
- Keine Prüfsummen von Ende zu Ende. Ein Controller prüft Parität, und das erkennt ein fehlendes Laufwerk, nicht eine falsche Antwort eines vorhandenen. ZFS und Ceph bilden Prüfsummen über die Daten selbst und können dir sagen, welche Kopie falsch ist — stille Verfälschung, die ein Controller direkt durchlässt. Damit löst der Controller das falsche Problem.
- Hersteller-Metadaten auf den Laufwerken binden das Array an eine Controller-Familie, und das ist seine eigene Art Unzuverlässigkeit, wenn der Controller das ist, was ausfällt.
- Paritäts-RAID macht seinen eigenen Read-Modify-Write bei Schreibvorgängen über Teilstreifen, obendrauf auf alles in den Abschnitten oben.
Für Ceph ist das nicht einmal eine Vorliebe. Proxmox’ eigene Empfehlung für hyperkonvergente Aufbauten ist, dass Platten im HBA- oder Durchreichmodus zu zeigen sind, nicht hinter einem RAID-Controller, und ZFS will aus denselben Gründen genau dasselbe.
Die Anordnung, die aus all dem folgt, ist also: ein HBA statt eines RAID-Controllers, Laufwerke auf 4Kn mit null Metadaten formatiert, und Redundanz plus Prüfsummen von ZFS oder Ceph erledigt, die dir wirklich sagen können, wenn ein Laufwerk gelogen hat. Braucht etwas in deinem Bestand wirklich ein erweitertes Sektorformat, ist das ein bewusstes Entweder-oder, das zu klären ist, während die Laufwerke noch leer sind. Nicht etwas, das man entdeckt, nachdem die OSDs gebaut sind.
Wo 512e tatsächlich beißt
Es wäre unehrlich zu behaupten, 512e ruiniere ein modernes System, denn meist tut es das nicht.
Ein aktueller Linux-Stapel liest die physische Sektorgröße, richtet Partitionen daran aus — parted und sfdisk tun das inzwischen beide von allein — und nutzt Dateisystemblöcke von 4 K.
In dieser Aufstellung schickt der Host an 4 K ausgerichtetes 4-K-IO, das Laufwerk braucht nie einen Read-Modify-Write, und 512e kostet dich nahezu nichts.
Die Probleme sind bestimmte:
- Fehlausgerichtete Partitionen, meist aus einer alten Installation oder einem geklonten Abbild geerbt. Zwei Read-Modify-Writes bei jedem Schreibvorgang.
- ZFS mit
ashift=9auf einem 512e-Laufwerk, weil ZFS den gemeldeten 512 geglaubt hat. Jeder Datensatz-Schreibvorgang wird zu einem Read-Modify-Write, und du kannstashiftnachträglich nicht ändern — der Pool muss neu gebaut werden. - Anwendungen, die Datensätze von 512 Byte schreiben mit O_DIRECT und dabei das Zusammenführen des Page-Cache umgehen. Manche Datenbanken und viel eigene Software tun das.
- Alles, was der logischen Größe traut, die echte zu sein. Das ist der eigentliche Schaden der Emulation: sie gibt eine Zahl heraus, die falsch ist, und Dinge weiter unten entscheiden damit.
4Kn nimmt die ganze Kategorie weg. Das Laufwerk kann nicht über eine Sektorgröße lügen, die es nicht hat.
Es lohnt sich aber, über die Größe des Preises geradeheraus zu sein. Seagates eigene Empfehlung ist, dass 4Kn klar der Mühe wert ist, wenn der Stapel vollständig auf 4 K optimiert ist und du jede IOPS zählst — eine getunte Ebene komplett auf Flash etwa. Darunter, auf einem richtig ausgerichteten modernen Linux, ist der Leistungsunterschied bei ausgerichtetem IO oft klein. Das andere Argument ist Gleichmäßigkeit im Bestand: ein durchgehend 4Kn-Bestand hat keine Überraschungen mit gemischten Formaten, und niemand muss sich merken, welche Laufwerke lügen.
Die meisten Laufwerke lassen sich umstellen — wenn der Hersteller es zulässt
Das ist der Teil, der übersehen wird: 512e ist oft eine Formateinstellung und keine Eigenschaft der Hardware. Sehr viele SAS- und SATA-Laufwerke für Unternehmen und die meisten NVMe für Unternehmen kommen mit gemeldeten 512 Byte und lassen sich bereitwillig auf 4Kn umformatieren.
Alles Folgende vernichtet jedes Byte auf dem Gerät. Es gibt keine Umstellung an ihrem Platz.
NVMe — nvme-cli
Sieh zuerst nach, was der Namespace kann:
# Lists each LBA format and marks which one is in use
nvme id-ns -H /dev/nvme0n1 | grep -i "lbaf\|data size"
Du willst ein Format mit Data Size 4096 und Metadata Size 0, als bestes markiert und derzeit nicht in Gebrauch. Dann wende es an:
# -l/--lbaf selects the LBA format index from the list above
nvme format /dev/nvme0n1 --lbaf=1 --force
Die Größe der Metadaten zählt genauso wie die der Daten. Manche Werksformate halten zusätzliche Byte pro Sektor frei — 520 oder 4160 —, um Schutz-Metadaten nach T10-PI/DIF von Ende zu Ende zu tragen. Verbraucht nichts in deinem Stapel das, ist es Füllmaterial auf jedem Sektor, wähle also das Format ohne Metadaten und werde es los. Versehentlich ein Format mit Metadaten zu wählen gibt dir außerdem ein Laufwerk, das sich anders verhält als das, das du erzeugen wolltest, und eine Änderung der Sektorgröße mit einer Änderung an PI zu verbinden kann eine langsame vollständige Formatierung erzwingen statt einer schnellen.
Für die Laufwerke eines ganzen Hosts nimm eine Schleife. Sie braucht shopt -s extglob für die erweiterten Globs und wählt nur Formate, die 4096/0 sind und nicht in Gebrauch:
shopt -s extglob

for dev in /dev/nvme+([0-9])n+([0-9]); do
    # Skip anything that is not actually there
    [ -e "$dev" ] || continue

    # An LBA format with 4096-byte data, 0-byte metadata, marked Best, not in use
    lbaf=$(nvme id-ns -H "$dev" \
        | grep -P '(?=.*Metadata Size: 0)(?=.*Data Size: 4096)(?=.*Best)(?!.*in use)' \
        | awk '{found=$3} END {print (found != "" ? found : -1)}')

    if [ "$lbaf" != "-1" ]; then
        echo "Formatting $dev using LBA Format: $lbaf"
        nvme format --force --lbaf="$lbaf" "$dev"
    else
        echo "Skipping $dev: no matching LBA format found."
    fi
done
Zwei Dinge darin leisten mehr, als sie aussehen.
Das Glob greift Namespaces — nvme0n1, nvme12n3 — und greift bewusst keine Partitionen wie nvme0n1p1, denn das Muster endet nach den Ziffern hinter dem n. Das ist der Unterschied zwischen einen Namespace neu zu formatieren und mit einem laufenden System etwas Unwiederbringliches zu tun.
Und die Auswahl stellt nur ein Laufwerk um, das wirklich anbietet, was du verlangt hast. Alles andere fällt auf -1 durch und wird übersprungen, und das deckt drei getrennte Fälle ab:
- Das Laufwerk bietet nur 512. Es existiert kein Format mit 4096 Byte, es gibt also nichts, worauf umzustellen wäre, und die Schleife lässt es in Ruhe. Sie versucht es nicht, und sie scheitert nicht auf halbem Weg.
- Das Laufwerk ist schon 4Kn. Das Format 4096/0 ist das in Gebrauch, und
(?!.*in use)schließt es aus — ein zweiter Durchlauf über denselben Host tut also nichts. Kein sinnloses Neuformatieren jedes Laufwerks. - Die einzigen 4096-Formate tragen Metadaten. Ein Format 4096 + 8 erfüllt
Metadata Size: 0nicht, die Schleife wird dir also nicht still ein T10-PI-Laufwerk geben, das du nicht wolltest.
Anders gesagt: sie scheitert geschlossen. Wenn sie unsicher ist, überspringt sie.
Eine Anmerkung zur Portabilität: diese Lookaheads brauchen den PCRE-Modus -P von GNU grep. Auf einem System, wo grep etwas anderes ist, greift das Muster nichts und jedes Laufwerk wird übersprungen. Ärgerlich, aber es irrt zumindest in die sichere Richtung.
Lies die Schleife trotzdem, bevor du sie laufen lässt.
Wo sie greift, formatiert sie ohne weitere Rückfrage neu. nvme format --force fragt nicht zweimal.
Sie gehört in die Bereitstellung, auf eine Maschine, deren Laufwerke nichts enthalten, nie auf einen Host mit einer lebenden OSD, einem Pool oder einer VM-Platte.
Auf FreeBSD ist das Gegenstück nvmecontrol, wo -f der Formatindex ist:
nvmecontrol format -f 1 nvme0ns1
SAS und SATA — openSeaChest
Seagates openSeaChest läuft auf mehreren Plattformen, ist offener Quelltext und funktioniert auch auf Laufwerken anderer Hersteller.
# Find the handle
openSeaChest_Format --scan

# Ask the drive which sector sizes it will accept
openSeaChest_Format -d /dev/sg1 --showSupportedFormats

# Convert. The confirmation string is deliberately hard to type by accident.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
Diese Bestätigungsformel ist nicht meine Dramatik. Es ist die wörtliche Zeichenkette, die das Werkzeug verlangt, und der Teil „may render the drive inoperable“, das Laufwerk unbrauchbar machen, ist echt. Eine Formatierung auf niedriger Ebene, die von einem Stromausfall unterbrochen wird, kann ein Laufwerk hinterlassen, das erst wieder formatiert werden muss, bevor es überhaupt läuft.
Darunter unterscheidet sich der Vorgang je Transport: SAS und SCSI nutzen Format Unit, SATA nutzt Set Sector Configuration Ext — den Weg der schnellen Formatierung — und NVMe nutzt NVM Format. Bei einem SAS-Laufwerk kannst du Format Unit direkt ansteuern, und beachte, dass diese Option die kürzere Bestätigungsformel nimmt:
openSeaChest_Format -d /dev/sg1 --formatUnit 4096 --poll \
    --confirm this-will-erase-data
Zwei verschiedene Optionen, zwei verschiedene Bestätigungsformeln — verdreh sie, und das Werkzeug weigert sich.
Wo das Laufwerk schnelle Formatierung kann, ändert sich die Sektorgröße in Sekunden statt Stunden; das Laufwerk macht seine Integritäts- und Hintergrundarbeit danach, und deine echten Daten darauf zu schreiben verkürzt diese Hintergrundzeit. Eine vollständige Formatierung schreibt von Anfang bis Ende Nullen und kann auf einer großen sich drehenden Platte viele Stunden bis Tage dauern.
openSeaChest_Format -d /dev/sg1 --setSectorSize 4096 --fastFormat \
    --confirm this-will-erase-data-and-may-render-the-drive-inoperable
SCSI — sg_format
Für alles, was SCSI spricht, macht sg3_utils dieselbe Arbeit:
# --size requires --format; expect hours on a large spinning disk
sg_format --format --size=4096 /dev/sdb

# Fast format where the drive supports it — seconds instead of hours
sg_format --format --size=4096 --ffmt=1 /dev/sdb
sg_format gibt dir 15 Sekunden Countdown, bevor es sich festlegt, und --quick überspringt den.
Seine Dokumentation warnt außerdem vor einem bestimmten Fehlerfall, den man kennen sollte: gelingt die Änderung der Blockgröße, aber die Formatierung scheitert danach, kann das Laufwerk in einem Zustand „format corrupt“ landen und braucht eine weitere Formatierung, um sich zu erholen.
Bevor du etwas umstellst
- Prüf den Startweg. Ein 4Kn-Laufwerk als Startgerät braucht UEFI und ein Betriebssystem, das es kann. Modernes Linux ist in Ordnung. Älteres Windows nicht, und manche Hardware-RAID-Controller weisen 4Kn noch komplett ab.
- Mach es, bevor das Laufwerk etwas enthält. Nachträglich heißt: leerräumen, umstellen, zurückspielen.
- Mach eines, dann prüf. Stell ein einzelnes Laufwerk um, bestätige die gemeldeten Größen, dann mach den Rest.
- Rechne mit Stunden auf einer sich drehenden Platte ohne schnelle Formatierung. Fang keine Formatierung auf niedriger Ebene auf einer Maschine an, die du bald zurückbrauchst.
Prüfen, was du hast
# LOG-SEC is what the host addresses, PHY-SEC is what the medium uses
lsblk -o NAME,MODEL,SIZE,LOG-SEC,PHY-SEC

# The same, from sysfs
cat /sys/block/sda/queue/logical_block_size
cat /sys/block/sda/queue/physical_block_size

# SMART states both, and this is the clearest 512e signature there is
smartctl -a /dev/sda | grep -i "sector size"
512 bytes logical, 4096 bytes physical ist ein 512e-Laufwerk.
Übereinstimmende Zahlen heißen nativ — 512n, wenn beide 512 sind, 4Kn, wenn beide 4096 sind.
Und prüf, dass die Partitionen wirklich passen:
parted /dev/sda align-check optimal 1
ZFS, Ceph und virtuelle Platten
ZFS — setz ashift=12 ausdrücklich beim Anlegen eines Pools und verlass dich nicht auf die gemeldete Größe des Laufwerks, denn auf 512e wird es dir 9 sagen und falsch liegen. Es lässt sich später nicht ändern.
Ceph — die minimale Zuweisungsgröße von BlueStore sollte auf Flash 4 KB sein. Modernes Ceph stellt 4096 voreingestellt ein, aber ältere Bauten stellten höher ein — rund 16 KB auf SSD und 64 KB auf HDD —, und das passt schlecht zu RBD-VM-Platten, denn die schicken viele kleine zufällige Schreibvorgänge über 4 KB, und ein 4-KB-Schreibvorgang, der in einer Zuweisungseinheit von 16 oder 64 KB landet, verstärkt sowohl den Schreibvorgang als auch verschwendet den Rest als Füllung. Es liegt fest, wenn die OSD angelegt wird, muss also vor dem Anlegen oder Neubauen gesetzt werden:
ceph config set global bluestore_min_alloc_size_ssd 4096 # new or rebuilt OSDs only
Es gibt ein passendes bluestore_min_alloc_size_hdd. Bestehende OSDs behalten, womit sie gebaut wurden, es zu ändern heißt also, sie neu zu bauen.
Virtuelle Platten — ein Gast sieht, was der Hypervisor zeigt, nicht das darunterliegende Laufwerk, ein 4Kn-Laufwerk unter einer VM gibt dem Gast also weiter Blöcke von 512 Byte, solange du nichts anderes sagst. Den Stapel von Ende zu Ende auf 4 K zu halten heißt, QEMU zu sagen, 4 K zu zeigen, und das ist in Proxmox eine rohe Argumentzeile in /etc/pve/qemu-server/<vmid>.conf:
args: -global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096
Diese Zeile ist es, die QEMU für diese Platten wirklich auf 4Kn zwingt — -global wendet es auf jedes scsi-hd-Gerät der VM an, dem Gast werden also 4096 für logische und physische Blockgröße gesagt, und er partitioniert und richtet entsprechend aus.
Setz die ganze Zeichenkette nicht in Anführungszeichen. Proxmox liest args: mit Text::ParseWords::shellwords, und daher fällt dies:
args: "-global scsi-hd.physical_block_size=4k -global scsi-hd.logical_block_size=4096"
zu einem einzigen Argument zusammen — die Anführungszeichen werden beachtet und entfernt, und QEMU bekommt eine lange unlesbare Option statt vier. Ohne Anführungszeichen teilt sich dieselbe Zeile in -global, scsi-hd.physical_block_size=4k, -global, scsi-hd.logical_block_size=4096, und das willst du. Es ist ein leichter Fehler, denn Anführungszeichen sind auf einer Kommandozeile der richtige Instinkt, und der Fehlerfall — eine VM, die nicht startet und über die Option klagt — zeigt nicht auf die Anführungszeichen zurück.
Mach das vor der Installation des Gast-Betriebssystems. Die Blockgröße einer Platte unter einem schon installierten System zu ändern kann es unstartbar machen, denn Partitionslayout und Bootloader wurden für Sektoren von 512 Byte geschrieben. Beachte außerdem, dass args: eine Notluke für Fachleute außerhalb der Verwaltung durch die GUI ist, und das Zusammenspiel mit Live-Migration und Snapshots ist es wert, gegen die aktuelle Proxmox-Dokumentation nachgeprüft zu werden.
Wenn der Gast 512 sagt und der Host 4 K
Das ist der Fall, den man richtig verstehen sollte, denn das ist, was du standardmäßig bekommst, nachdem du die ganze Arbeit oben gemacht hast.
QEMU zeigt dem Gast logische Blöcke von 512 Byte, solange man nichts anderes sagt, was auch das Gerät darunter ist. Du kannst also jedes Laufwerk im Host auf 4Kn umstellen, und den VMs darauf werden weiterhin 512 gesagt — und sie werden es glauben.
Der Gast partitioniert dann auf Grenzen von 512 Byte, weil er darf, und schickt IO von 512 Byte, weil er darf. Aber das Gerät im Host hat jetzt wirklich einen logischen Block von 4096 Byte, und es nimmt keinen Schreibvorgang über 512 Byte an. Irgendetwas muss die beiden in Einklang bringen, und dieses Etwas ist der Host: QEMU liest die umgebenden 4 KB, mischt die 512 Byte des Gasts ein und schreibt das Ganze zurück.
Du hast die Emulation nicht entfernt. Du hast sie aus der Firmware des Laufwerks in deinen Hypervisor verlegt, wo sie CPU des Hosts und einen Zwischenpuffer kostet statt Zyklen des Laufwerks.
Mit cache=none ist das auch kein sanfter Aufschlag. O_DIRECT gegen ein 4Kn-Gerät verlangt an 4 KB ausgerichtete Versätze und Längen, ein Schreibvorgang des Gasts unter 4 K kann also nicht einfach durchgereicht werden — die Ausrichtung muss in QEMU zurechtgebogen werden, bevor das IO überhaupt abgeschickt wird.
Und der Fall der Fehlausrichtung kommt eine Schicht höher zurück. Ein Gast, der auf Granularität von 512 Byte partitioniert ist, setzt seine 4-KB-Dateisystem-Schreibvorgänge auf Versätze, die über zwei 4-KB-Blöcke des Hosts liegen, jeder davon wird also zu zwei Read-Modify-Writes auf dem Host. Dasselbe Versagen wie eine fehlausgerichtete Partition auf einem nackten 512e-Laufwerk, nur passiert es jetzt in einer VM, wo niemand danach sucht.
Die Regel ist also: ist der Host 4Kn, zeig dem Gast auch 4 K, und tu es, bevor das Betriebssystem darauf kommt.
Die Ausnahme ist die Unterstützung im Gast, und das ist der ganze Grund, warum 512e existiert:
- Linux-Gäste kommen mit 4Kn ohne Aufhebens zurecht.
- Windows unterstützt 4Kn für Datenlaufwerke ab Windows 8 und Server 2012, und von 4Kn zu starten will UEFI.
- Alles Ältere — Windows 7 und davor — kann 4Kn überhaupt nicht. Für die ist eine virtuelle Platte, die 512 zeigt, der Preis, sie zu betreiben, und der Host wird das in Einklang bringen. Wenn das zählt, halte diese Gäste auf Speicher, wo es dich am wenigsten kostet, und nicht auf deiner schnellsten Ebene.
Prüf im Gast, was der Gast tatsächlich bekommen hat:
lsblk -o NAME,LOG-SEC,PHY-SEC
512 dort auf einem 4Kn-Host heißt, dass das Zurechtbiegen von oben bei jedem fehlausgerichteten Schreibvorgang passiert.
Quellen
- OpenZFS — Workload Tuning —
ashift, warum2^ashiftdas kleinstmögliche IO auf einem vdev ist, und die Beobachtung, dass „many devices misreport their sector sizes“, viele Geräte ihre Sektorgrößen also falsch melden nvme-format-Handbuchseite —--lbaf,--namespace-id,--sesund--forcesg_format-Handbuchseite —--sizemit--format, die Option für schnelle Formatierung und die Warnung zu „format corrupt“- openSeaChest — Seagates Laufwerkswerkzeuge in offenem Quelltext, samt
--setSectorSizeund--showSupportedFormats - openSeaChest-Wiki — Format, Fast Format, And Sector Sizes — welcher Transport welchen Befehl nutzt, und wann schnelle Formatierung gilt
nvmecontrol(8)— das Gegenstück auf FreeBSD- Dokumentation der Linux-Block-Schicht — wie der Kernel logische und physische Blockgrößen abbildet