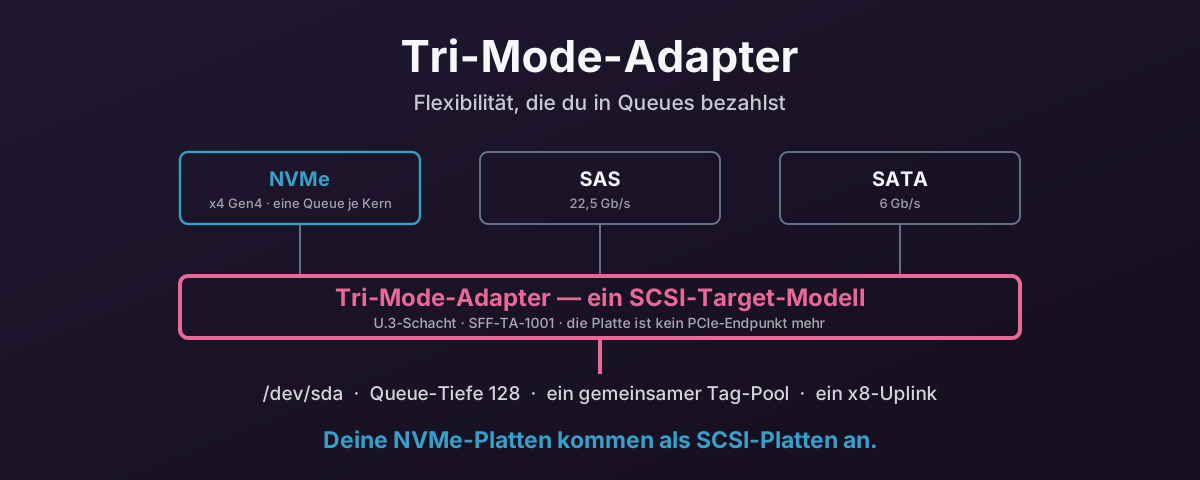
Der Schacht, der alles aufnimmt
Der Verkaufsspruch für einen Tri-Mode-Adapter ist wirklich gut, und man sollte ihn richtig aussprechen, bevor man ihn auseinandernimmt.
Kauf ein Gehäuse mit U.3-Backplane und einem Tri-Mode-Controller, und jeder Laufwerksschacht wird universell. Schacht 0 kann eine 24G-SAS-Platte halten, Schacht 1 ein billiges SATA-Startlaufwerk, Schacht 2 eine Gen4-NVMe-SSD, und der Adapter verhandelt, was auch auftaucht. Broadcom nennt das Silizium Tri-Mode SerDes; der Schachtstandard ist SFF-TA-1001, bekannt als U.3, der einen gemeinsamen Steckverbinder für SAS x1/x2, SATA und NVMe mit x1, x2 oder x4 festlegt. Die Verwaltungsseite ist SFF-TA-1005, Universal Backplane Management, und damit findet das Gehäuse heraus, mit was es eigentlich spricht, und treibt die richtigen Aktivitäts-LEDs.
Für jeden, der Server ausschreibt, löst das ein echtes und ärgerliches Problem. Du musst das Speicherprotokoll nicht länger zum Zeitpunkt der Bestellung festlegen, keine zwei Gehäusevarianten führen und nicht entdecken, dass die NVMe-fähigen Schächte die vier links sind und deine Platten in die anderen zwanzig gewandert sind. Eine Teilenummer deckt den Bestand, und ein SAS-Bestand kann Platte für Platte auf NVMe umziehen statt Gehäuse für Gehäuse.
Nichts davon ist Marketing. Es ist der Grund, warum diese Adapter sich verkaufen, und es wäre albern, etwas anderes zu behaupten.
Aber die Flexibilität ist nicht kostenlos, und die Rechnung wird nicht in Pfund bezahlt. Sie wird in Queues bezahlt.
Was mit der Platte tatsächlich passiert
Eine NVMe-SSD ist ein PCIe-Endpunkt. In einem direkt verbundenen Server laufen ihre vier Lanes zum Root Complex der CPU — über einen Retimer oder einen PCIe-Switch, aber elektrisch und logisch ist sie ein Gerät am PCIe-Bus. Der Kernel zählt sie auf, bindet den nvme-Treiber, und ab da spricht der Treiber direkt mit den Registern der Platte.
Steck dieselbe Platte hinter einen Tri-Mode-Adapter, und das stimmt nicht mehr.
Die Lanes der Platte enden jetzt am Controller. Broadcoms Dokumentation nennt den zuständigen Block die PCIe device bridge, und das Wort Brücke leistet viel Arbeit: das ist kein durchlässiger Switch, der die Transaktionen deiner CPU an eine Platte weitergibt, die sie noch sehen kann. Der Adapter ist der PCIe-Endpunkt, den dein Host aufzählt. Die Platte ist ein Target auf der anderen Seite, und die Firmware des Controllers setzt jedes I/O neu auf.
Der Adapter gibt deine NVMe-Befehle also nicht durch. Er beendet sie und spricht in deinem Namen mit der Platte.
Was die Frage aufwirft, welches Protokoll er mit dir spricht.
Das Betriebssystem sieht nie eine NVMe-Platte
Es spricht SCSI.
Steck eine NVMe-SSD in einen Broadcom-Tri-Mode-HBA, und sie erscheint nicht als /dev/nvme0n1. Sie erscheint als /dev/sdb, gebunden an mpt3sas — denselben Treiber, der seit über einem Jahrzehnt LSI-SAS-Controller fährt. nvme list gibt nichts zurück. lsblk -o NAME,TRAN meldet den Transport als sas. Für jede Schicht des Speicherstapels über dem Treiber hast du eine SAS-Platte gekauft.
Das ist kein Fehler und keine Firmware-Grenze, die auf Behebung wartet. Es ist der Entwurf. Alles als SCSI-Target zu zeigen ist genau wie ein Adapter drei Protokolle bedient: der Controller vereinheitlicht SAS, SATA und NVMe zu einem einzigen Gerätemodell, und der Host bekommt einen Treiber, einen Aufzählungsweg, einen Satz Werkzeuge. Die Flexibilität im Marketing und die SCSI-Darstellung in dmesg sind dieselbe Architekturentscheidung, von beiden Enden angesehen.
Die Generationen 9500 und 9600 bringen einen Passthrough-Mechanismus mit, damit Hersteller-Werkzeuge die NVMe-Admin-Befehle einer Platte erreichen, und Broadcoms neuere Teile sind viel besser darin, Plattengesundheit zu zeigen, als die 9400 war. Aber das ist ein Nebenkanal für die Verwaltung. Der Datenweg — jedes Lesen und Schreiben, das deine Last absetzt — läuft weiter den SCSI-Stapel hinunter.
Und der SCSI-Stapel hat ein Queue-Modell, das Flash um zwanzig Jahre vorausgeht.
Das Queue-Modell, das du gerade aufgegeben hast
Das ist der Teil, der dich tatsächlich Leistung kostet, und es ist wert, genau zu sein, denn „NVMe ist schneller als SAS“ ist nicht der Grund.
Die zentrale Entwurfsentscheidung von NVMe war keine schnellere Leitung. Sie war, nicht mehr vorzugeben, dass ein Speichergerät ein einzelnes serialisiertes Ding ist.
Die Spezifikation erlaubt bis zu 65.535 I/O-Queue-Paare, und diese Zahl wird in jeder NVMe-Erklärung zitiert. Es ist die falsche Zahl, nach der man greift. Keine Platte setzt annähernd so viele um, jeder, der ein laufendes System tatsächlich angesehen hat, kann den Vergleich also wegwischen — und er hätte recht damit. Die echte Zahl ist kleiner, unspektakulär, und macht den Punkt besser.
Also hier eine echte Platte. Kein Unternehmensteil: eine SK-Hynix-OEM-SSD mit 256 GB, die Art, die in einem Mittelklasse-Laptop verlötet ist, in einer Maschine mit 16 Kernen.
$ nproc
16
$ cat /sys/class/nvme/nvme0/queue_count
17
$ ls /sys/block/nvme0n1/mq | wc -l
16
$ cat /sys/block/nvme0n1/queue/nr_requests
1023
Siebzehn Queues: eine Admin-Queue und sechzehn I/O-Queues für sechzehn Kerne. Jede 1023 Befehle tief. Die Zuordnung ist eins zu eins — jede Hardware-Queue ist an genau eine CPU gebunden:
$ cd /sys/block/nvme0n1/mq && grep -H . */cpu_list
0/cpu_list:1
1/cpu_list:9
2/cpu_list:3
3/cpu_list:11
...
Eine CPU je Queue, ganz durch — Hardware-Queue 0 bedient Kern 1 und nichts sonst.
Das ist es, was „NVMe hat viele Queues“ in der Praxis tatsächlich heißt. Nicht 65.535 — eine je Kern, wie viele Kerne du auch hast. Linux legt ein Queue-Paar je CPU an, bis zu dem, was der Controller gewährt, und Controller gewähren weit mehr, als ein typischer Server Kerne hat, in der Praxis ist die Kernzahl also die Zahl. Steck diese Platte in eine Kiste mit 64 Kernen, und du bekommst 64.
Diese Aufteilung je Kern ist, woher die Leistung kommt:
- Ein Kern reicht in seine eigene Queue ein. Keine Sperre, denn kein anderer Kern fasst sie an.
- Jede Queue bekommt ihren eigenen MSI-X-Vektor, an diesen Kern gebunden.
- Der Abschluss-Interrupt landet zurück auf dem Kern, der das I/O abgesetzt hat, wo die zugehörigen Cache-Zeilen schon liegen.
- Alle sechzehn Kerne können gleichzeitig unterwegs sein, ohne je um eine gemeinsame Struktur zu streiten.
Die Parallelität wächst mit deiner Kernzahl, und die Arbeit keines Kerns steht je hinter der eines anderen in der Schlange. Eine billige Consumer-Platte macht das. Es ist das Mindeste.
Sieh jetzt an, was die Platte hinter dem Adapter bekommt. Die Zahlen unten sind keine Schätzungen — sie sind Konstanten im mpt3sas-Treiber im Mainline.
Die Queue-Tiefe je Gerät wird aus ioc->max_nvme_qd gesetzt, was der Treiber von dem nimmt, was die Controller-Firmware meldet, und sonst auf eine Voreinstellung zur Kompilierzeit in drivers/scsi/mpt3sas/mpt3sas_base.h zurückfällt:
#define MPT3SAS_SATA_QUEUE_DEPTH	32
#define MPT3SAS_SAS_QUEUE_DEPTH		254
#define MPT3SAS_RAID_QUEUE_DEPTH	128
#define MPT3SAS_NVME_QUEUE_DEPTH	128
128. Ein Gerät, das Zehntausende offene Befehle kann, bekommt eine Queue-Tiefe von 128 — und beachte, dass sie flacher ist als die SAS-Voreinstellung von 254 zwei Zeilen darüber. Die eigenen Fähigkeiten der Platte gehen in die Entscheidung nie ein. Die Zahl kommt vom Controller.
Die Zahl der Hardware-Queues ist schlimmer, und der Treiber ist offen darüber. Aus mpt3sas_scsih.c:
shost->nr_hw_queues = 1;

if (shost->host_tagset) {
	shost->nr_hw_queues =
	    ioc->reply_queue_count - ioc->high_iops_queues;
	...
	dev_info(&ioc->pdev->dev,
	    "Max SCSIIO MPT commands: %d shared with nr_hw_queues = %d\n",
	    shost->can_queue, shost->nr_hw_queues);
}
Lies das genau, denn drei getrennte Dinge passieren hier.
Die Voreinstellung ist eine Hardware-Queue. nr_hw_queues = 1. Multi-Queue passiert nur auf gen35-Controllern mit eingeschalteter host_tagset-Funktion, und selbst dann ist es, was die Commit-Geschichte des Treibers selbst als simulierte mehrere Hardware-Queues beschreibt — die Hardware des I/O-Controllers ist eine einzige Submission-Queue mit mehreren Reply-Queues, und blk-mq wird darüber gepasst.
Die Zahl der Queues kommt vom Controller, nicht von der Kernzahl. Sie ist reply_queue_count minus die High-IOPS-Queues — die MSI-X-Vektorzuteilung des Adapters. Sie hat nichts damit zu tun, wie viele CPUs du hast, und sie wächst nicht, wenn du Platten hinzufügst. Das ist die genaue Umkehrung der Platte oben, wo die Zahl der Queues die Kernzahl war.
Und der Tag-Pool ist geteilt. host_tagset heißt genau, was es sagt: ein Tag-Pool für den ganzen Host-Adapter, und diese Protokollzeile sagt „shared“ laut heraus. Jede Platte an der Karte zieht aus demselben Satz Befehlsplätze. Ein Gehäuse mit vierundzwanzig Schächten hat vierundzwanzig Platten, die um die Tags eines Controllers streiten.
Stell die zwei nebeneinander. Diese Laptop-SSD hatte sechzehn eigene Queues von 1023, eine je Kern, die nur ihr selbst antwortete. Dieselbe Platte hinter dem Adapter bekommt einen Anteil an den Reply-Queues der Karte, 128 offene Befehle und dreiundzwanzig Nachbarn, die aus demselben Pool ziehen.
Der Verlust ist also nicht, dass SCSI langsam ist. Modernes SCSI auf blk-mq ist in Ordnung. Der Verlust ist strukturell:
- Queues gehören dem Adapter, nicht der Platte. Platten hinzuzufügen teilt eine feste Ressource statt sie zu vermehren.
- Der Tag-Pool ist über den ganzen Host geteilt. Eine Platte unter schwerer Last kann die anderen aushungern, und zwar auf eine Weise, die einfach nicht passieren kann, wenn jede Platte ihre eigenen Queues hat.
- Die Tiefe je Gerät ist bei 128 gedeckelt, egal was die Platte durchhalten kann.
- Die Interrupt-Nähe ist geschwächt. Abschlüsse kommen auf der Reply-Queue an, die der Controller genutzt hat, nicht unbedingt auf dem Kern, der eingereicht hat.
Bei einer Queue-Tiefe von 1 oder 2 — ein einzelner Prozess, der gelegentlich liest — merkt man nichts davon. Du wirst so oder so dieselbe Latenz messen, im Rauschen. Der Preis erscheint genau dort, wo du NVMe gekauft hast, um zu helfen: viele Kerne, die viele gleichzeitige I/Os absetzen. Je tiefer die Last, desto mehr von der Platte hast du bezahlt und kannst sie nicht erreichen.
Der Uplink ist ein x8-Steckplatz
Das Queue-Modell ist das feine Problem. Die Bandbreitendecke ist das offensichtliche, und du kannst sie aus Broadcoms eigenen Produktblättern ablesen, ohne einen Benchmark zu brauchen.
Der HBA der 9500-Reihe ist eine x8-PCIe-Gen-4.0-Karte. Broadcoms veröffentlichte Zahlen dafür sind 13.700 MB/s bei sequentiellem Lesen mit 256K und 3 Mio. IOPS bei zufälligem Lesen mit 4K. Dasselbe Blatt sagt, sie unterstütze bis zu 32 NVMe-Geräte.
Stell die zwei Zahlen nebeneinander, und die Frage beantwortet sich selbst: wie viele Platten braucht es, bis der Adapter ausgeht?
Nicht viele, und jedes Jahr weniger. Eine Gen4-x4-SSD macht etwa 7 GB/s. Eine Gen5-x4-SSD macht etwa 14. Beides sind 2026 gewöhnliche Teile — Gen4 ist, wovon der Gebrauchtmarkt für U.2 voll ist, und Gen5 ist, was du neu bekommst.
| Decke | Gen4-Platten, um sie zu erreichen | Gen5-Platten, um sie zu erreichen |
|---|---|---|
| HBA 9500 — 13.700 MB/s sequentiell | 2 | 1 |
| HBA 9500 — 3 Mio. IOPS (4K zufällig lesen) | 3 | 1–2 |
| eHBA 9600 — 6,4 Mio. IOPS (4K zufällig lesen) | etwa 6 | etwa 3 |
| MegaRAID 9600 — 1,1 Mio. RAID-5-IOPS (4K zufällig schreiben) | etwa 1 | etwa 1 |
Lies die erste Zeile noch einmal. Eine einzelne Gen5-SSD erreicht die ganze sequentielle Decke eines HBA 9500. Eine Platte, in einer Karte, die für zweiunddreißig ausgelegt ist. Alles danach ist Kapazität. Nicht Leistung.
Und die letzte Zeile ist die, die eine Bestellung anhalten sollte: auf dem MegaRAID der aktuellen Generation liefert ein voll bestücktes Regal NVMe in RAID 5 etwa das, was eine gängige Platte allein macht.
Die Platten verbinden sich nicht einmal mit x4
Es gibt eine zweite Bremse unter dem gemeinsamen Uplink, leicht zu übersehen, weil sie in einer Datentabelle sitzt und nicht in einer Schlagzeile.
Dells Handbuch zum PERC 12, das die H965i-Tri-Mode-Controller abdeckt, sagt:
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3) and 16 GT/s (Gen 4) at maximum x2 lane width.
Jede NVMe-Platte bekommt zwei Lanes, nicht vier. Vor jedem Streit um den Uplink, vor dem Tag-Pool, vor der SCSI-Übersetzung ist eine Gen4-Platte also schon auf etwa 3,5 GB/s herunter — die Hälfte von dem, was sie kann. Steck eine Gen5-Platte in diesen Schacht, und sie verhandelt auf Gen4 x2 herunter und liefert etwa ein Viertel ihrer angegebenen Bandbreite.
Es ist wert, genau zu sein, was das ändert und was nicht. Es heißt nicht, dass der Adapter weiter reicht. Es braucht etwa vier auf x2 begrenzte Platten, um den Uplink der 9500 zu füllen, statt zwei, aber nur weil jede Platte halb so viel beiträgt. Der Engpass ist vom Uplink herunter zur Plattenverbindung gewandert. Was du insgesamt herausholen kannst, ist nicht besser geworden.
Direkt verbunden hätten dieselben zweiunddreißig Platten jede ihren eigenen x4-Weg zum Root Complex, mit der Generation, die Platte und CPU verhandeln können.
Die RAID-5-Zeile in dieser Tabelle verdient ihren eigenen Blick, denn es ist Broadcoms eigene Zahl, und sie ist ohne Beschönigung veröffentlicht. Aus dem Blatt zur 9600-Reihe:
900K to 1.1M RAID 5 IOPS (4K RW)
Paritäts-RAID in der Controller-Firmware ist das Teuerste, was man von einer Tri-Mode-Karte verlangen kann, und das ist die aktuelle Generation dabei. Zu lesen wert, bevor jemand RAID 5 über vierundzwanzig NVMe-Platten ausschreibt und die Leistung von vierundzwanzig Platten erwartet.
Und eine x16-Karte?
Der naheliegende Einwand gegen alles oben ist, dass die 9500 eine x8-Gen4-Karte ist und die Decke ein Artefakt einer schmalen Host-Verbindung. Gib dem Adapter sechzehn Lanes Gen5, und das Problem verschwindet.
Das ist ein fairer Einwand, und er verdient das stärkste Beispiel statt eines Strohmanns. Nimm also Dells PERC13 H975i — die aktuelle Generation, und etwa so gut, wie Tri-Mode wird. Ihr Handbuch gibt „Gen 4 and Gen 5 PCIe x16 host interfaces“ an, und StorageReview hat gemessen: 52,5 GB/s und 12,5 Mio. IOPS je Controller, gegen bis zu sechzehn NVMe-Platten.
Das sind ernste Zahlen, und sie ändern das Bild deutlich. Gegen die 13.700 MB/s und 3 Mio. IOPS der 9500 ist das etwa die vierfache Bandbreite und die vierfachen IOPS, über halb so viele Platten verteilt. Dell hat nicht bloß das Rohr verbreitert — sie haben auch die Verzweigung halbiert, und das Verhältnis der Überbuchung ist dadurch besser geworden. Besonders bei IOPS sind 12,5 Mio. über sechzehn Platten etwa 780K je Platte, und das kommt an das heran, was eine gängige Platte allein liefert. An diesem Punkt ist der Controller tatsächlich nicht das, was dich aufhält.
Alle Ehre also, wo sie hingehört: eine moderne x16-Gen5-Tri-Mode-Karte ist ein viel besseres Stück Technik als eine x8-Gen4, und war Bandbreite dein einziger Einwand, beantwortet x16 ihn weitgehend.
Drei Dinge behebt sie nicht.
Die Platten verbinden sich weiter mit x2. Das ist das, was mich überrascht hat. Das PERC13-Handbuch, das einen Gen5-x16-Controller beschreibt, sagt weiterhin:
Supports drive speeds for NVMe drives are 8 GT/s (Gen 3), 16 GT/s (Gen 4), and 32 GT/s (Gen 5) at maximum x2 lane width.
Eine breitere Host-Verbindung verbreitert die Plattenverbindungen dahinter nicht. Jede NVMe-Platte am neuesten, schnellsten Tri-Mode-RAID-Controller, den Dell verkauft, ist weiterhin mit zwei Lanes statt vier verbunden und gibt weiterhin die Hälfte ihrer Bandbreite auf, bevor irgendetwas anderes passiert.
Das Queue-Modell bleibt völlig unberührt. Nichts im Queue-Abschnitt dieses Beitrags hängt von der Breite der Host-Verbindung ab. nr_hw_queues kommt aus der MSI-X-Reply-Queue-Zuteilung des Controllers; die Tiefe von 128 je Gerät ist eine Treiber- und Firmware-Konstante; der Tag-Pool ist über den ganzen Host geteilt, weil host_tagset das sagt. Verbreitere die Host-Verbindung auf x16, x32, was du willst — die Platten sind weiter SCSI-Targets, die sich die Queues der Karte teilen, es gibt weiter kein /dev/nvme0n1, und du kannst weiter keine Platte an eine VM durchreichen.
Und x16 stellt keine Bandbreite her — es verzweigt Lanes, die du schon hattest. Das ist das Argument, das die Sache tatsächlich entscheidet. Sechzehn Gen5-Lanes in eine PERC13 kaufen dir 52,5 GB/s, geteilt über sechzehn Schächte. Dieselben sechzehn Lanes direkt an vier Gen5-Platten mit x4 verdrahtet kaufen dir etwa 56 GB/s über vier Schächte — dieselbe Bandbreite aus denselben Lanes, nur dass jede Platte ihre vollen x4 bekommt, ihr eigenes Queue-Paar je Kern und einen echten nvme-Geräteknoten.
Die ehrliche Beschreibung einer x16-Tri-Mode-Karte ist also nicht „ein schnellerer Adapter“. Sie ist ein Lane-Multiplexer: sie wandelt ein festes Lane-Budget in mehr Laufwerksschächte um und stellt dir das Queue-Modell für die Umwandlung in Rechnung. Ob der Handel gut ist, hängt von einer Sache ab. Schächte oder Parallelität.
Was passiert, wenn du alle Schächte füllst
Was zu dem Fall führt, auf den es tatsächlich ankommt, denn niemand kauft ein Gehäuse mit 24 Schächten, um vier Platten hineinzustecken.
Jenseits des Sättigungspunkts ist die Summenlinie flach. Platten hinzuzufügen fügt Kapazität hinzu, und nichts weiter — die Leistung je Platte fällt also mit 1/N. Diese Rechnung ist bei realistischen Bestückungen unbarmherzig:
| Platten an einem HBA 9500 | Summe | Je Platte | Anteil einer Gen4-Platte |
|---|---|---|---|
| 2 | 13,7 GB/s | 6,9 GB/s | 98 % |
| 12 | 13,7 GB/s | 1,14 GB/s | 16 % |
| 24 | 13,7 GB/s | 0,57 GB/s | 8 % |
Sieh die letzte Zeile an. Vierundzwanzig NVMe-Platten hinter einem HBA 9500 liefern etwa 570 MB/s jede. Eine SATA-SSD macht rund 550. Du hast vierundzwanzig NVMe-Platten gekauft, für einen Tri-Mode-Controller bezahlt, um sie anzuschließen, und bist bei Bandbreite je Platte in SATA-Klasse angekommen.
Die IOPS-Rechnung hat dieselbe Form: 3 Mio. über vierundzwanzig Platten verteilt sind 125K je Platte, gegen die 1 Mio., die eine gängige Gen4-Platte allein schafft — etwa ein Achtel von dem, was dir gehört.
Die x16-Karte verbessert das deutlich, entkommt ihm aber nicht. Eine PERC13 mit ihren vollen sechzehn Platten sind 52,5 GB/s ÷ 16 = 3,3 GB/s je Platte, oder etwa 23 % einer Gen5-Platte — und das vor der x2-Verbindung, die es noch einmal halbiert.
Zwei Wirkungen bei hohen Plattenzahlen sind schlimmer, als die Teilung vermuten lässt:
- Tag-Hunger geht über Geräte hinweg. Der gemeinsame Host-Tag-Pool heißt, dass eine einzelne Platte unter schwerer Last Plätze verbrauchen kann, die andere Platten brauchen. Vierundzwanzig Geräte, jedes nominell mit 128 offenen Befehlen erlaubt, wollen 3.072 zwischen sich, gezogen aus dem
can_queueeines Controllers. Head-of-Line-Blocking zwischen getrennten Platten ist ein Fehlerfall, der einfach nicht existiert, wenn jede Platte ihre Queues besitzt. - Wiederaufbauten treffen alles. Ein Paritäts-Wiederaufbau über ein bestücktes Regal sättigt den einen gemeinsamen Uplink, das Vordergrund-I/O zu jeder anderen Platte an der Karte verschlechtert sich also gleichzeitig. Mit Platten auf eigenen Lanes und Software-RAID streitet der Wiederaufbau um CPU, nicht um ein einzelnes Rohr.
Wann nichts davon zählt
Es gibt ein wichtiges Gegengewicht, und es ist der Grund, warum reichlich Tri-Mode-Server mit 24 Schächten völlig zufrieden laufen.
Die Adapterdecke beißt nur, wenn etwas dahinter mehr aufnehmen kann, als sie liefert. Ein Server mit 2 × 25 GbE hat 6,2 GB/s Netz — er kann selbst einen HBA 9500 nicht füllen. Sind diese vierundzwanzig Platten eine Kapazitätsebene, die Dateien über diese Verbindung liefert, ist der Adapter nirgends in der Nähe des Engpasses, und die Rechnung je Platte oben ist ohne Belang.
Der Moment, in dem es anfängt zu zählen, ist, wenn der Verbraucher schneller wird als die Karte: 100 GbE (12,5 GB/s) bringt dich allein auf die Höhe der ganzen sequentiellen Decke einer 9500, und lokale Lasten — Datenbanken, Kompilieren, Analytik, Virtualisierungs-Hosts mit beschäftigten Gästen — haben überhaupt kein Netz im Weg.
Die Frage zu einem bestückten Regal ist also nicht „ist der Adapter langsam“, sondern „was wird das aufnehmen, und kann es mehr aufnehmen, als die Karte liefern kann?“ Ist die Antwort eine 25-GbE-Verbindung, hör auf, dir Sorgen zu machen. Ist die Antwort 100 GbE, NVMe-oF oder eine lokale Datenbank, ist die Karte dein Engpass, und die Plattenzahl macht es schlimmer.
Was sonst noch verloren geht
Über den Durchsatz hinaus heißt eine NVMe-Platte als SCSI-Platte zu zeigen, dass die NVMe-eigenen Teile deines Werkzeugkastens aufhören zu funktionieren:
| Direkt verbunden | Hinter einem Tri-Mode-Adapter | |
|---|---|---|
| Geräteknoten | /dev/nvme0n1 | /dev/sdb |
| Treiber | nvme | mpt3sas / mpi3mr |
nvme-cli | Läuft | Nichts, mit dem es sprechen kann |
| Gesundheitsdaten | NVMe-SMART-Log-Seiten | Übersetzte SCSI-Log-Seiten |
| Namespace-Verwaltung | Ja | Nein |
| Firmware-Aktualisierungen | nvme fw-download | Hersteller-Werkzeug über den Controller |
| Format / Sanitize | NVMe Format NVM | SCSI-Entsprechungen, wenn umgesetzt |
| Hardware-Queues | Ein Paar je Kern (16 auf der Maschine oben) | Die Reply-Queues der Karte, von jeder Platte geteilt |
| Queue-Tiefe | 1023 je Queue | 128 je Gerät |
Eine Folge erwischt Leute oft genug, um sie gesondert zu nennen: du kannst eine einzelne Platte nicht an eine virtuelle Maschine durchreichen. PCIe-Passthrough braucht, dass die Platte ein PCIe-Endpunkt mit eigener IOMMU-Gruppe ist, und hinter einem Tri-Mode-Adapter ist sie das nicht — das einzige PCIe-Gerät, das da ist, ist der Controller. Du kannst den ganzen Adapter durchreichen, mit jeder Platte daran, oder nichts. Sah dein Plan vor, bestimmte NVMe-Platten an bestimmte Gäste zu geben, hat die Backplane-Entscheidung diese Frage schon für dich beantwortet.
Wer will das also 2026 tatsächlich?
Hier muss der Verkaufsspruch vom Anfang dieses Beitrags einer härteren Frage begegnen, denn die Welt, für die er entworfen wurde, ist größtenteils verschwunden.
Tri-Mode wurde ersonnen, als NVMe die teure Ebene war, die man einem SAS-Bestand hinzufügte. 2026 ist das umgekehrt: NVMe ist die Voreinstellung, U.2-Unternehmensplatten sind auf dem Gebrauchtmarkt reichlich und billig, und „SAS, SATA und NVMe gemischt in einem Gehäuse“ beschreibt immer weniger echte Installationen. Wer kauft es also?
Meist niemand — absichtlich. Die ehrliche Antwort ist, dass die meisten Tri-Mode-Controller nicht gewählt wurden. Sie kamen an, weil der Serverhersteller einen ausliefert, und der Hersteller liefert einen aus, weil eine einzige U.3-Backplane-Variante ihm erlaubt, SAS-, SATA- und NVMe-Konfigurationen aus demselben Gehäuse zu verkaufen. Das ist ein Gewinn in der Lieferkette für den OEM. Für deine Leistung tut es nichts, und es wurde auch nie so verkauft.
Drei der klassischen Begründungen halten nicht mehr gut:
„Ich brauche gemischte Plattentypen.“ Selten im selben Gehäuse, und selbst wenn, ist Tri-Mode nicht der einzige Weg. Ein einfacher SAS-HBA für die sich drehenden Platten plus NVMe an den Root Complex verdrahtet gibt dir beides, ohne dass eines bestraft wird. Gemischter Bestand heißt nicht gemischter Controller.
„Ich habe nicht genug PCIe-Lanes.“ Das war 2019 das echte Argument, auf Plattformen mit 40 Lanes und 24 Schächten. Ein Genoa- oder Turin-Epyc mit einem Sockel hat 128 Lanes. Vierundzwanzig Platten mit x4 sind 96. Die Knappheit, die es rechtfertigte, Platten hinter einem Controller zu bündeln, ist so gut wie weg, und wo sie es nicht ist, erledigt ein PCIe-Switch die Aufgabe, ohne das Protokoll zu beenden.
„Die Schächte müssen universell sein.“ Das ist es wert, sorgfältig getrennt zu werden, denn es ist das Argument, mit dem am häufigsten das falsche Bauteil gerechtfertigt wird. U.3 ist ein Backplane-Standard, keine Controller-Anforderung. Eine U.3-Backplane kann direkt an die PCIe-Lanes der CPU verkabelt werden statt durch einen Tri-Mode-Controller, und Hersteller dokumentieren beide Topologien. Du kannst die universellen Schächte behalten und die Steuer löschen. Hast du einen Tri-Mode-Server geerbt, ist das Wertvollste, was du prüfen kannst, ob die Backplane direkt neu verkabelt werden kann.
Was tatsächlich übrig bleibt:
- Hardware-RAID bei Dichte, wo Vorschrift oder Plattform es verlangt — eine Prüfanforderung, eine Support-Matrix, eine Windows- oder ESXi-Installation ohne Softwareschicht, die die Aufgabe erledigt. Das ist der echte verbleibende Markt, es ist der eine Fall, in dem du das RAID-Werk kaufst und nicht die Anbindung, und auf heutigem Silizium ist es ein taugliches Produkt: sechzehn NVMe-Platten in Hardware-RAID 5 mit einem durch Supercap geschützten Cache, aus sechzehn Lanes, ist etwas, das Direktanbindung überhaupt nicht anbieten kann.
- Massenkapazität mit SAS-HDDs, wo £/TB noch entschieden den sich drehenden Platten gehört. Aber das ist die Aufgabe eines einfachen SAS-HBA, und eines billigeren.
- Sehr hohe Schachtzahlen und externe Gehäuse, wo SAS-Expander weiter und breiter reichen, als PCIe es wird.
- Lasten, die nie tief gehen. Sitzen deine Queue-Tiefen im einstelligen Bereich, merkt man nichts davon. Reichlich echte Systeme leben hier ganz zufrieden.
Es gibt auch ein schlichtes betriebliches Argument — ein Gehäusetyp, ein Treiber, ein Ersatzteil im Regal —, und für einen Virtualisierungs-Host für allgemeine Zwecke ist das etwas Echtes wert. Rechne es bloß ehrlich gegen die Tatsache, dass laut der Tabelle oben eine Gen5-Platte die ganze sequentielle Decke der Karte erreichen kann.
Wann es das falsche Werkzeug ist
Der Handel wird schlecht im Verhältnis dazu, wie viel Parallelität deine Last hat.
Ceph ist der klarste Fall. Ein Speicherknoten fährt eine OSD je Platte, jede mit ihren eigenen Thread-Pools, alle setzen gleichzeitig I/O ab — und dann treiben Clients eines ganzen Clusters sie gleichzeitig. Das ist der schlimmste Fall für den gemeinsamen Tag-Pool: vierundzwanzig Dienste streiten um die Befehlsplätze eines Controllers, jede Platte bei 128 offenen gedeckelt, alles durch einen x8-Uplink getrichtert. Steck diese Platten direkt an den Root Complex, und jede OSD bekommt ihre eigenen Queues, ihre eigenen Tags und ihre eigenen Lanes. Ein Ceph-Knoten voll NVMe sollte keinen Tri-Mode-Adapter im Datenweg haben.
Dieselbe Logik gilt für NVMe-oF-Targets, wo du Platten wieder herausgibst und jede Schicht der Serialisierung sich aufaddiert; für Datenbanken mit tiefem asynchronem I/O; und für alles, was auf io_uring oder SPDK gebaut ist, die es gerade dafür gibt, die Queues je Kern auszunutzen, die der Adapter dir gerade genommen hat.
Die allgemeine Regel: je mehr Parallelität deine Software ausnutzen sollte, desto mehr stellt ein Tri-Mode-Adapter dir dafür in Rechnung.
Wie du herausfindest, was du hast
Hast du einen Server geerbt und willst wissen, auf welcher Seite davon du stehst:
# What is the transport? "nvme" is direct, "sas" means it went through a controller
lsblk -o NAME,TRAN,MODEL,SIZE

# Is there a tri-mode controller in the machine at all?
lspci -nn | grep -Ei 'sas|megaraid|serial attached'

# Which driver claimed the disk?
ls -l /sys/block/sdb/device/driver

# Per-device queue depth — 128 is the mpt3sas NVMe default
cat /sys/block/sdb/device/queue_depth

# How many hardware queues does this device actually get?
ls /sys/block/sdb/mq/ | wc -l
ls /sys/block/nvme0n1/mq/ | wc -l    # compare against a direct-attached drive

# On a direct-attached drive, what did the controller actually grant?
# One admin queue plus one I/O queue per core, so expect nproc + 1
cat /sys/class/nvme/nvme0/queue_count
nproc

# The driver says it out loud at load time
dmesg | grep -i 'nr_hw_queues'
Das Letzte gibt die Zeile Max SCSIIO MPT commands: N shared with nr_hw_queues = M aus, die oben zitiert wurde. Ist nvme list auf einer Maschine leer, von der dir gesagt wurde, sie sei ganz NVMe-Flash, ist der Adapter der Grund.
Die kurze Fassung
Ein Tri-Mode-Adapter wandelt deine NVMe-Platten in SCSI-Platten um. Diese Umwandlung ist keine Nebenwirkung. Sie ist, wie eine Karte drei Protokolle bedient, und sie ist, was du kaufst.
Was du aufgibst, ist bestimmt und messbar: Queue-Paare je Kern durch die gemeinsamen Reply-Queues eines Controllers ersetzt, eine Tiefe von 128 je Gerät, ein Tag-Pool auf jede Platte an der Karte verteilt, eine x2-Verbindung, wo die Platte x4 wollte, und ein gemeinsamer Uplink, wo jede Platte zuvor ihren eigenen Weg zum Root Complex hatte. Der Adapter hört auf, eine Verbindung zu sein, und wird zum Engpass, und auf heutiger Hardware wird er es schnell: zwei Gen4-Platten erreichen einen HBA 9500, vier Gen5-Platten erreichen selbst eine PERC13.
Eine breitere Host-Verbindung hilft — eine x16-Gen5-Karte hat etwa die vierfache Bandbreite und die vierfachen IOPS einer x8-Gen4 —, aber sie ändert die Form nicht. Sie kauft Schächte, nicht Parallelität: dieselben sechzehn Lanes direkt an vier Platten verdrahtet liefern dieselbe Bandbreite, ohne jede Queue-Steuer. Und sie rettet kein volles Regal. Vierundzwanzig Platten hinter einer 9500 bekommen etwa 570 MB/s jede, und das ist, was eine SATA-SSD macht.
2019, als NVMe die Ebene war, die man einem SAS-Bestand hinzufügte, und Plattformen knapp an Lanes waren, war das ein vernünftiger Handel. 2026 ist er es meist nicht. NVMe ist die Voreinstellung, gebrauchte U.2-Platten sind billig, ein Epyc mit einem Sockel hat Lanes übrig, und der eine Vorteil, der noch steht — universelle Laufwerksschächte —, gehört der U.3-Backplane, nicht dem Controller. Du kannst sehr oft die Schächte behalten und die Steuer löschen, indem du die Backplane direkt an die CPU verkabelst.
Kauf also einen Tri-Mode-Adapter, wenn du sein RAID-Werk kaufst und eines brauchst. Kauf ihn nicht für die Flexibilität, und hast du einen in einem Gehäuse voll NVMe geerbt, geh und finde heraus, wie diese Backplane verkabelt ist.