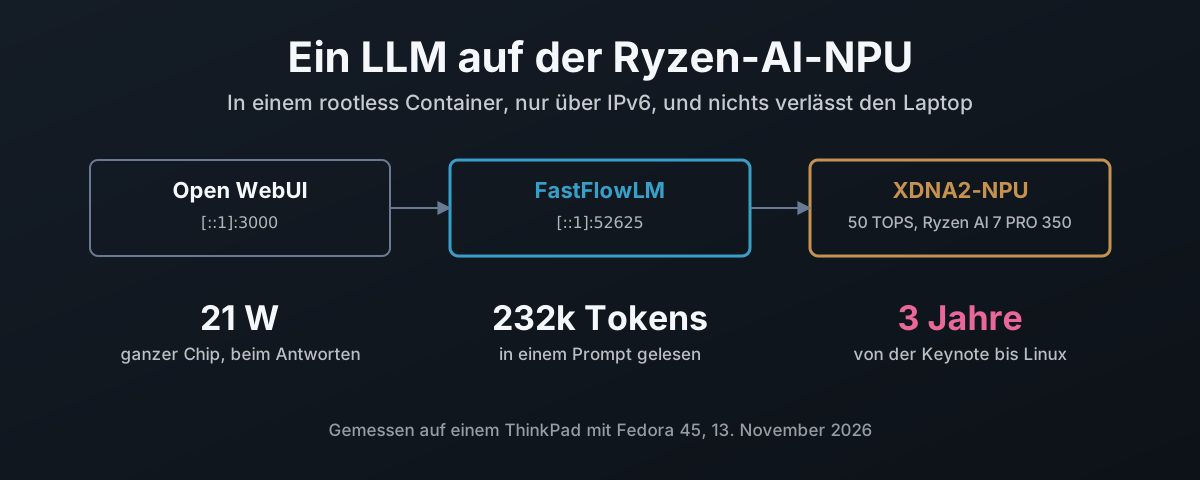
50 TOPS, die nix tun
Jeder Ryzen-AI-Laptop, der in den letzten zwei Jahren verkauft wurde, hat eine Neural Processing Unit (NPU), einen Block Silizium, der für nichts anderes gebaut ist als die Mathematik hinter KI-Modellen. Bei meinem, einem ThinkPad mit Ryzen AI 7 PRO 350, gibt AMD sie mit bis zu 50 TOPS an, Billionen Operationen pro Sekunde1. Du hast dafür bezahlt. Auf einer normalen Linux-Installation tut sie nichts.
Das hat sich dieses Jahr geändert. Einmal eingerichtet, betreibt die NPU ein Sprachmodell mit 4 Milliarden Parametern hinter einem Chatfenster, dazu Spracherkennung, alles auf dem Laptop, ohne Konto, ohne Abo und ohne dass irgendetwas die Maschine verlässt. Für alles, was du lieber nicht in die Website von jemand anderem tippen würdest, ist genau das der Punkt. Der ganze Chip zieht beim Antworten etwa 21 W, im Leerlauf unter 9 W.
| Was läuft | Wo | Adresse |
|---|---|---|
| Qwen 3.5 4B, 256k-Token-Kontext | NPU, im Container | http://[::1]:52625/v1 |
Spracherkennung: OpenAIs Whisper, whisper-v3:turbo | NPU, derselbe Container | dieselbe, /audio/transcriptions |
| Open WebUI, die Chatseite | CPU, im Container | http://[::1]:3000 |
| amdxdna-Kerneltreiber, Firmware | Host | /dev/accel/accel0 |
Zwei Regeln haben den Aufbau bestimmt. Nur der Kerneltreiber und seine Firmware kommen auf den Host; jedes Modell-Framework läuft in einem rootless podman-Container. Und jeder Dienst lauscht nur auf IPv6-Loopback, auf IPv4 gar nichts. Beides war am Ende weniger Arbeit als der unordentliche Weg, und beides hat Probleme gefangen, die ich sonst ausgeliefert hätte.
Was es unter Linux braucht
Die NPU in diesem Chip ist AMDs Design der zweiten Generation, XDNA2. Das ist wichtig, denn die Software, die Sprachmodelle darauf laufen lässt, unterstützt XDNA2-Teile (Ryzen AI 300 und 400, Strix Halo) und nicht die erste Generation im Ryzen 7040 und 80402. Prüf deinen, bevor du anfängst:
$ lspci -nn | grep -i 'neural\|signal processing'
c5:00.1 Signal processing controller [1180]: Advanced Micro Devices, Inc. [AMD] Strix/Krackan/Krackan2/Strix Halo Neural Processing Unit [1022:17f0] (rev 20)
Vier Schichten liegen zwischen diesem Gerät und einer Chatantwort, und die Trennung zwischen Host und Container ist das ganze Design:
| Schicht | Was sie ist | Liegt auf |
|---|---|---|
amdxdna | Kerneltreiber, erzeugt /dev/accel/accel03 | Host, über DKMS |
| NPU-Firmware | npu_7.sbin, 1.1.2.64 auf diesem Chip | Host, aus linux-firmware |
XRT + amdxdna-Plugin | AMDs Runtime-Bibliothek und ihr NPU-Backend | Container |
| FastFlowLM | die LLM-Runtime, NPU-Kernels inklusive | Container |
Kernel 7.x liefert amdxdna im Tree mit, aber AMD entwickelt ihn zuerst im eigenen Repository, und das Userspace-Plugin muss zu dem Kernelmodul passen, mit dem es spricht4. Der Abstand zwischen beiden ist nicht klein. Auf diesem Laptop:
| Im Tree, Fedoras 7.2.15 und 7.3.3 | Out-of-Tree, amd/xdna-driver bei 24dfd686 | |
|---|---|---|
| Treiberschnittstelle | 0.105 | 0.19 |
| Modulversion | keine | 2.27.0_20261113 |
| NPU-PCI-IDs, die er bindet | 6 | 8 |
| Firmwaredateien, nach denen er fragt | 7 | 59 |
| Firmware, die dieser Chip lädt | 17f0_10/npu_7.sbin, 1.1.2.64 | dieselbe Datei |
Neun Schnittstellenversionen auseinander, und Linux 7.3, das neueste Release, trägt immer noch 0.10. Das Einzige, worin sie übereinstimmen, ist die Firmware, und die kommt aus Fedoras linux-firmware, nicht aus einem der Treiber. Also baue ich beide Hälften aus einem Commit von amd/xdna-driver, lege das Modul auf den Host und backe den passenden Userspace ins Image.
Der Treiber: alles bauen, nur den Kernel-Teil behalten
amd/xdna-driver bringt XRT als Git-Submodul mit, und der Build erzeugt RPMs für XRT und ein Plugin-Paket. Das Plugin-Paket enthält auch den Treiberquellcode, den es bei DKMS registriert (Dynamic Kernel Module Support, das, was ein Modul für jeden neuen Kernel neu baut). Nichts davon ist schwer:
git clone --recursive https://github.com/amd/xdna-driver.git && cd xdna-driver
sudo ./tools/amdxdna_deps.sh
(cd xrt/build && ./build.sh -npu -opt)    # XRT RPMs in xrt/build/Release/
(cd build && ./build.sh -release)         # plugin RPM, driver source inside
Unter Fedora 45 endet das Abhängigkeitsskript mit einem Fehler. Ignorier ihn:
| Es verlangt | Was passiert | Wichtig? |
|---|---|---|
protobuf-devel | kollidiert mit einem installierten protobuf3-compiler | nein, XRT lässt ohne es nur ein Tracing-Werkzeug weg |
redhat-lsb | kein solches Paket, Fedora hat es gestrichen | nein |
| alles andere | schon installiert |
Das letzte getaggte Release dort ist vom Februar, also ist main der Release-Kanal. Ich bin von einem Build aus dem Mai auf den aus dem November gegangen: 550 Commits, XRT 2.23 auf 2.27.
Das Upgrade löscht den Treiber, den es gerade installiert hat
Mein erster Upgrade-Versuch hat das Modul komplett entfernt. RPM führt das Installationsskript des neuen Pakets aus, das den neuen Treiber baut und bei DKMS registriert, und danach das Entfernungsskript des alten Pakets. Dieses Entfernungsskript liest die Treiberversion aus einer Datei, die das neue Paket schon überschrieben hat, und meldet deshalb genau die Version ab, die gerade installiert wurde. Die Ausgabe von dnf sagt es in zwei Zeilen, direkt hintereinander:
>>> Successfully installed and enabled DKMS for xrt-amdxdna/2.27.0
>>> Removing driver source: xrt-amdxdna/2.27.0...
Nichts ist fehlgeschlagen, nichts wurde rot, und der nächste Boot hätte still geladen, was der Kernel stattdessen mitbringt. Darf ich fragen, warum ein Entfernungsskript bei einem Upgrade läuft, ohne zu prüfen, ob es ein Upgrade ist? RPM gibt jedem Scriptlet genau diese Antwort als erstes Argument mit. Es ist ein einziges if.
Das ist auch der Grund, warum der Host die RPMs jetzt gar nicht mehr bekommt. Der Treiberquellcode ist ein Tarball im Plugin-Paket, also hole ich ihn heraus und gebe ihn DKMS direkt:
T=$(mktemp -d) && rpm2cpio xrt_plugin*.rpm | (cd $T && cpio -idm --quiet)
D=$T/opt/xilinx/xrt/share/amdxdna
sudo mkdir -p /usr/src/xrt-amdxdna-2.27.0
sudo tar -xf $D/amdxdna.tar.gz -C /usr/src/xrt-amdxdna-2.27.0
sudo cp $D/dkms.conf $D/configure_kernel.sh /usr/src/xrt-amdxdna-2.27.0/
sudo dkms install xrt-amdxdna/2.27.0
sudo modprobe -r amdxdna; sudo modprobe amdxdna
Kein Neustart. Es ist Linux, und zu diesem Zeitpunkt hat nichts das Gerät offen, also wird das Modul im laufenden Betrieb getauscht. DKMS baut es danach für jeden Kernel neu, den dnf installiert; als 7.3.3 kam, war es gebaut, bevor ich überhaupt hineingebootet hatte.
Prüf, dass der DKMS-Build geladen ist und nicht der aus dem Tree, und dass die Firmware neu genug ist. FastFlowLM will 1.1.0.0 oder neuer2:
$ modinfo -F filename amdxdna
/lib/modules/7.2.15-300.fc45.x86_64/extra/amdxdna.ko.xz
$ cat /sys/bus/pci/drivers/amdxdna/*/fw_version
1.1.2.64
$ journalctl -k | grep 'Initialized amdxdna'
[drm] Initialized amdxdna_accel_driver 0.19.0 for 0000:c5:00.1 on minor 0
DKMS schiebt das eigene Modul des Kernels beiseite, statt es zu löschen, nach /var/lib/dkms/xrt-amdxdna/original_module/, und wer den DKMS-Build wieder herausnimmt, bekommt es zurück.
Noch etwas, das du in Ruhe lassen solltest: amd_iommu=off auf der Kernel-Kommandozeile schaltet die NPU ab2.
FastFlowLM im Container
FastFlowLM ist die Runtime, die die NPU für Sprachmodelle brauchbar macht. Es ist eine Kommandozeile im Stil von Ollama und ein OpenAI-kompatibler Server, geschrieben für XDNA2, und es ist dieses Jahr unter AMDs ROCm-Organisation gewandert6. Die Runtime steht unter MIT-Lizenz. Die NPU-Kernels, die es mitliefert, sind geschlossene Binärdateien, frei zu benutzen und unverändert weiterzugeben7. Mir wäre es lieber, sie wären offen, und das sage ich auch, aber sie liegen im Repository, und nichts muss von irgendwo anders geholt werden.
Das Image hat drei Stufen auf Fedora 45: XRT aus dem Treiber-Build, FastFlowLM dagegen kompiliert, dann eine Runtime mit nur dem, was sie braucht. Der Teil, auf den es ankommt:
FROM registry.fedoraproject.org/fedora:45 AS xrt
ARG XDNA_COMMIT
COPY dist/xdna-${XDNA_COMMIT}/ /rpms/
RUN dnf -y install /rpms/xrt_2*-base.rpm /rpms/xrt_2*-npu.rpm \
 && rpm -i --noscripts --nodeps --nosignature \
        --excludepath=/usr/lib/firmware --excludepath=/opt/xilinx/xrt/share/amdxdna \
        /rpms/xrt_plugin*.rpm \
 && echo /opt/xilinx/xrt/lib64 > /etc/ld.so.conf.d/xrt.conf && ldconfig
Jedes dieser Flags ist da, weil ohne es etwas kaputtging:
| Problem | Lösung |
|---|---|
| Die Skripte des Plugins bauen ein Kernelmodul, und das gehört auf den Host | --noscripts, Treiberquellcode und Firmware ausgeschlossen |
| Das RPM 6 von Fedora 45 erzwingt standardmäßig die Signaturprüfung8, und ein selbst gebautes RPM ist unsigniert | --nosignature: Ich habe es gebaut, ich weiß, woher es kommt |
Die Bibliotheken von XRT liegen in lib64, und das ist nicht im Linker-Pfad | /etc/ld.so.conf.d/xrt.conf im Image |
FastFlowLM findet XRT über pkg-config, und XRTs setup.sh setzt den Pfad nicht | PKG_CONFIG_PATH=/opt/xilinx/xrt/lib64/pkgconfig in der Build-Stufe |
Das fertige Image hat 609 MB, und sein Tag trägt den Treiber-Commit, fastflowlm:v1.0.12-xdna24dfd686. Ein Health-Check vergleicht das mit dem Commit, den das geladene Modul meldet, und schlägt fehl, wenn sie sich unterscheiden. Ein Image, das für den falschen Treiber gebaut wurde, ist hier der eine Fehler, der wirklich verwirrend zu diagnostizieren ist, also wird er gefangen, bevor es so weit kommt.
Der Container bekommt ein Gerät, die NPU, und das Memory-Lock-Limit, das FastFlowLM braucht, um seine Puffer festzunageln:
podman run --rm --device /dev/accel/accel0 --ulimit memlock=-1:-1 \
  localhost/fastflowlm:v1.0.12-xdna24dfd686 validate
[Linux]  NPU: /dev/accel/accel0 with 8 columns
[Linux]  NPU FW Version: 1.1.2.64
[Linux]  Memlock Limit: infinity
AMDs eigener Selbsttest, xrt-smi validate, maß die NPU bei einer Matrixmultiplikation mit 51 TOPS. Das sind die 50 auf der Packung, geliefert.
Start beim Booten, nur über IPv6
Quadlet macht aus einer kurzen .container-Datei einen systemd-Dienst9. Als User-Unit läuft er rootless, als ich, und mit Lingering startet er beim Booten, ohne dass jemand angemeldet ist10:
[Unit]
Description=FastFlowLM NPU server
ConditionPathExists=/dev/accel/accel0

[Container]
Image=localhost/fastflowlm:v1.0.12-xdna24dfd686
AddDevice=/dev/accel/accel0
Ulimit=memlock=-1:-1
Network=host
Volume=%h/.config/flm:/models:Z
Exec=serve qwen3.5:4b --host ::1 --port 52625 -c 262144 -a whisper-v3:turbo
StopSignal=SIGINT

[Install]
WantedBy=default.target
loginctl enable-linger $USER
cp fastflowlm.container ~/.config/containers/systemd/
systemctl --user daemon-reload && systemctl --user start fastflowlm
-c 262144 setzt das Kontextfenster, und der Kontexttest weiter unten ist der Grund, warum es so groß ist. -a whisper-v3:turbo lädt ein zweites Modell neben dem Chatmodell, eines, das Sprache in Text verwandelt; es bekommt einen eigenen Abschnitt.
Drei Zeilen darin habe ich auf die harte Tour gelernt:
| Zeile | Ohne sie |
|---|---|
StopSignal=SIGINT | FastFlowLM ignoriert SIGTERM, das Stoppsignal von podman, und wird zehn Sekunden später abgeschossen |
--host ::1 | es lauscht auf 127.0.0.1, IPv4 |
::1, nicht [::1] | die Form mit Klammern lässt sich nicht parsen; Klammern gehören in eine URL |
Beweis die Adresse, statt ihr zu vertrauen:
$ ss -ltn 'sport = :52625'
LISTEN 0  4096  [::1]:52625  [::]:*
$ curl -s http://127.0.0.1:52625/v1/models || echo refused
refused
localhost funktioniert weiterhin für alles, was es zuerst zu ::1 auflöst, und das tun sowohl Fedoras /etc/hosts als auch Chrome.
Was es leistet, gemessen
Neun Modelle durch den eigenen Benchmark von FastFlowLM, wobei Decode die Geschwindigkeit ist, mit der die Antwort hereinläuft:
| Modell | Decode, 1k Kontext | Decode, 8k Kontext | Prompt lesen, 8k |
|---|---|---|---|
llama3.2:1b | 77 tok/s | 56 tok/s | 2.009 tok/s |
qwen3.5:2b | 32 | 29 | 1.533 |
llama3.2:3b | 30 | 20 | 857 |
phi4-mini-it:4b | 25 | 17 | 744 |
qwen3:4b | 23 | 15 | 613 |
qwen3.5:4b | 17 | 15 | 657 |
gemma4-it:e4b | 14 | 12 | 642 |
qwen3:8b | 13 | 10 | 418 |
qwen3.5:9b | 11 | 10 | 451 |
Lesetempo sind fünf bis acht Tokens pro Sekunde, also bleibt jedes davon vor dir. Decode halbiert sich ungefähr mit jeder Verdopplung des Modells, und genau das erwartest du, wenn die Grenze die Speicherbandbreite ist und nicht die Rechenleistung. Ich nutze qwen3.5:4b. Phi-4 mini ist schneller, aber Qwen 3.5 hält sein Tempo, wenn ein Gespräch wächst, kann Bilder und Tool-Aufrufe und hält einen Prompt-Cache, der erspart, bei jedem Zug den ganzen Verlauf neu zu lesen. Das entscheidet es.
256.000 Tokens Kontext
Qwen 3.5 ist für ein Fenster von 262.144 Tokens gebaut11, und FastFlowLM stellt standardmäßig 32.768 ein. Jenseits dieser Grenze tut es etwas, das man wissen sollte: Es protokolliert Max length reached, stopping prefilling und schließt die Verbindung ohne Antwort und ohne Fehler, und so sitzt das Chatfenster mit einer leeren Antwort da, und du darfst raten, ob das Modell, der Server oder der Browser umgefallen ist.
Also habe ich es mit -c 262144 hochgesetzt und ordentlich getestet. Ein Code, versteckt in der ersten Zeile eines Prompts mit 232.250 Tokens, grob 175.000 Wörter, am Ende danach gefragt:
| 8k Kontext | 232k Kontext | |
|---|---|---|
| Antwort | richtig | richtig, AMBER-FALCON-7731 |
| Prompt lesen | 657 tok/s | 210 tok/s |
| Warten auf das erste Wort | 12 Sekunden | 18,4 Minuten |
| Decode | 15 tok/s | 2,4 tok/s |
| Reservierter Speicher | ~5 GB | ~12,7 GB |
Es funktioniert. Es ist langsam. Und der Speicher ist reserviert, ob du das Fenster nutzt oder nicht. Mit 90 GB in der Maschine zahle ich das, damit ein langer eingefügter Text beantwortet und nicht still fallen gelassen wird.
Kann die GPU helfen?
Derselbe Chip hat eine Radeon 860M, also liegt die Frage nahe, ob sie einen Teil der Last übernehmen kann. Ein Modell auf NPU und GPU aufzuteilen, den Prompt auf der einen zu lesen und die Antwort auf der anderen zu schreiben, macht heute keine Linux-Runtime. Eine zweite Runtime auf der GPU laufen zu lassen schon, also habe ich das gemessen.
„Effizient“ heißt hier Geschwindigkeit und Energie zusammen. Der amdgpu-Treiber meldet ohne root die Package-Leistung des ganzen Chips, und der amdxdna-Treiber meldet die NPU für sich, also wurde jeder Lauf unten viermal pro Sekunde abgetastet. Durchgehend dasselbe Modell in 4 Bit.
Von den GPU-Runtimes, die ich mir angesehen habe, lief eine:
| Runtime | Ergebnis auf der 860M |
|---|---|
| llama.cpp, Vulkan-Backend12 | läuft; 881-MB-Image |
| llama.cpp, ROCm-Backend | sieht die GPU, dann Segfault beim ersten Stück Arbeit, mit oder ohne GPU-Versions-Override; 23-GB-Image |
| MLC-LLM, Vulkan13 | sein Compiler stürzt beim Bauen der Qwen-3.5-Architektur mit Segfault ab |
| vLLM, SGLang | nicht ausprobiert: gebaut für Rechenzentrums-GPUs und viele Nutzer, nicht für eine iGPU mit 8 Einheiten |
Und die NPU gegen die, die lief:
| Qwen 3.5 4B | NPU, FastFlowLM | GPU, llama.cpp Vulkan |
|---|---|---|
| Leerlauf, Modell geladen | 8,6 W | 16,0 W, gegen 9,7 W, wenn sie gestoppt ist |
| Prompt lesen, ~6k Tokens | 557 tok/s bei 23,8 W | 411 tok/s bei 46,1 W |
| Energie pro Prompt-Token | 0,043 J | 0,112 J |
| Decode | 18,2 tok/s bei 21,0 W | 23,5 tok/s bei 40,7 W |
| Energie pro erzeugtem Token | 1,16 J | 1,73 J |
Die GPU schreibt Antworten etwa 29 % schneller. Sie verbrennt dabei die doppelte Leistung. Die NPU liest Prompts schneller und mit weniger als der Hälfte der Energie. Die größere Zahl ist die im Leerlauf: Der GPU-Server, geladen und untätig, kostet 6,3 W mehr als dieselbe Maschine mit gestopptem Server, den ganzen Tag. Beide gleichzeitig laufen zu lassen, drückte die NPU von 18,2 auf 14,2 Tokens pro Sekunde und die GPU von 23,5 auf 13,9, weil sie sich denselben Speicher teilen. Insofern gibt es den GPU-Container, aber er wird gestartet, wenn ich ein zweites Modell will, und er ist beim Booten nicht aktiviert.
Die NPU selbst zog in jedem Lauf unter 2 W. Das meiste der 21 W sind CPU und Speicher, die sie füttern. Das ist die Grenze, die man bei künftigen FastFlowLM-Releases im Auge behalten sollte.
Sprache zu Text, auch auf der NPU
Whisper ist OpenAIs Spracherkennungsmodell: Audio rein, Text raus, in 99 Sprachen, und unter der MIT-Lizenz veröffentlicht, also läuft es überall, ohne dass man jemanden fragen muss14. Large-v3 ist die aktuelle Version in voller Größe. Turbo ist dasselbe Modell mit seinem Decoder, der Hälfte, die den Text ausschreibt, von 32 Schichten auf 4 gekürzt. Die Model Card beschreibt den Tausch nüchtern: „way faster, at the expense of a minor quality degradation“. Mit 809 Millionen Parametern ist es ein Fünftel so groß wie das Chatmodell.
FastFlowLM liefert es schon für die NPU konvertiert als whisper-v3:turbo, ein Download von 623 MB, und lädt es mit -a whisper-v3:turbo neben dem Chatmodell. Whisper allein bedient es nicht; es muss auch ein Chatmodell geladen sein. Audio geht an den Standard-Transkriptionsendpunkt von OpenAI, und der Text kommt zurück.
| 19,6 Sekunden Sprache | |
|---|---|
| Erste Anfrage, Whisper wird geladen | 6,2 s |
| Danach | 2,0 s, etwa zehnfache Echtzeit |
| Leistung des ganzen Chips | ~24,7 W |
| Genauigkeit | jedes Wort richtig |
Allerdings in amerikanischer Fake-Englisch-Schreibweise: „color“ und „program“. Die API von Whisper nimmt einen prompt, und ein Prompt in echter britischer Schreibweise, dem Englisch Englands, wo die Sprache herkommt, reicht, um das zu beheben:
curl -s 'http://[::1]:52625/v1/audio/transcriptions' -F file=@speech.wav \
  -F model=whisper-v3:turbo -F language=en \
  -F 'prompt=British English spelling: colour, programme, organise, centre.'
Wir sollten diese Modelle gar nicht korrigieren müssen. Whisper wurde mit 99 Sprachen trainiert und schreibt Englisch trotzdem auf die amerikanische Art, wenn man ihm nichts anderes sagt, weil die Leute, die es gebaut haben, ihre Schreibweise als Standard behandeln und die aller anderen als Option, um die man bitten muss. Das ist der nervige amerikanische Defaultismus, den der Rest der Welt hasst, und er ist als Bias eingebacken. Der Systemprompt für das Chatmodell trägt dieselbe Anweisung, im Abschnitt weiter unten, aus demselben Grund.
Ein Chatfenster und 7.000 Tokens, die du nie getippt hast
Open WebUI ist das Browser-Frontend15, in einem eigenen Container, auf dieselbe Art an [::1]:3000 gebunden und auf die NPU gerichtet. Sein Mikrofonknopf geht an Whisper auf der NPU statt an seine eigene Voreinstellung, die ein Modell heruntergeladen und auf der CPU ausgeführt hätte.
Die erste Nachricht, die ich geschickt habe, hatte zwanzig Wörter. Bei der NPU kam sie als Prompt mit 7.223 Tokens an, weil Open WebUI 0.13 die Definitionen aller eingebauten Tools (Memory, Notizen, Kalender, Automatisierungen, Websuche) an jede Nachricht hängt, und ein Admin bekommt jedes davon.
| Dieselbe Frage mit zwanzig Wörtern | Prompt an die NPU | Warten auf das erste Wort |
|---|---|---|
| Eingebaute Tools an, die Voreinstellung | 7.223 Tokens | ~12 s |
| Eingebaute Tools für das Modell aus | 127 Tokens | unter 1 s |
Für ein lokales Modell sollte diese Voreinstellung aus sein. Zwölf Sekunden, bei jeder Antwort.
Außerdem erzählte es mir selbstbewusst, es sei „trained by Google“ und laufe „on Google’s advanced infrastructure“. Es ist ein Qwen-Modell, gemacht von Alibaba, und es läuft auf einem Laptop. Das ist kompletter Unsinn, und das sollte nicht passieren.
Am Setup liegt es nicht. Ein Modell sieht nur den Text, den es geschickt bekommt, und der Name im Drop-down ist eine Beschriftung für den Server, die nie an das Modell weitergegeben wird. Also kam diese Antwort allein vom Modell, und es hat die eine Tatsache über sich selbst falsch, an der nie ein Zweifel bestehen sollte. Das ist ein Designfehler, und er liegt bei dem, der das Modell ausgeliefert hat.
Alibaba wusste, wie man das verhindert. Die Chat-Vorlage von Qwen 2.5 eröffnete jedes Gespräch mit „You are Qwen, created by Alibaba Cloud“, sofern man ihr nichts anderes gab16. Qwen 3 hat diese Zeile gestrichen17, und Qwen 3.5 kommt ebenfalls ohne sie18. Nichts hat sie ersetzt, und nach dieser Antwort zu urteilen, wurde dem Modell das nie gut genug beigebracht, um allein zurechtzukommen. Frag ein 4B-Modell ohne Prompt „Was bist du?“, und es greift auf die häufigste Antwort in seinen Trainingsdaten zurück, und die ist die von jemand anderem.
Ist das eine Kleinigkeit? Nein. Ein Modell, das dir mit voller Überzeugung sagt, wer es gebaut hat und in wessen Rechenzentrum es läuft, und beides falsch hat, macht dasselbe mit allem anderen, das es nicht prüfen kann. Hier kennst du die richtige Antwort. Meistens wirst du sie nicht kennen.
Also muss man es ihm sagen, in einem Systemprompt:
| Gefragt „what are you, and what are you running on?“ | Antwort |
|---|---|
| Kein Systemprompt | „a large language model trained by Google… Google’s advanced infrastructure“ |
| Mit einem | „Qwen 3.5, a large language model created by Alibaba… running locally on your Lenovo ThinkPad using the AMD Ryzen AI 7 PRO 350’s NPU via FastFlowLM“ |
Derselbe Prompt sagt ihm, britisches Englisch zu schreiben, wieder wegen des amerikanischen Defaultismus, den auch Whisper hat. Wenn man es ihm sagt, tut es das. Welcher Tag heute ist, kann es dir trotzdem nicht sagen. Ein Modell ohne Kalender und ohne Internet rät Daten und aktuelle Ereignisse, und es sagt das nicht immer dazu, egal, was der Prompt verlangt.
Drei Jahre, bis KI unter Linux lief
AMD hat Ryzen AI im Januar 2023 auf die Bühne gebracht, als „the first dedicated artificial intelligence hardware in an x86 processor“19. Zähl von dieser Keynote aus vorwärts:
| Wann | Was unter Linux passierte | Nach der Keynote |
|---|---|---|
| 4. Januar 2023 | Ryzen AI angekündigt, im Ryzen 7040 | |
| 25. Januar 2024 | amd/xdna-driver auf GitHub veröffentlicht4 | 1 Jahr |
| 24. März 2025 | amdxdna im Mainline-Linux, 6.1420 | 2 Jahre 2 Monate |
| 27. März 2025 | dieser Chip, der Ryzen AI 7 PRO 350, kommt auf den Markt1 | 2 Jahre 2 Monate |
| 11. März 2026 | FastFlowLM 0.9.35, sein erstes natives Linux-Release21 | 3 Jahre 2 Monate |
| 11. August 2026 | FastFlowLM 1.0.0, jetzt unter AMDs ROCm6 | 3 Jahre 7 Monate |
| heute | immer noch keine LLM-Runtime für den 7040 und 80402 | 3 Jahre 10 Monate |
Drei Jahre und zwei Monate, bis überhaupt ein Sprachmodell unter Linux auf der NPU lief, und AMDs eigene Software hat es nicht geschafft. FastFlowLM hat es geschafft, ein Projekt, das außerhalb der Firma angefangen hat und dieses Jahr unter ROCm aufgenommen wurde. Seine Linux-Release-Notes beginnen mit „The wait is finally over“ und sagen dann, es nutze „the exact same recipe you already know and love on Windows“21. Das Fisher-Price OS (Windows) hat es zuerst bekommen, und das haben sie auch gesagt. AMDs eigene Ryzen AI Software sagt in ihren aktuellen Release-Notes immer noch: „Model generation is not supported on Linux in this release“22.
Wer die erste Generation gekauft hat, ist noch schlechter dran. Ein Ryzen-7040-Laptop von 2023 hat eine NPU, die keine Sprachmodell-Runtime unter Linux anfasst, und nichts Veröffentlichtes sagt, dass eine kommt. Dasselbe Logo.
Darf ich fragen, warum? Nicht wer, warum. Was in AMDs Prozess hat zugelassen, dass ein Chip mit KI im Namen verkauft wird, während die Software, um diese KI unter Linux zu nutzen, Jahre später auftauchte, von außen? Im Datenblatt steht „Up to 50 TOPS“1. Auf dem Aufkleber steht Ryzen AI. Beides sind Aussagen an den Menschen, der den Laptop kauft, und im ersten Linux-Jahr dieses Chips waren beide nix wert.
Auf Copilot gezielt, nicht aufs Rechenzentrum
Es ist nicht so, dass AMD Linux schwer fände. Im Rechenzentrum ist Linux erste Klasse, und AMD weiß das: El Capitan am Lawrence Livermore besteht aus AMD-EPYC-Prozessoren und AMD-Instinct-Beschleunigern, war bis Juni dieses Jahres der schnellste Computer der Welt23 und läuft unter TOSS, Livermores eigenem Build von Red Hat Linux24. Kannst du dir vorstellen, dass AMD einen Instinct-Beschleuniger verkauft und dem Käufer sagt, die Linux-Software komme irgendwann, von jemand anderem? Das wäre ein Nein. AMD hat sogar den Kerneltreiber dieser NPU geschrieben und in die Mainline gebracht. Die letzte Schicht, die, die die Hardware den Job machen lässt, für den sie verkauft wurde, war das Stück, das warten musste.
Es hätte nie ein Laptop-Projekt sein dürfen. Dieselbe XDNA-Architektur ging im selben Jahr in eine Rechenzentrumskarte, die Alveo V70, verkauft als „the first Alveo production card leveraging AMD XDNA architecture with AI Engines“25. Bau einen Software-Stack für die AI Engine, Linux zuerst wie im Rest des Rechenzentrums, und der Laptop bekommt ihn umsonst. Der Server auch. Ein kleiner, sparsamer Beschleuniger ist genau das, was man an virtuelle Maschinen verteilen will, für jede eine Scheibe, für die kleinen Modelle, die keine ganze GPU brauchen. Der Kernel hat erst dieses Jahr gelernt, das zu tun, eine NPU auf den neuen AIE4-Teilen in virtuelle Funktionen aufzuteilen26. Auf der NPU in diesem Laptop kann er es gar nicht.
Stattdessen ging die Arbeit ins Fisher-Price OS (Windows) und in Copilot. AMD hat die Generation dieses Chips als Prozessoren eingeführt, die „Unlock Transformational AI Experiences for Windows Copilot+ PCs“27. Kaum jemand hat angebissen. Copilot+-Maschinen waren 2,3 % der im ersten Quartal 2025 verkauften PCs mit dem Fisher-Price OS (Windows), und Microsofts neuere Copilot-Funktionen laufen sowieso in der Cloud: „only one of its new AI capabilities actually requires an NPU“28. Microsoft meldet außerdem, dass die Einnahmen von PC-Herstellern um 7 % gesunken sind, wegen „lower PC market demand“, mit „roughly 30% of the installed base still on Windows 10“29. Die NPU wurde also auf ein Betriebssystem gezielt, auf das die Leute nicht upgraden, um einen Assistenten laufen zu lassen, um den sie nicht gebeten haben und der die NPU meistens nicht nutzt.
Dort wird KI auch nicht gebaut. Die Leute, die das beruflich machen, nutzen Linux, weil dort ihre Werkzeuge laufen. TensorFlow sagt klar, dass 2.10 „was the last TensorFlow release that supported GPU on native-Windows“30. Der Modellserver vLLM „does not support Windows natively“31. JAX führt seinen Build für das Fisher-Price OS (Windows) als experimentell und seine AMD-Unterstützung als „AMD GPU (Linux)“32. Wo das Fisher-Price OS (Windows) diese Werkzeuge doch ausführt, geschieht das über WSL 2, nach Microsofts eigener Beschreibung „an actual Linux kernel inside a managed VM“33. AMD hat seinen KI-Chip auf den einen Desktop gezielt, den der KI-Berufsstand nicht benutzt. Den teilweise zu unterstützen, reicht nicht, AMD.
Dann verkauft sich AMD bei Investoren als KI-Firma. Am 11. November 2025 sagte die Vorsitzende und CEO, AMD „is uniquely positioned to lead the next generation of high-performance and AI computing“, in einer Mitteilung, die damit prahlt, das „AI PC portfolio 2.5x since 2024“ ausgebaut zu haben, und mit „full-stack AI solutions“ schließt34. Full Stack. Auf dem KI-PC in diesem Beitrag kam die Spitze dieses Stacks von einem Projekt, das AMD nicht gestartet hat, und auf der ersten Generation kam sie nie. Eine KI-Firma, deren eigener KI-Chip drei Jahre warten musste, um KI auf dem Betriebssystem laufen zu lassen, auf dem ihr Rechenzentrumsgeschäft gebaut ist? Lachhaft.
Erstklassige Unterstützung ist einfach zu beschreiben. Sie funktioniert an dem Tag, an dem du die Maschine kaufst, auf dem Betriebssystem, das du nutzt, von der Firma, die dir den Chip verkauft hat. Diese NPU hat das bisher nicht erreicht. Ich habe den Laptop für den Rest gekauft, und die NPU kam mit, und das ist der einzige Grund, warum das hier ein Erfahrungsbericht ist und keine Beschwerde. Wer einen für die KI auf dem Aufkleber gekauft hat und Linux nutzt, hat ein Versprechen gekauft, das spät gehalten wurde, und von jemand anderem.
Besitz das Silizium, für das du bezahlt hast
Die NPU kam mit dem Laptop. So, wie sie verkauft wird, ist sie das Teil, das die Maschine bereit für KI macht, und die KI im Angebot ist die von jemand anderem, im Rechenzentrum von jemand anderem, und liest, was du tippst, damit sie auf andere Weise bezahlt werden kann. Nichts an der Hardware braucht diese Abmachung. Ein 4B-Modell auf 21 W beantwortet eine Frage, liest einen eingefügten Text mit 175.000 Wörtern, wenn du ihm die Zeit gibst, und schreibt auf, was du sagst, und nichts davon verlässt den Schreibtisch.
Fertige Software ist es nicht, und jede raue Kante oben hat eine Stunde gekostet, um sie zu finden, und eine oder zwei Zeilen, um sie zu beheben. Das kostet Open Source, wenn man es tatsächlich betreibt. Es ist trotzdem ein besseres Geschäft, als dieselbe Fähigkeit zurückzumieten, und die Stunde kauft dir das Wissen, wie es funktioniert.
Die Container halten es ehrlich. Nichts auf dem Host außer einem Kernelmodul und seiner Firmware, ein Gerät an einen Container gereicht, eine Adresse, die sonst niemand erreicht, und eine Prüfung, die in dem Moment fehlschlägt, in dem die Teile nicht mehr zusammenpassen. Es hat einen Tag gedauert. Es wird weiter funktionieren, weil ich weiß, warum jede Zeile darin steht, und die Prüfung wird mir an dem Morgen Bescheid sagen, an dem eine davon nicht mehr stimmt.
AMD — Ryzen AI 7 PRO 350 — 8 Kerne, 16 Threads, Radeon 860M, „NPU TOPS: Up to 50 TOPS“, Markteinführung „3/27/2025“. ↩︎ ↩︎ ↩︎
Lemonade — LLMs on Linux with FastFlowLM — nur XDNA2 (Ryzen AI 300/400, Strix Halo), nicht XDNA1; NPU-Firmware 1.1.0.0 oder neuer;
amd_iommu=offnicht setzen. ↩︎ ↩︎ ↩︎ ↩︎Linux kernel documentation — amdxdna — der Beschleunigertreiber für AMD-NPUs im Tree. ↩︎
amd/xdna-driver — Treiber, XRT-Submodul und Plugin; das XRT-Basispaket aus dem mitgelieferten Submodul bauen, damit es mit dem Plugin funktioniert; Repository am 25. Januar 2024 angelegt. ↩︎ ↩︎
Linux v7.3 — drivers/accel/amdxdna/amdxdna_pci_drv.c —
AMDXDNA_DRIVER_MAJOR 0,AMDXDNA_DRIVER_MINOR 10; dasselbe in v7.2. ↩︎ROCm/FastFlowLM — NPU-LLM-Runtime für XDNA2, OpenAI-kompatibler Server, seit v1.0.0 Teil von ROCm; hier verwendetes Release ist v1.0.12. ↩︎ ↩︎
FastFlowLM — LICENSE_BINARY.txt — Bedingungen für die mitgelieferten NPU-Kernel-Binärdateien. ↩︎
RPM 6.0.0 release notes — „RPM defaults to enforcing signature checking“. ↩︎
podman-systemd.unit(5) — Quadlet-
.container-Units, einschließlichAddDevice=,Ulimit=,StopSignal=undExec=. ↩︎loginctl(1) —
enable-lingerstartet einen User-Manager beim Booten und lässt ihn nach dem Abmelden weiterlaufen. ↩︎Qwen/Qwen3.5-4B — „Context Length: 262,144 natively“; hybride Schichten aus Gated DeltaNet und Gated Attention. ↩︎
ggml-org/llama.cpp — das Container-Image
server-vulkan, das für die GPU-Läufe verwendet wurde, Build 12352. ↩︎mlc-ai/mlc-llm — getestet mit den Nightly-Paketen von 0.26. ↩︎
openai/whisper-large-v3-turbo — „a state-of-the-art model for automatic speech recognition (ASR) and speech translation“; aus large-v3 beschnitten, „the number of decoding layers have reduced from 32 to 4“; 809M Parameter; MIT-Lizenz. ↩︎
open-webui/open-webui — hier verwendetes Release v0.13.3. ↩︎
Qwen/Qwen2.5-7B-Instruct — tokenizer_config.json — die Standard-Systemnachricht der Chat-Vorlage: „You are Qwen, created by Alibaba Cloud. You are a helpful assistant.“ ↩︎
Qwen/Qwen3-4B — tokenizer_config.json — Chat-Vorlage ohne Standard-Systemnachricht. ↩︎
Qwen/Qwen3.5-4B — tokenizer_config.json — Chat-Vorlage ohne Standard-Systemnachricht. ↩︎
AMD — AMD Highlights Future of High-Performance and Adaptive Computing During Opening Keynote of CES 2023 — 4. Januar 2023: „AMD also unveiled Ryzen AI Technology – the first dedicated artificial intelligence hardware in an x86 processor.“ ↩︎
Kernel Newbies — Linux 6.14 — veröffentlicht am Montag, 24. März 2025; „an amdxdna driver for AMD NPUs“. ↩︎
FastFlowLM v0.9.35 release notes — 11. März 2026: „The wait is finally over… FastFlowLM is officially available natively on Linux!“ ↩︎ ↩︎
AMD — Ryzen AI Software release notes — bekannte Probleme: „Model generation is not supported on Linux in this release.“ ↩︎
TOP500 — June 2026 — „LineShine debuts as the new No. 1 system, ending El Capitan’s run atop the list“; El Capitan „is based on AMD 4th generation EPYC processors… and AMD Instinct MI300A accelerators“. ↩︎
LLNL — TOSS: Speeding Up Commodity Cluster Computing — „a fully functional cluster operating system, based on Red Hat Linux“. ↩︎
AMD — Alveo V70 — „the first Alveo production card leveraging AMD XDNA architecture with AI Engines… designed for AI inference efficiency“. ↩︎
Linux — accel/amdxdna: Add basic support for AIE4 devices — „Add initial support for AIE4 devices (PCI device IDs 0x17F2 and 0x1B0B), including… SR-IOV enablement“. Die Tabelle des Treibers gibt nur diesen Teilen Einträge für virtuelle Funktionen; die NPU dieses Laptops ist
17f0. ↩︎AMD — AMD Unveils Next-Gen “Zen 5” Ryzen Processors to Power Advanced AI Experiences — Computex, 2. Juni 2024: „AMD Ryzen AI 300 Series Processors Unlock Transformational AI Experiences for Windows Copilot+ PCs“. ↩︎
Engadget — Microsoft’s Copilot+ AI PC plan fizzled, but it still served a purpose — 5. Dezember 2025: Copilot+-Systeme „made up just 2.3 percent of Windows machines sold in the first quarter of 2025“; „only one of its new AI capabilities actually requires an NPU“. ↩︎
Windows Latest — Microsoft admits its end of support was the real Windows 11 sales driver — 31. Juli 2026, mit Zitaten aus Microsofts Ergebnis-Call: „Windows OEM and Devices revenue decreased 7%… driven by lower PC market demand“; „roughly 30% of the installed base still on Windows 10“. ↩︎
TensorFlow — Install TensorFlow with pip — „TensorFlow 2.10 was the last TensorFlow release that supported GPU on native-Windows.“ ↩︎
vLLM — GPU installation — „vLLM does not support Windows natively“. ↩︎
JAX — Installation — CPU-Wheels für „Windows, x86_64 (experimental)“; GPU-Abschnitte für NVIDIA, Google Cloud TPU, Mac und „AMD GPU (Linux)“. ↩︎
Microsoft — Comparing WSL versions — „the use of an actual Linux kernel inside a managed VM“. ↩︎
AMD — AMD Unveils Strategy to Lead the $1 Trillion Compute Market and Accelerate Next Phase of Growth — Financial Analyst Day, 11. November 2025: „AMD is uniquely positioned to lead the next generation of high-performance and AI computing“; „AMD has expanded its AI PC portfolio 2.5x since 2024“; „AMD delivers full-stack AI solutions“. ↩︎