Offenlegung vorweg: Ich arbeite für croit, die das hier geschrieben haben. Alles unten ist aus dem veröffentlichten Quellcode und der Dokumentation beider Projekte gelesen, verlinkt am Ende der Seite, und wo croits eigene Doku croits eigenem Code widerspricht, sage ich es.
Cephs OSD, von Grund auf neu geschrieben
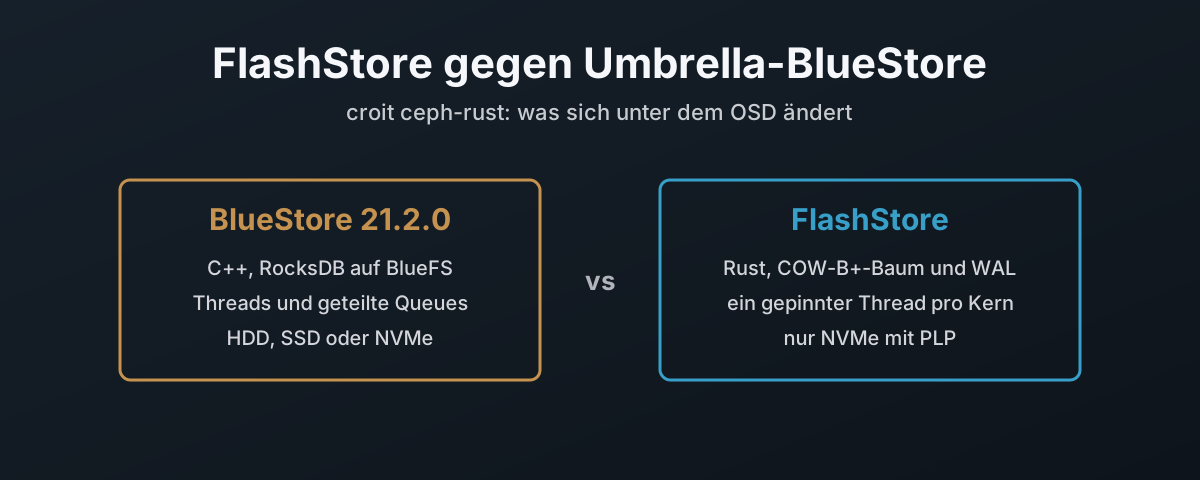
croit hat ceph-rust veröffentlicht, ein Ceph-OSD, aus dem Nichts in Rust geschrieben, mit einem eigenen Object Store namens FlashStore anstelle von BlueStore1.
Es ging am 9. November 2026 in die Public Preview, die allgemeine Verfügbarkeit ist für das erste Quartal 2027 geplant1.
Es ist kein Fork.
Die Regel des Projekts lautet: Cephs C++ wird als Referenz gelesen, in croits eigenen Worten als Spezifikation aufgeschrieben und dann nach der Spezifikation implementiert2.
Für jeden, der Ceph betreibt, zählt die Drop-in-Behauptung.
Deine Monitore, deine Manager, das ceph-CLI und deine Clients bleiben, wie sie sind.
Ein FlashStore-OSD tritt denselben Pools und denselben Placement Groups bei wie die klassischen OSDs, die schon da sind, und du tauschst ein Laufwerk nach dem anderen1.
Für einen Betreiber ist die Frage also praktisch. Wenn du ein BlueStore-OSD gegen ein FlashStore-OSD tauschst, was ist darunter anders? Nicht im Abstrakten, und nicht gegen irgendein BlueStore aus einem Konferenzvortrag von vor Jahren. Sondern gegen das BlueStore, das du heute tatsächlich betreibst, wenn du auf Umbrella bist, Ceph 21.2.0, das Release, gegen das FlashStore gebaut und getestet wird1.
Das ist hier also der Vergleich, und nur der. Umbrellas BlueStore, wie sein eigener Quellcode und seine Dokumentation es beschreiben, gegen FlashStore, wie sein Quellcode und seine Entscheidungsprotokolle es beschreiben.
Es betrifft jeden mit NVMe-Ceph-Clustern und jeden, der sich angeschaut hat, was ihn ein OSD an Kernen kostet. HDD-Cluster betrifft es überhaupt nicht, und warum, kommt weiter unten.
Was im Repository steckt
Das Repository ist ein schreibgeschützter Snapshot von croits privatem Entwicklungsbaum. Kein Issue-Tracker, keine Pull Requests; Updates kommen als neue Snapshot-Commits1. Das gilt für die Preview-Phase, und die ist für Feedback aus der Community da, während croit intern seine Produktions-Testfälle durchläuft, bevor es als sicher für den Einsatz freigegeben wird. Nach dem ersten Produktiv-Release wird die Entwicklung offen, wie bei den meisten von Firmen getragenen Open-Source-Projekten. Dieser hier ist vom 10. November 2026 und bringt rund 700.000 Zeilen Rust und über 450 Architecture Decision Records mit, die ADRs, kurze Dokumente, die festhalten, warum jede Designentscheidung so gefallen ist.
Für einen Vergleich wie diesen sind die ADRs der nützliche Teil. Sie sind direkt, sie enthalten Messungen, und sie halten fest, was ausprobiert und wieder verworfen wurde, nicht nur, was geblieben ist.
| Komponente | Was sie ersetzt | Preview | GA (geplant) |
|---|---|---|---|
| FlashStore-OSD | ceph-osd + BlueStore | Nov. 2026 | Q1 2027 |
| librustyrados | librados | Nov. 2026 | Q1 2027 |
| librustyrbd | librbd | Nov. 2026 | Q1 2027 |
| RDMA-Transport (RoCEv2) | nichts in Umbrella | Nov. 2026 | Q1 2027 |
| CephFS2, Rust-RGW | MDS, RGW | Q1 2027 | Q2 2027 |
| ceph-mon, ceph-mgr | nicht ersetzt | entfällt | entfällt |
Die Lizenzen solltest du kennen, bevor du irgendetwas darauf baust. Daemon und Werkzeuge stehen unter LGPL-3.0-only, die Client-Bibliotheken unter MPL-2.0, die Dokumentation unter CC-BY-SA-4.03. Die Client-Bibliotheken sind MPL geworden, damit ein Rust-Programm sie statisch linken kann, ohne die Relinking-Pflichten, die LGPL mitbringt. Das ist eine begründete Entscheidung, und sie ist auch so aufgeschrieben3.
Preview heißt, was es sagt. croits eigene README sagt, es sei für Tests und Evaluierung und „not yet recommended for production data“1. Ich würde auch noch keine Kundendaten darauf legen, und nichts im Rest dieses Posts ändert daran etwas.
Zwei Stores nebeneinander
Ein OSD hat zwei Hälften. Die obere spricht das Ceph-Protokoll, besitzt Placement Groups, peert, stellt wieder her und scrubbt. Die untere, der Object Store, macht aus „schreib diese Bytes in dieses Objekt“ Blöcke auf einem Laufwerk und verspricht, dass sie einen Stromausfall überleben.
BlueStore ist Umbrellas untere Hälfte. Laut Dokumentation „reads and writes to the devices directly in a ‘raw’ fashion“4, und es nimmt „raw block devices or partitions“5. Objektdaten gehen direkt auf das Blockgerät. Alles andere, die Objekt-Metadaten, OMAP und seine eigene Buchhaltung, landet in einer eingebetteten RocksDB-Key/Value-Datenbank, und RocksDB sitzt auf BlueFS, einem kleinen Dateisystem, das BlueStore eigens dafür mitbringt56.
FlashStore wirft all das raus. Ein Copy-on-Write-B+-Baum pro Store-Shard hält alles: Collections, Objekt-Metadaten, erweiterte Attribute, Extent-Maps, OMAP, das PG-Log, Referenzzähler und sogar die Bitmap des Allocators selbst7. Daneben liegen ein Redo-Write-Ahead-Log als Ring und der Datenbereich. Es gibt kein RocksDB, kein BlueFS und keine zweite Datenbank zum Tunen.
Die andere große Trennung ist das Laufwerk selbst. BlueStore geht durch die Block-Schicht des Kernels auf das, was du ihm gibst. FlashStore spricht NVMe entweder über SPDK an, einen Userspace-Treiber, der das Gerät per vfio dem Kernel wegnimmt, oder über den Kernel mit io_uring89. SPDK ist das Standard-Backend. Die io_uring-Stufe ist die, die funktioniert, wo vfio es nicht tut, und als solche ist sie die, auf der ich in dem Proxmox-Aufbau gelandet bin.
Wo die Metadaten liegen
Fang hier an. Das meiste andere folgt daraus.
| Umbrella-BlueStore | FlashStore | |
|---|---|---|
| Objekt-Metadaten | RocksDB-Keys | COW-B+-Baum pro Shard |
| OMAP | RocksDB-Keys | standardmäßig derselbe B+-Baum; LSM oder RocksDB optional beim Prepare |
| PG-Log | RocksDB-Keys | derselbe B+-Baum |
| Allocator-Zustand | Hybrid-Allocator, Freelist in RocksDB | Bitmap pro Shard, im Baum |
| Metadaten-Gerät | optional block.db und block.wal | keins, dieselbe NVMe |
| Daten-Prüfsummen | standardmäßig crc32c pro 4 KiB | crc32c pro 4 KiB, in der Extent-Map |
| Stores pro OSD | einer | einer pro Kern |
Die Standardwerte auf der BlueStore-Seite stammen direkt aus Umbrellas Optionsdatei: RocksDB als Key/Value-Backend, der Hybrid-Allocator, crc32c-Prüfsummen61011. BlueStores Metadaten-Prüfsummen „is handled by RocksDB and uses the crc32c algorithm“, und Daten kosten es „a checksum value (usually 4 bytes) for every 4 KB block of data“4. Bei den Prüfsummen sind sich beide Stores einig. FlashStore hält ein crc32c pro 4-KiB-Block in der Extent-Map und prüft es beim Lesen7.
Bei der Struktur trennen sie sich. BlueStores RocksDB ist ein Log-Structured Merge Tree, es schreibt also und kompaktiert dann im Hintergrund, wobei es Daten neu schreibt, die es schon geschrieben hat. FlashStores Baum wird per Copy-on-Write aktualisiert und an Checkpoints auf die Platte gefaltet: alle fünf Sekunden, solange etwas nicht persistiert ist, oder wenn der WAL-Ring halb voll ist7.
Eine weitere Folge: FlashStore hat kein schnelles Gerät für Metadaten, weil es keins braucht.
Auf Umbrella kannst du block.db auf ein schnelleres Laufwerk legen, und BlueStore legt dann „as much metadata as it can on the DB device“4.
FlashStore geht davon aus, dass jedes Laufwerk schon schnelles NVMe ist, und hält seine Metadaten neben den Daten.
Für die Hardware, auf die es zielt, ist das eine faire Annahme. Es ist auch genau der Grund, warum es keine HDD-Geschichte gibt.
OMAP ist die eine Stelle, an der FlashStore sich absichert. Der Baum ist der Standard, aber ein Store kann auch mit einer eigenen LSM-Engine von croit oder mit RocksDB hinter derselben Schnittstelle vorbereitet werden12. Die OMAP-Engine wird beim Anlegen des Stores gewählt. Auf einem laufenden OSD schaltest du sie nicht um.
Ein 4-KiB-Write, zwei Wege
Hier ist der Unterschied, den du spüren würdest, falls du überhaupt einen spürst.
Nimm einen 4-KiB-Write auf ein Objekt unter Umbrella mit Standardeinstellungen auf Flash.
bluestore_min_alloc_size_ssd ist 4 KiB und bluestore_prefer_deferred_size_ssd ist 0, also geht ein ganzer 4-KiB-Write auf frisch allokierte 4 KiB1314.
BlueStore schickt diesen Daten-Write ab, und die Transaktion wartet in STATE_AIO_WAIT, bis das Laufwerk meldet, dass er fertig ist15.
Erst dann werden die Metadaten für RocksDB eingereiht, und der RocksDB-Sync-Thread flusht das Blockgerät, bevor er committet16.
Dann bekommt der Client seine Bestätigung.
Zwei Wege zum Gerät, hintereinander.
FlashStore schickt beides auf einmal. Die Daten gehen auf einen frischen 4-KiB-Extent und die WAL-Einheit parallel in den Log-Ring. Der WAL-Eintrag trägt das crc32c jedes neuen Datenblocks, damit das Replay nach einem Absturz erkennen kann, ob die Daten angekommen sind7. Die Bestätigung geht in Log-Reihenfolge raus, wenn die Daten, die WAL-Einheit und jede frühere Transaktion dauerhaft gespeichert sind7. Die eigene Begründung des ADR für das Design lautet „parallel commit gives one device latency per ack“7.
Zwei Dinge halten das ehrlich. Auf einem ausgelasteten OSD bündeln beide Stores Commits, also ist der Abstand unter Last kleiner als eine Gerätelatenz pro Write. Und ein einzelner Weg zum Gerät dauert auf NVMe ein paar zehn Mikrosekunden. Ob du das merkst, hängt davon ab, ob deine Clients bei niedriger Queue-Tiefe auf Latenz warten, was Datenbanken auf RBD oft tun, oder auf Durchsatz drücken, wo es untergeht.
croit hat versucht, weiter zu gehen, zu einem einzigen Geräte-Write pro Transaktion, wie bei ZFS. Sie haben es gebaut, gemessen und rausgeworfen: Der Gewinn zeigte sich nur bei Queue-Tiefe 1, und die Komplexität war es nicht wert17. Das wiegt bei mir mehr als jedes Benchmark-Diagramm. Es ist ein Entscheidungsprotokoll, das öffentlich sagt: „Wir haben das gebaut, und es hat sich nicht gelohnt.“
Der Write unter 4 KiB
Beim kleineren Write gehen die beiden wirklich auseinander.
Angenommen, ein Client überschreibt 512 Bytes mitten in einem Block, der schon Daten enthält.
Umbrella fährt standardmäßig noch seinen ursprünglichen Schreibpfad; bluestore_write_v2, die Überarbeitung, wird ausgeschaltet ausgeliefert18.
Auf diesem Pfad wird ein Write kleiner als min_alloc_size in einen bereits allokierten Block zu einem Deferred Write19.
Die Daten reisen in der RocksDB-Transaktion als Key unter dem Präfix L mit und gehen erst an ihren eigentlichen Platz, nachdem dem Client schon gesagt wurde, sie seien sicher2021.
Die Daten erreichen das Laufwerk also zweimal. Umbrellas Dokumentation versteckt das nicht: „writes smaller than min_alloc_size must first pass through the BlueStore WAL“4.
FlashStore überschreibt lebende Daten nie an Ort und Stelle, Punkt7. Objekte bis 2 KiB gehen noch weiter und liegen komplett im Baum, sodass ein WAL-Write der ganze Commit ist7.
Das heißt auch: FlashStore hat keine Deferred-Write-Queue, die leerlaufen muss, kein Deferred-Replay beim Mount und keine L-Keys zum Aufräumen.
Es zahlt dafür woanders: Freigegebene Blöcke werden bis zum nächsten Checkpoint zurückgehalten, freier Platz hinkt also bis zu ein Checkpoint-Intervall hinterher7.
Threads gegen Kerne
Die obere Hälfte des OSD unterscheidet sich genauso stark.
Umbrellas ceph-osd ist ein klassischer Thread-Server, und jede Zahl in der linken Hälfte des Diagramms unten ist einer seiner Standardwerte auf Flash22.
Eine Operation durchquert auf ihrem Weg mehrere dieser Pools. Sie teilen sich Zustand hinter Locks.
FlashStore hält die ganze Reise auf einem gepinnten, pollenden Kern, von der Netzwerkkarte bis zum Laufwerk und zurück23. Jede Placement Group gehört genau einem Kern, und genauso alles, was die PG anfasst: „no locks, no atomics, no shared mutable state“24. Verkehr zwischen Kernen läuft über Single-Producer-Ringe, und das Eigentum an der Nachricht wandert mit.
Der Store folgt derselben Aufteilung.
flashstore_store_shards steht standardmäßig auf einem Shard pro Kern, jeder mit eigenem WAL-Ring, Baum und Allocator, und eine PG lebt in genau einem Shard257.
BlueStore ist ein Store pro OSD mit einer RocksDB.
Das hat seinen Preis, und das ADR nennt ihn: „idle cores burn CPU (accepted; optional adaptive sleep later)“23.
Spätere Arbeit hat adaptiven Leerlauf und gerätegetaktete Wartezeiten ergänzt, damit ein Kern bei niedriger Queue-Tiefe nicht die ganze Gerätelatenz lang durchdreht8, aber das Prinzip steht, und flashstore_cores steht standardmäßig auf 8, wenn du keinen Bereich festlegst25.
Du gibst FlashStore ganze Kerne.
Auf einem dedizierten Storage-Node ist das in Ordnung. Auf einer hyperkonvergenten Kiste, auf der dieselben Kerne auch VMs fahren, ist das die erste Rechnung, die du aufmachen musst.
Das Laufwerk muss sein Versprechen halten
BlueStore ist so geschrieben, dass es mit einem Laufwerk zurechtkommt, das darüber lügt, wann Daten sicher sind. FlashStore weigert sich, mit so einem Laufwerk überhaupt etwas zu tun zu haben.
| Umbrella-BlueStore | FlashStore | |
|---|---|---|
| Was einen Write dauerhaft macht | Flush des Blockgeräts vor dem RocksDB-Commit | der abgeschlossene Write auf einem PLP-Laufwerk |
| Flush im heißen Pfad | ja | nein |
| Laufwerk mit flüchtigem Schreibcache | wird genutzt und geflusht | mkfs verweigert es; Host-Check FAIL |
| Übersteuerung | nicht nötig | nur im Lab: FUA-Bit auf jedem dauerhaften Write |
Die BlueStore-Seite ist der schon zitierte kv-Sync-Thread16. Die FlashStore-Seite sind das Durability-ADR und der Host-Check: PLP heißt, das Laufwerk meldet keinen flüchtigen Schreibcache, also bedeutet ein abgeschlossener Write, dass die Daten auf stabilem Medium liegen2426.
Für das Ziel ist das die richtige Entscheidung, aber sei dir im Klaren, was sie ausschließt. Fast jede Consumer-NVMe hat einen flüchtigen Cache und kein PLP, und das gilt auch für eine ordentliche Menge „Datacenter“-Hardware, die über den Preis verkauft wird. Kein PLP, kein FlashStore. Was immer du sonst davon hältst.
Worauf FlashStore nicht läuft
Leg die Anforderungen nebeneinander, und der Zielmarkt ist offensichtlich.
| Umbrella-BlueStore | FlashStore | |
|---|---|---|
| Medien | HDD, SSD, NVMe | nur NVMe |
| Power-Loss-Protection | nicht nötig | Pflicht, mkfs verweigert ohne |
| Sektorformat | 512 B oder 4 KiB | 4 KiB erwartet, sonst Warnung |
| Layout | Partitionen, LVM über ceph-volume | ganze Namespaces, keine Partitionen |
| Separates DB/WAL-Gerät | unterstützt | gibt es nicht |
| Verschlüsselung im Ruhezustand | --dmcrypt über ceph-volume | außerhalb des Umfangs |
| msgr1-Clients | standardmäßig gebunden | verweigert, nur msgr2 |
| Cache-Tiering | veraltet, noch vorhanden | verweigert, Pool wird passiv |
| Kernel-Anforderungen | jeder unterstützte | io_uring: Linux 5.19+, oder RHEL 9s 5.14 mit Backports; Hugepages für SPDK |
Die BlueStore-Spalte ist Umbrellas eigene: ceph-volume verschlüsselt logische Volumes „using dmcrypt by specifying the --dmcrypt flag“27, und ms_bind_msgr1 steht weiterhin standardmäßig auf true28.
Die FlashStore-Spalte stammt aus seiner Hardware-Referenz und seiner Scope-Entscheidung2629.
Zwei davon verdienen mehr als eine Tabellenzeile.
Verschlüsselung im Ruhezustand ist raus, mit Begründung: SPDK umgeht dm-crypt, und Verschlüsselung im Store ist nicht geplant. Die Antwort des ADR sind selbstverschlüsselnde NVMe-Laufwerke oder Verschlüsselung oberhalb des Stores, im Client oder im RGW29. Wenn du eine Compliance-Anforderung hast, die dm-crypt auf dem OSD vorschreibt, ist das heute ein Ausschlussgrund.
msgr1 ist raus, als akzeptiertes Risiko. Kernel-Clients älter als 5.11 und librados von vor Nautilus können mit einem FlashStore-OSD überhaupt nicht reden29. Die meisten Umgebungen sind darüber längst hinaus. Manche nicht, und es ist die alte, vergessene Kiste in der Ecke, die es dann merkt.
Es sagt dem Monitor, es sei BlueStore
Das hier wird Leute erwischen.
Standardmäßig bootet ein FlashStore-OSD und meldet den Monitoren osd_objectstore=bluestore30.
Es versteckt sich nicht. Es fügt seine eigenen Keys flashstore_version und flashstore_build daneben hinzu30.
Der Grund ist Kompatibilität: Ein Umbrella-Monitor erlaubt Features wie EC-Overwrites auf einem Pool nur, wenn jedes OSD darin BlueStore meldet, und Manager-Module wie Prometheus und Telemetry verzweigen auf denselben Wert30.
Das ADR sagt ausdrücklich, dass bluestore hier „is a compat value for mon/mgr feature gates, not a product name“30.
Es gibt einen Schalter, flashstore_report_objectstore=flashstore, der alles umbenennt: die Metadaten, die bluestore_bdev_*-Keys, den Perf-Logger, die Tell-Befehle und die BLUESTORE_*-Health-Codes. Er braucht gepatchte Monitore, und der Standard bleibt bluestore2530.
croits eigene Ceph-Builds bringen diese Patches mit, dort meldet sich FlashStore als flashstore, und nichts von dem, was folgt, trifft zu.
Der Name bluestore ist für die Standard-Monitore und -Manager da, die heute in Produktion laufen.
Ich verstehe, warum.
Ein Monitor-Gate, das an einem String hängt, ist Cephs Design, nicht croits, und sich zu weigern, bluestore zu sagen, würde auf einem ungepatchten Cluster Features abschalten.
Genau das ist die Falle auf einem Standard-Cluster.
Jedes Dashboard, jedes Inventarskript und jedes ceph osd count-metadata osd_objectstore, das du laufen lässt, zählt FlashStore-OSDs als BlueStore.
Während einer Migration, wenn du am dringendsten wissen musst, welche OSDs welche sind, sagt dir das naheliegende Feld rein gar nix.
Prüf also flashstore_version in ceph osd metadata, nicht osd_objectstore.
Schreib das in dein Runbook, bevor das erste FlashStore-OSD reinkommt.
Dieselben Regler, anderes Verhalten
FlashStore liest viele von Cephs bestehenden Optionen, und das ist größtenteils eine gute Nachricht. Nicht jede Option bedeutet, was sie auf Umbrella bedeutet hat, und die, bei denen das nicht so ist, sind die Stellen, an denen ein getunter Cluster überrascht wird.
| Option | Umbrella-BlueStore | FlashStore |
|---|---|---|
compression_mode, pro Pool | none, passive, aggressive, force | dieselben vier, dieselbe Bedeutung |
compression_algorithm | standardmäßig snappy | snappy, zlib, zstd, lz4; zstd-Level fest auf 1 |
bluestore_compression_max_blob_size_ssd | 64 KiB | 64-KiB-Chunks |
osd_memory_target | 4 GiB, Caches live autogetunt | einmal beim Start gelesen, dimensioniert Store-Caches, kein Autotuning |
osd_op_queue | mclock_scheduler | akzeptiert und ignoriert |
osd_mclock_* | aktiv | akzeptiert und ignoriert |
csum_type | crc32c als Standard, xxhash-Varianten verfügbar | crc32c fest; jeder andere Wert loggt eine Warnung31 |
Die Kompression stimmt überein.
BlueStores Standardmodus ist none und sein Standardalgorithmus snappy3233; FlashStore implementiert dieselben vier Modi, dieselben Pool-Optionen und dasselbe 64-KiB-Chunking, und das ADR hält fest, dass ein zu 50 % komprimierbarer 64-KiB-Chunk auf beiden gleich viel Platz belegt34.
Das war nicht immer so vorgesehen. Die ADR-Datei heißt immer noch no-store-compression, nach der ursprünglichen Entscheidung, die gekippt wurde, als croit volle funktionale Parität mit klassischem Ceph zur Vorgabe machte34.
Beim Speicher gibt es keine Parität.
Umbrella tunt BlueStores Caches im laufenden Betrieb automatisch gegen osd_memory_target3536.
FlashStore liest das Ziel einmal beim Start, verteilt es auf seine Shards, und eine Änderung per ceph config set greift erst beim nächsten Neustart37.
Es hält den Prozess auch nicht am Ziel fest: Hugepages, Netzwerkpuffer und PG-Zustand liegen außerhalb davon37.
osd_memory_target dimensioniert also FlashStores Caches. Es deckelt den Speicher des OSD nicht so, wie du es vielleicht gewohnt bist.
Und mClock wird glatt ignoriert37.
Nicht heruntergeregelt. Ignoriert.
Es gibt keinen Op-Scheduler zu konfigurieren, weil jeder Kern seine PGs besitzt.
Recovery und Backfill werden stattdessen über osd_max_backfills, osd_recovery_max_active und die Sleep-Optionen gebremst37.
Wenn du auf Umbrella mClock-Profile für einen Rebuild getunt hast, bewirken diese Einstellungen auf einem FlashStore-OSD nichts, und nichts wird dich warnen.
Keine Konvertierung, in keine Richtung
Du kannst ein BlueStore-OSD nicht in ein FlashStore-OSD umwandeln. croits Migrationsanleitung sagt es klar: „There is no in-place conversion of a BlueStore device“38. Stattdessen bietet sie zwei Reihenfolgen an, und beide sind Backfill38:
| Erst hinzufügen, dann entfernen | Erst freimachen, dann hinzufügen | |
|---|---|---|
| Braucht | einen freien NVMe-Slot | nichts Freies |
| Schritt 1 | FlashStore auf dem neuen Laufwerk vorbereiten | ceph osd out, auf clean warten |
| Schritt 2 | auf active+clean warten | das klassische OSD stoppen und purgen |
| Schritt 3 | das klassische OSD entfernen | FlashStore auf dem freien Laufwerk vorbereiten |
| Risiko währenddessen | keins über normalen Backfill hinaus | eine Kopie weniger, bis der Backfill fertig ist |
Später wird es auch nicht einfacher. FlashStores On-Disk-Format hat Feature-Bits, und ein Mount verweigert ein unbekanntes Bit: „Every format change means mkfs; unknown bits refuse mount (no downgrade)“7. Eine Formatänderung in einem späteren FlashStore-Release ist also dasselbe Leeren und Neubefüllen wie die erste Migration.
Eine Sache hat die Dokumentation falsch.
Die Checkliste der Migrationsanleitung sagt, man solle sicherstellen, dass „the pools do not use erasure coding on croit-flashstore-osd OSDs“38.
Die Erasure-Coding-Anleitung im selben Snapshot sagt, dass FlashStore Legacy-EC-Pools standardmäßig bedient, und der eigene Standard des Codes für optimiertes EC ist all3940.
Eins von beiden ist veraltet, und nach dem Code ist es die Migrationsanleitung.
Ich würde die EC-Anleitung trotzdem komplett lesen, bevor ich EC-Pools über beide Arten von OSD mische, denn der Fehler, den sie beschreibt, ist eine PG, die degradiert, und ein Backfill, der hängen bleibt39.
Ein Store für die Laufwerke, die wir wirklich kaufen
BlueStore wurde gebaut, um auf allem zu laufen. Drehende Platten, billige SSDs, NVMe, Partitionen, LVM, verschlüsselte Volumes, ein schnelles DB-Gerät vor einem langsamen Datengerät. Diese Breite ist der Grund, warum es zum Standard wurde, und der Grund, warum es einen Deferred-Schreibpfad mitschleppt, einen Flush vor jedem Commit, eine Key/Value-Datenbank auf einem eigenen Dateisystem und einen Haufen Threads, die all das in Bewegung halten. Jedes einzelne davon existiert, weil irgendein Laufwerk irgendwo es gebraucht hat.
FlashStore fängt am anderen Ende an. Es nimmt an, dass das Laufwerk NVMe ist, dass es Power-Loss-Protection hat und dass es schnell genug ist, dass jetzt die Software der Flaschenhals ist. Dann wirft es alles raus, was nur für die anderen Laufwerke da war.
Ist das die richtige Wette? Für neue All-Flash-Cluster auf ordentlicher Enterprise-NVMe: ja. Dahin gehen Ceph-Cluster, und ein OSD, das seine Kerne für Locks, Übergaben und eine im Hintergrund kompaktierende Datenbank ausgibt, zahlt jede Sekunde jedes Tages für Flexibilität, die so ein Cluster nie nutzen wird.
Aber die Wette hat ihren Preis, und ich will lieber, dass du ihn siehst, bevor du einsteigst. Du gibst HDD, dm-crypt, msgr1, Live-Speichertuning und mClock auf. Auf einem Standard-Cluster bekommst du ein OSD, das deinen Monitoren erzählt, es sei BlueStore, weil die heutigen Monitore und Manager ihm keinen anderen Weg lassen; croits eigene Builds brauchen das nicht. Du bekommst ein Format, in das du nicht konvertieren kannst und zwischen dessen Versionen du auch nicht konvertieren kannst. Und du bekommst es als Preview, von einem einzigen Anbieter, der zufällig mich beschäftigt.
Nimm also den Quellcode als Beweis, nicht diesen Post und nicht croits Benchmark-Bericht. Die Entscheidungsprotokolle sind öffentlich, und sie sagen, was gemessen und was weggeworfen wurde. Lies sie, bau einen Testcluster auf der Hardware, die du tatsächlich einsetzen würdest, und miss deine eigene Last. Wenn es auf deinen Laufwerken tut, was die ADRs sagen, wirst du es wissen. Wenn nicht, weißt du das auch, und du hast es auf einem Testcluster herausgefunden.
croit ceph-rust, README at snapshot 48f9014 — Komponenten, Status und Roadmap, „not yet recommended for production data“, Wire-kompatibel mit v21.2.0 und v20.2.4. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
ADR 0003, green-field, no Crimson fork — „No fork, no linking of Ceph code“; Ceph-Quellcode als Referenz gelesen, Spezifikationen in eigenen Worten. ↩︎
ADR 0164, licences — Daemon und Werkzeuge LGPL-3.0-only, Client-Bibliotheken MPL-2.0, Doku CC-BY-SA-4.0, und der Grund für MPL. ↩︎ ↩︎
Ceph Umbrella, BlueStore configuration reference — direkter Gerätezugriff, DB-Gerät, „writes smaller than min_alloc_size must first pass through the BlueStore WAL“, Prüfsummen. ↩︎ ↩︎ ↩︎ ↩︎
Ceph Umbrella, storage devices — BlueStore „consumes raw block devices or partitions“; RocksDB eingebettet für interne Metadaten. ↩︎ ↩︎
Ceph v21.2.0,
bluestore_kvbackend— Standardrocksdb. ↩︎ ↩︎ADR 0021, storage engine — COW-B+-Baum pro Shard, WAL-Ring, paralleler Commit, Checkpoints, Inline-Daten, zurückgehaltene Freigaben, „Every format change means mkfs“. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
ADR 0004, storage I/O — SPDK über vfio, ergänzt um zwei Stufen mit io_uring, gerätegetakteter Leerlauf. ↩︎ ↩︎
ceph-rust docs, prepare and activate —
spdkist das Standard-Backend,kernelundkernel-cmdlassen die NVMe beim Kernel-Treiber. ↩︎Ceph v21.2.0,
bluestore_allocator— Standardhybrid. ↩︎Ceph v21.2.0,
bluestore_csum_type— Standardcrc32c. ↩︎ceph-rust, croit-flashstore-tool usage — „fresh prepare/mkfs –omap-engine btree|lsm|rocksdb“. ↩︎
Ceph v21.2.0,
bluestore_min_alloc_size_ssd— Standard 4 KiB. ↩︎Ceph v21.2.0,
bluestore_prefer_deferred_size_ssd— Standard 0. ↩︎Ceph v21.2.0,
BlueStore.cc, transaction state machine — ausstehende aios versetzen die Transaktion inSTATE_AIO_WAIT, bevor sie für den Key/Value-Commit eingereiht wird. ↩︎Ceph v21.2.0,
BlueStore.cc, kv sync thread — „flush/barrier on block device“ vor dem RocksDB-Submit. ↩︎ ↩︎ADR 0027, single-IO atomic commit, rejected — „gain only at QD1“, gebaut und wieder entfernt. ↩︎
Ceph v21.2.0,
bluestore_write_v2— „Use faster write path“, Standard false. ↩︎Ceph v21.2.0,
BlueStore.cc,_do_write_small— Kopf und Ende lesen, dann „chunk-aligned deferred overwrite“. ↩︎Ceph v21.2.0,
BlueStore.cc, “journal deferred items” — die Deferred-Transaktion wird als Key in derselben RocksDB-Transaktion gesetzt. ↩︎Ceph v21.2.0,
BlueStore.cc, key prefixes —PREFIX_DEFERRED = "L". ↩︎Thread-Standardwerte in Ceph v21.2.0 —
osd_op_num_shards_ssd8;osd_op_num_threads_per_shard_ssd2;osd_op_queuemclock_scheduler;ms_async_op_threads3;BlueStore.ccthread creation,bstore_kv_syncundbstore_kv_final. ↩︎ADR 0006, thread-per-core runtime — ein gepinnter, busy-pollender Thread pro Kern, PGs gehören einem Kern, „idle cores burn CPU (accepted …)“. ↩︎ ↩︎
ADR 0008, concurrency and durability — „no locks, no atomics, no shared mutable state“; PLP Pflicht,
mkfsverweigert Nicht-PLP, FUA-Übersteuerung fürs Lab. ↩︎ ↩︎ceph-rust docs, configuration reference —
flashstore_coresStandard 8,flashstore_store_shardsauto,flashstore_report_objectstore. ↩︎ ↩︎ ↩︎ceph-rust docs, hardware and host requirements — flüchtiger Schreibcache FAIL, 4-KiB-LBA, keine Partitionen, Kernel- und io_uring-Anforderungen. ↩︎ ↩︎
Ceph Umbrella, ceph-volume encryption — „Logical volumes can be encrypted using dmcrypt by specifying the
--dmcryptflag“. ↩︎Ceph v21.2.0,
ms_bind_msgr1— Standard true. ↩︎ADR 0168, encryption at rest, msgr1, cache tiering out of scope — „SPDK bypasses dm-crypt“; reine v1-Clients „cannot reach croit-flashstore-osd“. ↩︎ ↩︎ ↩︎
ADR 0019, report
osd_objectstore=bluestore— die Feature-Gates des Monitors, die zusätzlichenflashstore_*-Keys und die Meldeoptionflashstore. ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ceph-rust,
pgs.rs— „csum_type {v} unsupported; using fixed crc32c per 4096-byte block“. ↩︎Ceph v21.2.0,
bluestore_compression_mode— Standardnone. ↩︎Ceph v21.2.0,
bluestore_compression_algorithm— Standardsnappy. ↩︎ADR 0059, per-pool store compression — dieselben Modi und Optionen wie BlueStore, zstd-Level fest auf 1, Platzbedarf bei 50 % Komprimierbarkeit „identical to BlueStore“. ↩︎ ↩︎
Ceph v21.2.0,
osd_memory_target— Standard 4 GiB. ↩︎Ceph v21.2.0,
bluestore_cache_autotune— Standard true. ↩︎ADR 0062, memory target and mClock — Ziel einmal gelesen, kein Autotuning, RSS nicht erzwungen; mClock-Optionen „ACCEPTED and IGNORED“. ↩︎ ↩︎ ↩︎ ↩︎
ceph-rust docs, migrate from classic — „There is no in-place conversion of a BlueStore device“; die zwei Reihenfolgen; die EC-Zeile der Checkliste. ↩︎ ↩︎ ↩︎
ceph-rust docs, erasure-coded pools —
ec_enable_poolsStandardall,ec_enable_optimizedStandardall, und wie ein abgelehnter Pool aussieht. ↩︎ ↩︎ceph-rust, OSD config defaults —
("ec_enable_optimized", "all"). ↩︎