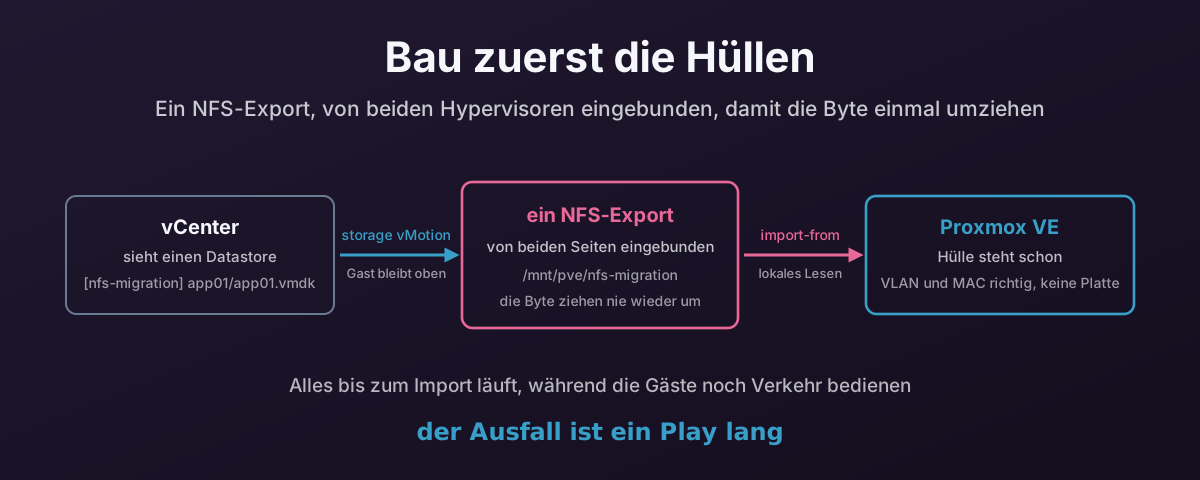
Diesmal existiert der Host. Er sitzt bloß auf dem falschen Hypervisor
Letztes Mal war das Problem, dass die im Inventar genannte Maschine noch nicht existierte — keine IP, kein SSH, kein Python, nichts, wohin man verbindet. Jeder Task musste von ihr weg delegiert werden.
Eine VMware-Migration dreht das um und ändert nichts. Die Maschine existiert, sie läuft, Leute benutzen sie. Du verbindest dich trotzdem nie zu ihr. Sie ist ein Name und ein Sack Variablen, die etwas beschreiben, das woanders neu zu bauen ist. Jeder Task läuft weiter auf dem Steuerknoten, und jetzt sind am anderen Ende zwei APIs statt einer.
Ein Wort dazu, was das ist. Dieser Beitrag ist der Entwurf und das Playbook, keine Kriegsgeschichte. Ich habe es noch nicht von Anfang bis Ende gegen einen produktiven Bestand laufen lassen. Alles, was ich unten über das Verhalten der Module sage, wurde aus dem ausgelieferten Code gelesen und geprüft, und ich habe klar gesagt, wo eine Aussage aus der Quelle kommt und nicht aus einem Lauf. Wenn ich damit eine echte Migration gemacht habe, bekommen die Zahlen und die Überraschungen ihren eigenen Beitrag.
Die Fassungen, gegen die das geprüft wurde:
$ ansible --version | head -1
ansible [core 2.20.7]

$ ansible-galaxy collection list | grep -E 'vmware|proxmox'
community.proxmox 1.6.0
community.vmware  6.2.1
vmware.vmware     2.9.0
Die Ausschnitte unten sind aus einem einzelnen Playbook geschnitten — migrate.yml, ein dynamisches
vSphere-Inventar in inventory/vmware.vms.yml und ein group_vars/all.yml. Ich habe die Namen
von Datacenter, Knoten und Speicher der Lesbarkeit zuliebe verallgemeinert.
Die Form der Aufgabe
Fünf Schritte, und nur der letzte kostet etwas.
Die Reihenfolge ist der ganze Entwurf. Entdecken ändert nichts. Das Netz zu bauen ändert nur Proxmox. Die Hüllen zu bauen ändert nur Proxmox, und eine Hülle ohne Platte ist billig zu löschen. Die Platten zu bewegen ist langsam, aber im Betrieb. Nur das letzte Play schaltet etwas ab.
Geh auf halbem Weg weg, und jeder Gast läuft weiter auf VMware, unberührt.
Zwei Collections, und eine davon wird abgewickelt
Du brauchst beide, und nicht aus dem Grund, den du vermuten würdest.
collections:
  - name: community.vmware
    version: ">=6.2.1"
  - name: vmware.vmware
    version: ">=2.5.0"
  - name: community.proxmox
    version: ">=1.6.0"
community.vmware ist die alte, breite Collection, und sie wird auseinandergenommen. Ihre MANIFEST.json erklärt {"vmware.vmware": ">=2.5.0"} als harte Abhängigkeit, die erste zu installieren zieht also die zweite mit, ob du danach gefragt hast oder nicht. Module ziehen eines nach dem anderen um, und die, nach denen man in einer Migration greift, stehen an verschiedenen Punkten dieses Umzugs:
vmware_dvs_portgroup_info— noch nur incommunity.vmware, und es ist das, was deine VLANs liest.vmware_vmotion— noch nur incommunity.vmware.vmware_guest_powerstate— abgekündigt, entfernt incommunity.vmware7.0.0. Nimmvmware.vmware.vm_powerstate.vmware_vm_inventory— abgekündigt, entfernt in 7.0.0. Nimmvmware.vmware.vms.
Ansible sagt dir beim ersten Lauf von den Modul-Abkündigungen, was anständig ist:
[DEPRECATION WARNING]: community.vmware.vmware_guest_powerstate has been deprecated.
Use vmware.vmware.vm_powerstate instead. This feature will be removed from
collection 'community.vmware' version 7.0.0.
Vom Inventar-Plugin sagt es dir nichts, denn Inventar-Plugins werden ausgewertet, bevor diese Maschinerie läuft. Da musst du hingehen und das Plugin lesen.
In der Aufteilung steckt ein dritter Fallstrick. vmware.vmware.vm_portgroup_info sieht aus wie genau das, was eine Netzmigration will — je VM, je NIC, gibt dir die Portgruppe und das VLAN. Aber es baut auf ModuleRestBase auf und importiert com.vmware.vapi, was heißt, dass es das vSphere Automation SDK auf dem Steuerknoten braucht, nicht bloß pyVmomi. Seine dokumentierte Rückgabe ist auch veraltet: der RETURN-Block verspricht name und vlan_id, während der Code tatsächlich portgroup_name und für den verteilten Fall ein vlan_info-Dict baut. Ich bin unten einen anderen Weg gegangen und brauchte keins von beiden.
Das Inventar ist die Entdeckung
Es gibt in diesem Playbook kein „geh und finde die VMs“-Play, denn bis der erste Task läuft, hat das Inventar es schon getan — in einer Abfrage des Property Collectors statt in einer Schleife je VM.
# inventory/vmware.vms.yml
plugin: vmware.vmware.vms

hostname: "{{ lookup('ansible.builtin.env', 'VMWARE_HOST') }}"
username: "{{ lookup('ansible.builtin.env', 'VMWARE_USER') }}"
password: "{{ lookup('ansible.builtin.env', 'VMWARE_PASSWORD') }}"
validate_certs: false

search_paths:
  - /Datacenter-1

properties:
  - name
  - config.name
  - config.uuid
  - config.guestId
  - config.firmware
  - config.template
  - config.hardware.numCPU
  - config.hardware.numCoresPerSocket
  - config.hardware.memoryMB
  - config.hardware.device
  - summary.runtime.powerState

gather_compute_objects: true
hostnames: ['name']
filter_expressions:
  - 'config.template'
Der Dateiname zählt. Das verify_file des Plugins beansprucht nur Dateien, die auf vms.yml, vms.yaml, vmware_vms.yml oder vmware_vms.yaml enden. Nenn sie vcenter.yml, und sie ist still nicht dein Inventar.
search_paths filtert vor der Abfrage, nicht danach. Auf einem großen Bestand ist das der Unterschied zwischen Sekunden und Minuten — anders als filter_expressions, wozu die Dokumentation ausdrücklich ist: es läuft nach dem Sammeln und „does not affect the speed of the inventory plugin“.
filter_expressions verwirft einen Host, wenn der Ausdruck wahr ist. config.template entfernt daher Templates, was sich beim ersten Mal verkehrt liest.
Und die wichtige Zeile ist config.hardware.device, die in keiner voreingestellten Property-Liste irgendwo steht. Es ist das ganze Hardware-Inventar der VM, und es trägt drei Dinge, ohne die diese Migration nicht weiterkommt: die MAC jeder NIC, den dvportgroup-Schlüssel, an dem jede NIC hängt, und den Datastore-Pfad jeder Platte. Ohne es bist du zurück bei einer vmware_guest_info-Schleife, ein Hin und Her je VM.
Die Geräte kommen als JSON zurück, mit ihrem vSphere-Typ in _vimtype erhalten. Das ist zu wissen wert, denn so unterscheidest du eine NIC von einer Platte. Ich habe den Encoder gelesen statt zu raten:
{
  "_vimtype": "vim.vm.device.VirtualVmxnet3",
  "macAddress": "00:50:56:87:a5:9a",
  "backing": {
    "_vimtype": "...DistributedVirtualPortBackingInfo",
    "port": {
      "_vimtype": "vim.dvs.PortConnection",
      "portgroupKey": "dvportgroup-1014"
    }
  }
}
Ein compose-Block kann die unbequemen Pfade also in flache Hostvars hochziehen:
compose:
  vm_moid: moid
  vm_firmware: config.firmware
  vm_memory_mb: config.hardware.memoryMB
  vm_num_cpu: config.hardware.numCPU

  # A virtual NIC is any device with a MAC. Filtering on _vimtype does not
  # work cleanly here, because VMXNET3, E1000 and SR-IOV cards are all
  # different types with no shared substring.
  vm_nics: >-
    config.hardware.device
    | selectattr('macAddress', 'defined')
    | selectattr('macAddress', 'ne', None) | list

  # Disks are one exact type, so this one can match on it.
  vm_disks: >-
    config.hardware.device
    | selectattr('_vimtype', 'eq', 'vim.vm.device.VirtualDisk') | list
Diese Unsymmetrie ist echt, und sie erwischt Leute. Es gibt keinen Typ VirtualEthernetCard, auf den man passen könnte. Das ist die abstrakte Basisklasse, und was vCenter dir tatsächlich gibt, ist VirtualVmxnet3, VirtualE1000, VirtualE1000e, VirtualPCNet32 oder VirtualSriovEthernetCard. Es gibt keine Teilzeichenkette, die alle gemeinsam haben. Eine MAC zu haben ist allerdings etwas, das nur eine NIC tut.
Jedes Info-Modul versteckt das Feld, das du brauchst
Das ist der rote Faden der ganzen Aufgabe, und wenn du es dreimal gesehen hast, fängst du an, jede Voreinstellung zu prüfen, bevor du den Task schreibst.
vmware_dvs_portgroup_info hat sechs show_*-Optionen. Fünf stehen voreingestellt auf true. Die sechste ist show_vlan_info, und sie steht auf false.
show_mac_learning=dict(type='bool', default=True),
show_network_policy=dict(type='bool', default=True),
show_teaming_policy=dict(type='bool', default=True),
show_uplinks=dict(type='bool', default=True),
show_port_policy=dict(type='bool', default=True),
show_vlan_info=dict(type='bool', default=False),
Lass es in Ruhe, und du bekommst MAC-Learning-Richtlinie, Teaming-Richtlinie, Uplink-Reihenfolge und Port-Richtlinie für jede Portgruppe im Bestand. Alles außer dem VLAN-Tag, dem einzigen Feld, nach dem eine Netzmigration tatsächlich fragt. Der Task ist also verkehrt herum zu dem, was du aus dem Bauch schreiben würdest: schalte das eine Ding an, schalte die anderen fünf aus.
- name: Read the distributed portgroups
  community.vmware.vmware_dvs_portgroup_info:
    datacenter: "{{ vcenter_datacenter }}"
    show_vlan_info: true
    show_network_policy: false
    show_teaming_policy: false
    show_port_policy: false
    show_mac_learning: false
    show_uplinks: false
  register: dvs_pgs
Es ist kein Einzelfall. vmware.vmware.vms hat gather_compute_objects, das cluster und esxi_host füllt — voreingestellt false. community.vmware.vmware_vm_info hat show_allocated, den Block mit CPU und Speicher — voreingestellt false. In allen drei Fällen ist das teuer zu sammelnde Feld das, das die Migration braucht, und die Voreinstellung schützt einen nur lesenden Berichtsfall, der nicht der ist, in dem du steckst.
vlan_id ist drei verschiedene Typen
Dann bekommst du die VLAN-Tags und stellst fest, dass sie nicht eine Form haben. Direkt aus get_vlan_info:
if isinstance(vlan_obj, vim...TrunkVlanSpec):
    ...
    return dict(trunk=True, pvlan=False, vlan_id=vlan_id_list)
elif isinstance(vlan_obj, vim...PvlanSpec):
    return dict(trunk=False, pvlan=True, vlan_id=str(vlan_obj.pvlanId))
else:
    return dict(trunk=False, pvlan=False, vlan_id=str(vlan_obj.vlanId))
Eine Access-Portgruppe gibt dir die Zeichenkette "100". Ein PVLAN gibt eine Zeichenkette. Ein Trunk gibt eine Liste von Zeichenketten, jede entweder "20" oder "20-30". Und jeder verteilte Switch hat mindestens einen Trunk, ob du einen gemacht hast oder nicht, denn die Uplink-Portgruppe ist ein Trunk, der "0-4094" trägt.
| int steht dir also nicht zur Verfügung, bis du die anderen zwei Formen weggeworfen hast:
access_pgs: >-
  {{ dvs_pgs.dvs_portgroup_info | dict2items | map(attribute='value') | flatten
     | rejectattr('vlan_info.trunk') | rejectattr('vlan_info.pvlan')
     | rejectattr('vlan_info.vlan_id', 'in', ['0', 0])
     | list }}
Drei Rejects, in dieser Reihenfolge. Trunks gehen, PVLANs gehen, und dann gehen die untagged Portgruppen, was auch die Uplink-Gruppen und alles auf VLAN 0 erledigt.
Ich übersetze Trunks und PVLANs nicht automatisch, und ich würde bei jedem widersprechen, der das täte. Ein VMware-Trunk, der auf Proxmox landet, braucht entweder eine Q-in-Q-Zone oder ein VLAN-fähiges VNet, und welches richtig ist, hängt davon ab, was der Gast zu sehen erwartet. Das ist eine Entscheidung, keine Abbildung. Das Playbook gibt sie aus und macht weiter:
TASK [Report what was found]
ok: [localhost] => {
    "msg": "3 access portgroups -> [100, 200]. Not translated:
            ['dvs_001-uplink'] (trunks), ['isolated'] (PVLANs)."
}
Die VLANs in SDN spiegeln
Eine VLAN-Zone, an eine Bridge gebunden, dann ein VNet je VLAN mit dem Tag darauf.
- name: Create the VLAN zone
  community.proxmox.proxmox_zone:
    zone: "{{ sdn_zone }}"
    type: vlan
    bridge: "{{ sdn_bridge }}"
    mtu: "{{ sdn_mtu }}"
    state: present

- name: Create one VNet per VMware VLAN
  community.proxmox.proxmox_vnet:
    vnet: "{{ sdn_vnet_prefix }}{{ item.vlan_info.vlan_id | int }}"
    zone: "{{ sdn_zone }}"
    tag: "{{ item.vlan_info.vlan_id | int }}"
    alias: "{{ item.portgroup_name }}"
    state: present
  loop: "{{ access_pgs | unique(attribute='vlan_info.vlan_id') }}"
  throttle: 1
VNet-Namen sind kurz und eingeschränkt, VMware-Portgruppennamen nicht. Production-Web-Tier-VLAN100 ist ein völlig gewöhnlicher Portgruppenname und ein unmöglicher VNet-Name. Der Name wird also erzeugt — v100, aus dem Tag —, und das für Menschen lesbare Original geht in alias, wo es in der Oberfläche und in der pvesh-Ausgabe sichtbar bleibt. Den Namen aus dem VLAN statt aus der Portgruppe abzuleiten heißt auch, dass die Abbildung in sechs Monaten durch Hinsehen umkehrbar ist.
Zwei Portgruppen auf demselben VLAN fallen in ein VNet zusammen. Das ist richtig — sie waren in VMware auch dieselbe Broadcast-Domäne —, aber du solltest es passieren sehen, und dafür ist unique(attribute='vlan_info.vlan_id') da. Zwei Portgruppen namens prod-web und prod-web-b, beide auf VLAN 100, ergeben ein v100.
throttle: 1 ist keine Vorsicht, es ist das Modul. Jeder SDN-Schreibvorgang in community.proxmox nimmt eine globale Cluster-Sperre, wendet die anstehende Konfiguration an und gibt sie frei — get_global_sdn_lock(), dann apply_sdn_changes_and_release_lock(). Lauf sie parallel, und sie stehen ohnehin an der Sperre Schlange; die Drossel hört bloß auf, etwas anderes vorzugeben. Auch zu wissen wert: das Zurückrollen im Fehlerfall hängt von der Fassung ab — das Modul prüft is_lock_and_rollback_supported und sagt dir auf älterem PVE, dass es nicht zurückrollen konnte, statt es zu tun.
Eine kosmetische Sache, die dich an dir zweifeln lässt. In 1.6.0 gibt proxmox_vnet bei jedem einzelnen Anlegen sein ganzes Params-Dict als Ansible-Warnung aus:
self.module.warn(f"{vnet_params}")
self.proxmox_api.cluster().sdn().vnets().post(**vnet_params)
Das ist eine Debug-Zeile, die jemand liegen gelassen hat. Es ist Lärm, kein Fehler.
Bau die Hüllen, ohne Platten
Jetzt die VMs, und hier verdient sich der Entwurf. Jede VM wird in Proxmox mit der richtigen Kernzahl, dem richtigen Speicher, der richtigen Firmware und den richtigen NICs auf den richtigen VLANs gebaut. Überhaupt keine Platten.
Eine plattenlose Hülle ist schnell angelegt, umsonst gelöscht und bootet zu einer PXE-Eingabe, wenn jemand sie versehentlich startet. Du kannst vierhundert davon an einem Nachmittag bauen, das Ergebnis ansehen, entscheiden, dass es falsch ist, alles löschen und es wieder machen. Nichts wurde kopiert, nichts wurde abgeschaltet, und niemand hat es gemerkt.
Die abgeleiteten Werte sind Erklärungen, keine Tasks. Ansible wertet sie faul gegen den Host aus, der gerade im Blick ist, jede VM bekommt also ihre eigenen, ohne ein einziges set_fact:
# group_vars/all.yml
pve_vmid: "{{ vmid_base | int + (vm_moid | regex_replace('^vm-', '') | int) }}"
pve_bios: "{{ 'ovmf' if vm_firmware == 'efi' else 'seabios' }}"
pve_cores: "{{ vm_cores_per_socket | int }}"
pve_sockets: "{{ ((vm_num_cpu | int) / (vm_cores_per_socket | int)) | round(0, 'ceil') | int }}"
Die VMID kommt aus der vCenter-MoID. vm-42 wird 20042. Das zählt mehr, als es aussieht: das Umschalt-Play muss die VM finden, die das Bau-Play angelegt hat, und ein zweiter Lauf muss auf derselben landen, statt still eine zweite zu bauen. Die API die nächste freie ID zuteilen zu lassen — was passiert, wenn du vmid weglässt, und worüber ich letztes Mal geschrieben habe — macht das unmöglich.
Der Speicher braucht keine Umrechnung. VMware meldet config.hardware.memoryMB, und Proxmox will MB. Sockel schon: VMware gibt dir vCPUs insgesamt und Kerne je Sockel, Proxmox will Sockel und Kerne.
- name: Create the VM shell
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    name: "{{ inventory_hostname }}"
    cores: "{{ pve_cores }}"
    sockets: "{{ pve_sockets }}"
    memory: "{{ vm_memory_mb }}"
    ostype: "{{ pve_ostype }}"
    bios: "{{ pve_bios }}"
    scsihw: "{{ default_scsihw }}"
    efidisk0: "{{ {'storage': pve_target_storage, 'efitype': '4m',
                   'pre_enrolled_keys': false}
                  if pve_bios == 'ovmf' else omit }}"
    agent: "enabled=1"
    onboot: false
    state: present
onboot: false mit Absicht. Nichts sollte mitten in einer Migration von selbst starten, am wenigsten eine Maschine, auf deren Platten noch ein anderer Hypervisor schreibt.
Die Firmware richtig zu haben ist nicht wahlfrei. Ein UEFI-Gast, der auf eine SeaBIOS-VM importiert wird, importiert einwandfrei und weigert sich dann zu booten, und du verbringst eine Stunde damit. config.firmware ist efi oder bios und bildet direkt auf ovmf und seabios ab. Ein UEFI-Gast braucht auch eine EFI-Variablenplatte, die mit der VM angelegt werden muss — unten steht, warum.
proxmox_kvm richtet keine NIC und sagt es dir nicht
Letztes Mal habe ich geschrieben, dass proxmox_kvm sich verweigert statt zu aktualisieren. Hier ist die schärfere Fassung davon, die mich beim Schreiben gebissen hat und es wert ist, genau zu sein.
update steht voreingestellt auf false, ein zweiter Lauf gegen eine VM, die schon existiert, tut also nichts. In Ordnung, und dokumentiert. Aber setz update: true, und das Modul weigert sich weiterhin, manche Parameter anzufassen:
# If update, don't update disk (virtio, efidisk0, tpmstate0, ide, sata, scsi)
# and network interface, unless update_unsafe=True
if update_unsafe is False:
    ...
    if "efidisk0" in kwargs:
        del kwargs["efidisk0"]
Es löscht sie aus der Anfrage und macht weiter. Du korrigierst also eine NIC in deiner Inventar-Abbildung, läufst mit update: true neu, siehst Ansible changed melden, und die NIC ist genau so falsch wie vorher. Das changed ist wahr — irgendetwas anderes in der Nutzlast wurde aktualisiert — aber nicht das, was du beheben wolltest.
update_unsafe: true hebt die Einschränkung auf, und der Name ist ehrlich. Dieselbe Sperre deckt Platten ab, auf einer VM mit Platten ist ein unsicheres Update also ein guter Weg, eine zweite Kopie einer davon zu bekommen. Das ist kein Schalter, nach dem man in einer Migration greift.
Der Ausweg ist, net überhaupt nicht zu nutzen. NICs kommen mit proxmox_nic dran, einem Modul, dessen ganze Aufgabe eine Schnittstelle ist und das richtig konvergiert:
- name: Attach each NIC to its VNet
  delegate_to: localhost
  community.proxmox.proxmox_nic:
    vmid: "{{ pve_vmid }}"
    interface: "net{{ idx }}"
    bridge: "{{ sdn_vnet_prefix }}{{ pg_vlan[item.backing.port.portgroupKey] }}"
    mac: "{{ item.macAddress }}"
    model: "{{ default_net_model }}"
    state: present
  loop: "{{ vm_nics }}"
  loop_control:
    index_var: idx
Das ist dieselbe Aufteilung, bei der ich letztes Mal gelandet bin: proxmox_kvm, um die Maschine zu beschreiben, proxmox_disk und proxmox_nic für die Dinge, die sich danach ändern. Der Parameter heißt mac, nicht mac_addr.
efidisk0 lässt sich nicht auf dieselbe Weise auslagern — proxmox_disk hat kein efitype und kein pre_enrolled_keys —, es muss also beim Anlegen dran und beim ersten Mal richtig sein.
Nimm die MAC mit. VMware teilt MACs aus 00:50:56:... zu, und Proxmox nimmt sie ohne Murren. Sie zu behalten heißt, dass DHCP-Reservierungen weiter passen, MAC-gebundene Lizenzen weiter gelten und jede Firewall-Regel, die gegen eine MAC geschrieben ist, weiter greift. Sie zu ändern heißt einen Tag voll kleiner Rätsel. proxmox_nic nimmt auch model: vmxnet3, wenn der Gast dieselbe Karte sehen soll wie vorher, aber auf KVM ist virtio die bessere Karte, und ein Windows-Gast will so oder so neue Treiber.
Verweigern statt raten
Eine NIC auf einer Standard-Portgruppe hat überhaupt kein backing.port. Ihr Backing ist ein NetworkBackingInfo mit einem deviceName. Sie steht nicht in der Abbildung, und das Richtige ist anzuhalten:
- name: Every NIC must sit on a distributed portgroup with a VNet
  ansible.builtin.assert:
    that:
      - vm_nics | rejectattr('backing.port.portgroupKey', 'defined') | list | length == 0
      - vm_nics | map(attribute='backing.port.portgroupKey')
          | reject('in', pg_vlan.keys() | list) | list | length == 0
    fail_msg: >-
      {{ inventory_hostname }} has NICs that do not map to a Proxmox VNet.
      Attaching it to the wrong network is worse than not building it.
Zwei Bedingungen statt einer, denn die erste muss vor der zweiten laufen: map(attribute=...) über eine NIC ohne port würde am undefinierten Zugriff platzen. Wirf die formlosen zuerst weg, dann prüf den Rest gegen die Abbildung.
Ein Export, zweimal eingebunden
Hier ist der Teil, der das Ganze billig macht.
Stell einen NFS-Export dorthin, wo beide Hypervisoren ihn einbinden können. vCenter sieht einen Datastore namens nfs-migration; die Proxmox-Knoten binden denselben Export ein und sehen /mnt/pve/nfs-migration. Jetzt storage-vMotion die VMDKs dorthin.
Storage vMotion ist im Betrieb. Der Gast bedient die ganze Zeit weiter Verkehr. Nichts wird umgeschaltet, kein Fenster ist nötig, und es kann auf halbem Weg aufgegeben werden, ohne Folgen über verschwendetes I/O hinaus. Es ist mit weitem Abstand die langsamste Stufe, und es kostet nichts.
- name: Relocate to the NFS datastore
  delegate_to: localhost
  throttle: 2
  community.vmware.vmware_vmotion:
    moid: "{{ vm_moid }}"
    destination_datastore: "{{ nfs_datastore_vmware }}"
    timeout: "{{ vmotion_timeout }}"
timeout steht voreingestellt auf 3600 — eine Stunde. Eine VMDK mit 2 TB schafft das nicht, und der Fehlerfall ist auf eine stille Weise unangenehm: der Ansible-Task scheitert, während die vMotion in vCenter weiterläuft. Du hast jetzt ein Playbook, das sagt, es sei gescheitert, und einen Bestand, der noch beschäftigt ist. Setz ihn auf etwas, das deinen tatsächlichen Speicher widerspiegelt.
throttle: 2, denn der Engpass ist nicht der Steuerknoten. Storage vMotion ist vom Array und vom Netz begrenzt. Sechs gleichzeitig geben dir nicht den sechsfachen Durchsatz; sie geben dir sechs langsame Migrationen und ein wütendes Speicher-Team.
Das Modul ist auf die Weise idempotent, die du willst — es setzt storage_vmotion_needed = False, wenn die VM schon auf dem Ziel-Datastore liegt —, ein zweiter Lauf zum Aufsammeln von Nachzüglern ist also sicher.
Bis das fertig ist, sitzen die Byte auf Speicher, den Proxmox schon eingebunden hat. Damit muss sie nichts weiter kopieren. Nie.
Die Umschaltung
Das ist das einzige Play, das Ausfallzeit kostet, und die Reihenfolge darin ist nicht verhandelbar.
Zuerst ein Problem, das leicht zu übersehen ist: das Inventar ist jetzt veraltet. Es wurde vor der vMotion gesammelt, vm_disks hält also noch die alten Datastore-Pfade. Importiere von denen, und du zeigst Proxmox auf einen Pfad, den es nicht sehen kann.
- name: Re-read the inventory now the disks have moved
  ansible.builtin.meta: refresh_inventory
Und deshalb ist das Zwischenspeichern in der Inventar-Konfiguration abgeschaltet. Ein warmer Cache würde refresh_inventory genau die veralteten Daten zurückgeben, zu deren Ersatz es aufgerufen wurde. Das ist eine echte Abwägung — vCenter ist nicht schnell —, aber ein falscher Pfad hier ist eine gescheiterte Umschaltung in einem Fenster, und das Hin und Her ist dagegen billig.
Dann abschalten. Eine VMDK zu importieren, die ein ESXi-Host noch offen hat, gibt dir bestenfalls eine absturzkonsistente Kopie:
- name: Shut the guest down in VMware
  delegate_to: localhost
  vmware.vmware.vm_powerstate:
    moid: "{{ vm_moid }}"
    state: "{{ 'shutdown-guest' if vm_power_state == 'poweredOn' else 'powered-off' }}"
    timeout: 600
    force: true
shutdown-guest ist ein sanftes Herunterfahren über die VMware Tools; force: true stoppt alles hart, was nicht innerhalb der Zeit geht. Am neuen Modul heißt der Parameter timeout, nicht state_change_timeout wie am abgekündigten.
Dann der Import, der der Dreh- und Wendepunkt ist:
- name: Import each VMDK onto its VM
  delegate_to: localhost
  throttle: 2
  community.proxmox.proxmox_disk:
    vmid: "{{ pve_vmid }}"
    disk: "scsi{{ idx }}"
    storage: "{{ pve_target_storage }}"
    import_from: >-
      {{ item.backing.fileName
         | regex_replace('^\[[^\]]+\]\s*', '/mnt/pve/' ~ nfs_storage_pve ~ '/') }}
    format: "{{ pve_target_format }}"
    timeout: "{{ import_timeout }}"
    create: regular
    state: present
  loop: "{{ vm_disks }}"
  loop_control:
    index_var: idx
Das regex_replace erledigt die Übersetzung zwischen den zwei Welten. vCenter nennt eine Platte [nfs-migration] app01/app01.vmdk; Proxmox erreicht dieselbe Datei unter /mnt/pve/nfs-migration/app01/app01.vmdk. Derselbe Export, dieselben Byte, keine zweite Kopie. Du behältst die Deskriptor-.vmdk und ignorierst die -flat.vmdk daneben — qemu-img liest den Deskriptor und folgt ihm zum Extent.
Drei Dinge zu import_from, alle im Modul und alle zu wissen wert, bevor das Fenster aufgeht.
Es greift nur beim Anlegen. Im Update-Zweig:
# 'import_from' fails on disk updates
playbook_config = self.get_create_attributes()
playbook_config.pop("import_from", None)
Existiert scsi0 auf dieser VM schon, wird der Parameter verworfen, und du bekommst ein gewöhnliches Update. Ein zweiter Lauf nach einem schlechten Import importiert also nicht neu. Er tut still überhaupt nichts und meldet Erfolg. Geht ein Import schief, lösch die Platte, bevor du es wieder versuchst.
timeout steht voreingestellt auf 600 Sekunden. Zehn Minuten, um die Platte einer virtuellen Maschine zu importieren und umzuwandeln. Die eigene Dokumentation des Moduls sagt, ihn zu erhöhen; nimm den Rat an.
Und ein absoluter Pfad braucht root. Die Dokumentation ist unverblümt:
<STORAGE>:<VMID>/<FULL_NAME>or<ABSOLUTE_PATH>/<FULL_NAME>.<STORAGE>:import/<FULL_NAME>for PVE 9.x and later, to use storage’s import directory. Attention! Only root can use absolute paths.
Das landet unbequem neben dem Rat, den ich letztes Mal gegeben habe und zu dem ich stehe: nimm ein eingegrenztes API-Token, nicht root. Dieser Rat hält für jede andere Stufe hier: Entdecken, SDN, Hüllen bauen, Bootreihenfolge setzen laufen mit einem Token gut. Dieser eine Task nicht, und keine Menge Rechte auf der Rolle wird das ändern, denn die Einschränkung hängt daran, dass der Nutzer root ist, und nicht an einer Berechtigung.
Es gibt drei ehrliche Auswege und keinen klugen vierten:
- PVE 9.x: nimm
<storage>:import/<file>und bleib beim Token. - PVE 8.x: mach diesen einen Task als
root@pam, und nur diesen. - PVE 8.x, kein root über die API: lass stattdessen
qm importdisküber SSH laufen.
Das Playbook nimmt die ersten zwei über ein Flag, denn etwas anderes vorzugeben würde das Problem bloß zu dem verschieben, der es laufen lässt.
Schließlich die Bootreihenfolge, die ein gewöhnliches Update ist und daher von der update_unsafe-Einschränkung unberührt bleibt:
- name: Boot from the first imported disk
  delegate_to: localhost
  community.proxmox.proxmox_kvm:
    node: "{{ proxmox_node }}"
    vmid: "{{ pve_vmid }}"
    boot: "order=scsi0"
    update: true
Nichts startet den Gast. Das ist Absicht. Starte ihn von Hand, sieh zu, wie er hochkommt, und denk erst dann daran, in VMware etwas zu löschen.
Es laufen lassen
Das Ganze ist ein Playbook, nach Stufen getaggt, denn das sind keine Schritte, die man zusammen laufen lassen will:
ansible-playbook migrate.yml --tags discover   # look, change nothing
ansible-playbook migrate.yml --tags sdn        # build the VLANs
ansible-playbook migrate.yml --tags build      # build the diskless shells
ansible-playbook migrate.yml --tags relocate   # storage vMotion, live
ansible-playbook migrate.yml --tags cutover    # power off and import
--limit ist durchweg dein Freund. Mach zuerst eine VM. Mach einen Cluster. Das Playbook hat keine Meinung dazu, wie viel du abbeißt, und das Inventar gibt dir Gruppen umsonst — power_poweredOn, cluster_<name>, plus vmware_windows und vmware_linux aus dem groups-Block.
Prüf, worauf du zeigst, bevor du darauf zeigst:
ansible-inventory --graph
ansible-inventory --host some-vm
Worauf ich weiter achten würde
Dinge, die ich erwarte zu finden, wenn das auf einen echten Bestand trifft, jetzt aufgeschrieben, damit ich hinterher nicht behaupten kann, ich hätte sie kommen sehen:
- Windows-Gäste booten nicht sauber von einem VirtIO-SCSI-Controller, ohne dass der Treiber vorher da ist.
virtio-scsi-singleist der richtige Controller und der falsche, um ihn einer Windows-VM zu geben, die ihn nie gesehen hat. Das ist ein eigenes Problem, und nichts oben löst es. - Die VMware Tools sollten vor dem Umzug herunter, nicht danach.
- Momentaufnahmen. Eine VM mit einer Kette von Momentaufnahmen hat mehr als eine
.vmdkje Platte, und die Basis zu importieren gibt dir den Zustand vor der Momentaufnahme. Erst zusammenführen. - Die Reihenfolge von
config.hardware.deviceentscheidet, welche Plattescsi0wird. Sie hat überall, wo ich hingesehen habe, mit der Reihenfolge des Gastes übereingestimmt, aber ich würde es auf einem Datenbankserver mit mehreren Platten prüfen, bevor ich ihr in einem Fenster vertraue. - Unabhängige Platten und RDMs lassen sich nicht wie gewöhnliche storage-vMotionen.
Nichts davon ändert die Form. Bau die Hüllen zuerst, beweg die Platten, während alles noch läuft, und halte den Ausfall auf das eine Play, das ihn braucht.