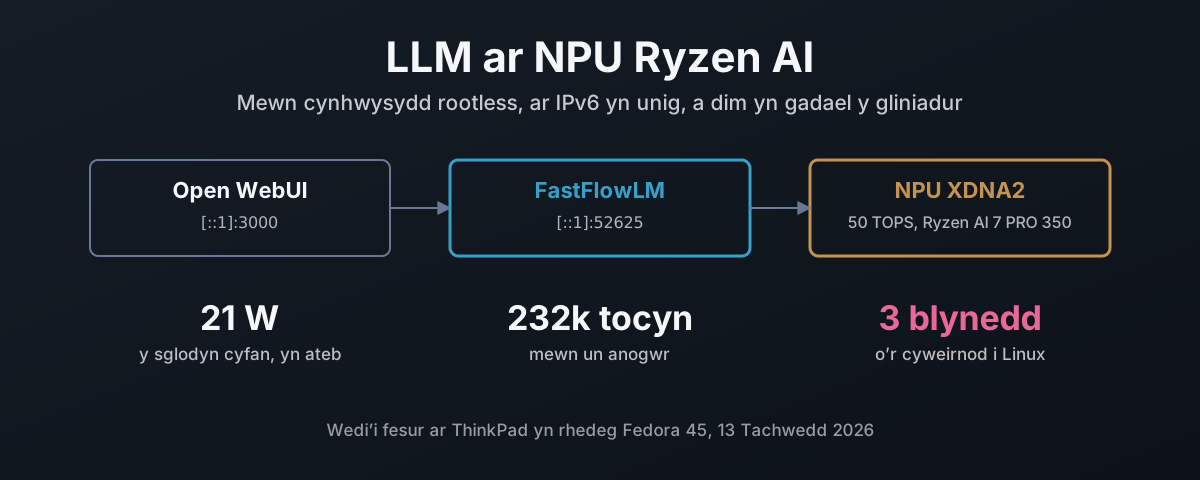
50 TOPS yn Gwneud Dim
Mae gan bob gliniadur Ryzen AI a werthwyd yn ystod y ddwy flynedd diwethaf Uned Prosesu Niwral (NPU) ynddo, darn o silicon sydd wedi’i adeiladu at ddim byd ond y fathemateg y tu ôl i fodelau AI. Ar fy un i, ThinkPad gyda Ryzen AI 7 PRO 350, mae AMD yn ei raddio ar hyd at 50 TOPS, triliynau o weithrediadau’r eiliad1. Ti dalodd amdano. Ar osodiad Linux safonol, nid yw’n gwneud dim.
Newidiodd hynny eleni. Unwaith y mae wedi’i osod, mae’r NPU yn rhedeg model iaith 4 biliwn paramedr y tu ôl i ffenest sgwrsio, a lleferydd i destun hefyd, i gyd ar y gliniadur, heb gyfrif, heb danysgrifiad a heb ddim yn gadael y peiriant. I unrhyw beth y byddai’n well gen ti beidio â’i deipio i wefan rhywun arall, dyna’r holl bwynt. Mae’r sglodyn cyfan yn tynnu tua 21 W tra mae’n ateb, ac yn segura ar lai na 9 W.
| Beth sy’n rhedeg | Ble | Cyfeiriad |
|---|---|---|
| Qwen 3.5 4B, cyd-destun 256k tocyn | NPU, mewn cynhwysydd | http://[::1]:52625/v1 |
Lleferydd i destun: Whisper OpenAI, whisper-v3:turbo | NPU, yr un cynhwysydd | yr un fath, /audio/transcriptions |
| Open WebUI, y dudalen sgwrsio | CPU, mewn cynhwysydd | http://[::1]:3000 |
| gyrrwr cnewyllyn amdxdna, cadarnwedd | gwesteiwr | /dev/accel/accel0 |
Dwy reol a luniodd yr adeiladu. Dim ond gyrrwr y cnewyllyn a’i gadarnwedd sy’n mynd ar y gwesteiwr; mae pob fframwaith model yn rhedeg mewn cynhwysydd podman rootless. Ac mae pob gwasanaeth yn gwrando ar loopback IPv6 yn unig, heb ddim ar IPv4 o gwbl. Roedd y ddwy yn llai o waith na’i wneud y ffordd flêr, a daliodd y ddwy broblemau y byddwn i wedi’u cludo fel arall.
Beth Sydd ei Angen ar Linux
Yr NPU yn y sglodyn hwn yw ail genhedlaeth AMD o’r cynllun, XDNA2. Mae hynny’n bwysig, oherwydd mae’r feddalwedd sy’n rhedeg modelau iaith arno yn cefnogi rhannau XDNA2 (cyfresi Ryzen AI 300 a 400, Strix Halo) ac nid y genhedlaeth gyntaf yn y Ryzen 7040 a’r 80402. Gwiria dy un di cyn dechrau:
$ lspci -nn | grep -i 'neural\|signal processing'
c5:00.1 Signal processing controller [1180]: Advanced Micro Devices, Inc. [AMD] Strix/Krackan/Krackan2/Strix Halo Neural Processing Unit [1022:17f0] (rev 20)
Mae pedair haen rhwng y ddyfais honno ac ateb yn y sgwrs, a’r rhaniad rhwng y gwesteiwr a’r cynhwysydd yw’r cynllun cyfan:
| Haen | Beth yw hi | Yn byw ar |
|---|---|---|
amdxdna | gyrrwr cnewyllyn, yn creu /dev/accel/accel03 | gwesteiwr, drwy DKMS |
| Cadarnwedd yr NPU | npu_7.sbin, 1.1.2.64 ar y sglodyn hwn | gwesteiwr, o linux-firmware |
XRT + ategyn amdxdna | llyfrgell runtime AMD a’i backend NPU | cynhwysydd |
| FastFlowLM | y runtime LLM, gyda chnewyllyn yr NPU wedi’u cynnwys | cynhwysydd |
Mae cnewyllyn 7.x yn cludo amdxdna yn y goeden, ond mae AMD yn ei ddatblygu’n gyntaf yn ei
storfa ei hun, ac mae’n rhaid i’r ategyn userspace gyfateb i’r modiwl cnewyllyn y mae’n siarad
ag ef4. Nid yw’r bwlch rhwng y ddau yn fach. Ar y gliniadur hwn:
| Yn y goeden, 7.2.15 a 7.3.3 Fedora | Y tu allan i’r goeden, amd/xdna-driver yn 24dfd686 | |
|---|---|---|
| Rhyngwyneb y gyrrwr | 0.105 | 0.19 |
| Fersiwn y modiwl | dim | 2.27.0_20261113 |
| IDs PCI NPU y mae’n eu rhwymo | 6 | 8 |
| Ffeiliau cadarnwedd y mae’n gofyn amdanynt | 7 | 59 |
| Cadarnwedd y mae’r sglodyn hwn yn ei llwytho | 17f0_10/npu_7.sbin, 1.1.2.64 | yr un ffeil |
Naw fersiwn rhyngwyneb ar wahân, ac mae Linux 7.3, y rhyddhad diweddaraf, yn dal i gario 0.10. Yr
unig beth y maen nhw’n cytuno arno yw’r gadarnwedd, a daw honno o linux-firmware Fedora, nid o’r
naill yrrwr na’r llall. Felly rydw i’n adeiladu’r ddau hanner o un commit o amd/xdna-driver, yn
rhoi’r modiwl ar y gwesteiwr, ac yn pobi’r userspace cyfatebol i mewn i’r ddelwedd.
Y Gyrrwr: Adeiladu’r Cyfan, Cadw Dim Ond Darn y Cnewyllyn
Mae amd/xdna-driver yn cario XRT fel is-fodiwl git, ac mae ei adeiladu yn cynhyrchu RPMs ar
gyfer XRT a phecyn ategyn. Mae’r pecyn ategyn hefyd yn cario ffynhonnell y gyrrwr, y mae’n ei
chofrestru gyda DKMS (Dynamic Kernel Module Support, y peth sy’n ailadeiladu modiwl ar gyfer pob
cnewyllyn newydd). Does dim o hynny’n anodd:
git clone --recursive https://github.com/amd/xdna-driver.git && cd xdna-driver
sudo ./tools/amdxdna_deps.sh
(cd xrt/build && ./build.sh -npu -opt)    # XRT RPMs in xrt/build/Release/
(cd build && ./build.sh -release)         # plugin RPM, driver source inside
Ar Fedora 45 mae’r sgript dibyniaethau yn gorffen gyda gwall. Anwybydda fe:
| Mae’n gofyn am | Beth sy’n digwydd | Ydy e’n bwysig? |
|---|---|---|
protobuf-devel | yn gwrthdaro â protobuf3-compiler sydd wedi’i osod | na, dim ond hepgor offeryn olrhain y mae XRT hebddo |
redhat-lsb | does dim pecyn o’r fath, gollyngodd Fedora fe | na |
| popeth arall | wedi’i osod yn barod |
Mae’r rhyddhad tagiedig diwethaf yno o fis Chwefror, felly main yw’r sianel ryddhau. Es i o
adeiladwaith mis Mai i un mis Tachwedd: 550 o commits, XRT 2.23 i 2.27.
Mae’r Uwchraddiad yn Dileu’r Gyrrwr Newydd ei Osod
Aeth fy nghynnig cyntaf ar uwchraddio â’r modiwl i ffwrdd yn llwyr. Mae RPM yn rhedeg sgript
gosod y pecyn newydd, sy’n adeiladu ac yn cofrestru’r gyrrwr newydd gyda DKMS, ac yna’n rhedeg
sgript dynnu’r hen becyn. Mae’r sgript dynnu honno’n darllen fersiwn y gyrrwr o ffeil y mae’r
pecyn newydd eisoes wedi’i throsysgrifo, felly mae’n dadgofrestru’r fersiwn a gafodd ei gosod
newydd. Mae allbwn dnf yn ei ddweud mewn dwy linell, y naill ar ôl y llall:
>>> Successfully installed and enabled DKMS for xrt-amdxdna/2.27.0
>>> Removing driver source: xrt-amdxdna/2.27.0...
Fethodd dim byd, aeth dim byd yn goch, a byddai’r cychwyn nesaf wedi llwytho’n dawel beth bynnag
a gludodd y cnewyllyn yn lle. Ga i ofyn pam mae sgript dynnu yn rhedeg ar uwchraddiad heb wirio
ai uwchraddiad ydyw? Mae RPM yn rhoi’r ateb hwnnw i bob scriptlet fel ei ddadl gyntaf. Un if
yw e.
Dyna hefyd y rheswm nad yw’r gwesteiwr yn cael yr RPMs o gwbl bellach. Pelen tar y tu mewn i’r pecyn ategyn yw ffynhonnell y gyrrwr, felly rydw i’n ei chodi allan a’i rhoi i DKMS yn uniongyrchol:
T=$(mktemp -d) && rpm2cpio xrt_plugin*.rpm | (cd $T && cpio -idm --quiet)
D=$T/opt/xilinx/xrt/share/amdxdna
sudo mkdir -p /usr/src/xrt-amdxdna-2.27.0
sudo tar -xf $D/amdxdna.tar.gz -C /usr/src/xrt-amdxdna-2.27.0
sudo cp $D/dkms.conf $D/configure_kernel.sh /usr/src/xrt-amdxdna-2.27.0/
sudo dkms install xrt-amdxdna/2.27.0
sudo modprobe -r amdxdna; sudo modprobe amdxdna
Dim ailgychwyn. Linux yw e, a does dim byd â’r ddyfais ar agor ar y pwynt hwnnw, felly mae’r
modiwl yn cyfnewid yn fyw. Yna mae DKMS yn ei ailadeiladu ar gyfer pob cnewyllyn y mae dnf yn
ei osod; pan gyrhaeddodd 7.3.3 roedd wedi’i adeiladu cyn i mi ailgychwyn i mewn iddo.
Gwiria mai adeiladwaith DKMS a lwythodd ac nid yr un yn y goeden, a bod y gadarnwedd yn ddigon newydd. Mae FastFlowLM eisiau 1.1.0.0 neu’n hwyrach2:
$ modinfo -F filename amdxdna
/lib/modules/7.2.15-300.fc45.x86_64/extra/amdxdna.ko.xz
$ cat /sys/bus/pci/drivers/amdxdna/*/fw_version
1.1.2.64
$ journalctl -k | grep 'Initialized amdxdna'
[drm] Initialized amdxdna_accel_driver 0.19.0 for 0000:c5:00.1 on minor 0
Mae DKMS yn symud modiwl y cnewyllyn ei hun o’r ffordd yn hytrach na’i ddileu, i
/var/lib/dkms/xrt-amdxdna/original_module/, felly mae tynnu adeiladwaith DKMS yn ei roi’n ôl.
Un peth arall i adael llonydd iddo: mae amd_iommu=off ar linell orchymyn y cnewyllyn yn
analluogi’r NPU2.
FastFlowLM Mewn Cynhwysydd
FastFlowLM yw’r runtime sy’n gwneud yr NPU yn ddefnyddiol ar gyfer modelau iaith. Llinell orchymyn yn null Ollama a gweinydd sy’n gydnaws ag OpenAI ydyw, wedi’i ysgrifennu ar gyfer XDNA2, a symudodd o dan sefydliad ROCm AMD eleni6. Mae’r runtime o dan drwydded MIT. Mae’r cnewyllyn NPU y mae’n eu cludo yn ddeuaidd caeedig, yn rhydd i’w defnyddio a’u hailddosbarthu heb eu haddasu7. Byddai’n well gen i petaen nhw’n agored, a dyweda i hynny, ond maen nhw yn y storfa a does dim rhaid nôl dim o unman arall.
Mae’r ddelwedd yn dri cham ar Fedora 45: XRT o adeiladwaith y gyrrwr, FastFlowLM wedi’i grynhoi yn ei erbyn, yna runtime gyda dim ond yr hyn sydd ei angen arno. Y rhan sy’n bwysig:
FROM registry.fedoraproject.org/fedora:45 AS xrt
ARG XDNA_COMMIT
COPY dist/xdna-${XDNA_COMMIT}/ /rpms/
RUN dnf -y install /rpms/xrt_2*-base.rpm /rpms/xrt_2*-npu.rpm \
 && rpm -i --noscripts --nodeps --nosignature \
        --excludepath=/usr/lib/firmware --excludepath=/opt/xilinx/xrt/share/amdxdna \
        /rpms/xrt_plugin*.rpm \
 && echo /opt/xilinx/xrt/lib64 > /etc/ld.so.conf.d/xrt.conf && ldconfig
Mae pob un o’r baneri hynny yno oherwydd i rywbeth dorri hebddo:
| Problem | Ateb |
|---|---|
| Mae sgriptiau’r ategyn yn adeiladu modiwl cnewyllyn, sy’n perthyn ar y gwesteiwr | --noscripts, a ffynhonnell y gyrrwr a’r gadarnwedd wedi’u hepgor |
| Mae RPM 6 Fedora 45 yn gorfodi gwirio llofnodion yn ddiofyn8, ac mae RPM hunan-adeiledig heb ei lofnodi | --nosignature: fi a’i hadeiladodd, rydw i’n gwybod o ble daeth |
Mae llyfrgelloedd XRT yn lib64, nad yw ar lwybr y cysylltydd | /etc/ld.so.conf.d/xrt.conf y tu mewn i’r ddelwedd |
Mae FastFlowLM yn dod o hyd i XRT drwy pkg-config, ac nid yw setup.sh XRT yn gosod y llwybr | PKG_CONFIG_PATH=/opt/xilinx/xrt/lib64/pkgconfig yn y cam adeiladu |
Mae’r ddelwedd orffenedig yn 609 MB, ac mae ei thag yn cario commit y gyrrwr,
fastflowlm:v1.0.12-xdna24dfd686. Mae gwiriad iechyd yn cymharu hynny â’r commit y mae’r modiwl
a lwythwyd yn ei adrodd, ac yn methu os ydyn nhw’n wahanol. Delwedd wedi’i hadeiladu ar gyfer y
gyrrwr anghywir yw’r un nam yma sy’n wirioneddol ddryslyd i’w ddiagnosio, felly mae’n cael ei
ddal cyn iddo gyrraedd mor bell.
Mae’r cynhwysydd yn cael un ddyfais, yr NPU, a’r terfyn cloi cof sydd ei angen ar FastFlowLM i binio ei glustogau:
podman run --rm --device /dev/accel/accel0 --ulimit memlock=-1:-1 \
  localhost/fastflowlm:v1.0.12-xdna24dfd686 validate
[Linux]  NPU: /dev/accel/accel0 with 8 columns
[Linux]  NPU FW Version: 1.1.2.64
[Linux]  Memlock Limit: infinity
Rhoddodd hunan-brawf AMD ei hun, xrt-smi validate, yr NPU ar 51 TOPS ar luosi matricsau. Dyna’r
50 ar y bocs, wedi’i gyflawni.
Cychwyn Gyda’r Peiriant, ar IPv6 yn Unig
Mae Quadlet yn troi ffeil .container fer yn wasanaeth systemd9. Fel uned defnyddiwr
mae’n rhedeg yn rootless, fel fi, a gyda lingering ymlaen mae’n cychwyn gyda’r peiriant heb neb
wedi mewngofnodi10:
[Unit]
Description=FastFlowLM NPU server
ConditionPathExists=/dev/accel/accel0

[Container]
Image=localhost/fastflowlm:v1.0.12-xdna24dfd686
AddDevice=/dev/accel/accel0
Ulimit=memlock=-1:-1
Network=host
Volume=%h/.config/flm:/models:Z
Exec=serve qwen3.5:4b --host ::1 --port 52625 -c 262144 -a whisper-v3:turbo
StopSignal=SIGINT

[Install]
WantedBy=default.target
loginctl enable-linger $USER
cp fastflowlm.container ~/.config/containers/systemd/
systemctl --user daemon-reload && systemctl --user start fastflowlm
Mae -c 262144 yn gosod y ffenest gyd-destun, ac mae’r prawf cyd-destun
isod yn esbonio pam ei bod mor fawr. Mae -a whisper-v3:turbo yn llwytho ail fodel wrth ymyl y model
sgwrsio, un sy’n troi lleferydd yn destun; mae’n cael ei adran ei hun.
Dysgwyd tair llinell yno’r ffordd galed:
| Llinell | Hebddi |
|---|---|
StopSignal=SIGINT | mae FastFlowLM yn anwybyddu SIGTERM, signal stopio podman, ac yn cael ei ladd ddeg eiliad yn ddiweddarach |
--host ::1 | mae’n gwrando ar 127.0.0.1, IPv4 |
::1, nid [::1] | mae’r ffurf â chromfachau yn methu â’i dosrannu; mewn URL y mae cromfachau’n perthyn |
Profa’r cyfeiriad yn hytrach na’i drystio:
$ ss -ltn 'sport = :52625'
LISTEN 0  4096  [::1]:52625  [::]:*
$ curl -s http://127.0.0.1:52625/v1/models || echo refused
refused
Mae localhost yn dal i weithio i unrhyw beth sy’n ei ddatrys i ::1 yn gyntaf, ac mae
/etc/hosts Fedora a Chrome ill dau yn gwneud hynny.
Beth Mae’n ei Wneud, Wedi’i Fesur
Naw model drwy feincnod FastFlowLM ei hun, a dadgodio yw’r cyflymder y mae’r ateb yn llifo arno:
| Model | Dadgodio, cyd-destun 1k | Dadgodio, cyd-destun 8k | Darllen yr anogwr, 8k |
|---|---|---|---|
llama3.2:1b | 77 tok/s | 56 tok/s | 2,009 tok/s |
qwen3.5:2b | 32 | 29 | 1,533 |
llama3.2:3b | 30 | 20 | 857 |
phi4-mini-it:4b | 25 | 17 | 744 |
qwen3:4b | 23 | 15 | 613 |
qwen3.5:4b | 17 | 15 | 657 |
gemma4-it:e4b | 14 | 12 | 642 |
qwen3:8b | 13 | 10 | 418 |
qwen3.5:9b | 11 | 10 | 451 |
Mae cyflymder darllen yn bump i wyth tocyn yr eiliad, felly mae pob un o’r rhain yn cadw o dy
flaen di. Mae dadgodio’n haneru’n fras bob tro y mae’r model yn dyblu, sef yr hyn rwyt ti’n ei
ddisgwyl pan mai lled band y cof yw’r terfyn ac nid y gallu cyfrifo. Rydw i’n rhedeg
qwen3.5:4b. Mae Phi-4 mini yn gyflymach, ond mae Qwen 3.5 yn dal ei gyflymder wrth i sgwrs
dyfu, yn trin delweddau a galwadau offer, ac yn cadw storfa anogwyr sy’n arbed ailddarllen yr
hanes cyfan ar bob tro. Dyna sy’n penderfynu.
256,000 o Docynnau Cyd-destun
Mae Qwen 3.5 wedi’i adeiladu ar gyfer ffenest o 262,144 tocyn11, ac mae FastFlowLM yn
defnyddio 32,768 yn ddiofyn. Y tu hwnt i’r terfyn hwnnw mae’n gwneud rhywbeth sy’n werth gwybod
amdano: mae’n cofnodi Max length reached, stopping prefilling ac yn cau’r cysylltiad heb ateb
a heb wall, felly mae’r ffenest sgwrsio yn eistedd yno gydag ateb gwag a thithau’n gorfod dyfalu
ai’r model, y gweinydd neu’r porwr a syrthiodd drosodd.
Felly codais e gyda -c 262144 a’i brofi’n iawn. Cod wedi’i guddio yn llinell gyntaf anogwr o
232,250 tocyn, tua 175,000 o eiriau, a gofyn amdano ar y diwedd:
| Cyd-destun 8k | Cyd-destun 232k | |
|---|---|---|
| Ateb | cywir | cywir, AMBER-FALCON-7731 |
| Darllen yr anogwr | 657 tok/s | 210 tok/s |
| Aros am y gair cyntaf | 12 eiliad | 18.4 munud |
| Dadgodio | 15 tok/s | 2.4 tok/s |
| Cof wedi’i neilltuo | ~5 GB | ~12.7 GB |
Mae’n gweithio. Mae’n araf. Ac mae’r cof wedi’i neilltuo p’un a wyt ti’n defnyddio’r ffenest ai peidio. Gyda 90 GB yn y peiriant, mi dala i hynny er mwyn cael ateb i ddarn hir wedi’i ludo yn hytrach na’i weld yn cael ei ollwng yn dawel.
All y GPU Helpu?
Mae gan yr un sglodyn Radeon 860M, felly’r cwestiwn amlwg yw a all gymryd peth o’r llwyth. Nid yw hollti un model ar draws yr NPU a’r GPU, darllen yr anogwr ar un ac ysgrifennu’r ateb ar y llall, yn rhywbeth y mae unrhyw runtime Linux yn ei wneud heddiw. Mae rhedeg ail runtime ar y GPU, felly mesurais hynny.
Mae ‘effeithlon’ yma’n golygu cyflymder ac ynni gyda’i gilydd. Mae gyrrwr amdgpu yn adrodd pŵer
y pecyn ar gyfer y sglodyn cyfan heb root, ac mae gyrrwr amdxdna yn adrodd yr NPU ar ei ben ei
hun, felly cafodd pob rhediad isod ei samplu bedair gwaith yr eiliad. Yr un model ar 4 did drwy
gydol yr amser.
O’r runtimes GPU yr edrychais arnynt, gweithiodd un:
| Runtime | Canlyniad ar yr 860M |
|---|---|
| llama.cpp, backend Vulkan12 | yn gweithio; delwedd 881 MB |
| llama.cpp, backend ROCm | yn gweld y GPU, yna’n segfault ar y darn cyntaf o waith, gyda neu heb or-reolaeth fersiwn GPU; delwedd 23 GB |
| MLC-LLM, Vulkan13 | mae ei grynhoydd yn segfault wrth adeiladu pensaernïaeth Qwen 3.5 |
| vLLM, SGLang | heb eu trio: wedi’u hadeiladu ar gyfer GPUs canolfan ddata a llawer o ddefnyddwyr, nid iGPU 8 uned |
A’r NPU yn erbyn yr un a weithiodd:
| Qwen 3.5 4B | NPU, FastFlowLM | GPU, llama.cpp Vulkan |
|---|---|---|
| Segur, model wedi’i lwytho | 8.6 W | 16.0 W, yn erbyn 9.7 W gyda hi wedi’i stopio |
| Darllen yr anogwr, ~6k tocyn | 557 tok/s ar 23.8 W | 411 tok/s ar 46.1 W |
| Ynni fesul tocyn anogwr | 0.043 J | 0.112 J |
| Dadgodio | 18.2 tok/s ar 21.0 W | 23.5 tok/s ar 40.7 W |
| Ynni fesul tocyn a gynhyrchwyd | 1.16 J | 1.73 J |
Mae’r GPU yn ysgrifennu atebion tua 29% yn gyflymach. Mae’n llosgi dwywaith y pŵer i wneud hynny. Mae’r NPU yn darllen anogwyr yn gyflymach ac ar lai na hanner yr ynni. Y rhif mwyaf yw’r un segur: mae gweinydd y GPU wedi’i lwytho a heb wneud dim yn costio 6.3 W yn fwy na’r un peiriant gydag ef wedi’i stopio, drwy’r dydd. Aeth rhedeg y ddau ar unwaith â’r NPU o 18.2 i 14.2 tocyn yr eiliad a’r GPU o 23.5 i 13.9, oherwydd eu bod yn rhannu’r un cof. O’r herwydd, mae cynhwysydd y GPU yn bodoli, ond rydw i’n ei gychwyn pan fydda i eisiau ail fodel, a dyw e ddim wedi’i alluogi i gychwyn gyda’r peiriant.
Tynnodd yr NPU ei hun lai na 2 W ym mhob rhediad. Y CPU a’r cof sy’n ei fwydo yw’r rhan fwyaf o’r 21 W. Dyna’r nenfwd sy’n werth cadw llygad arno yn rhyddhadau FastFlowLM y dyfodol.
Lleferydd i Destun ar yr NPU Hefyd
Whisper yw model adnabod lleferydd OpenAI: sain i mewn, testun allan, mewn 99 o ieithoedd, ac wedi’i ryddhau o dan drwydded MIT, felly mae’n rhedeg yn unrhyw le heb ofyn i neb14. Large-v3 yw’r fersiwn maint llawn presennol. Turbo yw’r un model gyda’i ddadgodiwr, yr hanner sy’n ysgrifennu’r testun allan, wedi’i dorri o 32 haen i 4. Mae cerdyn y model yn rhoi’r gyfnewid yn blaen: ‘way faster, at the expense of a minor quality degradation’. Ar 809 miliwn o baramedrau mae’n bumed maint y model sgwrsio.
Mae FastFlowLM yn ei gludo wedi’i drosi’n barod ar gyfer yr NPU fel whisper-v3:turbo,
lawrlwythiad 623 MB, ac yn ei lwytho wrth ymyl y model sgwrsio gyda -a whisper-v3:turbo. Wnaiff
e ddim gweini Whisper ar ei ben ei hun; rhaid i fodel sgwrsio fod wedi’i lwytho hefyd. Mae’r sain
yn mynd i bwynt terfyn trawsgrifio safonol OpenAI ac mae’r testun yn dod yn ôl.
| 19.6 eiliad o leferydd | |
|---|---|
| Cais cyntaf, yn llwytho Whisper | 6.2 s |
| Ar ôl hynny | 2.0 s, tua deg gwaith amser real |
| Pŵer y sglodyn cyfan | ~24.7 W |
| Cywirdeb | pob gair yn gywir |
Wedi’i sillafu yn ôl sillafiadau Saesneg ffug America, cofia: ‘color’ a ‘program’. Mae API
Whisper yn derbyn prompt, ac mae anogwr wedi’i ysgrifennu mewn sillafu Saesneg Prydeinig go
iawn, Saesneg Lloegr lle mae’r iaith yn dod ohoni, yn ddigon i’w drwsio:
curl -s 'http://[::1]:52625/v1/audio/transcriptions' -F file=@speech.wav \
  -F model=whisper-v3:turbo -F language=en \
  -F 'prompt=British English spelling: colour, programme, organise, centre.'
Ddylen ni ddim gorfod cywiro’r modelau hyn o gwbl. Cafodd Whisper ei hyfforddi ar 99 o ieithoedd ac mae’n dal i ysgrifennu Saesneg y ffordd Americanaidd oni bai ei fod yn cael gwybod yn wahanol, oherwydd bod y bobl a’i hadeiladodd yn trin eu sillafu nhw fel y rhagosodiad a sillafu pawb arall fel dewis y mae’n rhaid gofyn amdano. Dyna’r rhagosodiaeth Americanaidd boenus y mae gweddill y byd yn ei chasáu, ac mae wedi’i phobi i mewn fel tuedd. Mae anogwr system y model sgwrsio yn cario’r un cyfarwyddyd, yn yr adran isod, am yr un rheswm.
Ffenest Sgwrsio, a 7,000 o Docynnau na Theipiaist Erioed
Open WebUI yw’r pen blaen yn y porwr15, yn ei gynhwysydd ei hun, wedi’i rwymo i [::1]:3000
yn yr un ffordd ac wedi’i gyfeirio at yr NPU. Mae ei fotwm meicroffon yn mynd i Whisper ar yr NPU
yn lle ei ragosodiad ei hun, a fyddai wedi lawrlwytho model a’i redeg ar y CPU.
Ugain gair oedd y neges gyntaf a anfonais ato. Cyrhaeddodd yr NPU fel anogwr 7,223 tocyn, oherwydd bod Open WebUI 0.13 yn atodi diffiniadau ei holl offer adeiledig (cof, nodiadau, calendr, awtomeiddio, chwilio’r we) i bob neges, ac mae gweinyddwr yn cael pob un ohonyn nhw.
| Yr un cwestiwn ugain gair | Anogwr a anfonwyd i’r NPU | Aros am y gair cyntaf |
|---|---|---|
| Offer adeiledig ymlaen, y rhagosodiad | 7,223 tocyn | ~12 s |
| Offer adeiledig i ffwrdd ar gyfer y model | 127 tocyn | llai nag 1 s |
Ar gyfer model lleol dylai’r rhagosodiad hwnnw fod i ffwrdd. Deuddeg eiliad, bob ateb.
Dywedodd wrtha i hefyd, yn gwbl hyderus, ei fod yn ‘trained by Google’ ac yn rhedeg ‘on Google’s advanced infrastructure’. Model Qwen yw e, wedi’i wneud gan Alibaba, yn rhedeg ar liniadur. Mae hynny’n lol llwyr, ac ni ddylai ddigwydd.
Nid y gosodiad sydd ar fai. Dim ond y testun sy’n cael ei anfon ato y mae model yn ei weld, ac mae’r enw yn y gwymplen yn label ar gyfer y gweinydd, heb ei basio i’r model byth. Felly daeth yr ateb hwnnw o’r model yn unig, a chafodd yr un ffaith amdano’i hun na ddylai fyth fod yn amheus yn anghywir. Diffyg dylunio yw hynny, ac mae’n perthyn i bwy bynnag a gludodd y model.
Roedd Alibaba yn gwybod sut i’w atal. Roedd templed sgwrsio Qwen 2.5 yn agor pob sgwrs gyda ‘You are Qwen, created by Alibaba Cloud’ oni bai dy fod yn rhoi rhywbeth arall iddo16. Gollyngodd Qwen 3 y llinell honno17, ac mae Qwen 3.5 yn cael ei gludo hebddi hefyd18. Ddaeth dim byd yn ei lle, ac a barnu wrth yr ateb hwnnw chafodd y model erioed ei ddysgu’n ddigon da i ymdopi ar ei ben ei hun. Gofynna i fodel 4B ‘what are you?’ heb anogwr ac mae’n disgyn yn ôl ar yr ateb mwyaf cyffredin yn ei ddata hyfforddi, sef ateb rhywun arall.
Ai peth bach yw hynny? Na. Bydd model a fydd yn dweud wrthot ti, yn gwbl hyderus, pwy a’i hadeiladodd ac ym mha ganolfan ddata y mae’n rhedeg, a chael y ddau’n anghywir, yn gwneud yr un peth gydag unrhyw beth arall na all ei wirio. Yma rwyt ti’n gwybod yr ateb cywir. Y rhan fwyaf o’r amser fyddi di ddim.
Felly mae’n rhaid dweud wrtho, mewn anogwr system:
| Wedi gofyn ‘what are you, and what are you running on?’ | Ateb |
|---|---|
| Dim anogwr system | ‘a large language model trained by Google… Google’s advanced infrastructure’ |
| Gydag un | ‘Qwen 3.5, a large language model created by Alibaba… running locally on your Lenovo ThinkPad using the AMD Ryzen AI 7 PRO 350’s NPU via FastFlowLM’ |
Mae’r un anogwr yn dweud wrtho am ysgrifennu Saesneg Prydeinig, eto oherwydd y rhagosodiaeth Americanaidd sydd gan Whisper hefyd. O gael gwybod, mae’n gwneud hynny. Dyw e dal ddim yn gallu dweud wrthot ti pa ddiwrnod yw hi. Mae model heb galendr a heb y rhyngrwyd yn dyfalu dyddiadau a digwyddiadau diweddar, a fydd e ddim bob amser yn dweud hynny, beth bynnag mae’r anogwr yn ei ofyn.
Tair Blynedd i Redeg AI ar Linux
Rhoddodd AMD Ryzen AI ar y llwyfan ym mis Ionawr 2023 fel ‘the first dedicated artificial intelligence hardware in an x86 processor’19. Cyfrifa ymlaen o’r cyweirnod hwnnw:
| Pryd | Beth ddigwyddodd ar Linux | Ar ôl y cyweirnod |
|---|---|---|
| 4 Ionawr 2023 | Ryzen AI yn cael ei gyhoeddi, yn y Ryzen 7040 | |
| 25 Ionawr 2024 | amd/xdna-driver yn cael ei gyhoeddi ar GitHub4 | 1 flwyddyn |
| 24 Mawrth 2025 | amdxdna yn Linux y brif linell, 6.1420 | 2 flynedd 2 fis |
| 27 Mawrth 2025 | y sglodyn hwn, y Ryzen AI 7 PRO 350, yn cael ei lansio1 | 2 flynedd 2 fis |
| 11 Mawrth 2026 | FastFlowLM 0.9.35, ei ryddhad Linux brodorol cyntaf21 | 3 blynedd 2 fis |
| 11 Awst 2026 | FastFlowLM 1.0.0, bellach o dan ROCm AMD6 | 3 blynedd 7 mis |
| heddiw | dal dim runtime LLM ar gyfer y 7040 a’r 80402 | 3 blynedd 10 mis |
Tair blynedd a dau fis i redeg model iaith ar yr NPU o dan Linux o gwbl, ac nid meddalwedd AMD ei hun a wnaeth hynny. FastFlowLM a’i gwnaeth, prosiect a ddechreuodd y tu allan i’r cwmni ac a gafodd ei gymryd i mewn o dan ROCm eleni. Mae ei nodiadau rhyddhau Linux yn agor gyda ‘The wait is finally over’, yna’n dweud ei fod yn defnyddio ‘the exact same recipe you already know and love on Windows’21. Cafodd y Fisher-Price OS (Windows) e gyntaf, ac fe ddywedon nhw hynny. Mae Ryzen AI Software AMD ei hun yn dal i ddweud, yn ei nodiadau rhyddhau presennol, ‘Model generation is not supported on Linux in this release’22.
Mae’n waeth ar unrhyw un a brynodd y genhedlaeth gyntaf. Mae gan liniadur Ryzen 7040 o 2023 NPU na wnaiff yr un runtime model iaith ar Linux ei gyffwrdd, a does dim byd wedi’i gyhoeddi yn dweud bod un ar y ffordd. Yr un bathodyn.
Ga i ofyn pam? Nid pwy, pam. Beth ym mhroses AMD a ganiataodd i sglodyn gael ei werthu gydag AI yn ei enw tra cyrhaeddodd y feddalwedd i ddefnyddio’r AI honno ar Linux flynyddoedd yn ddiweddarach, o’r tu allan? Mae’r daflen fanyleb yn dweud ‘Up to 50 TOPS’1. Mae’r bathodyn yn dweud Ryzen AI. Mae’r ddau yn ddatganiadau a wnaed i’r person sy’n prynu’r gliniadur, ac am flwyddyn gyntaf y sglodyn hwn ar Linux roedd y ddau’n werth dim.
Wedi’i Anelu at Copilot, Nid y Ganolfan Ddata
Nid bod AMD yn gweld Linux yn anodd. Yn y ganolfan ddata mae Linux o’r radd flaenaf ac mae AMD yn gwybod hynny: proseswyr AMD EPYC a chyflymyddion AMD Instinct yw El Capitan yn Lawrence Livermore, hwn oedd cyfrifiadur cyflymaf y byd tan fis Mehefin eleni23, ac mae’n rhedeg TOSS, fersiwn Livermore ei hun o Red Hat Linux24. Elli di ddychmygu AMD yn gwerthu cyflymydd Instinct ac yn dweud wrth y prynwr y byddai’r feddalwedd Linux yn dilyn rywbryd, gan rywun arall? Byddai’n ‘na’. Ysgrifennodd AMD hyd yn oed yrrwr cnewyllyn yr NPU hwn a’i gael i mewn i’r brif linell. Yr haen olaf, yr un sy’n gwneud i’r caledwedd wneud y gwaith y cafodd ei werthu ar ei gyfer, oedd y darn a adawyd yn aros.
Ddylai hwn erioed fod wedi bod yn brosiect gliniadur o gwbl. Aeth yr un bensaernïaeth XDNA i mewn i gerdyn canolfan ddata yr un flwyddyn, yr Alveo V70, wedi’i werthu fel ‘the first Alveo production card leveraging AMD XDNA architecture with AI Engines’25. Adeiladu un pentwr meddalwedd ar gyfer yr AI Engine, Linux yn gyntaf fel gweddill y ganolfan ddata, ac mae’r gliniadur yn ei gael am ddim. Felly hefyd y gweinydd. Cyflymydd bach, cynnil yw’r union beth rwyt ti eisiau ei rannu rhwng peiriannau rhithwir, sleisen yr un, ar gyfer y modelau bach nad oes angen GPU cyfan arnyn nhw. Dim ond eleni y dysgodd y cnewyllyn wneud hynny, gan hollti NPU yn swyddogaethau rhithwir ar y rhannau AIE4 newydd26. Ar yr NPU yn y gliniadur hwn, all e ddim ei wneud o gwbl.
Yn lle hynny aeth yr ymdrech i’r Fisher-Price OS (Windows), ac i Copilot. Lansiodd AMD genhedlaeth y sglodyn hwn fel proseswyr sy’n ‘Unlock Transformational AI Experiences for Windows Copilot+ PCs’27. Prin fod neb wedi prynu i mewn. Roedd peiriannau Copilot+ yn 2.3% o’r cyfrifiaduron Fisher-Price OS (Windows) a werthwyd yn chwarter cyntaf 2025, ac mae nodweddion Copilot mwy newydd Microsoft yn rhedeg yn y cwmwl beth bynnag: ‘only one of its new AI capabilities actually requires an NPU’28. Mae Microsoft hefyd yn adrodd bod yr hyn y mae’n ei ennill gan wneuthurwyr PCs i lawr 7% oherwydd ‘lower PC market demand’, gyda ‘roughly 30% of the installed base still on Windows 10’29. Felly cafodd yr NPU ei anelu at system weithredu nad yw pobl yn uwchraddio iddi, i redeg cynorthwyydd na ofynnon nhw amdano, nad yw’n defnyddio’r NPU gan amlaf.
Ac nid dyna lle mae AI yn cael ei adeiladu chwaith. Mae’r bobl sy’n gwneud hyn fel bywoliaeth yn rhedeg Linux, oherwydd dyna lle mae eu hoffer yn rhedeg. Mae TensorFlow yn dweud yn blaen mai 2.10 ‘was the last TensorFlow release that supported GPU on native-Windows’30. Mae gweinydd modelau vLLM ‘does not support Windows natively’31. Mae JAX yn rhestru ei adeiladwaith Fisher-Price OS (Windows) fel arbrofol, a’i gefnogaeth AMD fel ‘AMD GPU (Linux)’32. Lle mae’r Fisher-Price OS (Windows) yn rhedeg yr offer hyn, mae’n gwneud hynny drwy WSL 2, sef, yn ôl disgrifiad Microsoft ei hun, ‘an actual Linux kernel inside a managed VM’33. Anelodd AMD ei sglodyn AI at yr un bwrdd gwaith nad yw’r proffesiwn AI yn ei ddefnyddio. Dyw cefnogi hynny’n rhannol ddim yn ddigon, AMD.
Yna mae AMD yn gwerthu ei hun i fuddsoddwyr fel cwmni AI. Ar 11 Tachwedd 2025 dywedodd ei gadeirydd a’i brif weithredwr fod AMD ‘is uniquely positioned to lead the next generation of high-performance and AI computing’, mewn datganiad sy’n brolio iddo dyfu ei ‘AI PC portfolio 2.5x since 2024’ ac sy’n gorffen gyda ‘full-stack AI solutions’34. Pentwr llawn. Ar y PC AI yn y post hwn, daeth brig y pentwr hwnnw o brosiect na ddechreuodd AMD, ac ar y genhedlaeth gyntaf ddaeth e byth. Cwmni AI y bu’n rhaid i’w sglodyn AI ei hun aros tair blynedd i redeg AI ar y system weithredu y mae ei fusnes canolfannau data wedi’i adeiladu arni? Chwerthinllyd.
Mae cefnogaeth o’r radd flaenaf yn syml i’w disgrifio. Mae’n gweithio ar y diwrnod rwyt ti’n prynu’r peiriant, ar y system weithredu rwyt ti’n ei rhedeg, gan y cwmni a werthodd y sglodyn i ti. Dyw’r NPU hwn ddim wedi cyrraedd hynny eto. Prynais y gliniadur am y gweddill ohono a daeth yr NPU gydag e, a dyna’r unig reswm mai adroddiad yw hwn ac nid cwyn. Prynodd unrhyw un a brynodd un am yr AI ar y bathodyn, ac sy’n rhedeg Linux, addewid a gadwyd yn hwyr, a chan rywun arall.
Bydd Berchen ar y Silicon y Talaist Amdano
Daeth yr NPU gyda’r gliniadur. Yn y ffordd y mae’n cael ei werthu, dyma’r darn sy’n gwneud y peiriant yn barod ar gyfer AI, a’r AI sydd ar gynnig yw un rhywun arall, yng nghanolfan ddata rhywun arall, yn darllen yr hyn rwyt ti’n ei deipio er mwyn i rywbeth arall dalu amdano. Does dim byd am y caledwedd angen y trefniant hwnnw. Mae model 4B ar 21 W yn ateb cwestiwn, yn darllen darn 175,000 o eiriau wedi’i ludo os rhoi di’r amser iddo, ac yn ysgrifennu’r hyn rwyt ti’n ei ddweud, a does dim ohono’n gadael y ddesg.
Nid meddalwedd orffenedig yw hon, a chostiodd pob ymyl garw uchod awr i’w ganfod a llinell neu ddwy i’w drwsio. Dyna mae cod agored yn ei gostio pan wyt ti’n ei redeg go iawn. Mae’n dal yn fargen well na rhentu’r un gallu yn ôl, ac mae’r awr yn prynu i ti wybod sut mae’n gweithio.
Mae’r cynwysyddion yn ei gadw’n onest. Dim byd ar y gwesteiwr ond modiwl cnewyllyn a’i gadarnwedd, un ddyfais wedi’i phasio i un cynhwysydd, cyfeiriad na all neb arall ei gyrraedd, a gwiriad sy’n methu’r eiliad y mae’r darnau’n stopio cyfateb. Cymerodd ddiwrnod. Bydd yn dal i weithio, oherwydd fy mod i’n gwybod pam mae pob llinell ynddo yno, a bydd y gwiriad yn dweud wrtha i y bore y mae un ohonyn nhw’n peidio â bod yn wir.
AMD — Ryzen AI 7 PRO 350 — 8 craidd, 16 edau, Radeon 860M, ‘NPU TOPS: Up to 50 TOPS’, dyddiad lansio ‘3/27/2025’. ↩︎ ↩︎ ↩︎
Lemonade — LLMs on Linux with FastFlowLM — XDNA2 yn unig (Ryzen AI 300/400, Strix Halo), nid XDNA1; cadarnwedd NPU 1.1.0.0 neu’n hwyrach; paid â gosod
amd_iommu=off. ↩︎ ↩︎ ↩︎ ↩︎Linux kernel documentation — amdxdna — y gyrrwr cyflymydd yn y goeden ar gyfer NPUs AMD. ↩︎
amd/xdna-driver — gyrrwr, is-fodiwl XRT ac ategyn; adeiladu pecyn sylfaen XRT o’r is-fodiwl sydd wedi’i gynnwys fel ei fod yn gweithio gyda’r ategyn; storfa wedi’i chreu 25 Ionawr 2024. ↩︎ ↩︎
Linux v7.3 — drivers/accel/amdxdna/amdxdna_pci_drv.c —
AMDXDNA_DRIVER_MAJOR 0,AMDXDNA_DRIVER_MINOR 10; yr un fath yn v7.2. ↩︎ROCm/FastFlowLM — runtime LLM NPU ar gyfer XDNA2, gweinydd sy’n gydnaws ag OpenAI, rhan o ROCm ers v1.0.0; y rhyddhad a ddefnyddiwyd yma yw v1.0.12. ↩︎ ↩︎
FastFlowLM — LICENSE_BINARY.txt — telerau ar gyfer y deuaiddion cnewyllyn NPU sydd wedi’u cynnwys. ↩︎
RPM 6.0.0 release notes — ‘RPM defaults to enforcing signature checking’. ↩︎
podman-systemd.unit(5) — unedau
.containerQuadlet, gan gynnwysAddDevice=,Ulimit=,StopSignal=acExec=. ↩︎loginctl(1) — mae
enable-lingeryn cychwyn rheolwr defnyddiwr gyda’r peiriant ac yn ei gadw i redeg ar ôl allgofnodi. ↩︎Qwen/Qwen3.5-4B — ‘Context Length: 262,144 natively’; haenau hybrid Gated DeltaNet a gated attention. ↩︎
ggml-org/llama.cpp — y ddelwedd cynhwysydd
server-vulkana ddefnyddiwyd ar gyfer rhediadau’r GPU, adeiladwaith 12352. ↩︎mlc-ai/mlc-llm — wedi’i brofi gyda phecynnau nightly 0.26. ↩︎
openai/whisper-large-v3-turbo — ‘a state-of-the-art model for automatic speech recognition (ASR) and speech translation’; wedi’i docio o large-v3, ‘the number of decoding layers have reduced from 32 to 4’; 809M o baramedrau; trwydded MIT. ↩︎
open-webui/open-webui — rhyddhad v0.13.3 a ddefnyddiwyd yma. ↩︎
Qwen/Qwen2.5-7B-Instruct — tokenizer_config.json — neges system ddiofyn y templed sgwrsio: ‘You are Qwen, created by Alibaba Cloud. You are a helpful assistant.’ ↩︎
Qwen/Qwen3-4B — tokenizer_config.json — templed sgwrsio heb neges system ddiofyn. ↩︎
Qwen/Qwen3.5-4B — tokenizer_config.json — templed sgwrsio heb neges system ddiofyn. ↩︎
AMD — AMD Highlights Future of High-Performance and Adaptive Computing During Opening Keynote of CES 2023 — 4 Ionawr 2023: ‘AMD also unveiled Ryzen AI Technology – the first dedicated artificial intelligence hardware in an x86 processor.’ ↩︎
Kernel Newbies — Linux 6.14 — rhyddhawyd dydd Llun 24 Mawrth 2025; ‘an amdxdna driver for AMD NPUs’. ↩︎
FastFlowLM v0.9.35 release notes — 11 Mawrth 2026: ‘The wait is finally over… FastFlowLM is officially available natively on Linux!’ ↩︎ ↩︎
AMD — Ryzen AI Software release notes — problemau hysbys: ‘Model generation is not supported on Linux in this release.’ ↩︎
TOP500 — June 2026 — ‘LineShine debuts as the new No. 1 system, ending El Capitan’s run atop the list’; mae El Capitan ‘is based on AMD 4th generation EPYC processors… and AMD Instinct MI300A accelerators’. ↩︎
LLNL — TOSS: Speeding Up Commodity Cluster Computing — ‘a fully functional cluster operating system, based on Red Hat Linux’. ↩︎
AMD — Alveo V70 — ‘the first Alveo production card leveraging AMD XDNA architecture with AI Engines… designed for AI inference efficiency’. ↩︎
Linux — accel/amdxdna: Add basic support for AIE4 devices — ‘Add initial support for AIE4 devices (PCI device IDs 0x17F2 and 0x1B0B), including… SR-IOV enablement’. Mae tabl y gyrrwr yn rhoi cofnodion swyddogaeth rithwir i’r rhannau hynny yn unig;
17f0yw NPU y gliniadur hwn. ↩︎AMD — AMD Unveils Next-Gen “Zen 5” Ryzen Processors to Power Advanced AI Experiences — Computex, 2 Mehefin 2024: ‘AMD Ryzen AI 300 Series Processors Unlock Transformational AI Experiences for Windows Copilot+ PCs’. ↩︎
Engadget — Microsoft’s Copilot+ AI PC plan fizzled, but it still served a purpose — 5 Rhagfyr 2025: roedd systemau Copilot+ yn ‘made up just 2.3 percent of Windows machines sold in the first quarter of 2025’; ‘only one of its new AI capabilities actually requires an NPU’. ↩︎
Windows Latest — Microsoft admits its end of support was the real Windows 11 sales driver — 31 Gorffennaf 2026, yn dyfynnu galwad canlyniadau Microsoft: ‘Windows OEM and Devices revenue decreased 7%… driven by lower PC market demand’; ‘roughly 30% of the installed base still on Windows 10’. ↩︎
TensorFlow — Install TensorFlow with pip — ‘TensorFlow 2.10 was the last TensorFlow release that supported GPU on native-Windows.’ ↩︎
vLLM — GPU installation — ‘vLLM does not support Windows natively’. ↩︎
JAX — Installation — olwynion CPU ar gyfer ‘Windows, x86_64 (experimental)’; adrannau GPU ar gyfer NVIDIA, Google Cloud TPU, Mac ac ‘AMD GPU (Linux)’. ↩︎
Microsoft — Comparing WSL versions — ‘the use of an actual Linux kernel inside a managed VM’. ↩︎
AMD — AMD Unveils Strategy to Lead the $1 Trillion Compute Market and Accelerate Next Phase of Growth — Diwrnod Dadansoddwyr Ariannol, 11 Tachwedd 2025: ‘AMD is uniquely positioned to lead the next generation of high-performance and AI computing’; ‘AMD has expanded its AI PC portfolio 2.5x since 2024’; ‘AMD delivers full-stack AI solutions’. ↩︎